

Python函数参数与返回值类型注解的标准写法
深入解析Python函数参数与返回值类型注解的标准写法,包括基础标量、默认值格式、现代泛型容器、联合类型、变长参数及架构设计原则。
类型注解(Type Hints)是现代 Python 代码工程化与可维护性的重要基石。通过在函数定义中显式标注参数类型与返回值类型,开发者能够获得静态检查工具的精准排错支持、IDE 级别的智能补全,以及清晰明确的代码接口契约。本文聚焦于 Python 3.9 及 3.10+ 标准规范,梳理函数签名中各类参数与返回值的标准书写方式、常见易混淆点以及工程设计准则。
一、核心基础:参数与返回值的标准语法形态
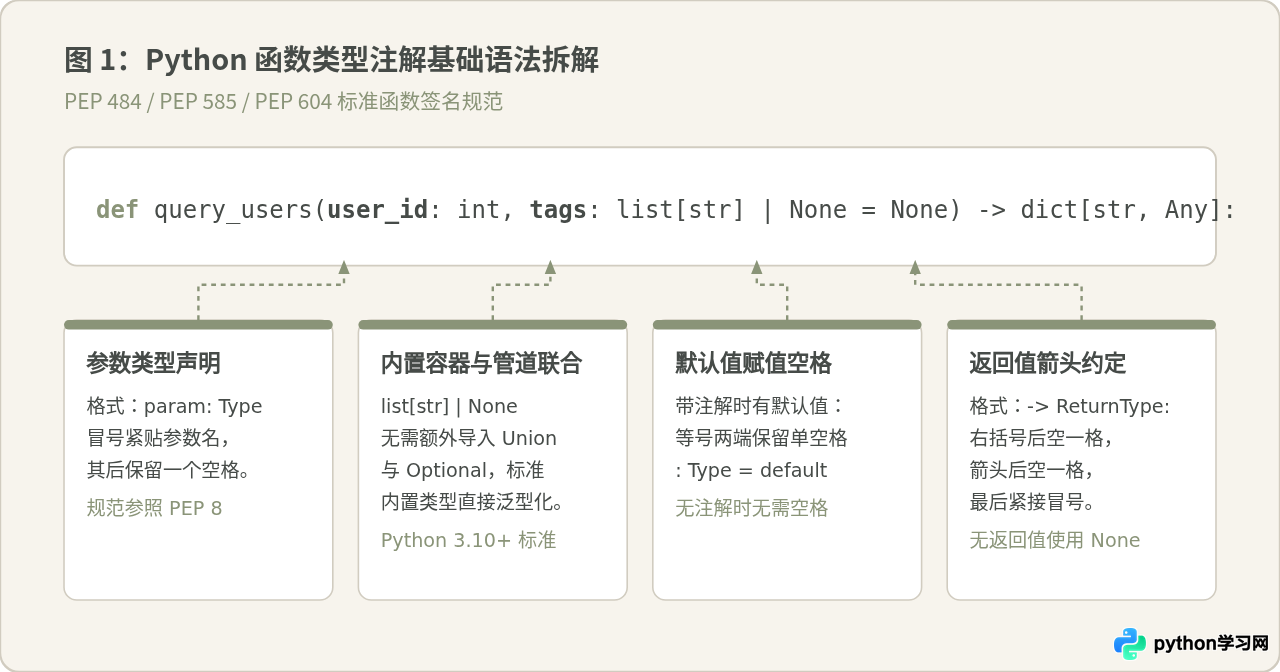
Python 在 PEP 484 中确立了类型注解机制,并在 PEP 8 代码风格指南中明确了具体的版面与空格规范。掌握基础形态的标准写法,是避免格式混乱与语法隐患的第一步。
1. 标量类型与空格规范
标注常规参数类型时,冒号应紧跟参数名(无空格),冒号后空一格再书写类型名称。对于带有默认值的参数,等号两边均需保留一个空格:
# 标准写法
def calculate_discount(price: float, rate: float = 0.85) -> float:
    return price * rate

# 不推荐写法(空格不规范)
def calculate_discount(price:float, rate: float=0.85)->float: ...
这里需要注意一个常见规则变化:在没有类型注解的普通参数中,PEP 8 要求默认值等号两端不加空格(如 def func(rate=0.85):);但在存在类型注解时,为保证阅读清晰度,必须在等号两端添加空格(如 rate: float = 0.85)。
2. 返回值注解与空返回
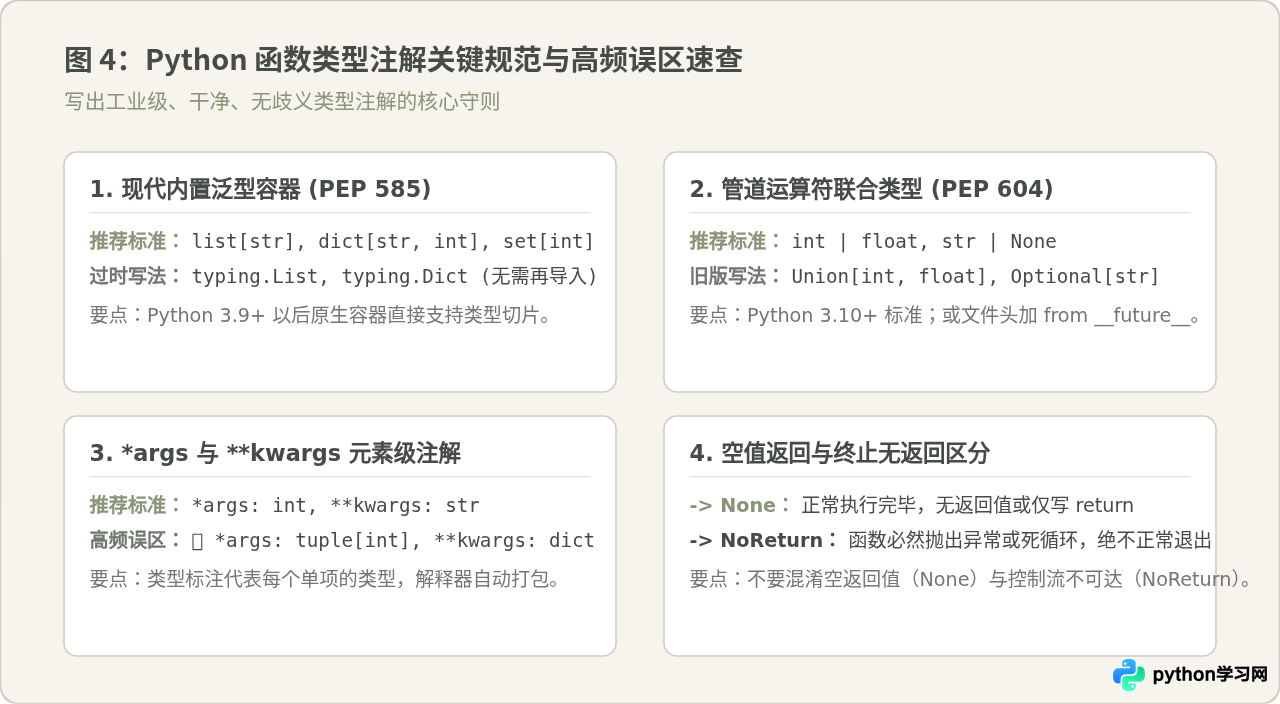
返回值类型使用由横杠和大于号构成的箭头 -> 标注,放置在函数参数括号之后、末尾冒号之前。若函数没有返回值或仅执行操作并不产出结果,应显式标注为 -> None,而非省略不写:
def log_message(message: str) -> None:
    print(f"[LOG]: {message}")
明确标注 -> None 能明确告知静态类型分析器与协作者:此函数的返回值不是未完成标注的遗留状态,而是设计上有意为之的空返回。
3. 变长参数(*args 与 **kwargs)的注解规则
在标注可变位置参数 *args 和可变关键字参数 **kwargs 时,初学者极易出现将它们标注为包装容器(如 tuple 或 dict)的误区。在标准规范中,变长参数应当标注其解包后每个元素的类型:
# 正确写法:标注单项元素类型
def sum_all(*args: int, **kwargs: str) -> int:
    for key, value in kwargs.items():
        print(f"{key}: {value}")
    return sum(args)

# 错误写法:切勿标注为包装类型
def sum_all(*args: tuple[int], **kwargs: dict[str, str]) -> int: ...
Python 解释器在运行时会自动将传入的位置参数打包为 tuple,关键字参数打包为 dict;类型检查器期望获得的正是这些包内元素的类型描述,因此直接标注单项类型即可。
二、现代类型系统:容器与联合类型的演进
随着 Python 3.9(PEP 585)与 Python 3.10(PEP 604)的发布,标准库对类型注解进行了大幅精简,现代 Python 项目已逐步摒弃冗余的 typing 泛型别名导入。
1. 原生容器泛型化(Python 3.9+)
在旧版 Python 中,复合容器必须从 typing 模块导入首字母大写的类型别名(例如 from typing import List, Dict, Set)。在现代标准写法中,原生内建类型直接充当泛型容器,代码更为精炼:
# 现代标准写法(Python 3.9+)
def process_tags(tags: list[str]) -> dict[str, int]:
    return {tag: len(tag) for tag in tags}

# 旧版写法(不再推荐)
from typing import List, Dict
def process_tags(tags: List[str]) -> Dict[str, int]: ...
2. 管道运算符表达联合类型与空值(Python 3.10+)
过去表示“多选一类型”或“可能为 None”时,需要使用 Union[A, B] 或 Optional[A]。现代写法采用位或管道符 |,语义清晰且表达直观:
# 现代标准写法(Python 3.10+)
def find_record(identifier: int | str) -> dict[str, str] | None:
    if isinstance(identifier, int):
        return {"id": str(identifier)}
    return None

# 旧版写法
from typing import Union, Optional
def find_record(identifier: Union[int, str]) -> Optional[dict[str, str]]: ...
版本向下兼容提示:若项目需要在 Python 3.7 或 3.8 等早期版本中提前使用 list[str] 或 str | None 等新语法,只需在源文件最顶部引入 from __future__ import annotations。该特性使得 Python 将注解作为惰性字符串存储,从而在运行时不会触发类型解析错误。
3. 元组的定长与不定长注解区别
元组(tuple)在 Python 类型注解中具有特殊规则:
- 固定长度与类型位置绑定:若元组具有固定的成员数量与顺序,需按位置列举全部类型。例如
tuple[str, int, bool]表示三元组,第一项为字符串,第二项为整数,第三项为布尔值。 - 同构不定长元组:若元组长度不确定但所有元素类型相同,使用省略号
...表示。例如tuple[int, ...]。
三、架构设计准则:入参宽容与返回值严格
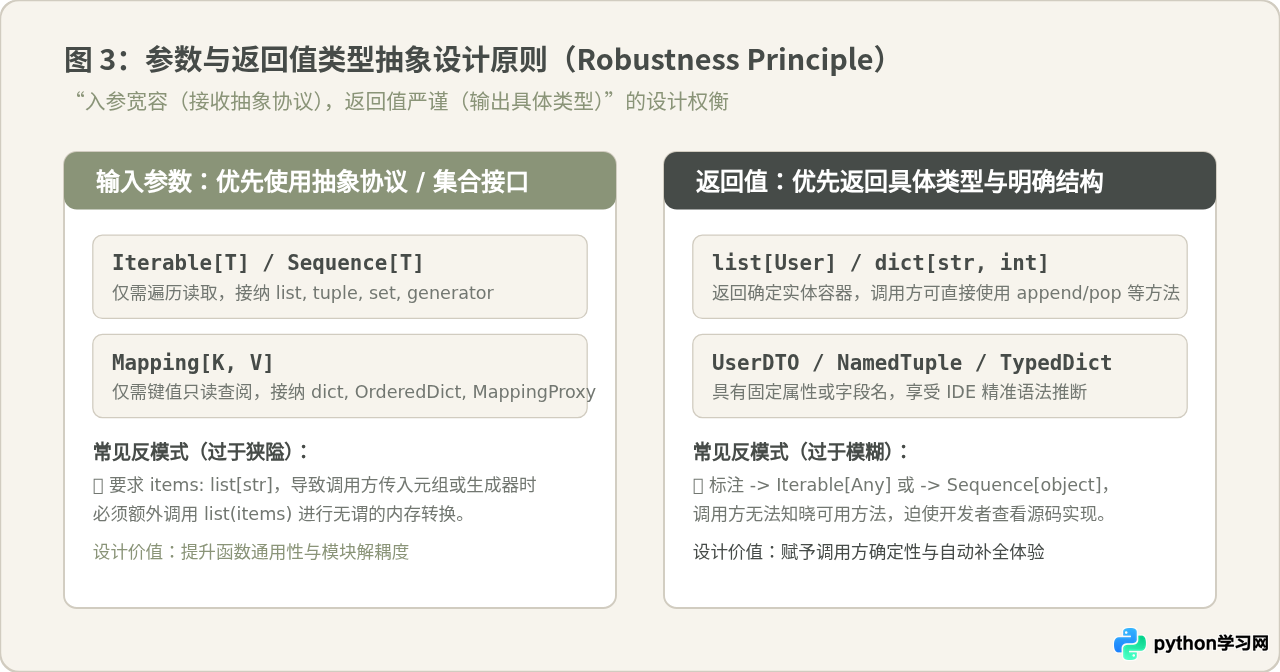
在编写业务函数或公共 SDK 时,类型注解不仅服务于静态检查,更定义了模块之间的接口契约。良好的工程实践遵循健壮性原则(Postel's Law):接受输入时尽量宽容,产出返回值时尽量严格。
1. 入参优先使用抽象协议
如果函数内部仅对参数执行遍历、读取长度或按键查询等操作,应优先选择 collections.abc 提供的抽象基类,而非具体类:
| 参数操作需求 | 推荐抽象注解 | 兼容的具体实参 | 不推荐的狭隘注解 |
|---|---|---|---|
| 仅单次遍历 (for x in obj) | Iterable[T] |
list, tuple, set, generator, range | list[T] |
| 索引读取与长度计算 (obj[i], len(obj)) | Sequence[T] |
list, tuple, str, bytes | list[T] |
| 键值只读查阅 (obj[k], obj.get(k)) | Mapping[K, V] |
dict, MappingProxy, OrderedDict | dict[K, V] |
反例分析:若将参数标为 def calculate_mean(scores: list[float]) -> float:,那么当调用方持有一个由生成器产生的数据流或元组时,静态检查器就会报错,迫使调用方执行多余的 calculate_mean(list(scores)) 转换,白白浪费内存与时间。
2. 返回值优先保持具体明确
与参数相反,函数返回的数据应当尽可能精准具体。若函数实际返回一个列表,应直接标注为 -> list[User],切勿泛化为 -> Sequence[User] 或 -> Iterable[User]。这样调用方在获得结果后,能够直接使用列表专有的 append、sort 等原生方法,且 IDE 能给出毫无歧义的成员补全。
3. Any 与 object 的边界辨析
当参数可能接受任意类型的数据时,不少人习惯使用 typing.Any。但 Any 和 object 存在根本性的语义差异:
Any表示关闭类型检查。对Any类型的变量执行任意属性访问或方法调用,静态检查器均不会报错,容易使类型防线被击穿。object是 Python 中所有对象的顶层基类。使用object表示函数可以接受任何对象,但函数体内不允许在未做isinstance类型收窄前调用该对象的特有方法,能够有效保障类型安全。
四、常见易混淆说法与条件辨析
在日常开发与技术讨论中,围绕类型注解存在一些流传甚广但需要严谨修正的观点:
说法辨析 1:“类型注解会在程序运行时校验并拦截非法传入参数”
为何看似合理:在很多强静态编译语言(如 Java、C#)中,传入错误类型会直接阻止编译或抛出异常。初学者往往认为 Python 标注了 age: int 之后,传入字符串就会崩溃。
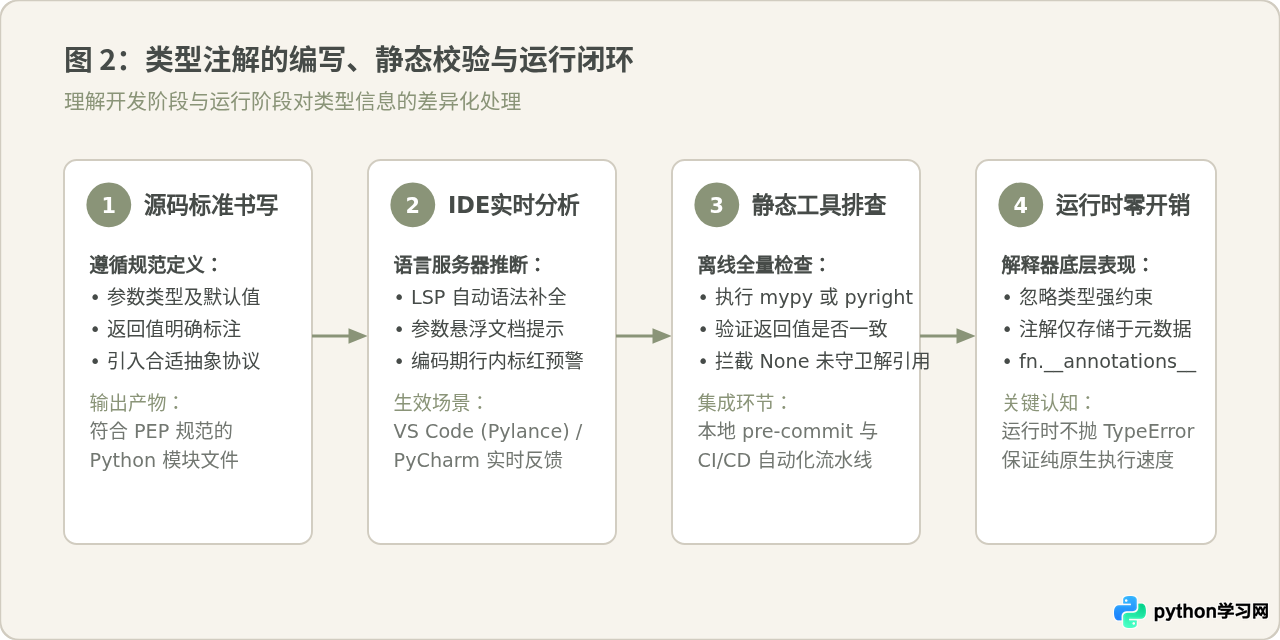
条件修正:原生的 Python 解释器在运行时是完全忽略类型注解的。解释器仅仅在函数对象建立时将注解解析并存入 __annotations__ 字典属性中,不会在调用期间做任何类型断言或校验。如果需要在运行时严格校验数据格式(例如 Web API 请求反序列化),应借助第三方数据校验库(如 Pydantic)或显式编写 isinstance() 检查。
说法辨析 2:“参数默认值为 None 时,无需额外标注可选类型”
为何看似合理:在早期某些老旧检查器版本中,存在参数如果指定了 = None 默认值就会隐式推断为 Optional 的行为。
条件修正:在当前的 PEP 484 规范及现代静态检查器(mypy/pyright)中,隐式推断已被严格禁用。如果默认值为 None,类型声明中必须显式包含 None:
# 规范做法
def fetch_token(seed: str | None = None) -> str: ...

# 不合规做法(mypy 在严格模式下会报警)
def fetch_token(seed: str = None) -> str: ...
说法辨析 3:“没有返回值的函数,写不写 -> None 都一样”
为何看似合理:不写返回值注解时,Python 函数在执行到底部时同样会返回 None,运行结果看似没有区别。
条件修正:对于静态检查器而言,不写注解意味着该函数的返回值类型是未标注的(隐式推导为 Any)。一旦调用方误将该函数的返回值赋给变量并进行调用,检查器无法及时发出警告。只有显式注明 -> None,调用方尝试读取其返回值时才能被检查器精准拦截。
五、工程落地与静态检查实操
书写完标准类型注解后,建议在项目中引入标准静态分析工具,以便在代码提交前形成自动化质量闭环:
# 安装主流静态类型检查工具
pip install mypy

# 对指定模块运行静态检查
mypy service.py --strict
在持续集成(CI)流程或 Git pre-commit 钩子中加入静态类型校验步骤,能够在单元测试执行之前迅速捕获约 40% 的常见接口对接与属性拼写错误,真正发挥类型注解在大型工程中的规范价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









