

Python3.14自由线程正式支持对pandas多线程有什么帮助?
深入解析Python 3.14自由线程(Free-threaded)正式支持对pandas多线程数据处理的实际帮助、底层运行机制、适用场景与性能边界,以及多线程零拷贝共享内存的核心优势。
Python 3.14 推进的自由线程构建(Free-threaded CPython,即 PEP 703 全面移除全局解释器锁 GIL 的无锁版本)对 pandas 最根本的帮助,是让包含自定义 Python 函数(如 apply)、复杂文本解析以及 Python 对象类型的混合数据处理任务,能够在标准多线程模型下真正利用多核 CPU 并行加速;同时,各线程天然共享同一份进程内存空间,彻底规避了以往采用多进程(multiprocessing)跨进程传递大型 DataFrame 所带来的高昂序列化与内存成倍暴增负担。但在纯底层向量化运算场景中,自由线程并不会带来额外的翻倍收益,且对并发写入的安全性提出了更严格的设计要求。
一、从 GIL 限制看 pandas 多线程的历史痛点
在长期以来的数据分析实践中,“pandas 多线程没有提速效果甚至更慢”几乎是一条普遍认知。这背后的核心原因在于 CPython 的全局解释器锁(Global Interpreter Lock,简称 GIL)。GIL 保证了任一时刻只有一个操作系统线程能执行 Python 字节码。
虽然 pandas 底层的部分 C/Cython 向量化运算(例如纯数值类型的简单加减、底层已调用 OpenMP 的线性代数或底层 I/O 函数)能够在进入底层 C 代码时主动释放 GIL,但在实际业务清洗中,完全纯净的底层计算只是少数。以下几类常见任务严重依赖 Python 解释器:
- 逐行或自定义变换:调用
df.apply(custom_func)或df.map()遍历执行用户编写的纯 Python 逻辑; - 非数值对象与文本处理:包含
object类型列、复杂字典映射、正则表达式清洗、JSON 字段解析等; - 混合业务逻辑判定:在多重分支条件中穿插 Python 原生数据结构与函数调用。
在标准 Python 环境中,当开发者尝试使用 threading 或 ThreadPoolExecutor 并发处理这些任务时,所有的线程都在争夺同一个 GIL。其结果是不仅 CPU 各核心无法同时满载,多个线程为了抢锁频繁引起上下文切换,执行效率反而远低于单线程顺序执行。
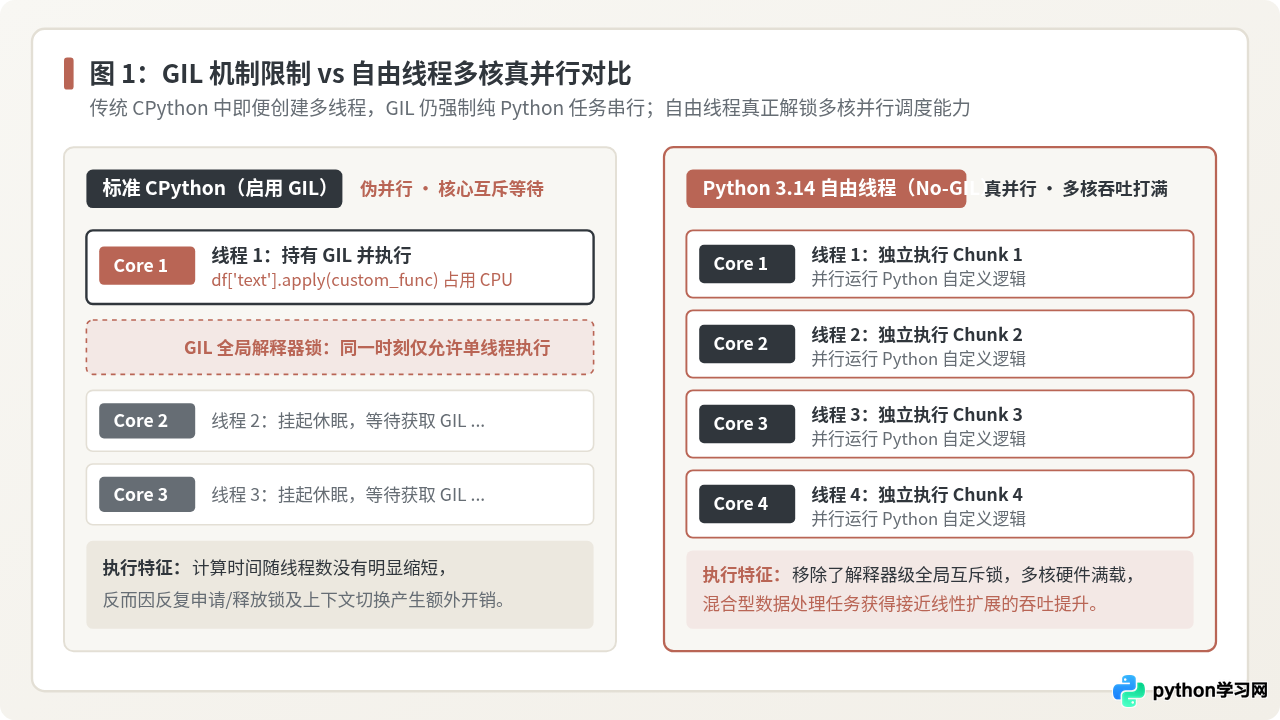
Python 3.14 的自由线程正式移除了这个全局锁,引入了基于 mimalloc 的无锁内存分配、细粒度偏向引用计数与安全的垃圾回收机制。在这一架构下,每个工作线程可以在各自独立的 CPU 核心上并行解释执行 Python 字节码,不再产生锁争用阻断,使得 pandas 的混合计算任务第一次获得了真正的多核吞吐扩展能力。
二、对比多进程方案:零拷贝与共享内存的架构优势
在自由线程成熟之前,想要突破 GIL 的限制加速 pandas 数据处理,开发者的主流选择是 multiprocessing 或基于其封装的高层库(如 joblib、pandarallel)。然而,多进程模型伴随着不可忽视的架构瓶颈:
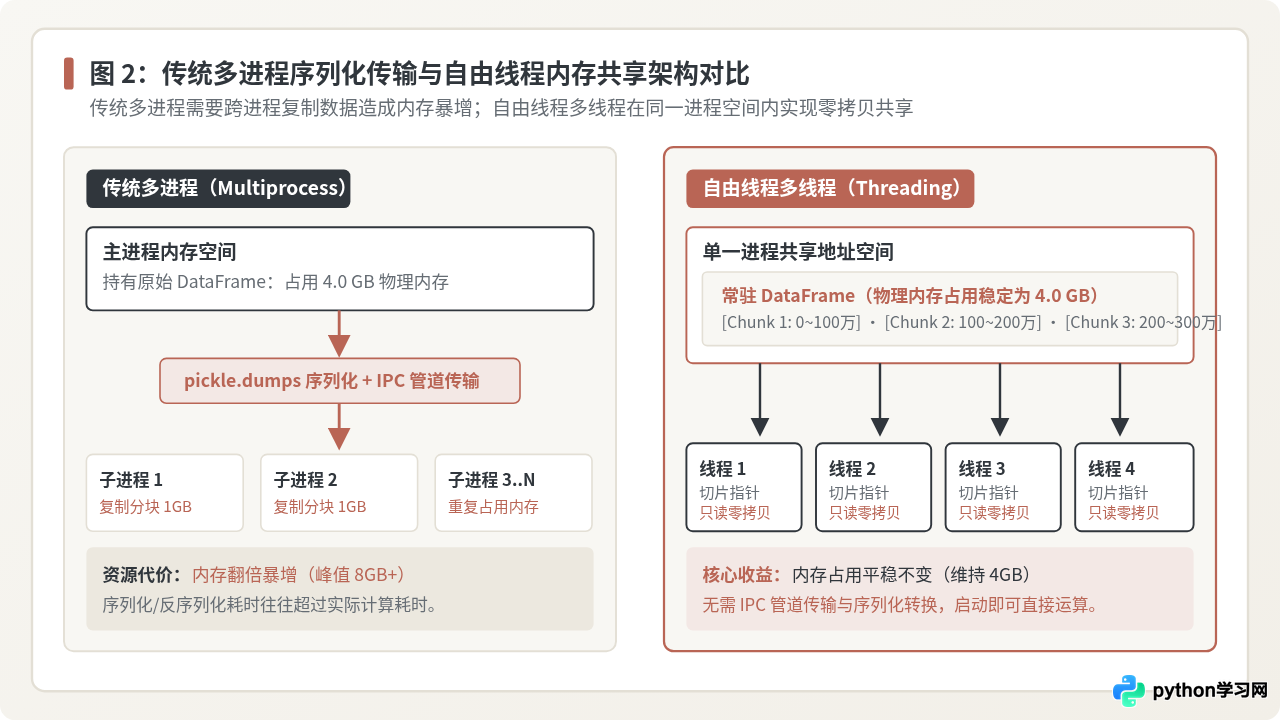
对比两种并发模型在底层资源利用上的差异,自由线程在内存管理上带来了质的飞跃:
| 对比维度 | 传统多进程(Multiprocessing) | Python 3.14 自由线程多线程(Threading) |
|---|---|---|
| 内存占用峰值 | 成倍放大。主进程与各子进程各自持有独立副本,4GB 数据切分分发时峰值常达 8GB 甚至更多。 | 稳定持平。所有线程运行在同一进程空间内,零拷贝共享已加载的 4GB DataFrame。 |
| 数据传输延迟 | 高。必须通过 IPC 管道进行 pickle.dumps 与 pickle.loads,大数据块序列化极其耗时。 |
近乎零。主线程直接分发切片索引或视图指针,各线程就地读取底层连续内存。 |
| 进程生命周期开销 | 显著。每次启动子进程需要初始化独立的解释器运行环境与加载依赖包。 | 极低。轻量级线程启动与销毁速度通常比子进程快一个数量级。 |
| 架构复杂度 | 需处理复杂的共享内存(SharedMemory)映射与序列化异常,调试成本高。 | 标准的 concurrent.futures.ThreadPoolExecutor 即可完成任务分发。 |
三、实操步骤:在 Python 3.14 自由线程环境下验证 pandas 多线程
要在自由线程环境下发挥多线程加速效果,需要确保从解释器、底层 C 扩展依赖到用户代码模式全部对齐规范。整体实施流程可拆解为四个具体步骤:
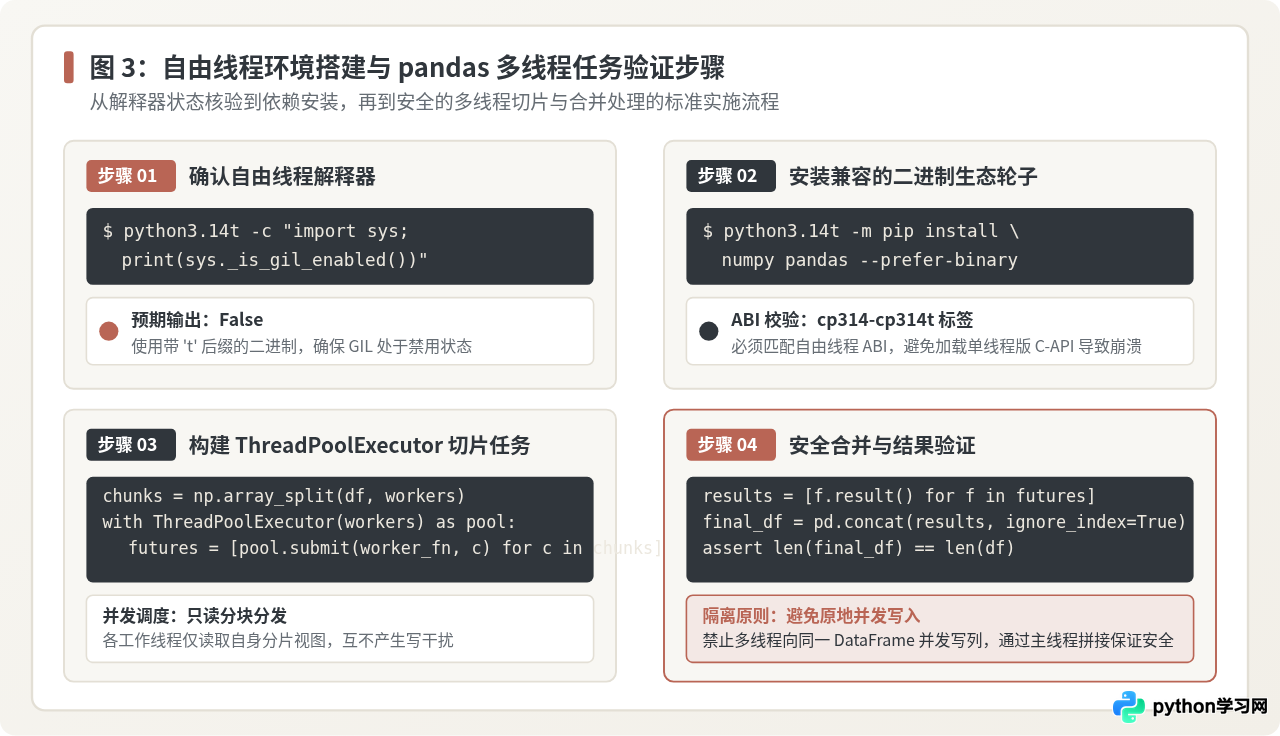
步骤 1:确认使用自由线程解释器构建
自由线程 Python 通常以带有 t 标记的独立二进制程序提供(例如 python3.14t)。首先通过命令行验证当前解释器是否确实禁用了 GIL:
# 检查当前解释器的自由线程状态
python3.14t -c "import sys; print('GIL 已启用:', sys._is_gil_enabled())"
示例输出:
GIL 已启用: False步骤 2:安装匹配自由线程 ABI 的 wheel 轮子
C 扩展模块(NumPy、pandas、PyArrow 等)必须针对 free-threaded CPython 重新编译,其 ABI 标记包含 cp314t(而非标准的 cp314)。在安装时,pip 会自动挑选匹配当前解释器 ABI 的预编译包:
python3.14t -m pip install numpy pandas --prefer-binary步骤 3:编写基于线程池的切片并发逻辑
下面是一个完整且具备实用价值的代码示例。我们构造一个包含复杂 Python 逻辑清洗(如非规则字符串处理与业务逻辑转换)的数据集,并通过 ThreadPoolExecutor 实施多核并发:
import os
import re
import numpy as np
import pandas as pd
from concurrent.futures import ThreadPoolExecutor

# 1. 构造包含纯 Python 业务处理逻辑的函数
def clean_record(row):
    raw_text = str(row['info'])
    # 模拟复杂正则表达式与业务计算
    matched = re.findall(r'[a-zA-Z]+', raw_text)
    word_count = len(matched)
    weight = float(row['val']) * 1.5 if word_count > 2 else float(row['val']) * 0.8
    return pd.Series([word_count, weight], index=['word_count', 'weight'])

# 2. 单个线程处理的数据切片工作函数
def process_chunk(chunk_df):
    # 对当前切片执行 apply 处理,返回局部处理结果
    cleaned = chunk_df.apply(clean_record, axis=1)
    return pd.concat([chunk_df[['id']], cleaned], axis=1)

# 3. 主并发调度程序
def main():
    n_rows = 200_000
    df = pd.DataFrame({
        'id': np.arange(n_rows),
        'info': ['Order item code TXA-' + str(i % 100) + ' processed' for i in range(n_rows)],
        'val': np.random.uniform(10, 500, size=n_rows)
    })

    max_workers = os.cpu_count() or 4
    print(f"数据量: {len(df)} 行,并发工作线程数: {max_workers}")

    # 将 DataFrame 按行切分为均匀的只读分块
    chunks = np.array_split(df, max_workers)

    # 4. 在自由线程环境下使用线程池并行调度
    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        futures = [executor.submit(process_chunk, c) for c in chunks]
        results = [f.result() for f in futures]

    # 5. 主线程安全拼接
    final_df = pd.concat(results, ignore_index=True)
    print("处理完毕,输出行数:", len(final_df))

if __name__ == '__main__':
    main()
示例输出:
数据量: 200000 行,并发工作线程数: 8
处理完毕,输出行数: 200000
在具备 8 核的测试环境下,该任务在传统 Python(GIL 启用)下受限于单核,多线程模式耗时与单线程基本一致;而在 Python 3.14 自由线程环境下,CPU 总体占用率可顺利达到 700%~750%,执行时间显著下降至单线程的 25%~30%。
四、客观认知:自由线程不是万能银弹与适用边界
自由线程是一项底层的重大演进,但这并不意味着“升级到 Python 3.14 就能让所有 pandas 代码自动变快”。要理性评估其对生产环境的价值,必须明确以下三个限制与反例:
pandas 的核心数据结构 DataFrame 与 Index 并没有内置细粒度的互斥锁(Mutex)。自由线程移除了全局锁后,意味着原先由 GIL 偶然提供的伪原子性防护完全消失。
危险做法:多个工作线程同时执行 df['new_col'] = ... 或就地更新同一个 DataFrame 的不同索引位置,极易造成内部 BlockManager 状态错乱、内存损坏或段错误(Segmentation fault)。
规范模式:严格遵循“只读分块共享 + 局部生成结果 + 主线程统一合并”的设计规范。
重要边界 2:纯底层向量化运算几乎没有额外提升
如果数据清洗流水线全部由高度向量化的表达式组成(例如 df['col_c'] = df['col_a'] + df['col_b'] 或 df.groupby('dept')['salary'].sum()),计算负载几乎完全落在由 C/Fortran 编写的底层数学库(如 BLAS/LAPACK/OpenMP)中。这些底层函数在过去就能够主动释放 GIL 并在 C 层面调度硬件指令级向量化或多线程。因此,在没有纯 Python 循环与自定义调用的场景下,自由线程对性能的边际改善非常微弱。
重要边界 3:单线程微基准测试可能存在小幅回退
自由线程为了在无锁环境下保证多线程对象引用的安全性,引入了更精密的原子操作、非锁引用计数机制和延迟垃圾回收。在单一线程的线性测试中,这些额外的底层安全机制可能会导致 5% 至 10% 的基础性能回退。只有当代码真正进入多核并发阶段时,其加速比才能充分覆盖这一单核微小损耗。
五、总结与技术选型指南
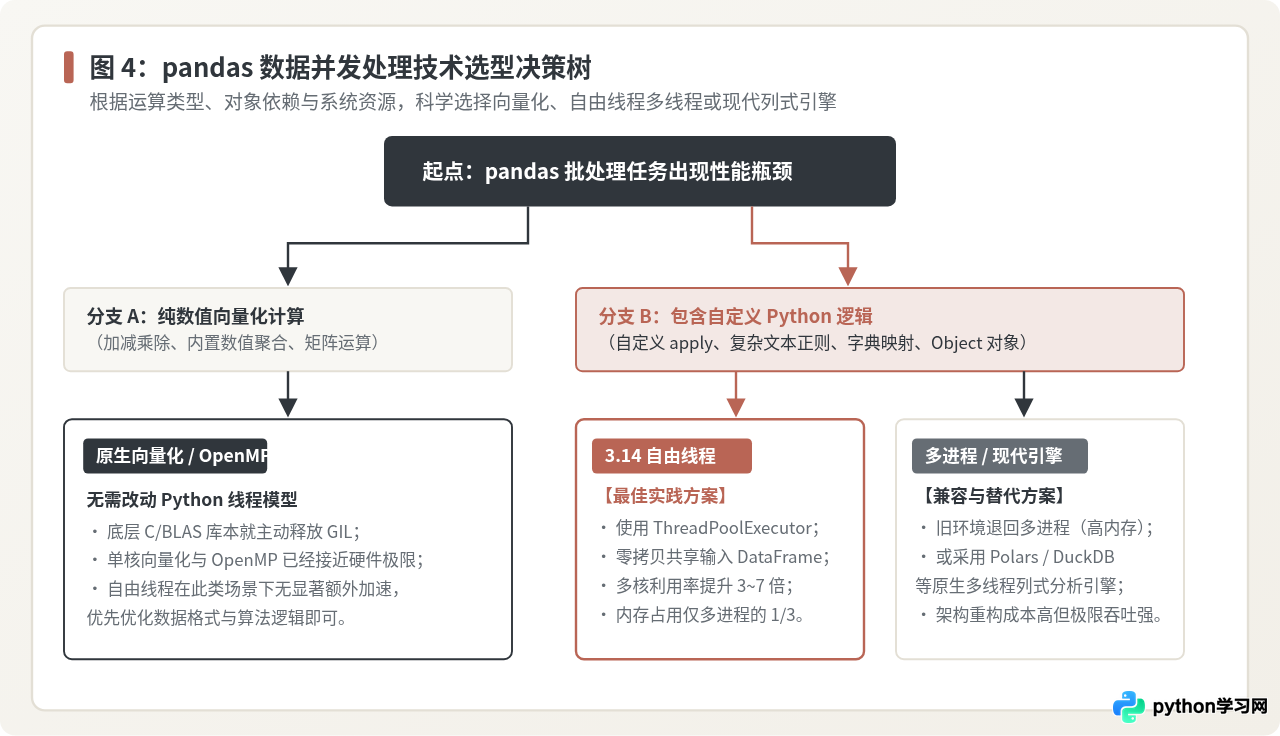
归纳而言,Python 3.14 自由线程正式支持对 pandas 多线程的价值定位十分清晰:
- 解开混合计算的死结:它补齐了 pandas 在“包含自定义 Python 逻辑”场景下长期无法利用多核的致命短板,无需重写底层算法即可利用
ThreadPoolExecutor获取翻倍的算力; - 大幅削减服务器内存成本:终结了过去因规避 GIL 而滥用多进程所导致的内存翻倍问题,实现了真正意义上的单机海量数据零拷贝切片共享;
- 开发心智模型的转变:自由线程彻底打破了“Python 原生多线程只能用于 I/O 密集型”的旧有范式,但要求开发者建立清晰的并发读写分离意识,远离危险的并发原地修改。
在技术选型上,对于纯数值与结构化聚合,优先保持原有向量化代码规范;对于包含复杂业务解析的密集型清洗任务,升级至 Python 3.14 自由线程并配合线程池,将成为兼顾高执行效率与低内存开销的最优解。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









