

怎么在现有Python代码中逐步引入类型注解
在现存Python项目中引入类型注解的最佳实践与落地步骤:从配置基础检查工具开始,通过核心工具函数切入,逐步收紧检查级别并接入CI流水线。
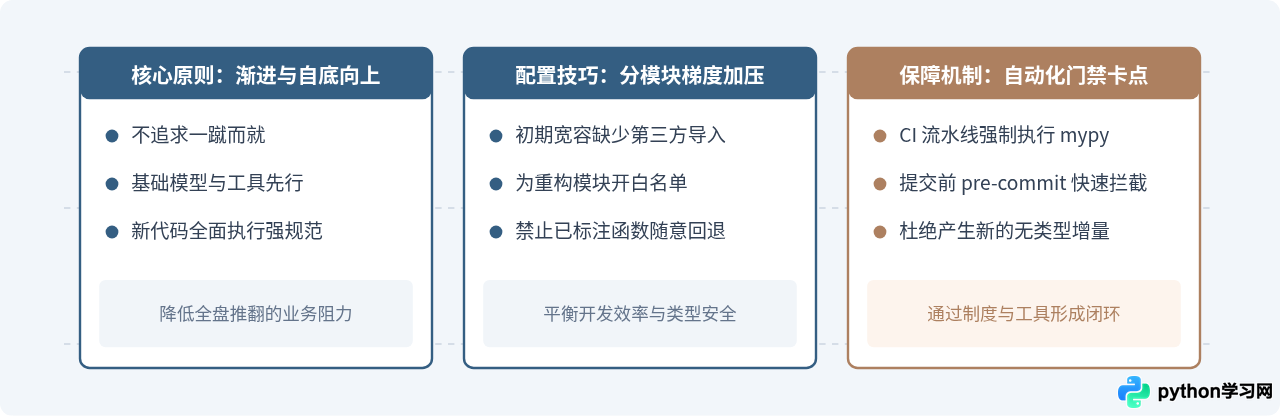
在已经稳定运行的现有 Python 代码库中,试图一次性为所有文件补全类型注解不仅耗时巨大,而且极易引入非预期的类型报错甚至运行时回归。可落地的解决方案是渐进式类型引入(Gradual Typing):先配置静态检查工具设立安全基线,针对新增代码与高频底层工具函数率先添加注解,结合逐模块放行策略建立防线,最后在持续集成(CI)中固化质量门禁。
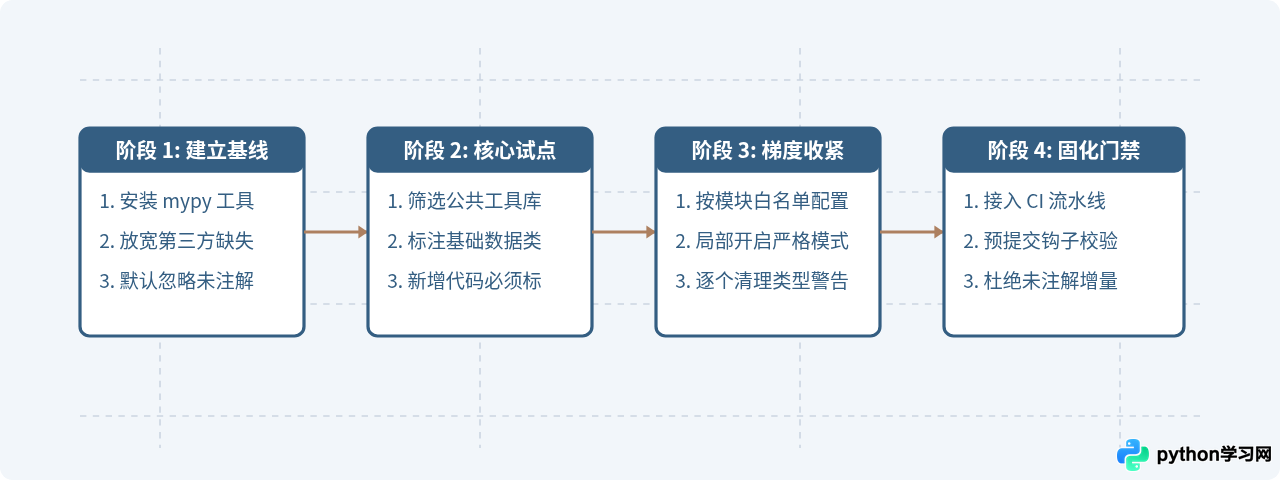
一、整体推进步骤与落地流程
为旧代码补全类型注解不能凭感觉随意修改,而需要分为四个清晰阶段:搭建检查基线、确立第一批核心试点、模块化梯度推进、以及在 CI/CD 中纳入阻断校验。这样既能保证业务迭代不中断,又能让代码质量稳步提升。
二、配置检查器:设立“只告警不崩溃”的初始基线
引入类型注解的第一步是安装静态分析器 mypy。如果直接对老代码执行默认的 mypy .,控制台通常会喷出成百上千条错误,导致开发者产生挫败感。
此时需要通过项目根目录的 mypy.ini 或 pyproject.toml 配置一套“温和”的初始规则,确保未做注解的旧函数不会直接报错,同时忽略没有类型存根(stubs)的第三方依赖。
# mypy.ini
[mypy]
# 允许代码在缺少类型注解时正常通过
check_untyped_defs = false
disallow_untyped_defs = false

# 避免第三方缺少 typing 的库报错(如 requests, yaml 等)
ignore_missing_imports = true

# 抑制过于严苛的转换警告
warn_unused_ignores = true
warn_redundant_casts = true
完成配置文件编写后,在终端执行以下检查命令:
mypy src/预期效果:在宽松配置下,mypy 仅对已经写了类型注解且存在显式类型冲突的地方给出提示,而不会因为大量未标注的函数中断检查。
三、切入点选择:模块依赖拓扑与标注优先级
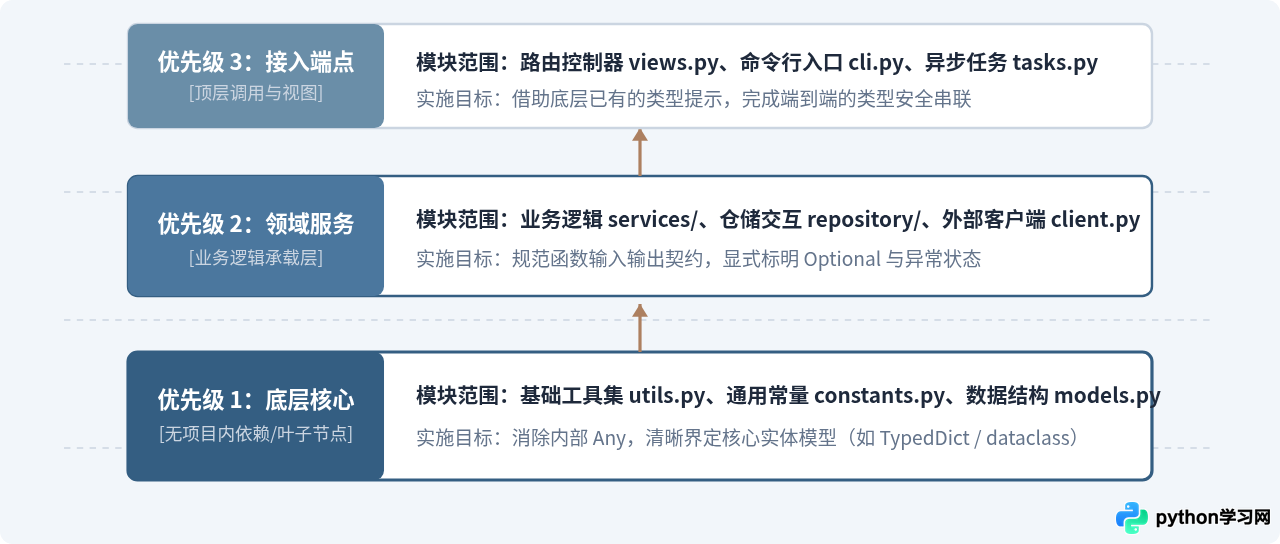
在现有系统中,盲目挑选业务层或视图层代码进行标注往往事倍功半,因为业务逻辑高度依赖底层的基础设施和通用工具。一旦底层类型未定义,业务层就会充斥大量的 Any,使类型提示形同虚设。
科学的实施路线应当遵从自底向上的拓扑顺序:从无任何内部依赖的叶子节点(如核心数据模型、公共工具函数)开始标注,逐步向上覆盖到服务层和接入层。
四、具体代码改造示例:由动态到强类型的演变
在现有代码中,最常见的问题是泛用普通字典(dict)传递参数,或者函数返回兼具数据与 None 却没有明确说明。下面通过一个具体的改造例子演示平滑过渡的技巧。
改造前:缺乏约束的动态代码
# 改造前:参数与返回值类型完全未定义,调用方难以预知字段与空值
def fetch_user_profile(user_id, include_meta=False):
    if user_id <= 0:
        return None
    profile = {"id": user_id, "name": "Anonymous"}
    if include_meta:
        profile["meta"] = {"login_count": 1}
    return profile
改造后:精确定义契约与可选类型
在 Python 3.9 及以上版本中,建议直接使用内建集合类型;对于结构化字典,推荐使用 TypedDict。
from typing import Optional, TypedDict

class UserMeta(TypedDict):
    login_count: int

class UserProfile(TypedDict, total=False):
    id: int
    name: str
    meta: UserMeta

def fetch_user_profile(user_id: int, include_meta: bool = False) -> Optional[UserProfile]:
    if user_id <= 0:
        return None
    profile: UserProfile = {"id": user_id, "name": "Anonymous"}
    if include_meta:
        profile["meta"] = {"login_count": 1}
    return profile
五、局部逐级收紧:利用 mypy 模块覆盖机制
当核心工具类与数据模型已完成改造后,我们不能停留在全局宽松模式下。mypy 允许在配置文件中按模块精细化覆盖规则(Per-module Options)。
这样可以对已经改造完毕的模块开启严格校验(如禁止未类型化的函数定义),而对其他未改造模块继续保持宽容:
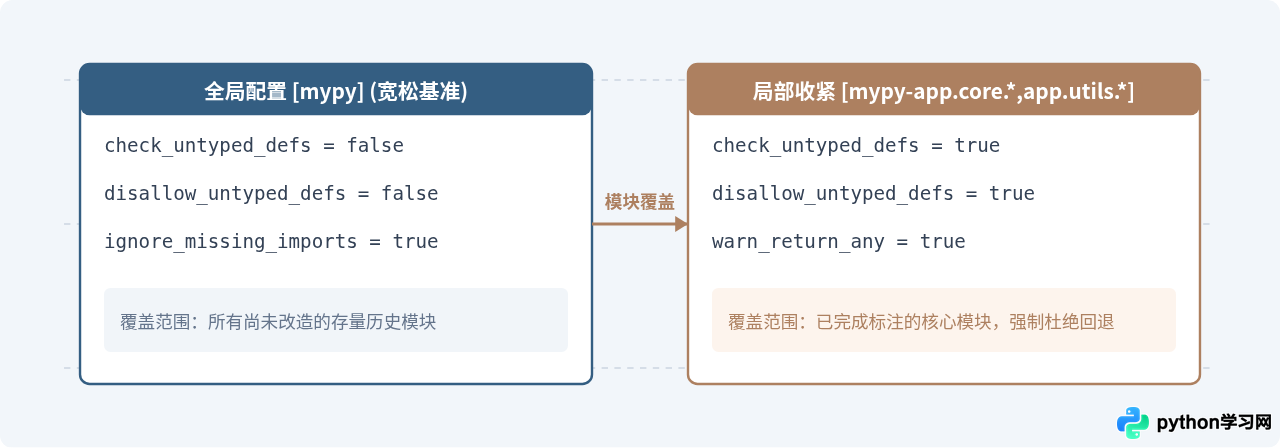
在配置文件中具体书写方式如下:
# 对已经重构完成的模块启用强校验
[mypy-app.core.*]
disallow_untyped_defs = true
check_untyped_defs = true

[mypy-app.utils.*]
disallow_untyped_defs = true
check_untyped_defs = true
六、防线守住:CI自动化校验与流程集成
类型注解的成果极易被后续快速迭代的代码稀释。为了保住战果,必须在日常开发流程中设置两道检查防线:
- 本地预提交钩子(pre-commit):限制开发者提交前仅针对修改的文件执行快速类型分析。
- 持续集成流水线(CI):在每次 Pull Request 或合并前全量执行类型检查,一旦白名单内的模块发生类型错误则直接阻断合并。
例如,在 GitHub Actions 中配置 CI 检查步骤:
name: Type Check
on: [push, pull_request]

jobs:
  mypy:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Set up Python
        uses: actions/setup-python@v5
        with:
          python-version: '3.11'
      - name: Install dependencies
        run: |
          pip install -r requirements.txt
          pip install mypy
      - name: Run Mypy
        run: |
          mypy src/
七、实施关键要点与避坑总结
在现有工程中推行类型注解时,有几个常见误区需要特别留意:
- 警惕
Any的传染性:如果一个函数标注了返回Any,所有调用它的下游代码都会失去静态类型检查的保护。遇到复杂类型应优先考虑Union、泛型TypeVar或结构化TypedDict,尽量不要退回Any。 - 避免改变运行时行为:Python 的类型注解本质是元数据,不应对运行时产生副作用。不要在类型标注中引入沉重的计算或可能引发循环导入的非类型化业务模块;在必要时使用
if typing.TYPE_CHECKING:隔绝导入。 - 新代码新标准,旧代码有排期:团队应形成约定:所有新创建的 Python 文件必须具备 100% 的类型注解覆盖并满足严格模式,旧文件的改造则与常规重构和需求排期绑定,避免全员停工突击重构。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









