

Python 2.7函数定义与模块导入基础详解
深入详解 Python 2.7 环境下的函数定义语法、默认参数与可变参数机制、LEGB作用域模型,以及模块与包的底层加载路径、sys.modules 缓存机制与 import 和 from ... import 的核心差异对比。
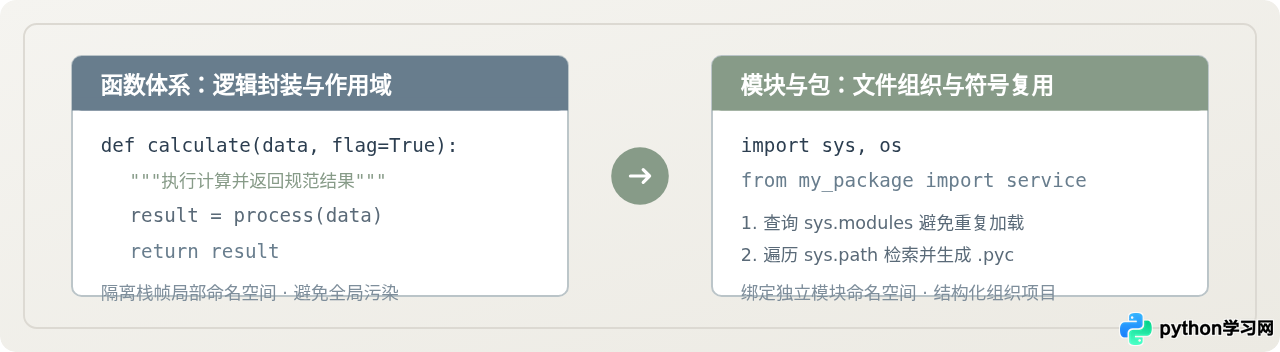
.py 文件为物理载体汇集函数、类与全局常量,借助导入机制按需分发。本文围绕 Python 2.7 解释器的实际执行流程,详细拆解 def 函数定义的参数解析规则、默认参数的编译期绑定陷阱与 LEGB 作用域模型,并剖析模块搜索路径(sys.path)、加载缓存(sys.modules)、两种核心导入语法的底层差异以及包的组织规范。
一、函数的基本定义与返回值机制
在 Python 2.7 中,函数通过关键字 def 进行声明,紧随其后的是函数标识符、包含在圆括号内的形参列表以及作为语句块开始的冒号。紧跟函数头的第一行通常推荐书写三引号文档字符串(Docstring),该字符串在语法解析时会被自动挂载到函数对象的 __doc__ 属性上,供文档工具或内建函数 help() 动态读取。
函数体内部的代码只有在被调用时才会真正执行。Python 2.7 使用严格的缩进(通常为 4 个空格)划分代码块边界。函数通过 return 语句将计算结果交付给调用者;若函数执行完毕未遇到 return,或执行了无表达式的裸 return,解释器均会默认隐式返回内置单例对象 None。
# -*- coding: utf-8 -*-
# 执行环境:Python 2.7.18
# 文件名:func_basic.py

def calculate_tax(amount, rate=0.05):
    """根据金额与税率计算应纳税额及税后余额。"""
    if amount < 0:
        return 0.0, 0.0
    tax = amount * rate
    net = amount - tax
    # 在 Python 2.7 中,逗号分隔的多个返回值会被自动封装为一个 tuple
    return tax, net

# 1. 正常传入位置参数与默认参数
t, n = calculate_tax(100.0)
print "Tax:", t, "Net:", n

# 2. 覆盖默认参数
t2, n2 = calculate_tax(100.0, 0.1)
print "Custom Tax:", t2, "Custom Net:", n2Custom Tax: 10.0 Custom Net: 90.0
当一个函数需要返回多个数据时,Python 并不会在底层开辟多套通道,而是将多个逗号隔开的变量打包为一个不可变的 tuple。调用方既可以使用单一变量接收该元组,也可以利用序列解包(Unpacking)分别赋值给多个变量。
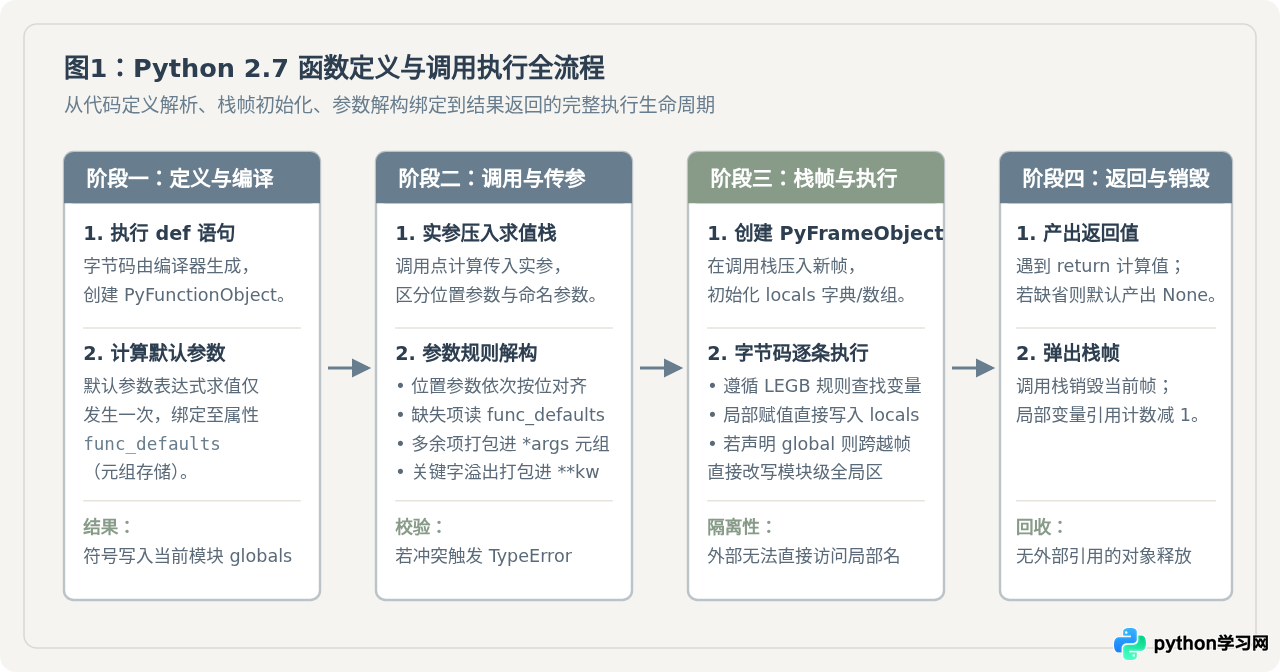
从图1 可以清晰地看出,def 语句在 Python 2.7 中属于可执行语句。只有当解释器自顶向下运行到 def 行时,才会在内存中构造出一个函数对象,并将函数名作为键写入当前模块的全局命名空间字典(globals())。此时,函数内部的代码并未运行,仅处于编译好的字节码状态。
二、形参体系与“可变默认参数”深度对比
Python 2.7 提供了丰富的形参定义形式,能够满足多样化的传参需求。在声明形参列表时,语法要求必须严格遵循先后顺序:
- 普通位置参数(Positional Arguments):必须按顺序传入,没有默认值。
- 默认参数(Default Arguments):为部分参数指定缺省值,调用时可省略。
- 可变位置参数(*args):将多余传入的位置参数打包为一个
tuple。 - 可变关键字参数(**kwargs):将多余传入的键值对实参打包为一个
dict。
# -*- coding: utf-8 -*-
# 执行环境:Python 2.7.18
# 文件名:args_demo.py

def dispatch_event(event_name, source="system", *tags, **metadata):
    print "Event:", event_name
    print "Source:", source
    print "Tags (tuple):", tags
    print "Metadata (dict):", metadata

# 执行调用
dispatch_event("login", "auth_service", "security", "audit", ip="192.168.1.10", status=200)Source: auth_service
Tags (tuple): ('security', 'audit')
Metadata (dict): {'status': 200, 'ip': '192.168.1.10'}
关键对比:可变默认参数 vs 不可变默认参数(None 占位惯用法)
在初学 Python 2.7 时,最普遍且隐蔽的缺陷之一是在函数定义中使用可变对象(如列表 [] 或字典 {})作为默认参数。为了理解该差异为什么极其重要,我们在相同的调用序列下对比以下两种做法:
做法 A:错误使用可变对象作为默认参数
def append_item(val, target_list=[]):
    target_list.append(val)
    return target_list

print append_item(1)
print append_item(2)
运行结果:第一次输出 [1],第二次输出 [1, 2]。
影响:后续所有使用默认参数的调用,都会共享并污染前一次调用的历史数据,造成灾难性的跨请求状态穿透。
做法 B:使用不可变对象 None 占位(标准做法)
def append_item(val, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(val)
    return target_list

print append_item(1)
print append_item(2)
运行结果:两次输出均稳定为独立的 [1] 和 [2]。
影响:每次调用若未传参,函数体内部都会全新实例化独立的列表对象,确保函数调用的无状态性与线程安全。
def 语句块时,默认参数表达式仅会被求值计算一次。求值得到的对象会被固化存储在函数对象的 func_defaults(元组)属性中。当调用函数而没有传递对应实参时,局部变量 target_list 直接指向 func_defaults 中已存在的同一个列表对象。因此,对该列表的 append 修改会直接改变该常驻对象的内容,导致在所有后续调用中互相影响。
三、变量查找规则与作用域机制(LEGB)
函数在每次被调用时,Python 2.7 虚拟机会为其分配一个全新的栈帧(PyFrameObject),栈帧内包含该函数运行所需的局部命名空间(Local Namespace)。在函数内部引用或修改一个变量时,解释器遵循严格的 LEGB 查找规则:
- L (Local) 局部作用域:在当前函数或 lambda 表达式内部声明的变量与形参。
- E (Enclosing) 嵌套外层作用域:若存在函数嵌套(闭包),指向外层非全局函数的局部变量。
- G (Global) 全局作用域:当前执行文件(模块)的模块级变量,即
globals()。 - B (Built-in) 内建作用域:Python 预定义的内置函数与异常,如
len、range、open等,即__builtin__模块所含符号。
静态编译绑定的局部变量陷阱:UnboundLocalError
很多开发者容易混淆“变量查找”与“变量赋值”。在 Python 中,作用域是由静态编译决定的,而不是运行时动态决定。如果在函数体的任何位置存在对变量的赋值操作(如 var = ...),编译器在将函数翻译为字节码时,就会把该变量直接标记为局部变量。
# -*- coding: utf-8 -*-
# 执行环境:Python 2.7.18
# 文件名:scope_err.py

counter = 10

def increment():
    # 试图先打印全局变量,随后再加 1
    print "Current counter:", counter
    counter = counter + 1

# 调用函数将触发运行时错误
# increment()
在这个例子中,因为函数体内部包含了 counter = ... 这一赋值动作,Python 2.7 编译器在解析阶段就判定 counter 是一个局部变量。当执行到 print counter 时,局部变量尚未被赋值,因此解释器直接抛出 UnboundLocalError,而绝对不会在此时“回退”去读取模块全局的 counter = 10。
如果确实需要在函数内部改写模块全局变量,必须显式使用 global 关键字通知解释器:
counter = 10

def increment():
    global counter
    print "Current counter:", counter
    counter = counter + 1

increment()
print "Updated counter:", counterUpdated counter: 11
nonlocal 关键字修改 Enclosing 作用域的变量;而在 Python 2.7 中并不存在 nonlocal 语法。如果嵌套函数需要修改外层函数的变量,Python 2.7 的通用工程方案是将该变量放入可变容器(如字典或单元素列表)中:
def make_accumulator():
    state = {'count': 0}
    def tick():
        state['count'] += 1
        return state['count']
    return tick
四、模块的创建与底层导入机制
在 Python 2.7 中,任何一个以 .py 为扩展名的源码文件都可以直接作为一个模块(Module)。模块的引入解决了两个核心问题:一是防止代码臃肿,将不同职责的函数和类归类到不同文件中;二是实现命名空间隔离,不同模块内部可以存在同名函数而不会产生命名冲突。
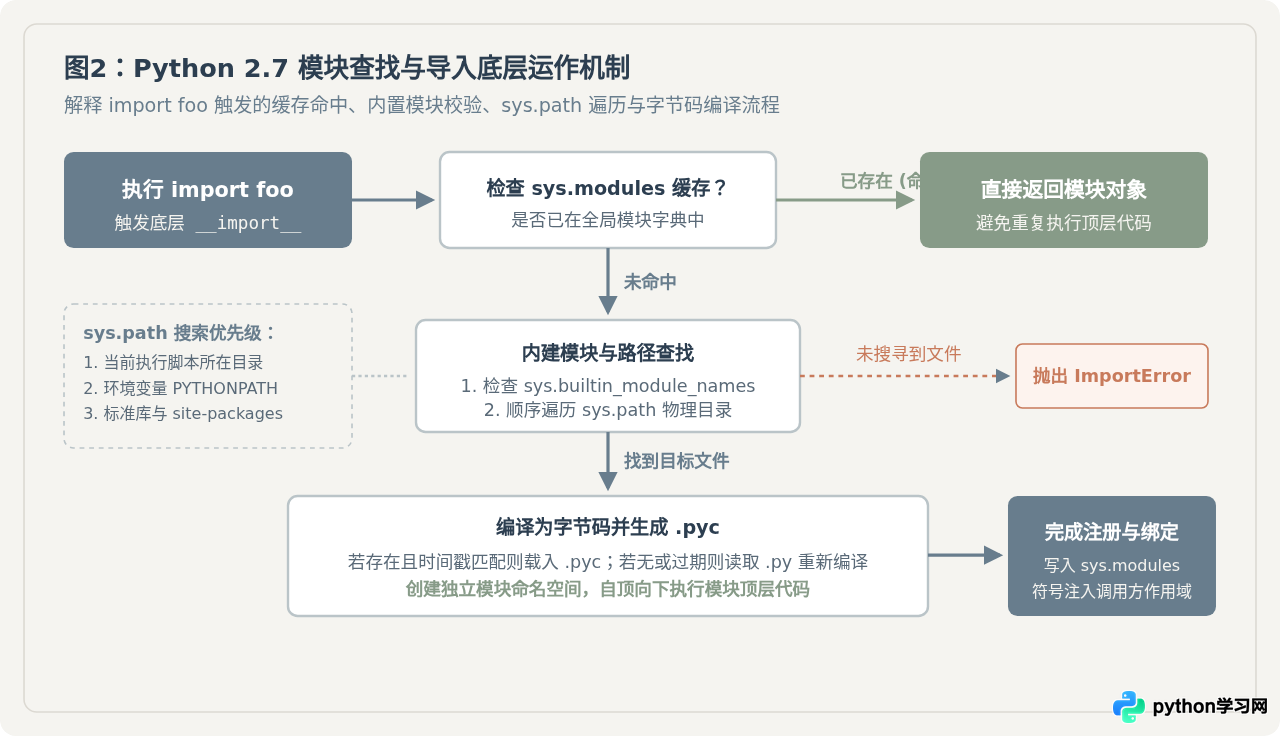
当执行 import my_module 时,Python 解释器在底层遵循以下严格的检索与加载逻辑:
-
第一步:检查全局缓存
sys.modules
sys.modules是一个全局字典,维护了当前 Python 进程所有已加载模块的映射。如果my_module已经在字典中,解释器将立即返回对应的模块对象,跳过后续所有查找和执行步骤。这是 Python 避免重复加载和保证单例特性的关键。 -
第二步:检查内建模块表
在sys.builtin_module_names元组中查找是否属于直接编译进 Python 解释器内部的 C 扩展模块(如sys、exceptions等)。 -
第三步:遍历
sys.path搜索物理路径
sys.path是一个包含物理目录字符串的列表。解释器按照列表中的先后顺序逐一检查目录下是否存在my_module.py、my_module.pyc或名为my_module的包目录。搜索顺序依次为:- 当前被执行脚本所在的绝对路径目录;
- 操作系统环境变量
PYTHONPATH指定的目录; - Python 2.7 安装目录中的标准库路径(例如
/usr/lib/python2.7); - 第三方依赖包目录
site-packages。
-
第四步:载入或编译字节码
.pyc
如果目标目录下已经存在对应的.pyc文件,且.pyc头部记录的时间戳与.py源码文件的修改时间完全一致,解释器直接读取加载.pyc;若.pyc不存在或源码已被改动,解释器会先在内存中将.py编译为字节码,并尝试将编译结果写回磁盘生成新的.pyc文件,以便后续启动加速。 -
第五步:执行模块顶层代码并完成注册
解释器为新模块创建独立的__dict__命名空间,自顶向下执行该文件内的所有顶层语句。执行完毕后,将该模块对象登记进sys.modules,并将模块名绑定到调用者的命名空间中。
模块自测防护守卫:if __name__ == '__main__':
因为在导入模块时,被导入文件中的所有顶层语句都会被直接执行一次,所以如果不加以限制,被导入模块中的测试调用或调试输出就会在导入端意外运行。Python 2.7 通过内置属性 __name__ 解决这一问题:
# -*- coding: utf-8 -*-
# 文件名:string_util.py
# 执行环境:Python 2.7.18

def strip_accents(text):
    """去除首尾多余空白字符并规范化。"""
    if not isinstance(text, basestring):
        return ""
    return text.strip()

# 模块自测代码守护块
if __name__ == '__main__':
    # 只有在该文件被终端直接运行时(python string_util.py),__name__ 才等于 '__main__'
    # 若被其他文件 import,__name__ 将为 'string_util',以下测试代码自动被跳过
    print "Running local unit test..."
    test_str = "  hello python 2.7  "
    assert strip_accents(test_str) == "hello python 2.7"
    print "Self test passed!"
五、两种导入语法的关键差异分析:import vs from ... import
在实际编写 Python 2.7 代码时,开发者常常在 import foo 与 from foo import bar 之间选择。这两者不仅仅是语法长短的差异,在底层的符号绑定、内存对象引用以及动态更新方面存在实质性的分歧。
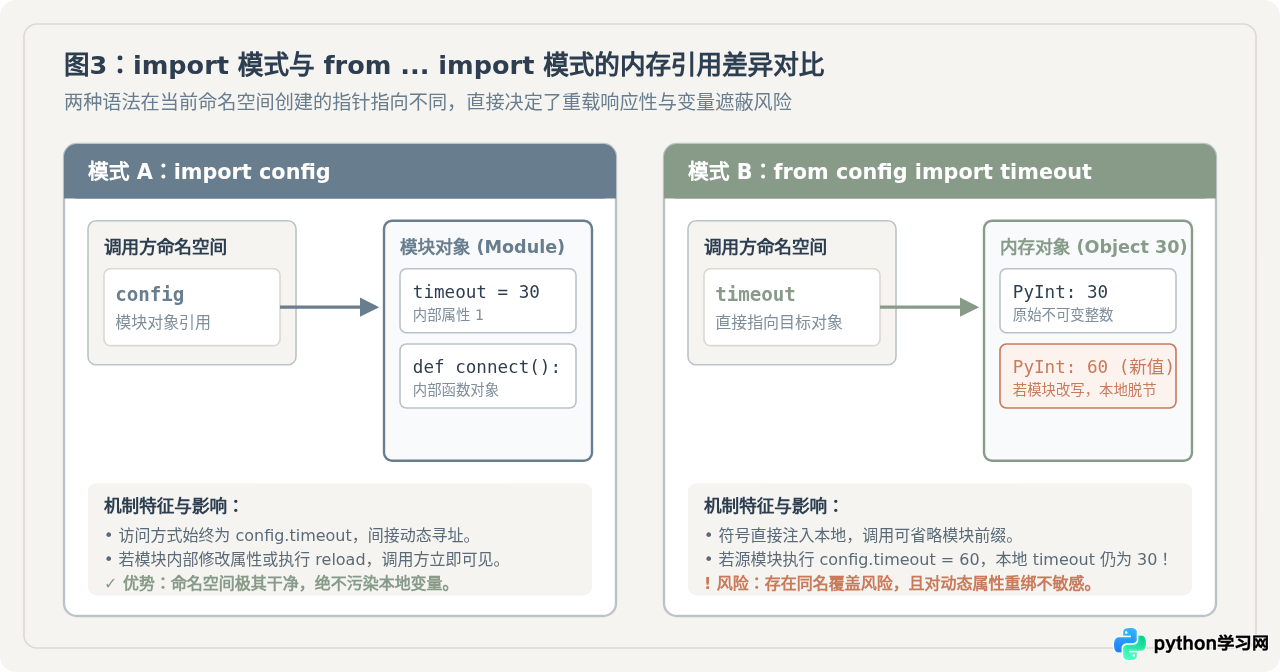
关键差异维度与影响
| 对比维度 | import foo | from foo import bar |
|---|---|---|
| 当前命名空间绑定的符号 | 仅绑定单个模块对象 foo。 |
直接绑定目标属性对象 bar。 |
| 属性访问方式 | 通过句点符间接动态寻址:foo.bar。 |
直接调用本地绑定的名称:bar。 |
| 模块属性动态重绑后的可见性 | 立即可见最新值。因为每次通过 foo.bar 访问都会实时查找模块属性字典。 |
无法感知变动。若 bar 是不可变对象(如数字、字符串),本地名称仍指向旧内存对象。 |
| 模块热重载 reload(foo) 响应 | 重载后 foo.bar 自动指向新加载的逻辑与对象。 |
重载后本地绑定的 bar 依旧指向旧对象,形成脱节。 |
| 命名空间污染与覆盖风险 | 极低。所有符号均位于 foo. 前缀之下,完全杜绝命名冲突。 |
较高。如果本地已有同名变量或函数,会被直接静默覆盖。 |
from foo import *)会将目标模块的所有公共属性直接倾倒进当前命名空间。在大型或长期维护的项目中,这会导致代码阅读者根本无法溯源函数的定义出处,且极易导致不同模块导出的同名符号发生相互覆盖,极难排查排错。
循环导入(Circular Import)的成因与解决方案
当模块 A 尝试导入模块 B,而模块 B 又在顶层导入模块 A 时,就会形成循环依赖。在 Python 2.7 中,若此时使用 from A import func_a,当模块 B 首次被 A 导入时,A 尚未完成全部顶层代码的执行,导致 B 在解析该行时找不到 func_a,从而抛出 ImportError: cannot import name func_a。
针对循环导入,工程上有两种稳妥的解决路径:
- 架构解耦(推荐):将 A 和 B 共同依赖的数据结构或公共函数剥离出来,放入第三个独立的底层模块(如
common.py或types.py),破坏循环链条。 - 延迟导入(Lazy Import):将
import语句移入具体函数体内。只有当该函数被实际调用时才触发加载,避开模块初始化时的死锁。
六、包(Package)的组织与 __init__.py 的作用
当项目的代码规模扩大,仅靠单层文件已难以清晰表达模块之间的隶属关系。Python 2.7 引入了“包(Package)”的概念,使用目录层级来组织模块。
在 Python 2.7 中,一个目录要被 Python 识别为一个合法的包,目录下必须包含一个名为 __init__.py 的文件(即便该文件完全为空)。如果缺少 __init__.py,解释器会将该目录视为普通文件系统文件夹,导入时会直接抛出 ImportError。
project_root/
│
├── main.py
└── database/
    ├── __init__.py       # 声明 database 为 Python 包
    ├── connection.py     # 数据库连接池模块
    └── models.py         # 数据模型模块
1. __init__.py 的三大核心职能
- 标识包边界:通知解释器将当前文件夹作为一个包处理。
- 控制暴露接口(API Gateway):在
__init__.py中预先导入子模块的关键类与函数,使用户可以直接使用import database; database.connect(),而无需层层书写长路径。 - 定义
__all__导出白名单:在__init__.py中定义字符串列表__all__ = ['connection', 'models'],明确规定外部执行from database import *时允许导出的具体符号。
2. Python 2.7 导入陷阱:隐式相对导入与 absolute_import
在 Python 2.7 早期版本中,如果当前模块目录中存在一个与标准库同名的文件(例如你自己写了一个 string.py 或 json.py),当你在同目录的其他模块中执行 import string 时,Python 2.7 会优先导入当前目录下的 string.py,而不是系统标准库中的 string 模块。这种现象被称为“隐式相对导入”(Implicit Relative Import),往往在标准库被遮蔽后引发难以定位的诡异属性错误。
为了杜绝此类安全隐患,在 Python 2.7 的所有现代工程文件中,强烈建议在源码的最顶部第一行添加以下未来特性声明:
# -*- coding: utf-8 -*-
# 开启绝对导入特性:凡是裸写 import 的模块,一律从 sys.path 根路径检索,绝不默认搜当前目录
from __future__ import absolute_import

# 此时导入的标准库保证纯净,绝不会被本地同名文件误遮蔽
import string

# 若需要显式导入同包下的同级模块,使用明确的相对导入语法点号(.)
from . import connection
from .models import UserModel
七、知识全景总结与最佳实践对照表
函数负责算法逻辑封装与执行期栈帧隔离,模块与包负责代码组织与命名空间边界划分。熟练掌握参数的求值时机、作用域的静态绑定规则以及模块加载的缓存生命周期,是写出健壮、可维护 Python 2.7 程序的必备基础。
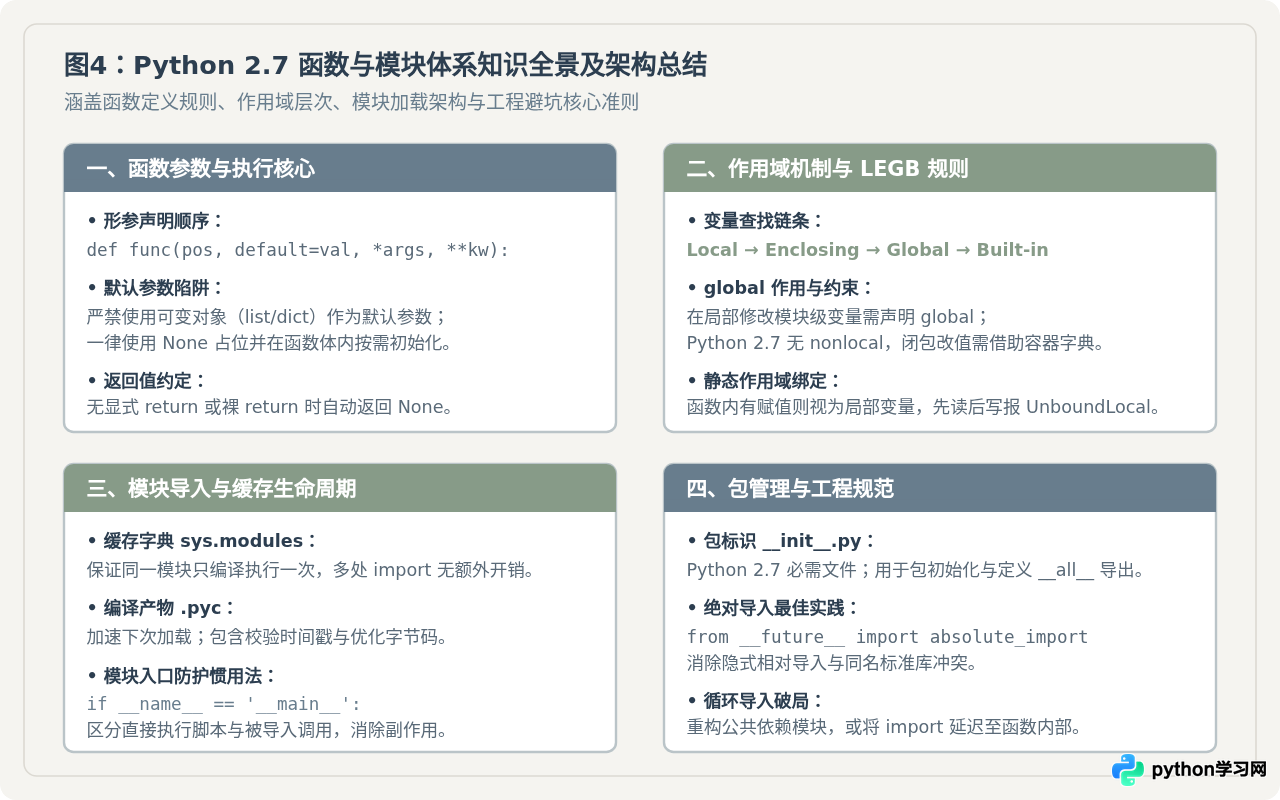
核心规范与避坑速查表
| 技术环节 | 推荐做法 | 反模式 / 严禁行为 | 关键原因 |
|---|---|---|---|
| 默认参数 | 使用 None 占位,在函数体内进行判空与独立初始化。 |
使用 []、{} 等可变对象直接作为默认形参。 |
默认参数仅在函数定义期计算一次,可变对象会被跨调用持久共享。 |
| 作用域修改 | 局部修改模块全局变量前显式声明 global;闭包修改借助容器字典。 |
在函数体内对未声明 global 的外部变量直接先读后写。 | 静态编译会将函数内包含赋值的变量一律标记为局部变量,导致 UnboundLocalError。 |
| 模块导入 | 优先使用 import package.module,或明确指定名称 from package.module import Item。 |
在工程代码中使用通配符 from module import *。 |
污染当前命名空间,引发静默覆盖,破坏代码可读性与静态检查。 |
| 模块自测 | 将测试与演示逻辑包裹在 if __name__ == '__main__': 中。 |
在模块顶层随意放置打印语句、测试逻辑或副作用操作。 | 任何模块在首次被 import 时都会完整执行一遍顶层语句。 |
| 包组织规范 | 每个包目录下包含 __init__.py,并在文件头引入 from __future__ import absolute_import。 |
创建与标准库同名的模块文件,或依赖隐式相对导入。 | 避免本地模块遮蔽系统标准库引发的各种难以复现的异常。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









