

从Python单体应用迁移至微服务的拆分策略与风险控制
详细解析Python单体架构平滑演进至微服务的完整拆分策略,涵盖限界上下文识别、绞杀者迁移模式、数据双写与最终一致性实现,以及延迟、分布式事务与可观测性等核心风险控制手段。
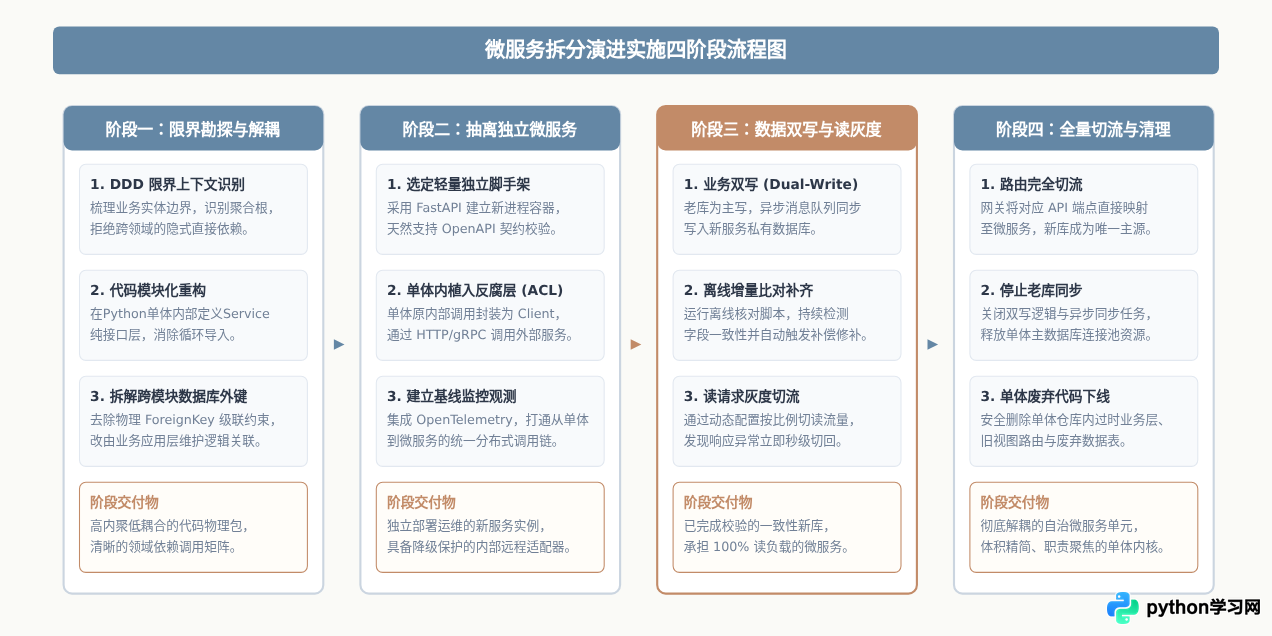
Python单体应用向微服务演进并非推倒重来的全量重写,而是基于领域驱动设计(DDD)识别核心限界上下文,利用“绞杀者模式”自边缘业务向核心系统逐步剥离。拆分的核心难点在于打破共享数据库的强耦合与维护跨服务事务最终一致性;关键防线则在于通过反腐层隔离依赖、设立全链路追踪与熔断降级机制,从而在保障业务零停机的前提下平滑释放架构伸缩性。
一、架构演进评估:明确拆分边界与前置条件
在实际工程实践中,很多团队误将“代码组织混乱、缺乏分层规范”归咎于单体架构本身。如果单体应用内部尚未完成模块化梳理,直接拆分微服务往往会将“一个混乱的巨石单体”转变为“数十个互相强依赖且难以排错的分布式单体”。因此,在启动服务化拆分前,必须先评估应用是否达到了真正的架构瓶颈。
通常适宜拆分的前提条件包括:其一,多团队并行开发在同一代码仓库内产生严重的发布阻塞与合流冲突;其二,不同业务模块对计算与I/O资源的需求存在显著差异(例如:高频低延迟的网关鉴权、高吞吐的报表异步导出与基础CRUD混跑在同一Gunicorn工作进程中,导致Worker被长任务阻塞);其三,核心交易与边缘非核心功能故障域交织,次要模块异常极易拖垮主业务。
二、拆分路线图:绞杀者模式的四个实施阶段
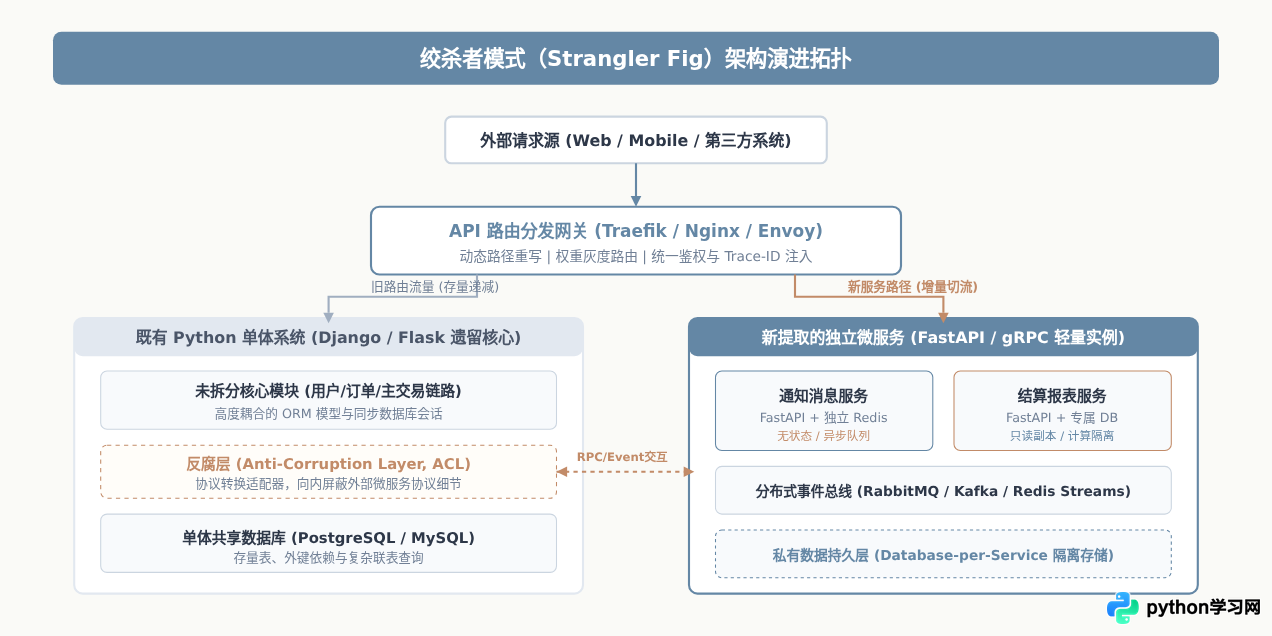
“绞杀者模式”(Strangler Fig Pattern)是业界公认风险最低的单体迁移范式。该模式并不试图在一夜之间关闭老系统,而是在单体应用外部架设统一网关,像无花果藤蔓缠绕老树一样,将新业务和逐步抽离的存量功能部署到新微服务中,逐渐替换单体功能,直至老系统萎缩并最终退役。
三、拆分切入点选择:由边缘至核心的领域建模
新手在拆分时最容易犯的错误是“首战即攻坚”,试图第一步就去拆解最复杂的“用户表”或“订单流水表”。这些核心实体被成百上千个业务逻辑强外键关联,贸然剥离会导致全系统陷入事务不一致与海量连表报错的泥潭。
理性的拆分策略应遵循“低耦合、低风险、高收益”三原则:
- 第一优先级(边缘支撑型业务):短信/邮件通知推送服务、文件上传转码、静态报表导出。这类模块通常入参明确、无状态或数据单向流动,对主库几乎没有反向依赖,拆分后能立竿见影地释放主应用的CPU与I/O资源。
- 第二优先级(计算独立型业务):例如内容检索聚合(可独立对接Elasticsearch)、风控规则初筛、推荐排序。这些模块的读取吞吐远高于写入,数据模型高度自闭环。
- 第三优先级(核心交易与资产):用户认证网关、核心订单、支付与结算。此类模块在所有边缘服务完成拆解、基础设施监控链路稳固后,方可启动数据割接。
四、数据拆分与平滑迁移:双写、同步与一致性闭环
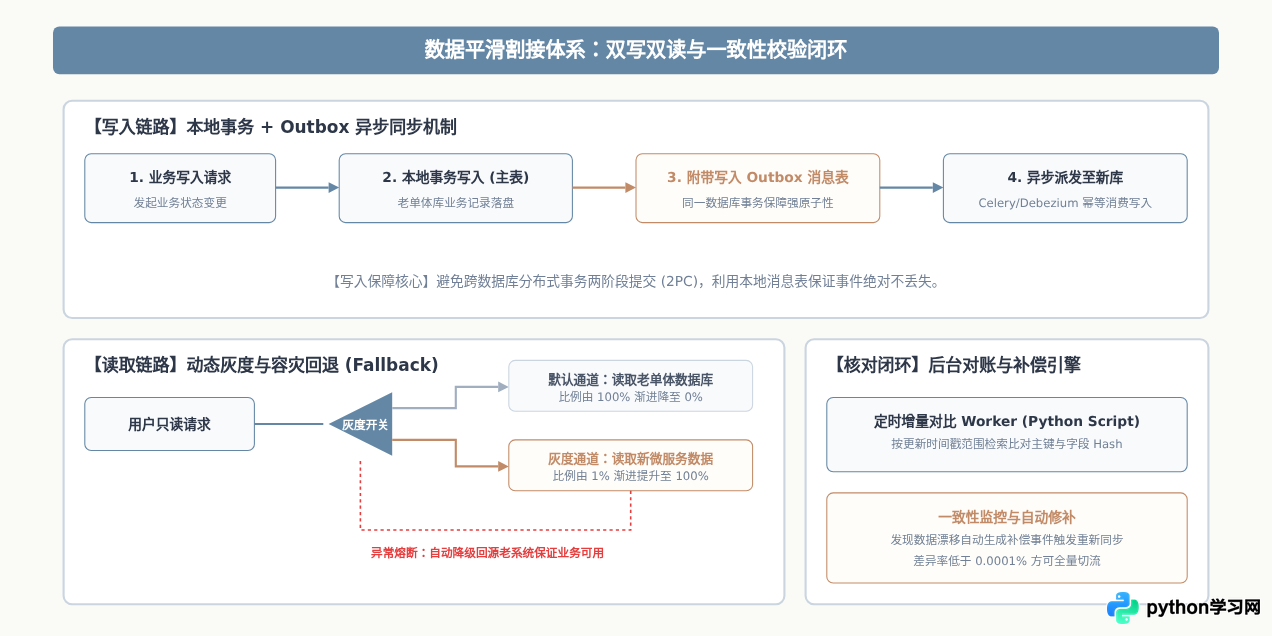
微服务架构的核心基石是“每个微服务独享其私有数据库”(Database-per-Service)。如果多个微服务依然共同读取和修改同一个底层的 PostgreSQL/MySQL 实例,那么服务隔离只是空中楼阁,底层的死锁排查与结构变更依然会引发全局故障。
1. 本地消息表模式(Transactional Outbox)实现示例
为了解决“业务写单体成功,但向消息中间件发送同步事件失败”导致的分布式数据丢失,应采用本地消息表方案。业务表与出站消息表在同一个本地数据库事务中提交,确保只要主记录保存成功,出站消息必定存在。
# Python (SQLAlchemy) 本地消息表落盘示例
from datetime import datetime
import json
from sqlalchemy.orm import Session
from models import Order, OutboxEvent

def update_order_status_with_outbox(
    db: Session,
    order_id: int,
    new_status: str,
    trace_id: str
) -> Order:
    # 开启本地原子事务
    with db.begin():
        # 1. 更新单体主业务表
        order = db.query(Order).filter(Order.id == order_id).with_for_update().first()
        if not order:
            raise ValueError(f"Order #{order_id} not found")

        old_status = order.status
        order.status = new_status
        order.updated_at = datetime.utcnow()

        # 2. 同一事务内写入 Outbox 消息记录
        event_payload = {
            "order_id": order.id,
            "user_id": order.user_id,
            "old_status": old_status,
            "new_status": new_status,
            "timestamp": order.updated_at.isoformat()
        }

        outbox_entry = OutboxEvent(
            aggregate_type="ORDER",
            aggregate_id=str(order.id),
            event_type="ORDER_STATUS_CHANGED",
            payload=json.dumps(event_payload),
            trace_id=trace_id,
            status="PENDING",  # 等待后台 Celery Worker 派发
            created_at=datetime.utcnow()
        )
        db.add(outbox_entry)

    # 事务提交后,后台异步进程(如 Celery / Debezium)安全拉取 PENDING 记录推向 RabbitMQ
    return order
五、分布式环境下的关键技术风险与控制策略
当单体进程内的本地函数调用转变为网络间的 RPC/HTTP 调用后,系统面临的不可预测性成倍增加。以下是 Python 微服务架构演进过程中必须严肃防控的四大核心风险。
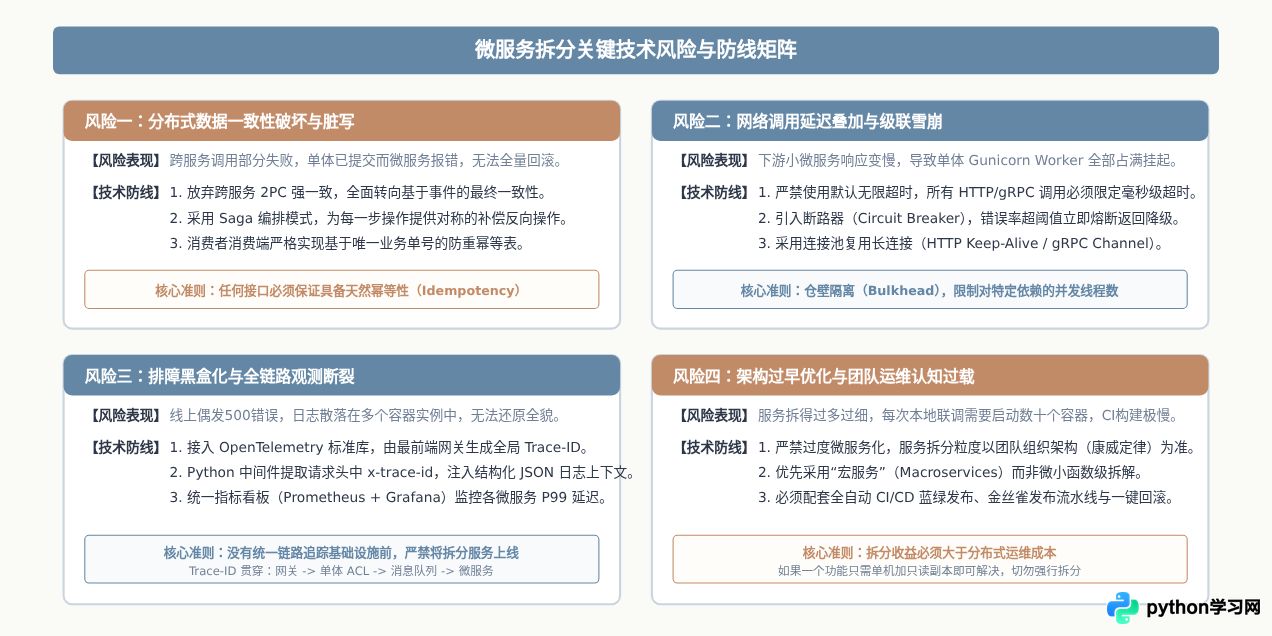
2. 单体与微服务调用间的断路器保护
在单体系统调用新抽离微服务时,必须在反腐层(ACL)中配置熔断保护机制。当新微服务出现网络抖动或崩溃时,单体系统必须能够快速失败或返回降级默认值,防止请求在单体工作线程堆积引发全站瘫痪。
# Python 反腐层熔断保护与降级调用示例
import httpx
from pybreaker import CircuitBreaker, CircuitBreakerError
import logging

logger = logging.getLogger(__name__)

# 配置断路器:5次失败后开启熔断,熔断持续时长 30 秒
notification_breaker = CircuitBreaker(fail_max=5, reset_timeout=30)

class NotificationServiceClient:
    def __init__(self, base_url: str):
        self.base_url = base_url
        # 严格配置超时:连接 1 秒,读写 2 秒
        self.client = httpx.Client(timeout=httpx.Timeout(2.0, connect=1.0))

    def send_sms_alert(self, user_id: str, message: str, trace_id: str) -> bool:
        headers = {"X-Trace-Id": trace_id}
        payload = {"user_id": user_id, "message": message}

        try:
            # 断路器监听执行外部微服务调用
            return self._call_remote_api(payload, headers)
        except CircuitBreakerError:
            logger.warning(f"Notification service circuit open. Fallback triggered for trace: {trace_id}")
            return self._fallback_local_queue(payload)
        except httpx.HTTPError as exc:
            logger.error(f"Remote notification failed: {exc}. Fallback triggered.")
            return self._fallback_local_queue(payload)

    @notification_breaker
    def _call_remote_api(self, payload: dict, headers: dict) -> bool:
        response = self.client.post(
            f"{self.base_url}/api/v1/sms/send",
            json=payload,
            headers=headers
        )
        response.raise_for_status()
        return True

    def _fallback_local_queue(self, payload: dict) -> bool:
        # 降级逻辑:将消息存入本地持久化暂存表,由后台低速重试,绝不挂起主线程
        logger.info(f"Persisted alert locally for user {payload.get('user_id')}")
        return False
在单体架构下,工程师习惯在 Django ORM 或 SQLAlchemy 中使用 select_related 或 join 进行多表联查。一旦数据分库,所有联表查询将无法在数据库层完成。如果简单粗暴地在 Python 代码层通过循环网络调用逐条补齐数据(典型的 N+1 网络请求问题),接口响应延迟将呈指数级恶化。
正确解法:重构数据查询视图,利用 CQRS(读写分离与命令查询职责分离)思想,将前端展示所需的多领域数据预先通过异步事件聚合到专用的只读视图库(如 Elasticsearch 或 Redis 缓存聚合对象)中,避免实时的跨微服务远程网络拼装。
六、迁移总结与实施落地清单
从 Python 单体迈向微服务不是一场突击战,而是一场严谨的工程马拉松。确保迁移成功的关键不在于技术栈的多样性,而在于对每一步割接过程的可控性与可逆性。
- 代码层内聚:在物理拆库拆服务前,必须先在单体内部消除模块间的循环引用与直接 ORM 模型穿透。
- 网关先行动:最先上线且最稳固的组件必须是 API 路由网关与链路追踪系统。没有 Trace-ID 的微服务系统无异于灾难。
- 数据独立性:严格遵守每个微服务独享数据库的原则。采用“双写 -> 异步同步 -> 离线校验 -> 读灰度 -> 全量切写”的五步平滑法。
- 防御性编码:跨服务调用必须配置明确的连接与响应超时、断路器机制与对称的降级兜底方案。
- 常态化可逆:在彻底下线单体旧代码前,系统必须随时保留一键切回单体旧链路的配置开关。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









