

初学者怎么根据职业方向选择Python主流框架?
面向Python初学者的主流框架选型全景指南。紧扣职业发展路径,深入剖析Web后端、数据分析、人工智能与自动化测试运维四个主要方向的框架差异、选型标准与实操建议。
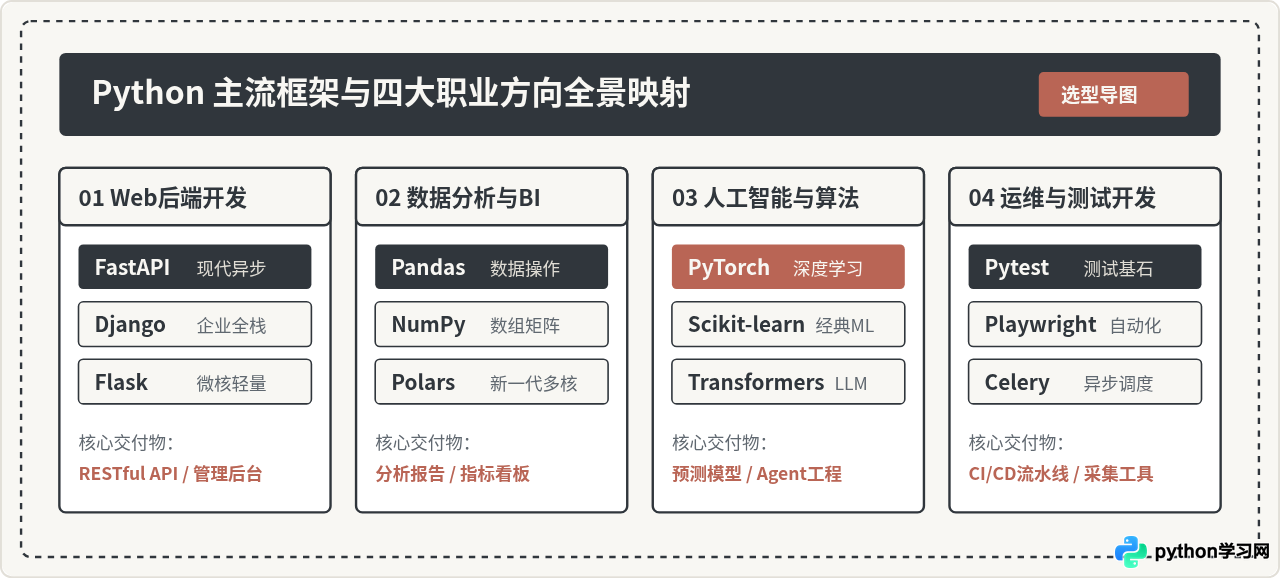
一、职业方向决定交付形态,交付形态决定框架选型
很多初学者在刚学完 Python 基础语法后,常常感到迷茫:市面上有 Django、FastAPI、Flask、Pandas、PyTorch 等众多框架,究竟该先学哪一个?一个常见的误区是盲目跟随热度,或者试图“全部掌握”。
在真实的软件工程与商业开发中,框架的本质是工程脚手架——它为你预设了代码组织形式、网络协议处理、数据库交互规则或数学运算加速机制。不同职业岗位对最终产出物(Deliverables)的要求有着根本差异:
- Web 后端开发工程师:日常交付的是符合规范的 RESTful API 接口、身份验证系统、数据库 ORM 模型以及高可用服务。
- 数据分析师 / 商业智能(BI)工程师:交付的是清洗干净的数据宽表、统计推断结论、交互式可视化图表与业务决策分析报告。
- AI / 算法研发工程师:交付的是经过训练与评估的模型权重文件、张量运算流图以及可供工程调用的推理封装接口。
- 自动化测试与运维工程师:交付的是高覆盖率的自动化测试套件、持续集成(CI)脚本、集群监控探针与网页自动化采集工具。
因此,初学者的首要任务不是背诵各个框架的特性,而是先明确自己希望进入的职业赛道,进而依据岗位核心产出锁定对应的基准框架。
二、初学者框架选型的四步决策路径
面对具体的技术选型,初学者可以通过结构化的四个步骤完成筛选与验证,避免在学习中途频繁推倒重来。
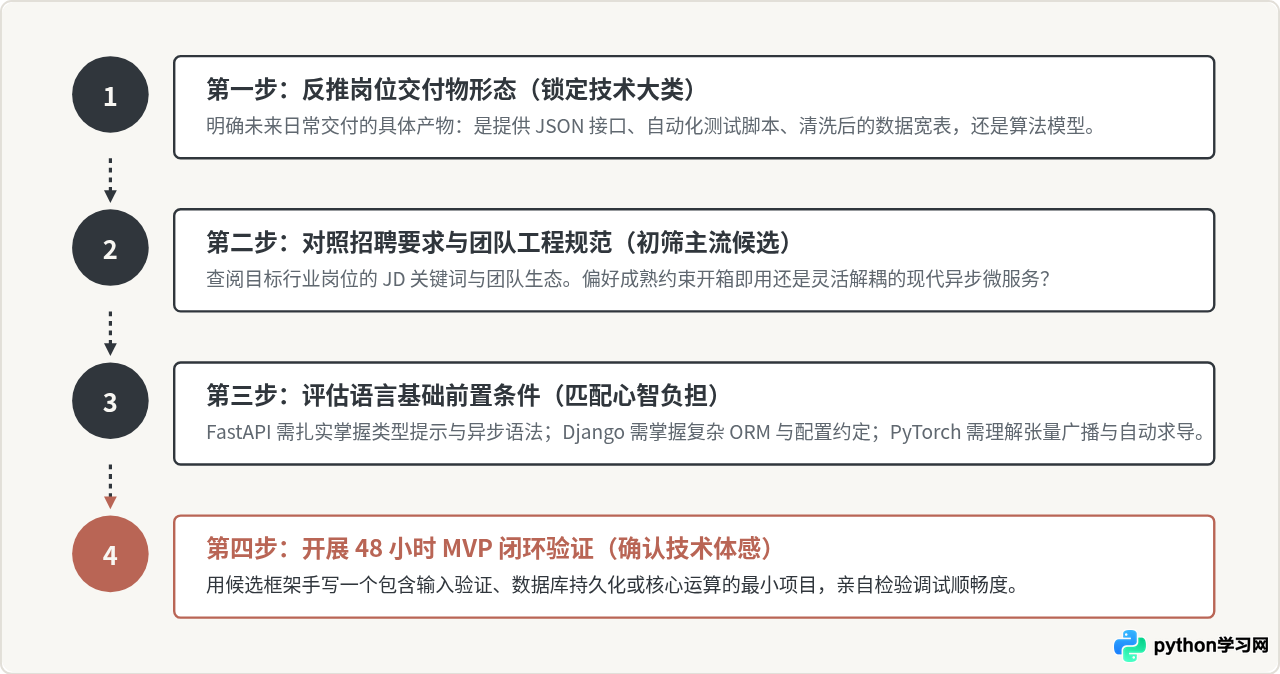
具体执行细节如下:
-
第一步:反推岗位交付物形态
明确你的代码最终以什么形态在生产环境中运行。如果是向前端提供 JSON 接口,那么你应当在 Web 框架中选型;如果核心逻辑是处理几十万行 Excel 或数据库流水,重点就是数据处理框架。 -
第二步:对照招聘要求与团队工程规范
浏览招聘网站上目标地域、目标行业 10 到 20 个相关岗位的招聘描述(JD)。观察高频出现的框架组合。例如传统政企、内容系统偏好 Django 的全套规范,而新型移动互联网、出海业务与大模型创业团队更青睐 FastAPI。 -
第三步:评估语言基础前置条件
不同框架对 Python 语法特性的依赖程度大相径庭。FastAPI 深度依赖 Python 3.7+ 的类型提示(Type Hints)与asyncio异步语法;Django 需要深入理解面向对象类属性元编程与 ORM 关联查询;PyTorch 要求对高维张量切片与求导机制有扎实了解。根据自身目前的语言底子选择最合适切入的框架。 -
第四步:开展 48 小时 MVP 闭环验证
不要在没写一行代码前就花费数周纠结选型。挑选候选框架,在两天内写一个最小可行性项目(MVP):例如一个具备增删改查和数据校验的待办事项 API,或者一个简单的数据汇总清洗脚本。亲身感受框架的调试报错信息、文档可读性与上手阻力。
三、Web 后端开发方向:Django、FastAPI 与 Flask 的取舍
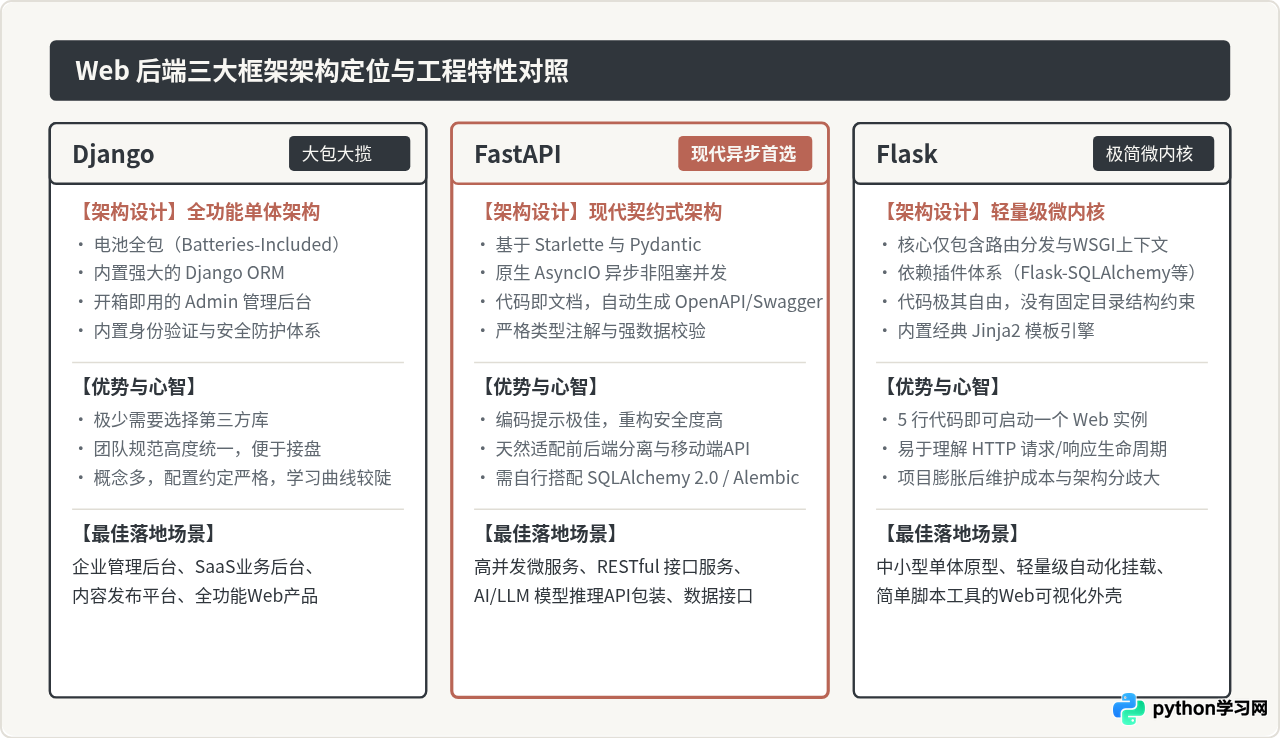
Python 在 Web 领域拥有深厚的生态积累。当前最核心的争论集中在 Django、FastAPI 与 Flask 三者之间。初学者需要从架构理念出发理解它们的区别。
1. FastAPI:现代前后端分离与高并发 API 的首选
FastAPI 基于 Starlette(负责异步 ASGI 网络通信)和 Pydantic(负责数据验证与序列化)。它的最大特点是类型驱动与自文档化。
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="用户任务服务")

class TaskCreate(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")

@app.post("/api/v1/tasks", status_code=201)
async def create_task(payload: TaskCreate):
    # Pydantic 自动完成字段类型转换与区间校验,不合法直接返回 422 结构化错误
    new_task = {"id": 101, "title": payload.title, "priority": payload.priority}
    return {"code": 0, "message": "创建成功", "data": new_task}
uvicorn main:app --reload 后,访问 http://127.0.0.1:8000/docs 即可直接得到交互式 Swagger UI 文档。不需要手动编写任何 API 文档,这对于前后端协作效率提升巨大。
选型结论:如果你未来的求职目标是移动端 API 研发、微服务架构后端,或者为 AI 模型/前端 React/Vue 团队提供数据接口,FastAPI 是当前最值得优先掌握的现代框架。
2. Django:企业级管理后台与全栈单体系统
Django 坚持“电池全包(Batteries-Included)”哲学。它内置了功能强大的 ORM、开箱即用的 Admin 后台管理界面、完善的会话与认证系统以及完善的 CSRF/XSS 安全防御。
对于初学者而言,Django 的优势是团队规范高度统一:目录结构、配置文件、模型迁移都有官方既定套路。但缺点是心智负担较重,大量的内部黑魔法和庞大的概念体系容易让新手迷失。
选型结论:如果目标岗位集中在传统软件企业、需要快速交付复杂的内部运营后台、ERP 系统或内容管理平台(CMS),Django 依然是国内存量需求极大、交付确定性最高的框架。
3. Flask:极度自由但需警惕“自研插件泥潭”
Flask 本身极其微小,核心只负责路由分发和请求响应上下文。数据库访问、身份验证、表单验证全部需要开发者挑选第三方插件(如 Flask-SQLAlchemy、Flask-JWT-Extended 等)自行装配。
很多教学课程喜欢用 Flask 入门,因为它“5 行代码就能跑起来”。但对于初学者构建正式工程项目来说,缺乏强制规范往往意味着每个人写出的代码结构都不一样,后期维护成本极高。
四、数据分析与科学计算方向:以 Pandas 为核心的分析栈
如果你的职业目标是数据分析师、数据挖掘工程师或商业分析师,Python 的选型路径相对非常清晰且收敛:Pandas 与 NumPy 是不可逾越的行业基石。
初学者在这一方向不要把精力花在 Web 框架上,而应集中攻克以下技术栈:
| 技术组件 | 核心职能与价值 | 学习阶段建议 |
|---|---|---|
| NumPy | 提供多维数组(ndarray)对象与底层 C 语言级别的高性能矢量化数学运算。 | 理解广播机制、数组形状变换(reshape)及切片逻辑。 |
| Pandas | 提供 DataFrame 表格数据结构,支持多源数据加载、清洗、分组聚合与透视计算。 | 熟练掌握缺失值处理、时间序列解析、groupby 分组及 merge 关联。 |
| Matplotlib / Seaborn | 将数据统计分布、相关性与趋势以学术或商业图表形式输出。 | 掌握折线图、柱状图、箱线图与热力图的参数配置及可视化呈现。 |
| Polars(进阶) | 基于 Rust 构建的新一代多线程 DataFrame 库,在千万级超大数据集上运算性能卓越。 | 熟练使用 Pandas 后,针对超大文件查询性能瓶颈时的进阶选择。 |
import pandas as pd

# 1. 模拟读取订单明细数据
data = [
    {"order_id": 1001, "dept": "华东", "amount": 299.0, "status": "COMPLETED"},
    {"order_id": 1002, "dept": "华北", "amount": 599.0, "status": "COMPLETED"},
    {"order_id": 1003, "dept": "华东", "amount": 120.0, "status": "CANCELLED"},
    {"order_id": 1004, "dept": "华南", "amount": 880.0, "status": "COMPLETED"},
    {"order_id": 1005, "dept": "华东", "amount": 450.0, "status": "COMPLETED"},
]
df = pd.DataFrame(data)

# 2. 过滤有效订单并按大区分组聚合销售额与订单数
valid_orders = df[df["status"] == "COMPLETED"]
summary = (
    valid_orders.groupby("dept")
    .agg(total_sales=("amount", "sum"), order_count=("order_id", "count"))
    .reset_index()
)
print(summary)
dept total_sales order_count
0 华东 749.0 2
1 华北 599.0 1
2 华南 880.0 1
在数据分析求职中,面试官重点考察的是你运用 Pandas 解决实际业务指标计算的敏锐度,而非背诵 API 数量。此外,SQL 依然是数据岗位的生命线,必须做到 Pandas 与 SQL 双轨并进。
五、人工智能与算法研发方向:PyTorch 与机器学习工程链
人工智能领域的技术演进极其迅速,但底层技术栈结构却具有严谨的层次递进性。
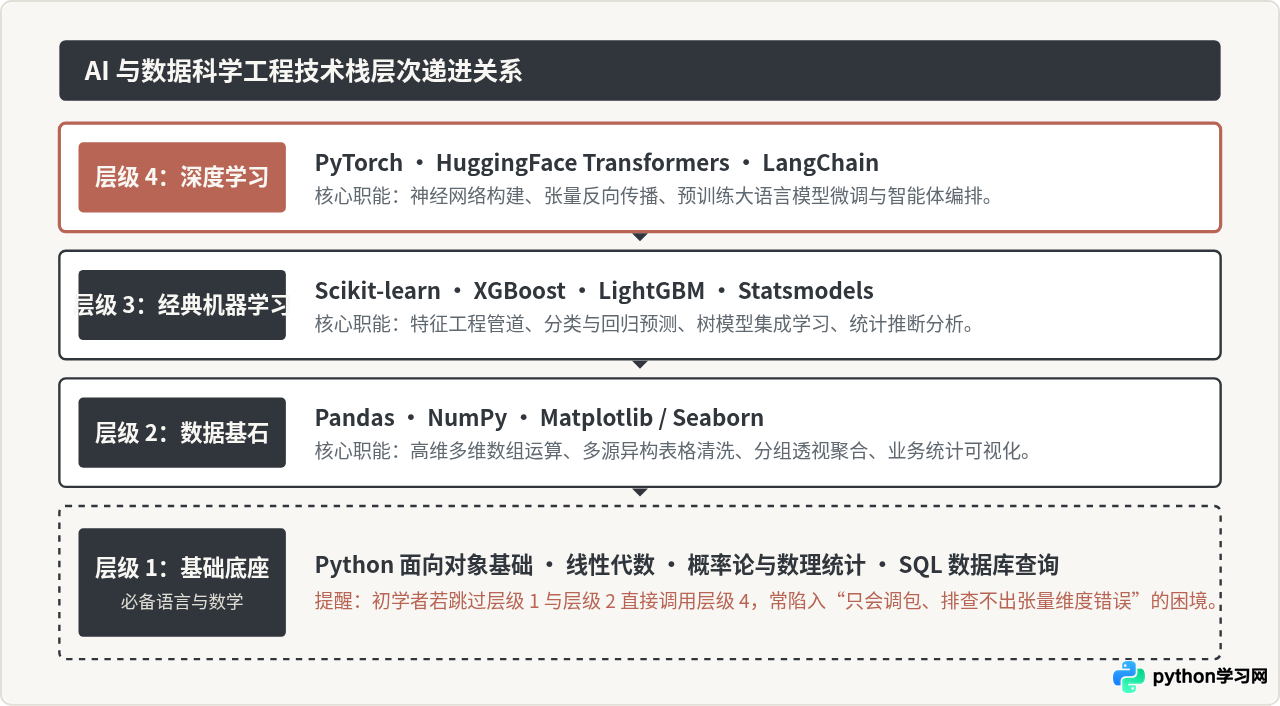
1. 为什么深度学习首选 PyTorch?
在过去,深度学习领域存在 TensorFlow/Keras 与 PyTorch 的激烈竞争。然而在当前学术研究与主流企业工业界,PyTorch 已经确立了绝对的统治地位。其核心优势在于:
- 动态计算图(Eager Execution):PyTorch 的代码执行方式与原生 Python 完全一致,可以随时使用
print()或常规断点调试器排查张量形状(Shape)与数值溢出错误。 - 顶会论文与开源模型首选:HuggingFace 社区绝大多数预训练模型(如 Llama、BERT、Stable Diffusion)均以 PyTorch 作为原生第一实现。
- 直观的面向对象模型构建方式:通过继承
torch.nn.Module并实现forward方法,代码逻辑清晰透明。
2. 经典机器学习基石:Scikit-learn 的不可替代性
很多初学者一上来就跟风学习大语言模型或复杂深度网络,往往忽视了 Scikit-learn。实际上,在绝大多数企业风控、用户流失预警、搜索排序等表格数据(Tabular Data)场景中,基于 Scikit-learn、XGBoost、LightGBM 的传统树模型集成,其运算效率与可解释性往往远超深度网络。
六、自动化运维与测试开发方向:让脚本走向工程化
编写十几行的单文件 Python 脚本协助日常操作,只能算作“自动化脚本编写”;而自动化测试工程师与 SRE 运维开发工程师的核心竞争力在于工程化体系建设。
主流框架选型应锁定以下两款工具:
-
Pytest:全行业公认的自动化测试标准
放弃 Python 内置的unittest,全面转向 Pytest。Pytest 拥有极为强大的fixture机制,能够以依赖注入的方式优雅处理数据库连接准备、测试现场还原与多参数化测试(parametrize),配合 Allure 能够自动生成结构化的测试报告。 -
Playwright:新一代端到端 UI 自动化与网页采集利器
传统 Selenium 存在环境配置复杂、等待时机难以把控等问题。由微软开源的 Playwright 原生支持现代单页应用(SPA)、拥有自动等待机制(Auto-waiting)、支持多上下文隔离并能录制生成代码,目前已成为 UI 自动化测试与现代动态网页数据采集的主流框架。
七、初学者最易陷入的四大选型误区与规避法则
在实际学习与求职准备过程中,初学者往往因为信息不对称而走入弯路。以下四个误区需要重点规避:
-
误区一:“唯性能论”或者“唯微服务论”
不少初学者在做小项目时,看到基准测试跑分就盲目追求极高并发,甚至为了几个接口强行拆分微服务。实际上,对于绝大多数中小型业务,开发迭代速度、代码可读性和数据库查询优化远比网络框架本身的纳秒级差异重要得多。 -
误区二:重框架 API 记忆,轻底层计算机基础
死记硬背框架的配置项或函数参数是没有意义的。HTTP 协议状态码、缓存机制、关系型数据库索引原理、数据结构复杂度与 Linux 基础操作,才是决定你能否在面试和实际工作中胜任的核心竞争力。 -
误区三:只学框架语法,缺少工程级部署经验
很多初学者在本地python main.py跑通后就认为掌握了框架。实际上,工程落地还包括 Docker 容器化编排、Gunicorn/Uvicorn 进程管理、Nginx 反向代理配置与环境变量解耦。 -
误区四:多方向同时铺开,贪多嚼不烂
有些同学在简历上同时写着精通 Django、Pandas、PyTorch 和 Scrapy,但每个都停留在官方 Hello World 水平。在就业市场上,一个能在单一方向拿出完整闭环项目的候选人,竞争力远高于广而不精的初学者。
八、全职业方向选型矩阵与执行建议
为了便于快速对照与查阅,下表总结了四大职业方向的核心选型标准、决策依据与求职关键动作。
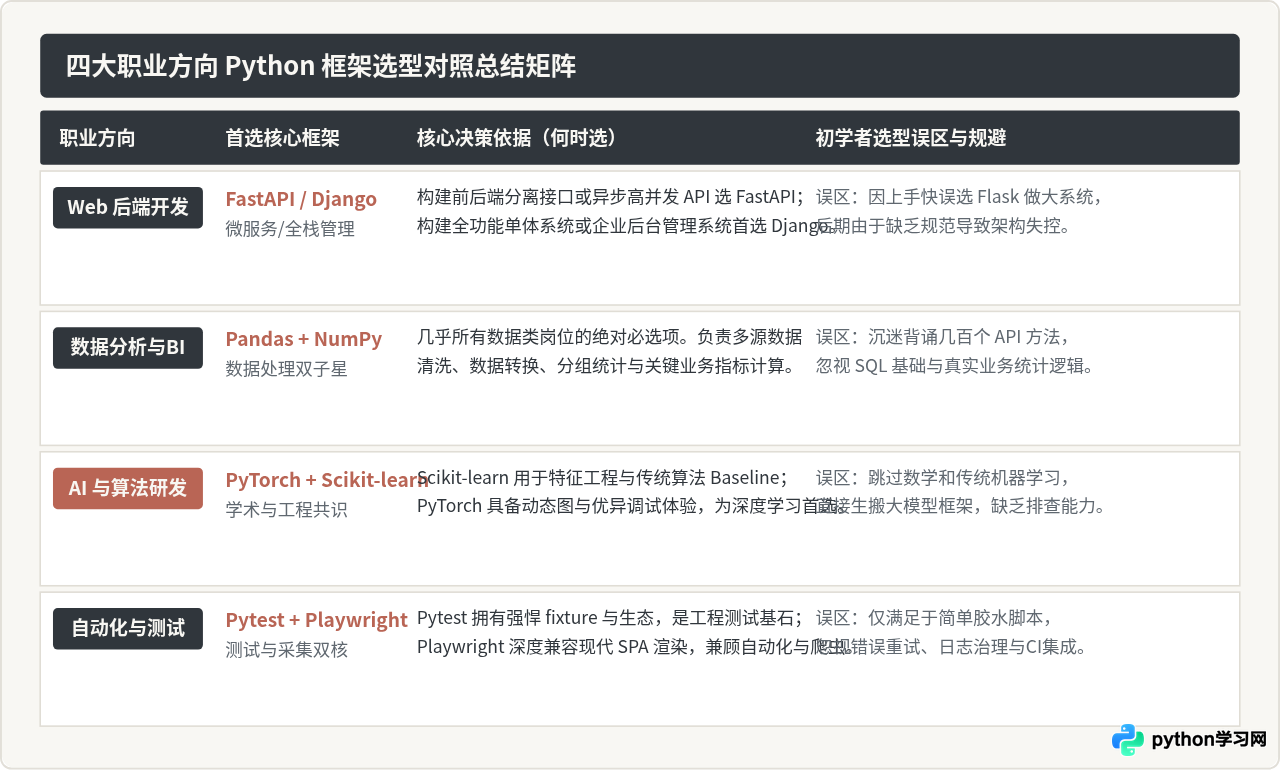
总结而言,选择 Python 框架不是一次性的终身决定,而是基于当前职业目标的务实起点。建议初学者按照本文介绍的四步决策法:先锁定一个具体岗位方向,选定一个主流基准框架,以两到三天为周期完成一个最小可行性项目,再通过深入理解底层原理与工程规范不断迭代扩展。当你真正吃透了一个主流框架的设计哲学与工程闭环,未来迁移到其他同类技术栈将变得水到渠成。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









