

Python爬虫教材推荐:适合零基础的系统学习书籍
针对零基础读者的Python爬虫系统学习书籍选型指南,详细对比《Python 3网络爬虫开发实战》《Python编程:从入门到实践》《Python网络数据采集》及《精通Scrapy网络爬虫》,提供科学的学习路线与选书决策。
零基础读者系统学习Python网络爬虫的核心路径是“掌握Python基础语法与HTTP通信机制 → 熟练运用Requests与解析库完成单页静态抓取 → 攻克浏览器动态渲染与会话维持 → 掌握Scrapy框架实现高并发与管道化持久存储”。针对不同基础阶段的读者,市面上最值得精读的教材组合为《Python编程:从入门到实践》(语法前置打底)、《Python 3网络爬虫开发实战》(主力全能核心教材)、《Python网络数据采集》(经典精炼原理入门)以及《精通Scrapy网络爬虫》(高并发工程化进阶)。
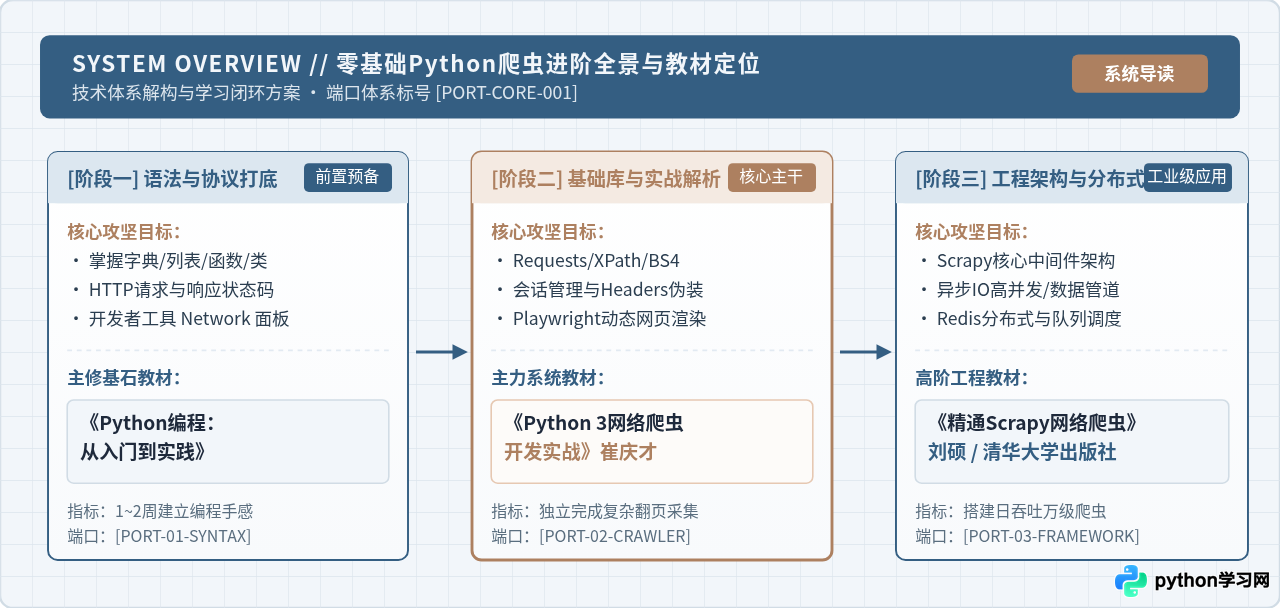
一、零基础学爬虫的三大核心断层与选书原则
多数零基础初学者在学习Python爬虫时中途放弃,并非因为爬虫技术本身门槛过高,而是因为所选教材的技术跨度脱节,遇到了三个典型的认知断层:
- 语法断层:直接翻阅专门的爬虫书籍,遇到列表推导式、生成器(yield)、面向对象(类与继承)以及装饰器时难以理解,导致即使照抄代码也无法独立修改。
- 协议断层:把爬虫单纯当成Python代码练习,忽略了底层的HTTP/HTTPS协议、请求头(Headers)、Cookie会话机制以及浏览器开发者工具(DevTools)抓包排查,导致网页一变动或返回403就无从下手。
- 架构断层:在没有熟练掌握单脚本“请求-解析-清洗-入库”完整流水线的情况下,直接硬啃Scrapy等重型异步框架,陷入复杂的配置参数和中间件调用链中。
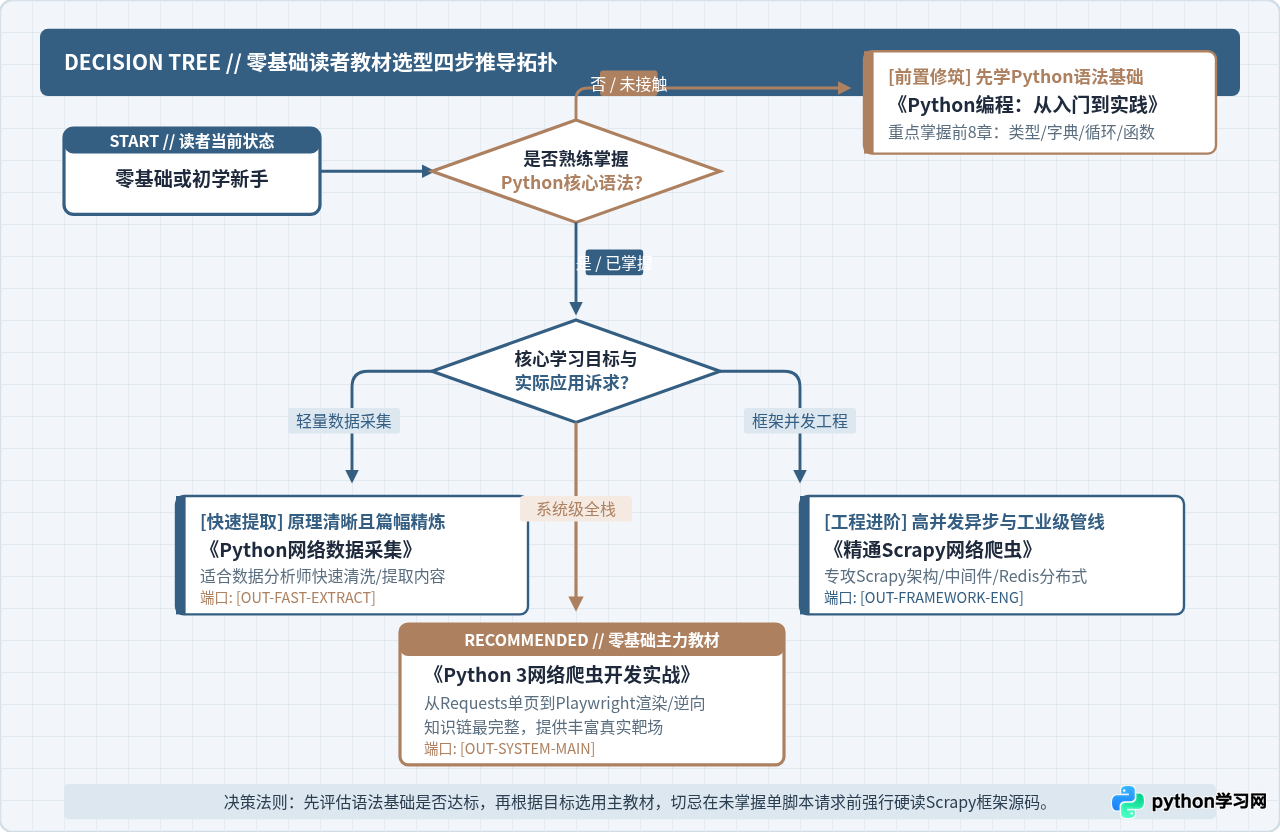
因此,一套合格的自学教材必须满足梯度合理、知识链路完整、实操靶场稳定三个硬性条件。盲目求全只会消耗学习耐心,按阶段梯次阅读才是最省时的方法。
二、四本主流教材深度解析与适用场景
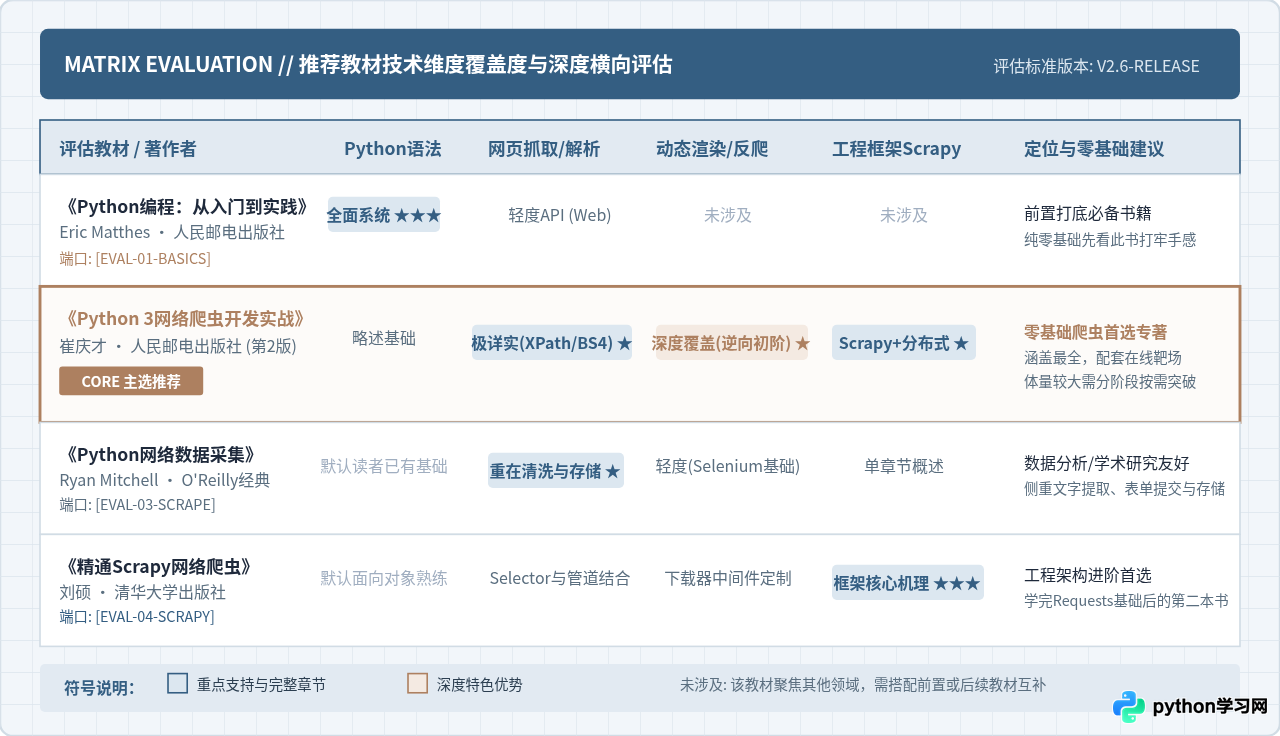
市面上的Python爬虫书籍繁多,但真正经过读者广泛检验且技术栈适应当下Web环境的书籍集中在以下四本。读者应当根据自身当下的技术起点选择主修书。
深度评析:该书是国内目前体系最全、实战案例设计最扎实的爬虫专著。全书超过千页,作者配套搭建了专门的测试演练靶场网站(涵盖静态HTML、动态Ajax、登录鉴权、混淆反爬等各种特征),解决了传统爬虫教材“书刚出版实战网站就改版失效”的痛点。
深度评析:若读者此前从未写过任何一行代码,切勿直接买爬虫专著。本书是公认最适合新手的Python语法启蒙书。其语言极其通俗,练习紧密配合场景。花1至2周时间读完前9章(变量、列表、字典、用户输入、while循环、函数、类、文件与异常),就能毫无阻碍地进入后续的爬虫代码学习。
深度评析:O'Reilly经典的“水獭书”。相比国内教程偏重工程框架与对抗,本书更具学术与数据分析气质。书中不仅解释“怎么抓”,更花大量篇幅讲解“抓取到的脏数据如何做正则过滤、自然语言规整以及存储架构设计”。对于目标是学术科研、数据统计的读者,本书篇幅适中、阅读体验极其轻快。
深度评析:当读者掌握了单个Python脚本的抓取逻辑,面临海量URL调度、自动去重、失败重试、并发控制时,必须转入工业级框架。《精通Scrapy网络爬虫》不仅提供模板代码,更详细拆解了Twisted异步事件驱动架构的内部运作机制,是初学者脱离“玩具脚本”、走向工业化数据采集团队的必修书。
三、爬虫流水线架构与教材知识点映射
阅读爬虫书籍时,必须在头脑中建立一条标准的数据工业流水线。不论是单文件脚本还是分布式集群,其底层数据流动均遵循下图所示的四个核心层级:
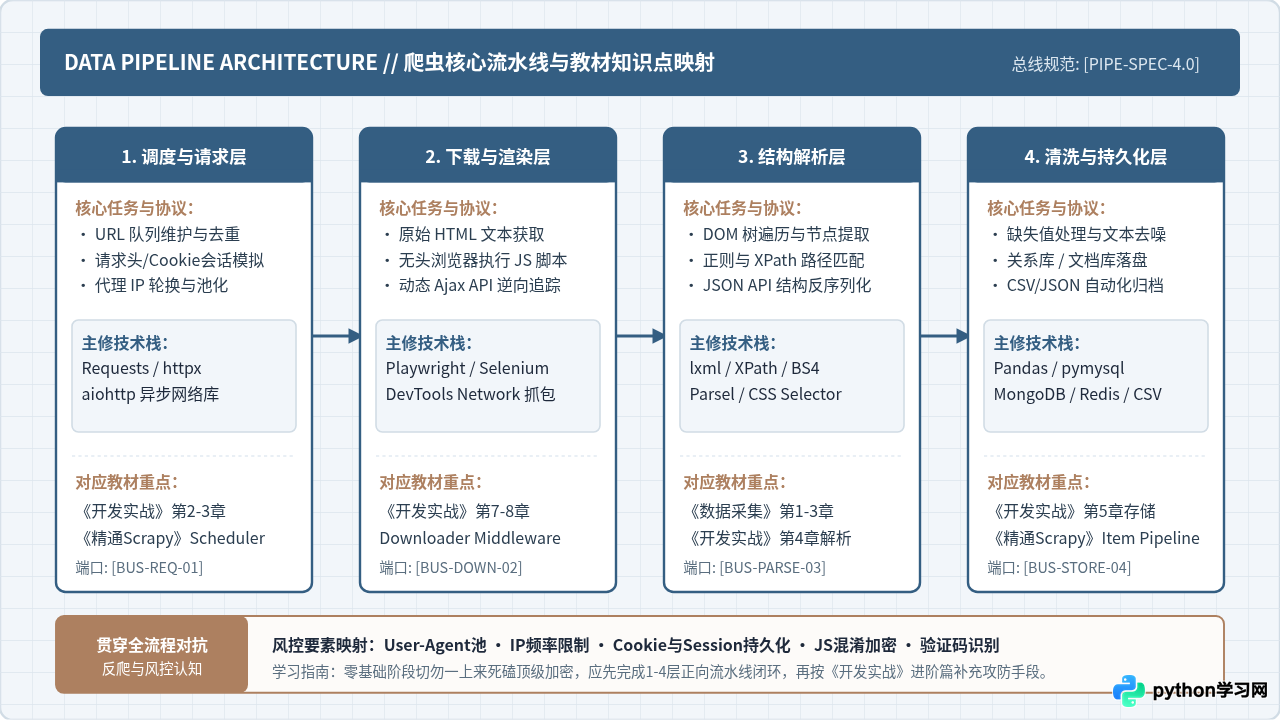
在学习具体章节时,可以对照下表理解每个库和概念在流水线中的具体职责,避免孤立记忆语法:
| 层级分类 | 核心技术与库 | 解决的具体问题 | 对应主修书籍重点 |
|---|---|---|---|
| 请求与会话层 | Requests, httpx, aiohttp | 发送标准HTTP请求、伪装User-Agent、维持Session鉴权Cookie、配置代理IP | 《开发实战》第2章、《数据采集》第12章 |
| 动态渲染层 | Playwright, Selenium | 执行页面JavaScript代码、模拟滚轮下拉翻页、捕获异步Ajax数据接口 | 《开发实战》第7-8章 |
| 文本解析层 | lxml, XPath, BeautifulSoup | 从凌乱的HTML文本中按标签层次、类名定位目标内容,提取属性与纯文本 | 《数据采集》第2章、《开发实战》第4章 |
| 持久存储层 | CSV, pymysql, MongoDB | 结构化数据清洗、字段缺失值填补、关系型存储与文档库批量落盘 | 《开发实战》第5章、《精通Scrapy》Pipeline |
四、零基础两步实操示例:从请求到解析的最小闭环
通过教材学习时,最忌讳“只看不练”。以下提供一个符合教材推荐规范的标准最小抓取示例,演示如何使用最主流的requests与lxml完成一个合规的数据采集闭环:
import requests
from lxml import etree
import csv
import time

def scrape_quote_page(page_num: int):
    # 示例采集目标:标准爬虫练习靶场(保持规范请求头)
    target_url = f"https://quotes.toscrape.com/page/{page_num}/"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        # 结果状态码校验
        if response.status_code != 200:
            print(f"[警告] 请求异常,状态码: {response.status_code}")
            return []

        # 结构化解析
        html = etree.HTML(response.text)
        quote_blocks = html.xpath('//div[@class="quote"]')

        extracted_data = []
        for block in quote_blocks:
            text = block.xpath('./span[@class="text"]/text()')[0].strip('“”')
            author = block.xpath('.//small[@class="author"]/text()')[0]
            extracted_data.append({"author": author, "quote": text})

        return extracted_data
    except requests.exceptions.RequestException as e:
        print(f"[网络错误] 抓取失败: {e}")
        return []

if __name__ == "__main__":
    # 采集前2页并持久化保存至本地CSV
    all_quotes = []
    for page in range(1, 3):
        print(f"正在抓取第 {page} 页数据...")
        quotes = scrape_quote_page(page)
        all_quotes.extend(quotes)
        time.sleep(1) # 礼貌爬虫间隔,避免造成目标服务器压力

    with open("quotes_output.csv", "w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=["author", "quote"])
        writer.writeheader()
        writer.writerows(all_quotes)

    print(f"抓取完成,成功持久化存储 {len(all_quotes)} 条记录。")
headers与timeout超时熔断;2. 必须做状态码校验(
status_code == 200)与网络异常捕获;3. 采集循环中加入
time.sleep是合规爬虫的基本礼仪;4. 写入CSV时使用
utf-8-sig编码可以避免Windows Excel打开时出现乱码。
五、零基础系统学习时间线与通关验收里程碑
为了避免“买书如山倒,翻书只看前三章”,建议读者将系统学习拆解为8周的清晰阶段,并以“可独立运行的项目成果”作为每个阶段的唯一通关标准(Definition of Done)。
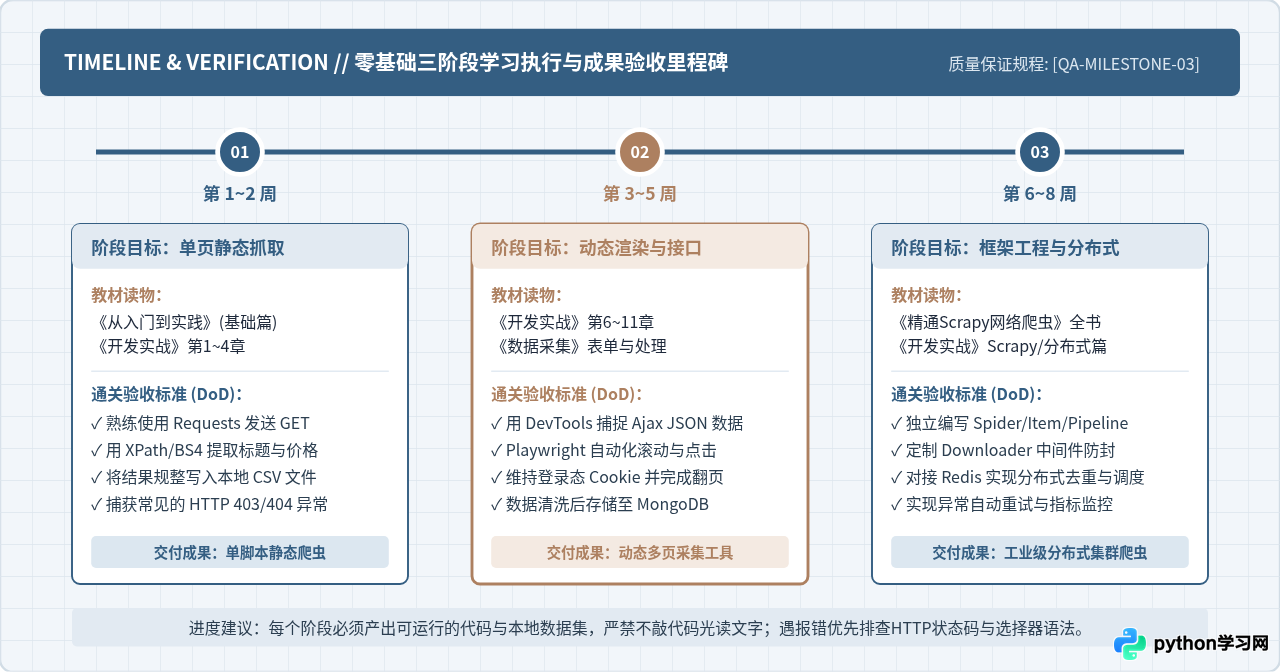
第1~2周:语法夯实与静态单页抓取(阶段一)
核心教材:《Python编程:从入门到实践》第1~9章 + 《Python 3网络爬虫开发实战》第2~4章。
学习重点:掌握变量、列表、字典的基本操作;掌握HTTP基础(GET/POST、200/403/404/500含义);掌握Chrome DevTools的Network面板查看响应体;掌握Requests库与XPath语法。
通关验收标准:不参考抄袭现成代码,能够独立编写脚本抓取任意一个静态图书或电影展示页的列表数据,将100条包含标题、评分、作者的信息清洗后存入本地CSV文件。
第3~5周:动态渲染、接口逆向与持久化(阶段二)
核心教材:《Python 3网络爬虫开发实战》第6~8章、第5章(存储篇)。
学习重点:理解前后端分离与Ajax动态加载机制;学会利用开发者工具抓取XHR/Fetch接口数据;掌握Playwright自动化测试框架驱动浏览器模拟真实用户操作;学习使用MongoDB存储半结构化JSON数据。
通关验收标准:能够模拟登录一个有Cookie鉴权的测试站点,并使用Playwright或直接请求Ajax接口,自动翻页采集10页以上的动态渲染商品数据,完成去重并保存至MongoDB数据库中。
第6~8周:Scrapy工程化架构与反爬应对(阶段三)
核心教材:《精通Scrapy网络爬虫》全书 或 《Python 3网络爬虫开发实战》Scrapy篇。
学习重点:理解Scrapy引擎、调度器、下载器、管道的协同机制;编写Downloader Middleware实现自动更换User-Agent与代理IP;掌握Scrapy-Redis分布式任务队列原理。
通关验收标准:使用Scrapy框架构建一个具有完备日志记录、自动失败重试、中间件防封机制的工程级爬虫项目,实现单机每分钟稳定吞吐500个页面以上且不发生内存泄漏或任务堵塞。
六、自学注意事项与常见踩坑提醒
在依照教材自学过程中,有几个极易让初学者产生挫败感的坑,务必提前知晓:
- 切勿死磕商业大厂的现代风控:部分初学者刚学完Requests就尝试去抓取知乎、小红书、微博、美团等高风控平台,被滑动验证码、反调试断点、动态字体加密和签名参数(token/sign)劝退。初期所有实战必须在合规开源靶场(如 Scrape Center、Quotes to Scrape)或公开政府统计数据接口上进行,打牢基础后再接触进阶逆向。
- 重视法律边界与Robots协议:爬虫技术本身中立,但采集行为受法律约束。务必严格遵守目标站点的
robots.txt声明;不得采集带有个人隐私属性的敏感数据;控制请求并发频率,避免对目标服务器造成拒绝服务(DoS)式冲击;严禁越权抓取需付费或未公开的数据资产。 - 善用官方文档作为教材补充:纸质教材受出版周期限制,部分库(如Playwright、Scrapy)的版本更新可能会微调API参数。遇报错时先查看终端给出的完整Traceback,再对照官方最新英文文档,养成查阅第一手手册的工程习惯。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









