

Python3.15已经发布数据分析环境该不该升级?
针对新发布的 Python 3.15,全面分析数据分析与科学计算环境的升级决策、C 扩展依赖生态、常见兼容性问题及双轨验证操作步骤。
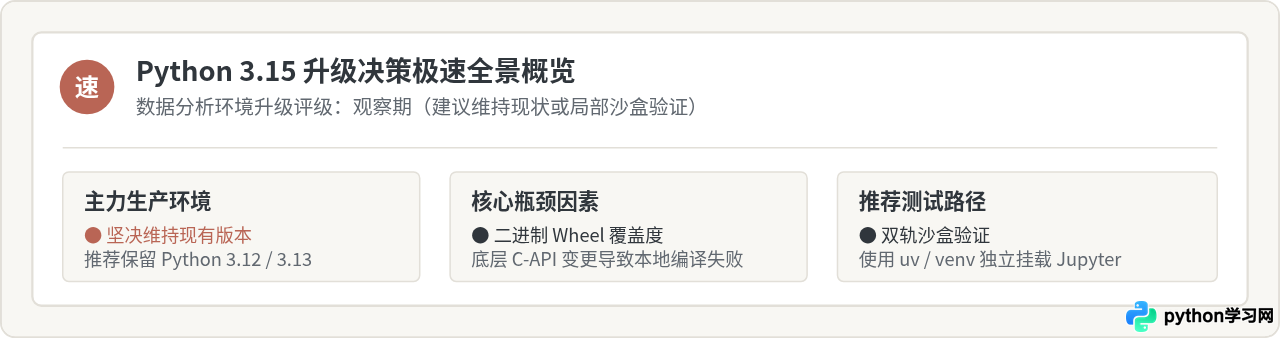
核心结论:生产与日常主力数据分析环境暂不建议立即升级至 Python 3.15。科学计算与数据分析库普遍高度依赖 C/C++/Fortran 底层编译扩展(C-API/ABI),在新版本发布初期,上游预编译二进制包(Wheel)尚未全量就绪。最稳妥的策略是:生产业务与日常报表流水线锁定在 Python 3.12 或 3.13 稳定分支,另建独立隔离的虚拟环境对 3.15 进行兼容性评估与新特性试用。
一、为什么数据分析环境对大版本升级极度敏感?
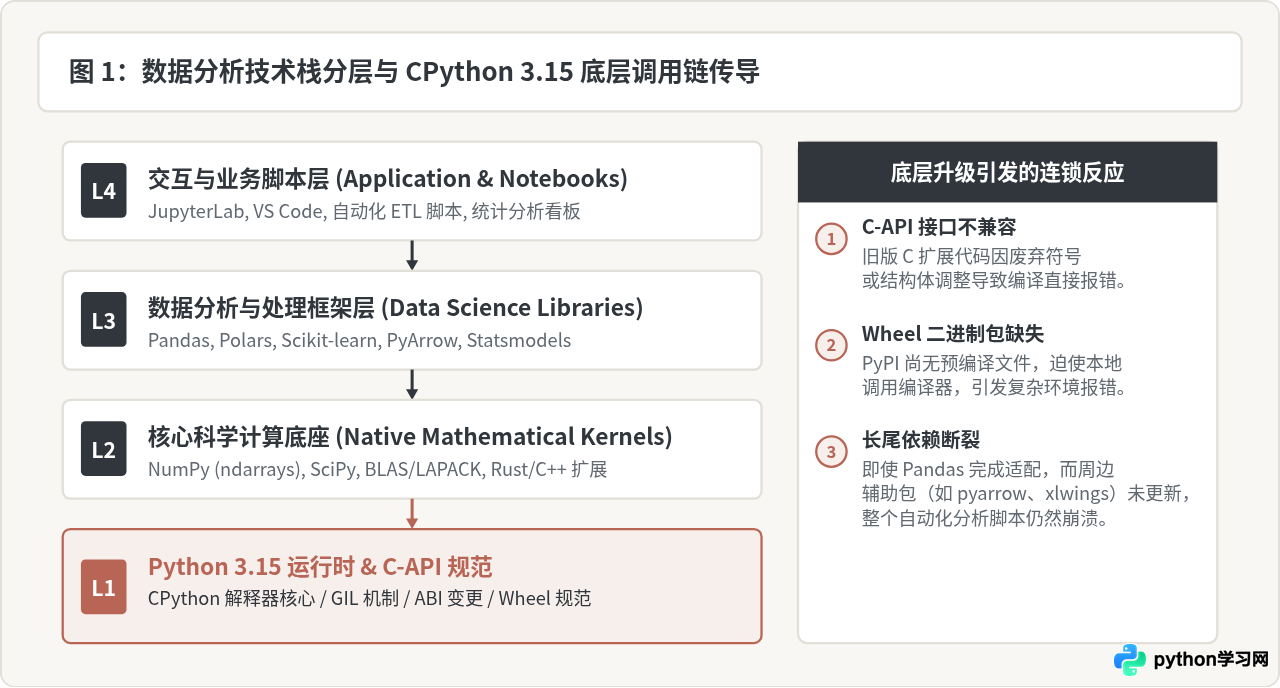
日常 Web 开发或轻量脚本通常纯粹由 Python 解释代码构成,依赖库升级大多仅涉及语法特性的前向兼容。但数据分析与科学计算技术栈完全不同:整个生态的运算性能建立在底层 C/C++、Fortran 以及 Rust 构建的编译扩展之上。
当 Python 官方发布新的次版本(如 Python 3.15)时,CPython 内部的底层 C-API、数据结构与应用二进制接口(ABI)会发生演进。这意味着所有包含原生扩展的三方包,必须针对 Python 3.15 的 ABI 重新编译构建对应平台的预编译二进制包(Wheel,如 .cp315-manylinux_x86_64.whl 或 .cp315-win_amd64.whl)。
如果直接执行升级命令,包管理器无法从 PyPI 获取针对 3.15 的 Wheel,便会退化为下载源码包(sdist)并在本地执行编译。大多数日常分析设备并未配置与底层库严格匹配的编译链(例如 MSVC、GCC、Clang、Fortran 以及 OpenBLAS、LAPACK、CUDA 头文件),极易直接触发构建失败崩溃。
二、升级决策树:哪些场景该按兵不动,哪些可以尝鲜?
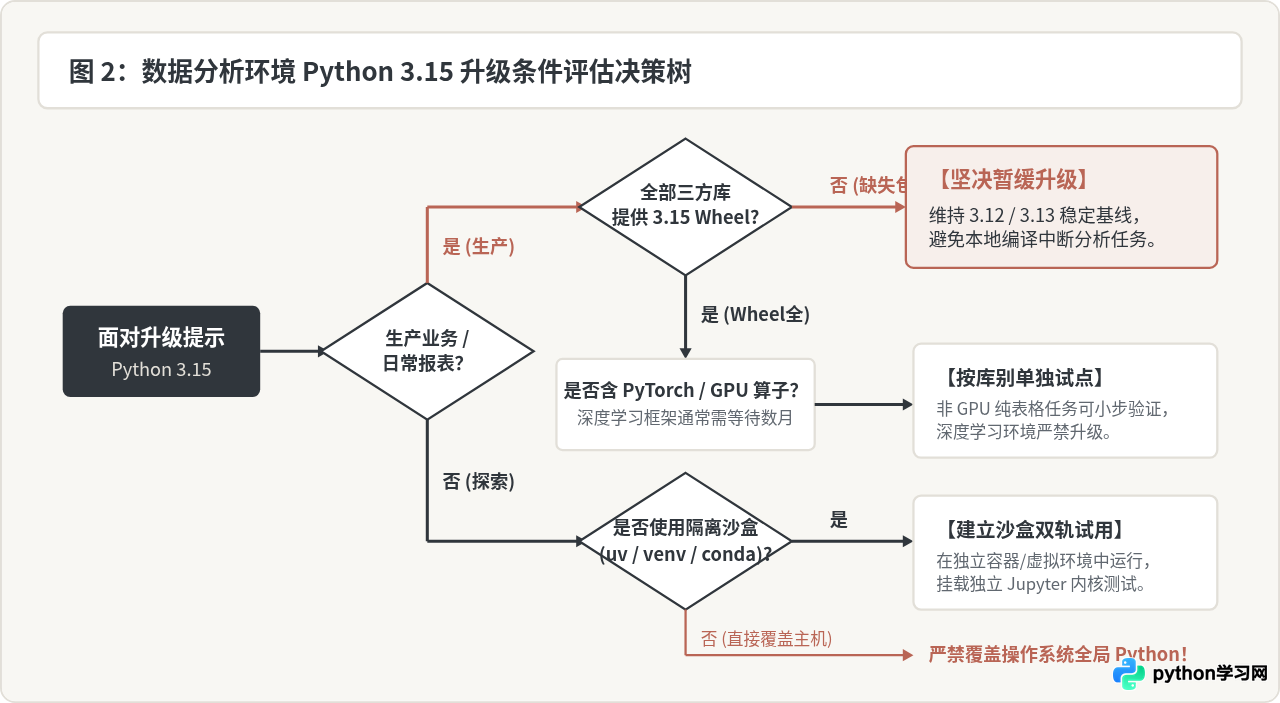
判断是否升级,不能仅看 Python 本身带来了哪些语法特性或性能优化,而必须结合具体工作场景对“稳定性”与“前沿特性”的权衡需求。以下是清晰的条件判断标准:
1. 坚决不要升级的三类场景
- 生产级 ETL 与定期自动化报表:若脚本用于每日生成财务数据、运营指标,或者部署在生产服务器的 Airflow/Cron 调度器中,任何包兼容故障都会导致核心业务停摆。此时稳定性压倒一切。
- 重度依赖深度学习或 GPU 算子:如 PyTorch、TensorFlow、JAX 以及特定版本的 CUDA 运行时。深度学习库往往需要数月时间适配新 Python 版本的 Wheel,盲目升级会导致 GPU 加速完全不可用。
- 团队多人协作与共享服务器环境:若组内其他分析师、工程师都在使用 Python 3.12/3.13,个别成员升级至 3.15 会导致导出的虚拟环境锁文件(如
poetry.lock或requirements.txt)在同事机器上无法还原。
2. 可以考虑搭建独立环境尝鲜的场景
- 本地单机做技术预研与性能对比:希望测试 Python 3.15 改进后的解释器性能、JIT 优化对纯 Python 算法逻辑的加速效果。
- 内部开源工具或公共脚本维护者:需要提前在 CI/CD 流水线中构建 Python 3.15 测试矩阵,确保未来的库发布具备向前兼容性。
三、如果需要评估新特性,如何安全搭建双轨测试环境?
如果出于技术调研目的需要体验 Python 3.15(例如验证 JIT 优化是否对循环密集的特征工程提速),核心原则是:绝对不修改当前系统或生产主环境。通过独立的包管理工具实现多版本隔离共存。
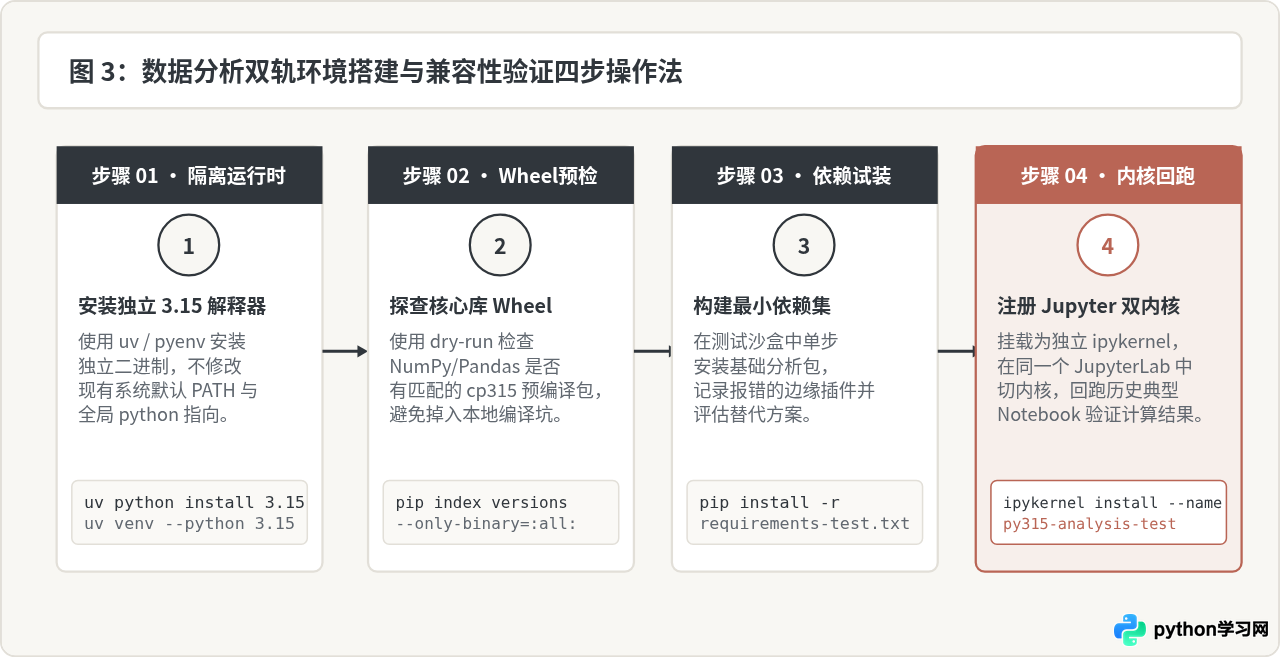
实操步骤与关键命令
以下以跨平台高效环境工具 uv(或标准 python -m venv)为例,展示完整的无损搭建流程:
# 1. 自动拉取并安装 Python 3.15 独立运行时(不污染全局)
uv python install 3.15

# 2. 在项目目录或测试专区创建名为 .venv315 的虚拟环境
uv venv .venv315 --python 3.15

# 3. 激活新虚拟环境
# macOS / Linux:
source .venv315/bin/activate
# Windows:
.venv315\Scripts\activate为防止 pip 在缺少预编译包时擅自启动 C 编译器并报错一整页,应添加 --only-binary=:all: 参数进行试装:
# 检查并安装核心数据分析基础包
pip install --only-binary=:all: numpy pandas matplotlib ipykernel如果控制台返回 Could not find a version that satisfies the requirement numpy (from versions: none),说明当前平台下官方尚未推送适用于 Python 3.15 的二进制 Wheel。此时应果断停止安装,切勿去掉 --only-binary 强行编译,否则将面临极其繁琐的 C/Fortran 依赖报错。
许多分析师习惯在同一个 JupyterLab 页面中处理工作。无需重新启动或升级现有的 JupyterLab 服务,只需将 3.15 环境作为新内核注册进去:
# 在激活的 3.15 虚拟环境中执行内核注册
python -m ipykernel install --user --name=py315-test --display-name "Python 3.15 (Test Environment)"
执行完成后,刷新已有的 JupyterLab 界面,即可在右上角 Kernel 切换菜单中看到 Python 3.15 (Test Environment)。打开历史数据处理 Notebook,切换到该内核执行全流程,能最直接地验证现有统计模型、数据清洗代码是否产生警告或异常。
四、升级常见故障与现象排查
在数据分析环境下尝试新版本时,最常遇到的三类典型故障及排查方式如下:
| 故障表现 (Error Pattern) | 底层根本原因 | 应对与排查措施 |
|---|---|---|
error: command 'gcc' failed 或 Microsoft Visual C++ 14.0 is required |
PyPI 缺少该操作系统/架构的预编译 Wheel,pip 尝试本地调用编译器编译 C 扩展代码失败。 | 不要在分析机上折腾编译器。查看对应库的 GitHub Release 页面,等待官方发布对应平台的 cp315 二进制包。 |
ImportError: cannot import name ... from ... |
Python 3.15 移除了部分在 3.13/3.14 标记废弃的旧 C-API 符号或模块内部私有属性。 | 旧版三方包未及时调整底层调用。检查三方包是否有专门适配 3.15 的新 patch 版本,否则回退 Python 运行版本。 |
Segmentation fault (core dumped) 运行时崩溃 |
C 扩展动态库在 ABI 变更后强行混合链接,或内存结构偏移不一致导致非法指针解引用。 | 严格清理虚拟环境缓存;切勿通过 PYTHONPATH 引用旧版本 Python 目录下的 .so / .pyd 编译文件。 |
五、版本演进与迁移节奏建议
开源科学计算生态的成熟具有明确的滞后周期。一个新主版本发布后,各层依赖库的适配通常遵循以下时间线:
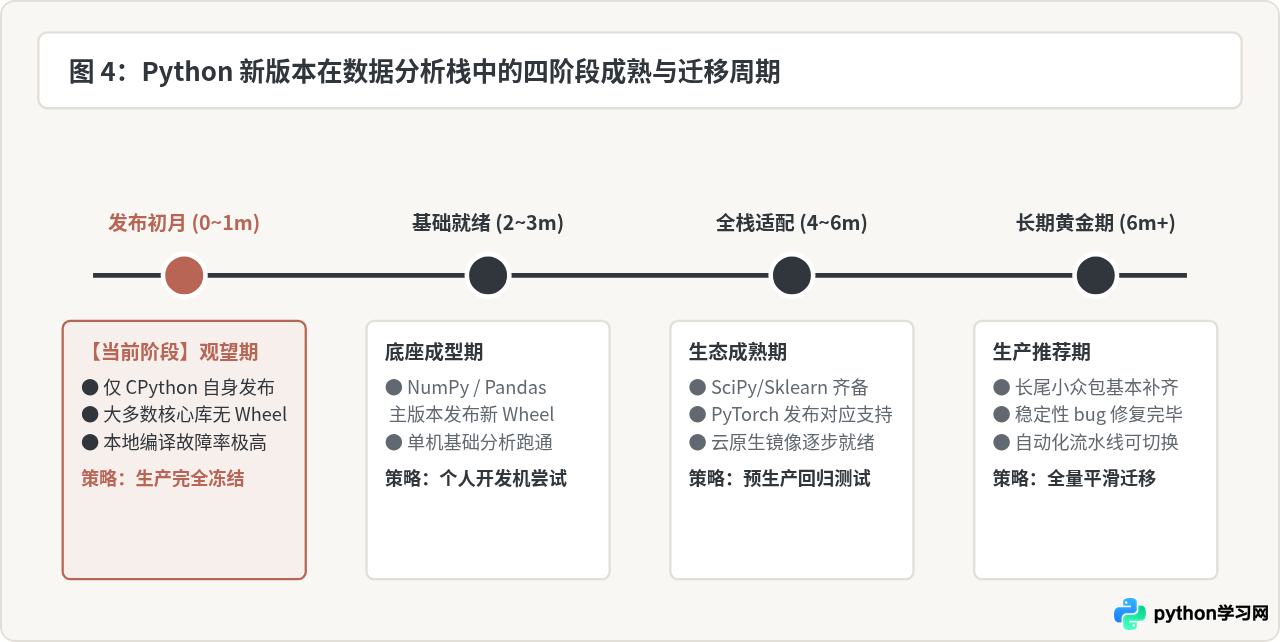
因此,对于正在进行日常取数、清洗、建模与报表自动化的数据分析师,最理性的方案是:
- 保持现状:继续基于成熟的 Python 3.12 或 3.13 开展日常生产交付,享受完整的 Wheel 支持与零维护成本。
- 关注动态:关注核心依赖库(NumPy、Pandas、Polars)的 Release 动态,确认其在 PyPI 上提供
cp315预编译文件。 - 沙盒演练:仅在独立的轻量沙盒中测试业务代码,等 3~6 个月后技术栈中的所有依赖库均完成闭环,再安排生产环境的有序切换。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









