

怎么用Python正则表达式清洗HTML标签数据
详细讲解如何使用Python内置re模块正则表达式清洗HTML标签数据,从去除基本标签、清除script与style代码块、处理HTML实体到空白规范化的完整步骤与示例。
在网络数据抓取、富文本内容解析或接口数据清洗时,我们常常会获得混杂着各种 HTML 标签、脚本块和转义实体的非结构化文本。清洗这部分数据的核心目标是:完整剔除尖括号标记与其携带的多余代码,还原可读的纯文本内容,同时保留正常的标点与段落间距。在 Python 中,内置的 re 模块提供了轻量、高效的正则替换方法 re.sub(),结合 html.unescape(),可以在无需安装第三方依赖的情况下完成标准化清洗。
一、正则表达式清洗 HTML 的基本原理与陷阱
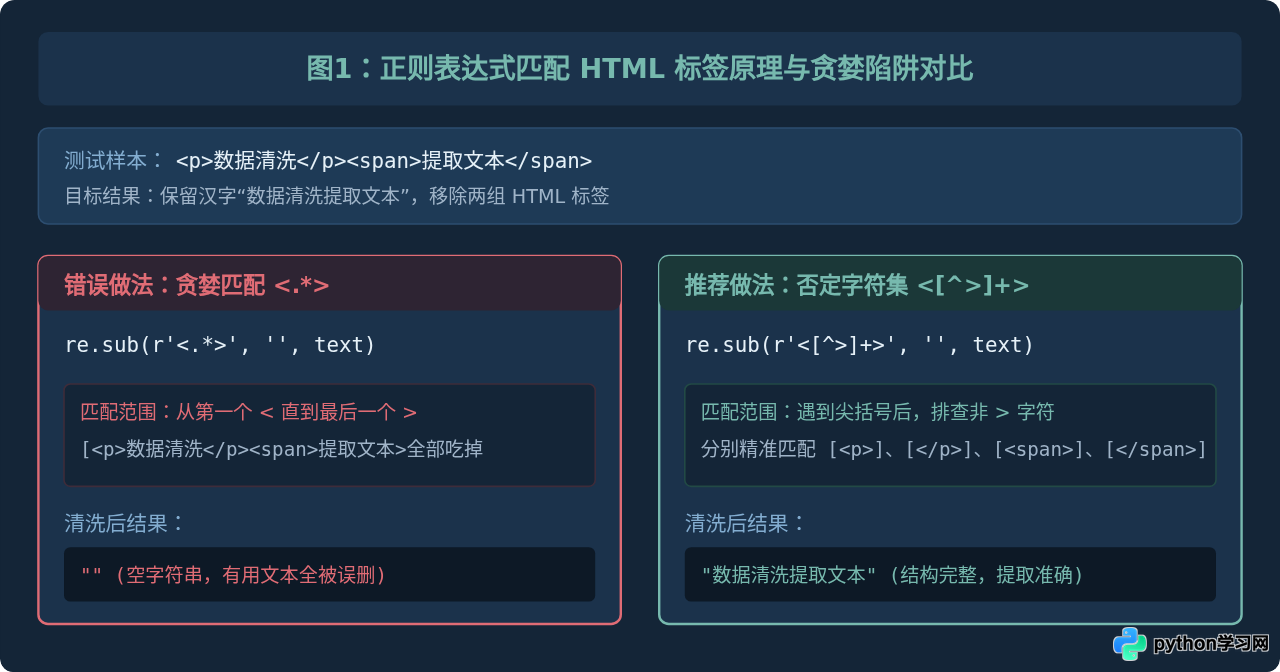
HTML 标签的最基本形态是由左右尖括号包裹的内容,例如 <div>、<p class="content"> 或闭合标签 </div>。初学者常犯的一个错误是直接使用 <.*> 尝试匹配标签,这会导致严重的“贪婪匹配”问题。
在正则表达式中,星号 * 默认具有贪婪性,它会尽可能多地吞噬字符。如果文本中包含 <p>段落一</p><p>段落二</p>,表达式 <.*> 会直接从第一个 < 匹配到最后一个 >,导致整个文本被全部删除。
解决此问题的有效方式有两种:一是使用非贪婪模式 <.*?>;二是使用否定字符集 <[^>]+>。其中 <[^>]+> 表示匹配以 < 开头、紧随一个或多个非 > 字符并以 > 结尾的片段。这种方式不仅执行效率更高,还能准确界定标签边界。
二、基础代码实现:使用 re.sub 清洗普通标签
在 Python 中,清洗操作主要依赖 re.sub(pattern, repl, string) 函数。其第一个参数为匹配模式,第二个参数为替换内容(通常替换为空字符串 ''),第三个参数为待处理文本。
import re

raw_html = "<div class='article'><h1>Python教程</h1><p>学习正则表达式清洗数据。</p></div>"

# 使用否定字符集匹配尖括号标签
clean_pattern = re.compile(r'<[^>]+>')
clean_text = clean_pattern.sub('', raw_html)

print("清洗后结果:", clean_text)
示例输出:
清洗后结果: Python教程学习正则表达式清洗数据。re.compile() 将正则表达式编译为 Pattern 对象,这样可以减少每次调用时的重复解析开销,显著提升执行速度。
三、进阶处理:清除 Script、Style 标签与 HTML 注释
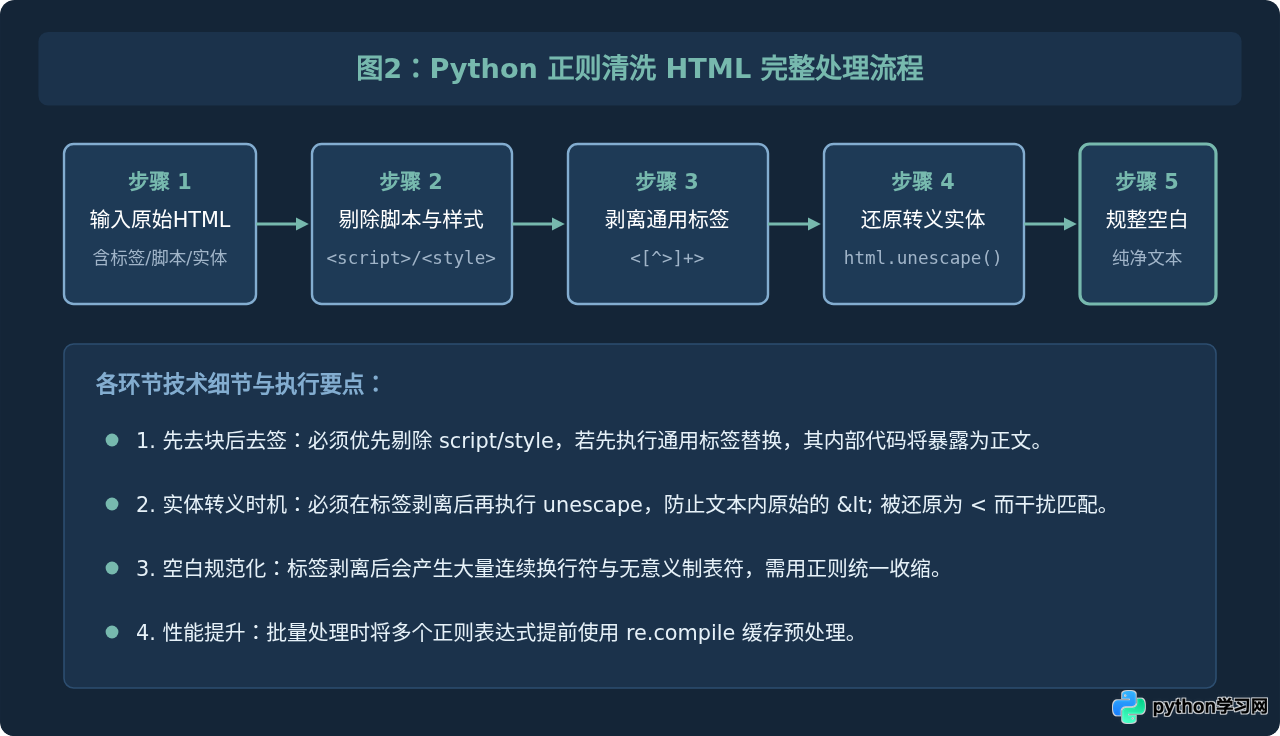
单纯剔除 <[^>]+> 能够处理常规排版标签,但在真实的网页源码中,还嵌入了大量的样式表 <style>、前端脚本 <script> 以及注释 <!-- ... -->。
如果仅移除两端的尖括号标签,<script>alert('test');</script> 中的 JavaScript 代码内容 alert('test'); 就会作为正文残留下来。因此,在剥离通用标签之前,必须连同标签内的子内容整块剔除。
1. 清除 Script 与 Style 块
我们需要匹配从 <script 开始,直到 </script> 结束的所有字符。由于脚本内部可能存在多行内容,需要使用非贪婪匹配结合不区分大小写标志 re.IGNORECASE 与跨行修饰:
# 移除脚本代码块
text = re.sub(r'<script[\s\S]*?</script>', '', text, flags=re.IGNORECASE)

# 移除内联样式代码块
text = re.sub(r'<style[\s\S]*?</style>', '', text, flags=re.IGNORECASE)
这里的 [\s\S] 表示匹配包括换行符在内的任意字符,比点号 . 更稳健;问号 ? 则确保命中最近的闭合标签,防止多段脚本被连续吞并。
2. 清除 HTML 注释
HTML 注释格式为 <!-- 注释内容 -->,清除规则如下:
# 移除 HTML 源码注释
text = re.sub(r'<!--[\s\S]*?-->', '', text)
四、完善清洗管道:处理 HTML 实体与多余空白
剥离所有标签后,文本中通常还会遗留两类常见问题:一是 HTML 转义字符(如 、&、"),二是标签被删除后暴露的大量连续空行与空格。
1. 还原转义字符
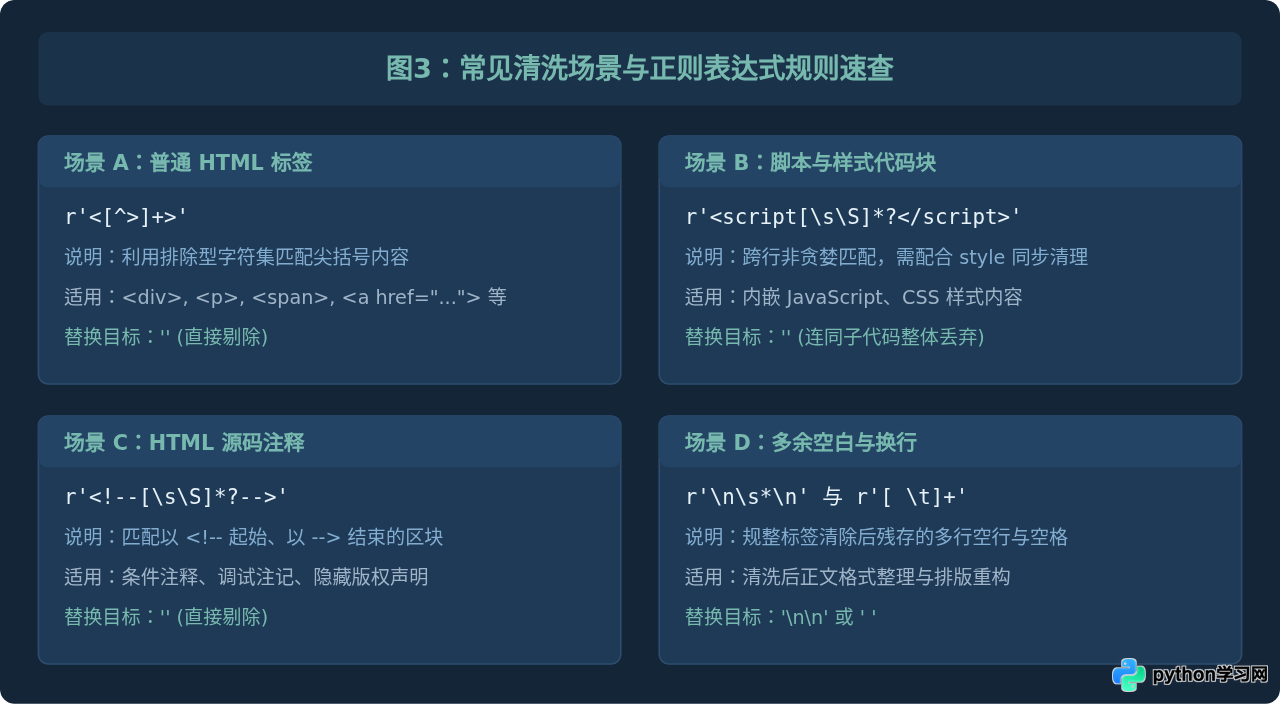
Python 3 内置了 html 模块,直接调用 html.unescape() 即可将各类命名实体和 Unicode 数值实体(例如 —)还原为真实字符:
import html

escaped_str = "Python 开发&爬虫<实战>"
unescaped_str = html.unescape(escaped_str)
print(unescaped_str)  # 输出:Python 开发&爬虫<实战>
html.unescape()。如果先还原实体,正文中原本写着的 <b> 会被提前还原成 <b>,随后被当作 HTML 标签错误删除。
2. 规范化空格与段落换行
多行 HTML 标签被替换为空后,往往会留下错乱的换行符或成串的空格。我们可以使用正则分步规整:
- 将连续多个水平空白符(空格、制表符)折叠为单个空格:
re.sub(r'[ \t]+', ' ', text) - 将超过两个的连续换行折叠为标准双换行(保留段落结构):
re.sub(r'\n\s*\n', '\n\n', text) - 去除全文首尾的空白字符:
text.strip()
五、完整的清洗函数封装与实战测试
我们将上述所有规则整合封装为一个可复用的 Python 函数 clean_html()。该函数能够依次剔除无用脚本代码、标签、注释,并自动解码实体与收缩空白。
import re
import html
class HTMLCleaner:
def __init__(self):
# 预编译常用正则表达式以提升吞吐性能
self.re_script = re.compile(r'<script[\s\S]*?</script>', re.IGNORECASE)
self.re_style = re.compile(r'<style[\s\S]*?</style>', re.IGNORECASE)
self.re_comment = re.compile(r'<!--[\s\S]*?-->')
self.re_tag = re.compile(r'<[^>]+>')
self.re_spaces = re.compile(r'[ \t]+')
self.re_newlines = re.compile(r'\n\s*\n')
def clean(self, raw_html: str) -> str:
if not raw_html or not isinstance(raw_html, str):
return ""
# 1. 移除脚本与样式块
text = self.re_script.sub('', raw_html)
text = self.re_style.sub('', text)
# 2. 移除 HTML 注释
text = self.re_comment.sub('', text)
# 3. 移除所有普通 HTML 标签
text = self.re_tag.sub('', text)
# 4. 还原 HTML 字符实体
text = html.unescape(text)
# 5. 规整空白与空行
text = self.re_spaces.sub(' ', text)
text = self.re_newlines.sub('\n\n', text)
return text.strip()
# 测试用例验证
if __name__ == '__main__':
cleaner = HTMLCleaner()
sample_html = """
<!DOCTYPE html>
<html>
<head>
<style>body { font-size: 14px; color: #333; }</style>
<script>
function track() { console.log("analytics"); }
</script>
</head>
<body>
<!-- 主要内容区开始 -->
<h1>Python 正则清洗实践</h1>
<p>使用正则表达式清洗数据既<b>高效</b>又轻量。</p>
<p>价格说明:¥99 & 免邮费。</p>
</body>
</html>
"""
result = cleaner.clean(sample_html)
print("=== 清洗结果 ===")
print(result)
运行结果输出:
=== 清洗结果 ===
Python 正则清洗实践

使用正则表达式清洗数据既高效又轻量。

价格说明:¥99 & 免邮费。可以看到,<style>、<script> 及注释被完全过滤,正文中的 变成了普通空格,¥ 被正确转回日元/人民币符号 ¥,& 转回 &,段落与格式保持了工整自然。
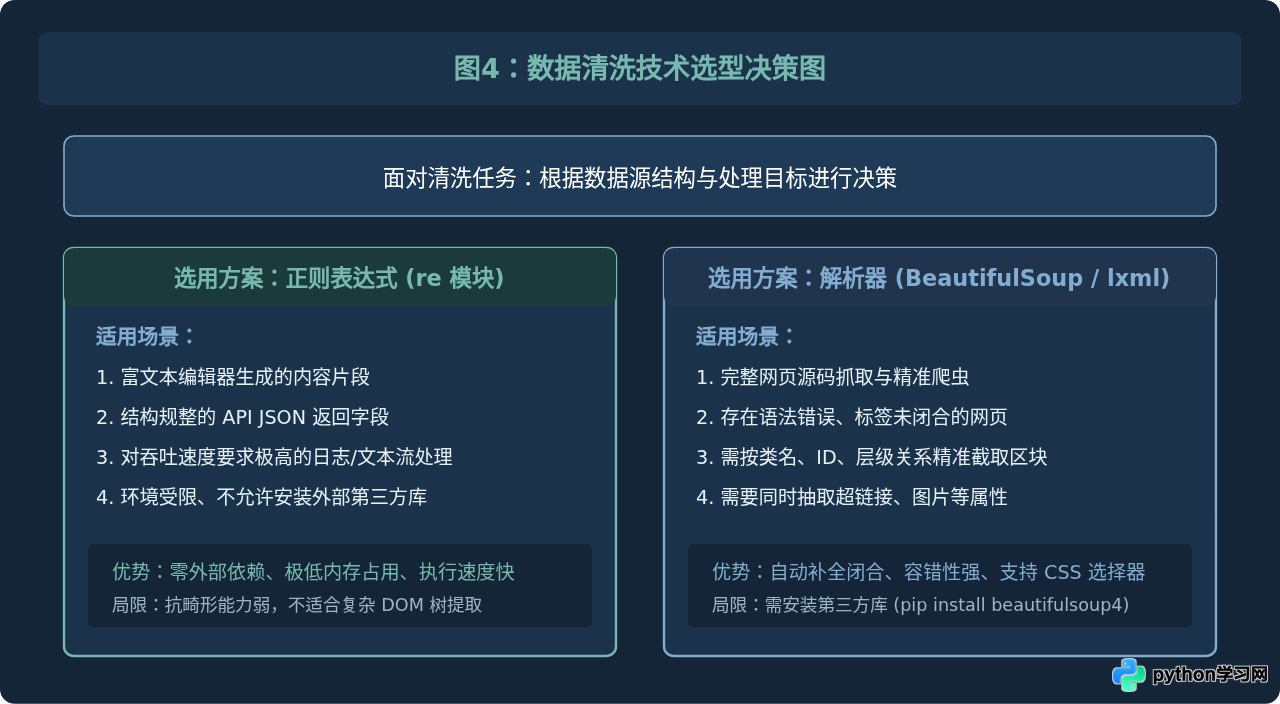
六、正则表达式的适用边界与选型建议
虽然正则表达式在处理单行标签、规范 HTML 片段或轻量级过滤时非常迅捷,但读者必须明确它的适用边界。HTML 本质上是一种具备上下文依赖的上下文无关文法(Context-Free Grammar),而不是严格意义上的正规文法(Regular Grammar)。
在面对以下复杂场景时,仅靠正则表达式往往容易出现逻辑盲区:
- 格式畸形的页面:缺少闭合尖括号、标签属性内部包含未转义的大于号(如
<img alt="a>b" src="pic.jpg">)。 - 深度复杂的嵌套结构:例如需要提取指定
<div id="article-body">内部的所有文本并保留局部排版。 - 基于 DOM 树的精准提取:需要根据 CSS 选择器或 XPath 筛选节点并提取特定属性(如超链接
href或图片地址src)。
七、常见问题排查与注意事项
| 异常现象 | 根本原因 | 解决方案 |
|---|---|---|
清洗后文本之间缺少空格,单词黏连在一块(如 hello<span>world 变成 helloworld) |
直接将标签替换为了空字符串 '',丢失了原本作为块级元素的分隔作用。 |
可先将 </p>、<br>、</div> 等块级标签替换为换行符 \n 或空格,再剔除其余行内标签。 |
| 清洗大文本时速度慢、CPU 占用率高 | 在循环内频繁调用 re.sub(r'...', ...),每次都在重复解析与编译正则模式。 |
在函数或类初始化时使用 re.compile() 将模式预编译,并在循环体中直接调用已编译对象。 |
带有样式的标签残留或漏匹配(如换行后的属性 <div\n class="box">) |
正则表达式中未正确匹配换行空白字符。 | 使用 <[^>]+> 即可天然匹配包含换行的多行属性,因为换行符属于“非 > 字符”范畴。 |
总结而言,使用 Python 正则表达式清洗 HTML 标签数据是一项轻量、快速且不依赖任何第三方扩展库的实用技巧。只要牢记“先剔除脚本样式块、再剥离普通尖括号、随后解码实体转义、最后规整连续空白”的流水线法则,就能稳健地完成绝大多数数据清洗任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









