

Python读取xls旧版Excel文件报错怎么办
针对Python读取.xls旧版Excel文件常见的缺失xlrd、引擎错配openpyxl、Expected BOF record伪文件等报错,提供详尽的成因剖析、排查流程、修复代码与优化方案。
.xls 格式的旧版 Excel 文件(Excel 97-2003 规范)时,最常见的报错通常由三类原因引起:运行环境缺少 xlrd 依赖、错误指定了仅支持 .xlsx 的 openpyxl 引擎,或者该文件实质为系统导出的“伪 .xls”网页/文本表格。解决的核心路径是先确认报错的具体回溯信息,核实文件的真实格式,随后安装对应版本的解析器或切换专门的读取函数。
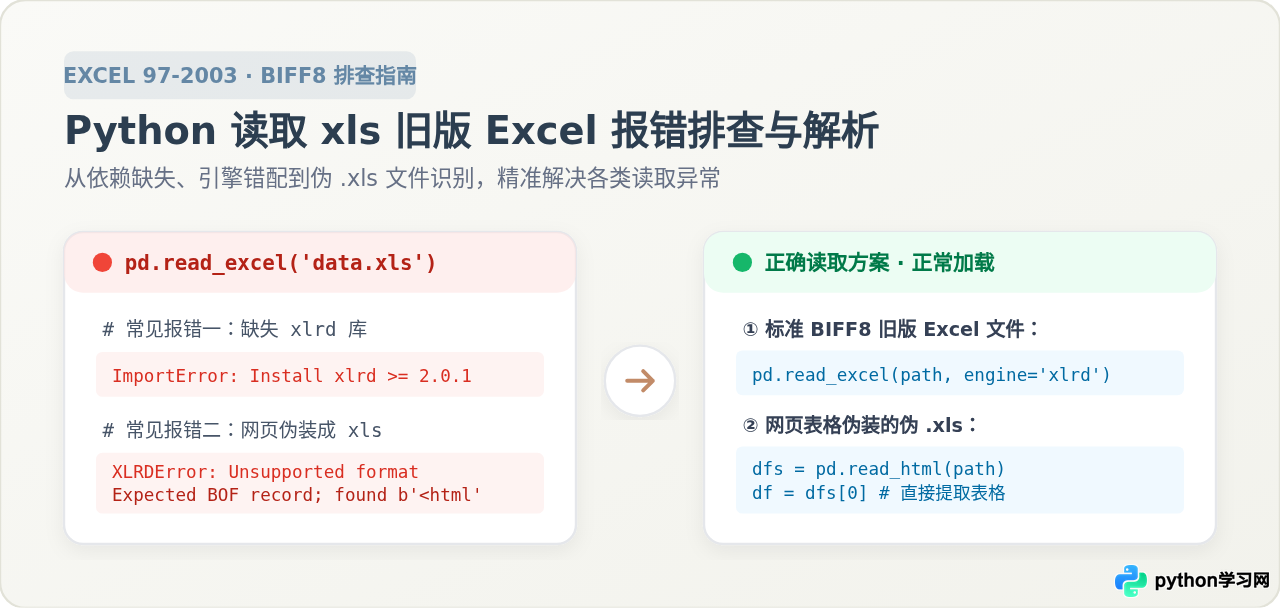
图 0:Python 读取 .xls 旧版 Excel 常见异常与对应解决机制概览
一、排查常见报错信息:定位根因
当执行 pd.read_excel('data.xls') 或使用原生类库调用时,终端返回的 Traceback 通常已经清晰提示了故障所在。在开始修改代码前,首先对照以下典型报错信息,确定当前问题归属于哪一种具体情形:
1. 缺少依赖:ImportError: Missing optional dependency 'xlrd'
Pandas 本身不直接解析 Excel 底层二进制流,而是调用第三方引擎。对于 .xls 文件,Pandas 默认使用 xlrd。如果在当前 Python 虚拟环境中未安装该库,程序就会直接抛出该导入异常。
2. 引擎选型错误:InvalidFileException: openpyxl does not support the old .xls
现代 Python 数据处理中,很多人习惯指定 engine='openpyxl'。但 openpyxl 是专为基于 XML 的新版 .xlsx 格式设计的,完全不支持二进制的 .xls。若在读取 .xls 时显式配置了 engine='openpyxl',就会报出该类型不支持错误。
3. 伪 xls 文件:XLRDError: Unsupported format, or corrupt file: Expected BOF record
许多企业 OA 系统、银行对账后台或政务导出系统在生成报表时,并没有真正构建复杂的 BIFF8 二进制结构,而是直接将 HTML 网页表格(<table>...</table>)或 CSV 纯文本文件强行加上 .xls 扩展名。Excel 软件打开时能自动识别网页并兼容渲染,但 xlrd 是严格按照二进制规范解析的,当在文件起始处找不到 BOF(Beginning Of File,记录标识 0x0809)时,就会抛出文件损坏或格式不支持异常。
4. 扩展名混淆:XLRDError: Excel xlsx file; not supported
自 xlrd 2.0.0 起,官方为了防范安全漏洞,正式移除了对 .xlsx 的解析功能,声明该库仅服务于旧版 .xls。如果某些文件实际是 .xlsx 却被改名为 .xls,xlrd 识别到 ZIP 格式特征后会主动报错拒绝。
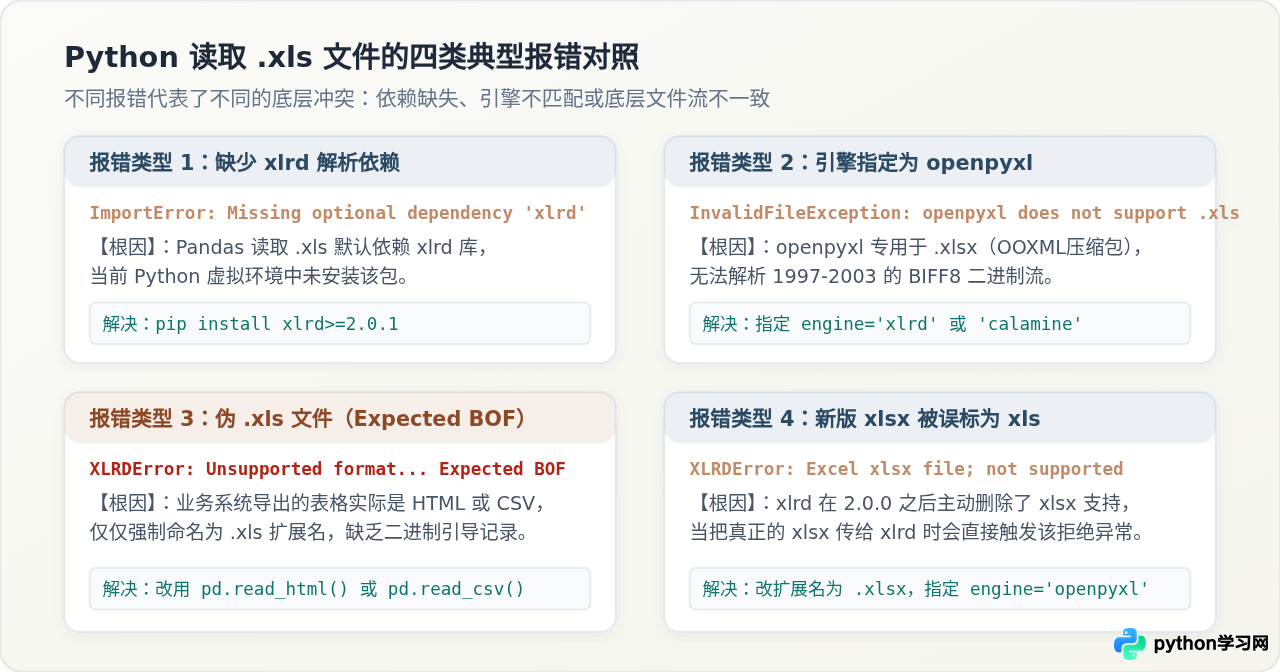
图 1:四种常见 .xls 读取报错分类及根因对应关系
二、标准 .xls 文件的常规解决步骤
若确认文件为真正的旧版 Excel 97-2003 二进制文件,请按以下步骤配置并规范读取代码:
步骤 1:安装 xlrd 库
在终端或命令行执行安装命令。注意:确保安装的是 2.0 及以上版本(若仅用于读取标准 .xls):
# 在终端或当前 Python 虚拟环境中执行
pip install "xlrd>=2.0.1"
步骤 2:在 Pandas 中显式指定 engine='xlrd'
为了避免 Pandas 受到全局配置或环境残留参数影响,在调用 pd.read_excel 时显式传入 engine='xlrd':
import pandas as pd

# 显式声明解析引擎为 xlrd
file_path = "sales_report_2003.xls"
df = pd.read_excel(file_path, engine="xlrd")

# 验证数据读取结果
print(f"读取成功,共 {df.shape[0]} 行,{df.shape[1]} 列。")
print(df.head())xlrd 动态库生效。
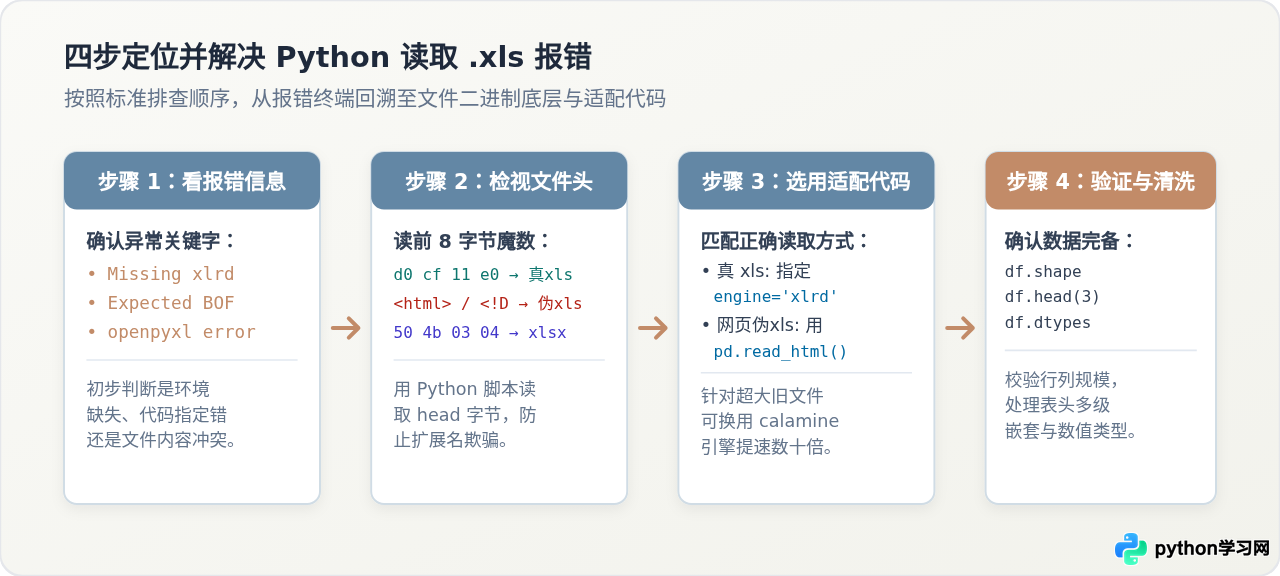
图 2:排查并解决 Python 读取 .xls 报错的四步标准操作流程
三、处理“伪 .xls”文件(HTML/CSV 伪装)
如果已经安装了 xlrd 且显式指定了引擎,却依然收到 Expected BOF record; found b'<html' 或 found b'<!DOCT',说明该文件并不是标准二进制 Excel,而是 HTML 格式文本。
1. 如何通过 Python 验证真实文件头
可以通过读取文件开头的几个字节(Magic Bytes),直接判断其底层真实格式:
# 快速检测文件开头的特征字节
file_path = "sales_report_2003.xls"

with open(file_path, "rb") as f:
    header = f.read(16)
    print("文件头部字节:", header)

# 判断分析:
# 若输出以 b'\xd0\xcf\x11\xe0' 开头,代表是真正的 OLE2 / BIFF8 标准 .xls 文件
# 若输出包含 b'<html'、b'<!DOCTYPE'、b'<table',代表是伪装成 .xls 的网页表格
# 若输出以 b'PK\x03\x04' 开头,代表实质是新版 .xlsx(ZIP压缩包)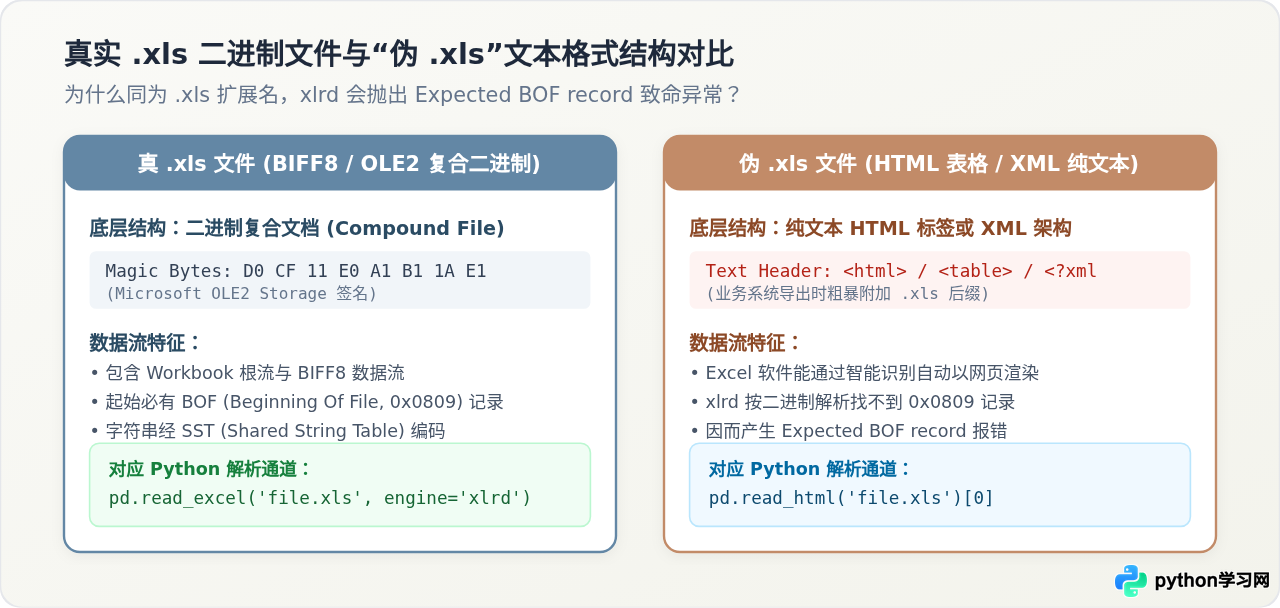
图 3:真实 .xls 复合二进制与伪 .xls 文本表格结构对比
2. 针对 HTML 伪装文件的读取代码
若检测出文件实际是 HTML 网页表格,使用 pd.read_html() 能够一次性直接解析出数据表格:
import pandas as pd

# 使用 read_html 解析伪装成 .xls 的网页表格
file_path = "sales_report_2003.xls"

try:
    # pd.read_html 会返回该页面内所有 table 标签构成的 DataFrame 列表
    dfs = pd.read_html(file_path, encoding="utf-8")
    df = dfs[0]  # 通常首个表格即为主数据
    print("成功解析 HTML 伪装表格:")
    print(df.head())
except UnicodeDecodeError:
    # 部分国内老系统可能使用 GBK / GB18030 编码
    dfs = pd.read_html(file_path, encoding="gbk")
    df = dfs[0]
    print("成功以 GBK 编码解析表格:")
    print(df.head())
提示:使用 pd.read_html 需要环境具备 lxml 或 html5lib 依赖。若报错提示缺失依赖,执行 pip install lxml 即可。
四、高性能与现代替代方案:python-calamine
对于包含数万行至数十万行的庞大历史 .xls 表格,xlrd 的纯 Python 实现解析速度较慢,且占用较多内存。如果使用的 Pandas 版本较新(Pandas 2.0+),推荐使用基于 Rust 编写的高性能引擎 python-calamine:
# 1. 安装 calamine 引擎支持
pip install python-calamine

# 2. 在 pandas 中直接调用
import pandas as pd

df = pd.read_excel("large_legacy.xls", engine="calamine")
print(df.shape)
calamine 同时兼容 .xls、.xlsx 和 .xlsb,在保持对旧版兼容的同时,大幅降低了解析卡顿概率。
五、方法决策与长效建议总结
遇到 Python 读取旧版 Excel 报错时,请根据以下表格进行决策对照:
| 报错特征 / 表现 | 根本原因 | 推荐解决手段 |
|---|---|---|
Missing optional dependency 'xlrd' |
Python 运行环境中缺少 xlrd 库 |
pip install xlrd>=2.0.1 |
openpyxl does not support .xls |
显式传入了仅支持 xlsx 的引擎 | 改为 engine='xlrd' 或 engine='calamine' |
Expected BOF record; found b'<html' |
系统导出的 HTML 表格被命名为 .xls | 改用 pd.read_html(file, encoding='...') |
Excel xlsx file; not supported |
实际为 .xlsx 文件但扩展名被标错 | 将扩展名更正为 .xlsx,使用 openpyxl |
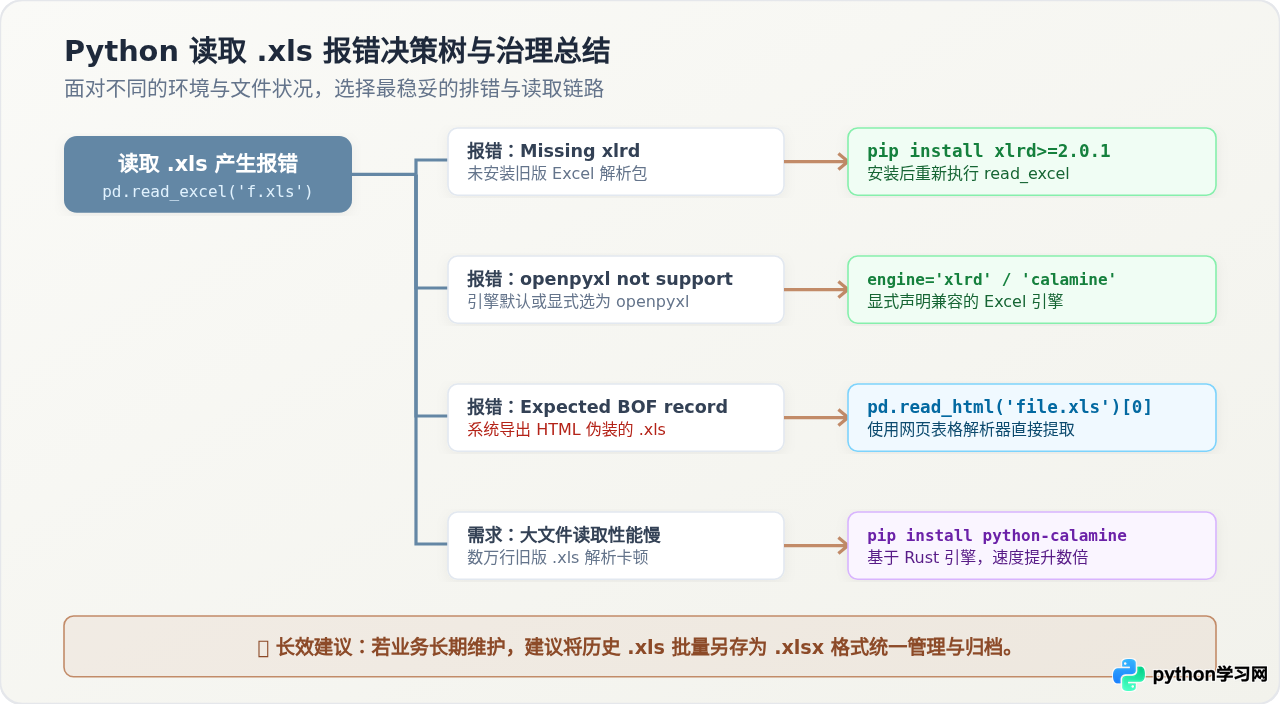
图 4:Python 处理 .xls 报错决策树与治理流程总结
在长期的数据管道或自动化运维场景中,.xls 属于已退役逾二十年的老旧规范。如果这批文件需要被多次分析或写入,建议在首次清洗后使用 df.to_excel('converted.xlsx', index=False) 或 df.to_parquet('data.parquet') 转存为现代标准格式,避免后续维护中反复陷入兼容性排查。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









