

怎么将简单的Python脚本重构为规范的Python程序
系统介绍如何将零散、硬编码的单文件Python脚本重构为具备模块化结构、命令行接口、分级日志、异常防御机制与自动化测试的规范Python程序。
许多初学者或自动化任务的编写者常将业务逻辑平铺在一个几十行的 .py 文件中:变量在全局作用域随意读取、路径在代码深处写死、依靠 print 打印调试、遭遇异常直接中断抛出回溯。将这种一次性脚本重构为规范的 Python 程序,核心路径是“逻辑解耦与纯函数提炼、入参与配置标准化、结构化日志与异常防护、标准包目录组织与自动化测试”。本文通过一个真实的日志统计与报表导出案例,一步一步演示重构的全流程与工程标准。
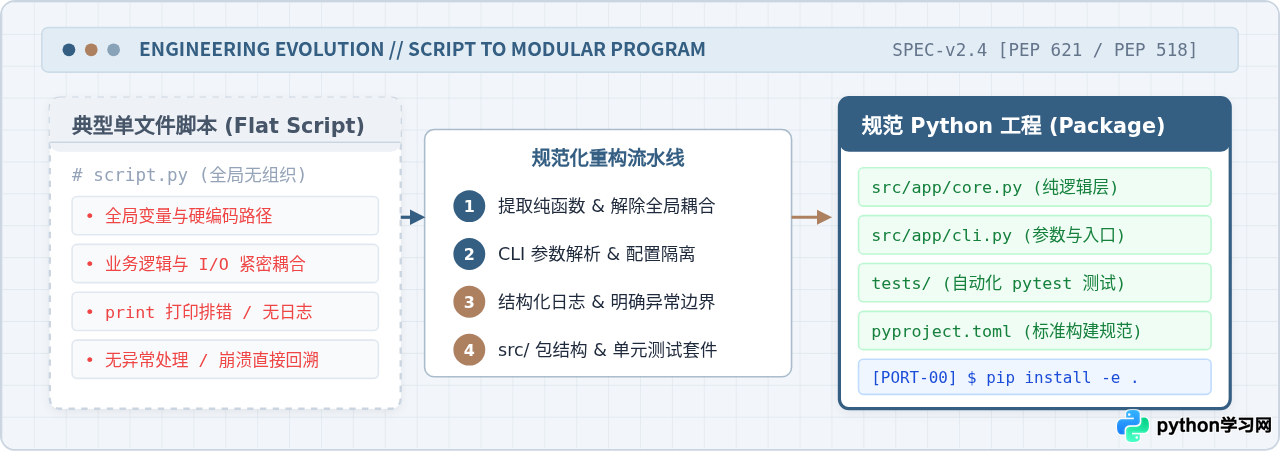
一、原始脚本的典型病症与重构目标
为了具体展现重构的演进过程,我们先来看一段在日常工作中非常常见的脚本:它用于读取服务器访问日志文件,统计特定状态码的请求数量和高频访问 IP,并将结果输出。
重构前:process_log.py (典型单文件平铺代码)# process_log.py - 原始简单脚本
# 问题:全局变量乱飞、文件路径写死、无函数拆分、直接 print 输出
log_path = "/var/log/nginx/access.log"
output_path = "/tmp/summary_report.txt"
print("正在读取日志文件...")
f = open(log_path, "r", encoding="utf-8")
lines = f.readlines()
f.close()
error_count = 0
ip_counter = {}
for line in lines:
parts = line.strip().split()
if len(parts) >= 9:
ip = parts[0]
status = parts[8]
if status.startswith("5"):
error_count += 1
ip_counter[ip] = ip_counter.get(ip, 0) + 1
print("分析完毕,正在写出报告...")
out_f = open(output_path, "w", encoding="utf-8")
out_f.write(f"5xx 服务器错误总数: {error_count}\n")
out_f.write("异常请求排名前三的 IP:\n")
sorted_ips = sorted(ip_counter.items(), key=lambda x: x[1], reverse=True)[:3]
for ip, cnt in sorted_ips:
out_f.write(f"{ip}: {cnt}\n")
out_f.close()
print(f"完成!报告已保存至 {output_path}")
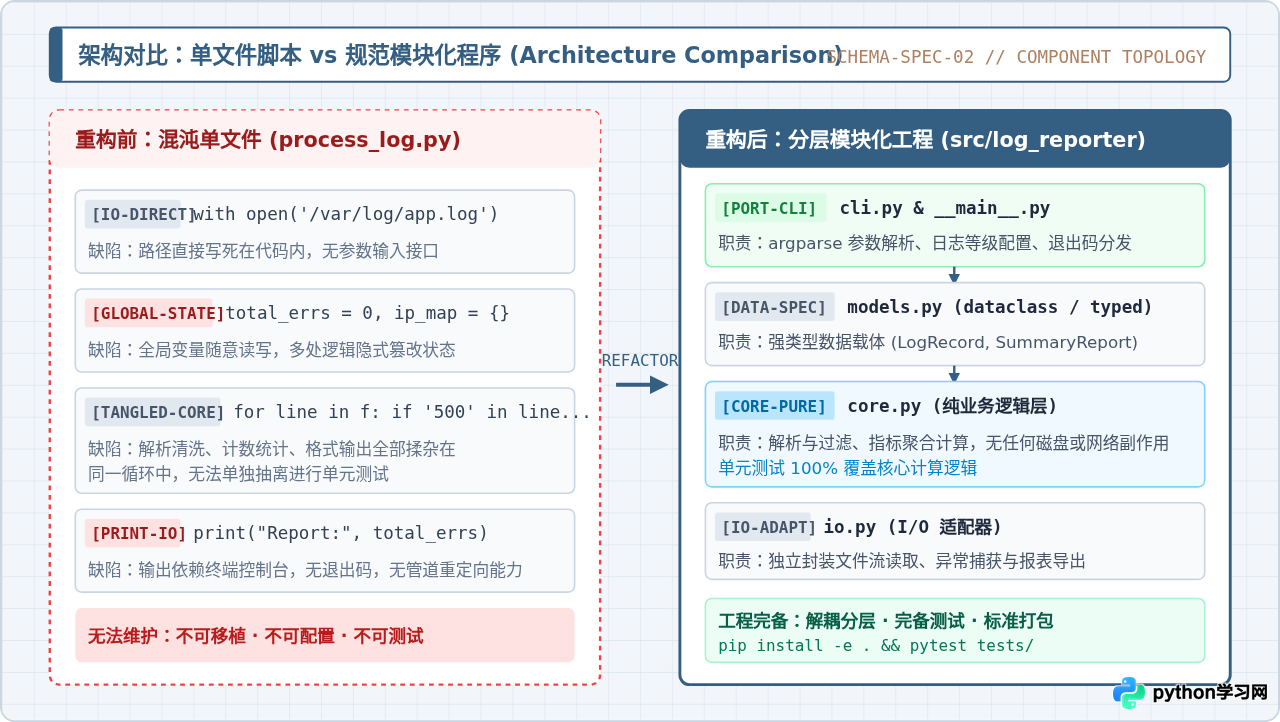
这段代码虽然能够满足“一次性跑通”的要求,但在实际工程环境中存在显著隐患:
- 无隔离的全局状态:
error_count和ip_counter暴露在模块顶级,无法防止后续代码对其产生意外篡改。 - 强依赖本地特定路径:
log_path写死为/var/log/nginx/access.log,换一台机器或在 Windows 环境下运行直接崩溃。 - 资源泄漏隐患:使用裸露的
open()而非with上下文管理器,一旦读取中途抛出解码错误,文件句柄将一直悬挂占用。 - 不可测试(Untestable):业务计算(解析状态码、排序聚合)与外部 I/O 紧紧杂糅在一起,无法在没有实际磁盘文件的情况下编写单元测试。
- 不可作为模块导入:如果另一个脚本执行
import process_log,该文件在导入瞬间就会强行执行全部读取与写出操作。
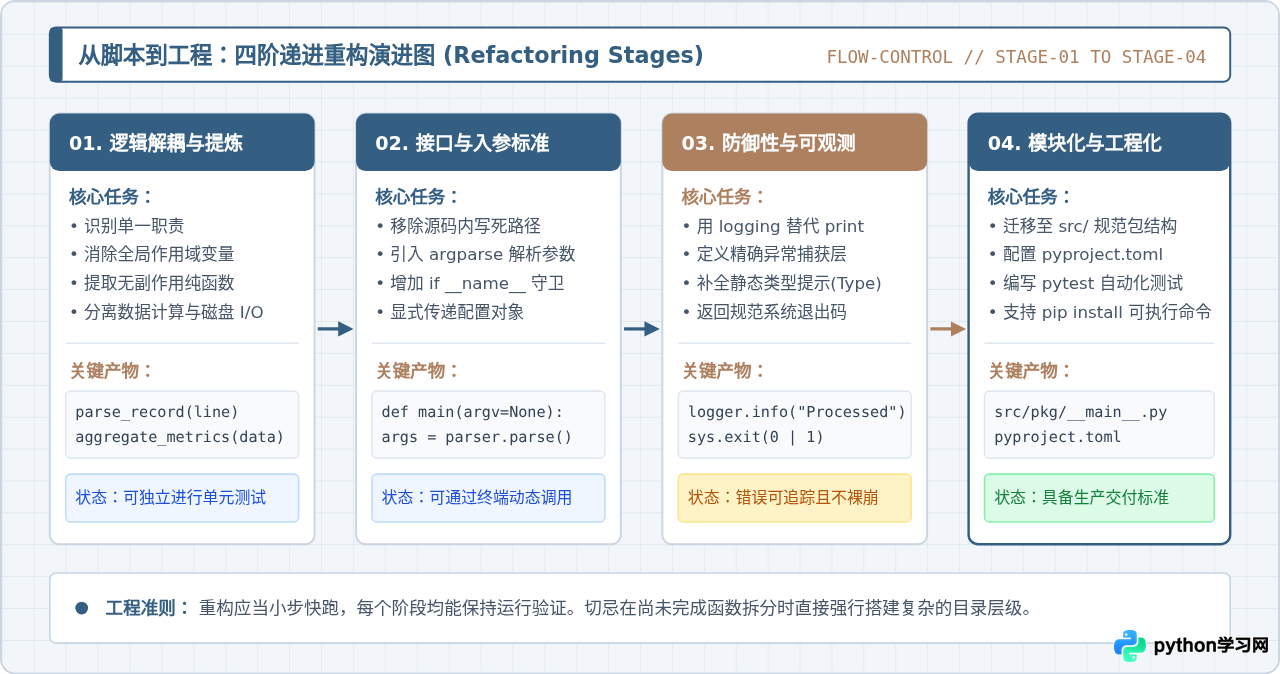
二、第一步:提炼纯函数并分离副作用
重构的第一步是**划定职责边界,消除副作用**。副作用指对函数外部世界产生的可观察变化,例如修改全局变量、读取文件、调用网络接口或在控制台打印字符。
一个规范的程序应尽可能将核心业务计算收敛在“纯函数”(Pure Functions)中:相同的输入始终产生相同的输出,不依赖也不改变外部状态。我们将原脚本拆解为三部分:
- 数据清洗解析(纯逻辑):接收单行文本,提取结构化数据(如 IP、状态码)。
- 指标聚合计算(纯逻辑):接收结构化数据集合,统计 5xx 错误并计算 Top IP。
- 外部 I/O 操作(副作用):独立处理磁盘文件的读取和写入,并使用上下文管理器保证句柄关闭。
from typing import List, Dict, Tuple, Optional
from dataclasses import dataclass

@dataclass(frozen=True)
class LogEntry:
    """日志条目强类型数据载体"""
    ip: str
    status_code: int

def parse_log_line(line: str) -> Optional[LogEntry]:
    """解析单行日志文本;格式不符时返回 None,杜绝未处理索引异常"""
    parts = line.strip().split()
    if len(parts) < 9:
        return None
    try:
        status = int(parts[8])
        return LogEntry(ip=parts[0], status_code=status)
    except ValueError:
        return None

def calculate_error_metrics(
    entries: List[LogEntry], top_n: int = 3
) -> Tuple[int, List[Tuple[str, int]]]:
    """计算 5xx 错误总数及排名前 N 的故障来源 IP(纯函数,无 I/O)"""
    error_count = 0
    ip_counter: Dict[str, int] = {}

    for entry in entries:
        if 500 <= entry.status_code < 600:
            error_count += 1
            ip_counter[entry.ip] = ip_counter.get(entry.ip, 0) + 1

    sorted_ips = sorted(ip_counter.items(), key=lambda item: item[1], reverse=True)[:top_n]
    return error_count, sorted_ips
calculate_error_metrics 后,你甚至无需任何真实的日志文件,就可以用两行代码在测试框架中验证算法正确性:
assert calculate_error_metrics([LogEntry('127.0.0.1', 502)])[0] == 1。
三、第二步:标准化入口与命令行参数解析
脚本与可交付程序的关键区别之一在于**入参控制**。规范的 Python 程序必须满足两个标准:
- 导入安全性:提供
if __name__ == '__main__':守卫,确保作为模块导入时不触发任何业务操作。 - 动态配置能力:使用标准库
argparse取代代码内写死的路径,支持通过命令行传参,提供--help帮助提示。
import sys
import argparse
from pathlib import Path

def build_argument_parser() -> argparse.ArgumentParser:
    """定义并构建命令行参数规范"""
    parser = argparse.ArgumentParser(
        prog="log-reporter",
        description="分析 Nginx 访问日志并导出 5xx 异常统计报表"
    )
    parser.add_argument(
        "-i", "--input",
        type=Path,
        required=True,
        help="目标日志文件路径(支持相对路径或绝对路径)"
    )
    parser.add_argument(
        "-o", "--output",
        type=Path,
        default=Path("report.txt"),
        help="输出报表的目标路径(默认: ./report.txt)"
    )
    parser.add_argument(
        "--top",
        type=int,
        default=3,
        help="统计排名前 N 的高频异常 IP(默认: 3)"
    )
    parser.add_argument(
        "-v", "--verbose",
        action="store_true",
        help="开启详细调试输出"
    )
    return parser

def main(argv: Optional[List[str]] = None) -> int:
    """应用程序统一控制入口,返回标准系统状态码"""
    parser = build_argument_parser()
    args = parser.parse_args(argv)

    # 校验输入文件存在性
    if not args.input.is_file():
        sys.stderr.write(f"错误: 输入文件不存在或不可读 -> {args.input}\n")
        return 2

    # 执行核心逻辑(下文将进一步包装日志与异常处理)
    print(f"正在处理: {args.input} -> 目标: {args.output}")
    return 0

if __name__ == "__main__":
    sys.exit(main())
main(argv: Optional[List[str]] = None) 显式设计,允许我们在自动化测试中直接调用 main(["-i", "test.log", "--top", "5"]) 模拟执行,而不需要通过子进程调用命令行;返回 int 状态码(0 代表成功,非 0 代表失败)则与操作系统的标准进程退出契约(POSIX 约定)无缝结合。
四、第三步:结构化日志与鲁棒的异常边界
在简单的脚本中,开发者习惯用 print() 打印各种阶段信息。但在生产环境或自动化运行场景中,print() 存在致命缺陷:
- 无法区分调试信息(DEBUG)、操作提示(INFO)与错误故障(ERROR)。
- 全部内容直接灌入标准输出(stdout),导致管道重定向或调用方无法单独捕获纯数据。
- 无法记录时间戳、代码位置和线程信息,线上排错无从下手。
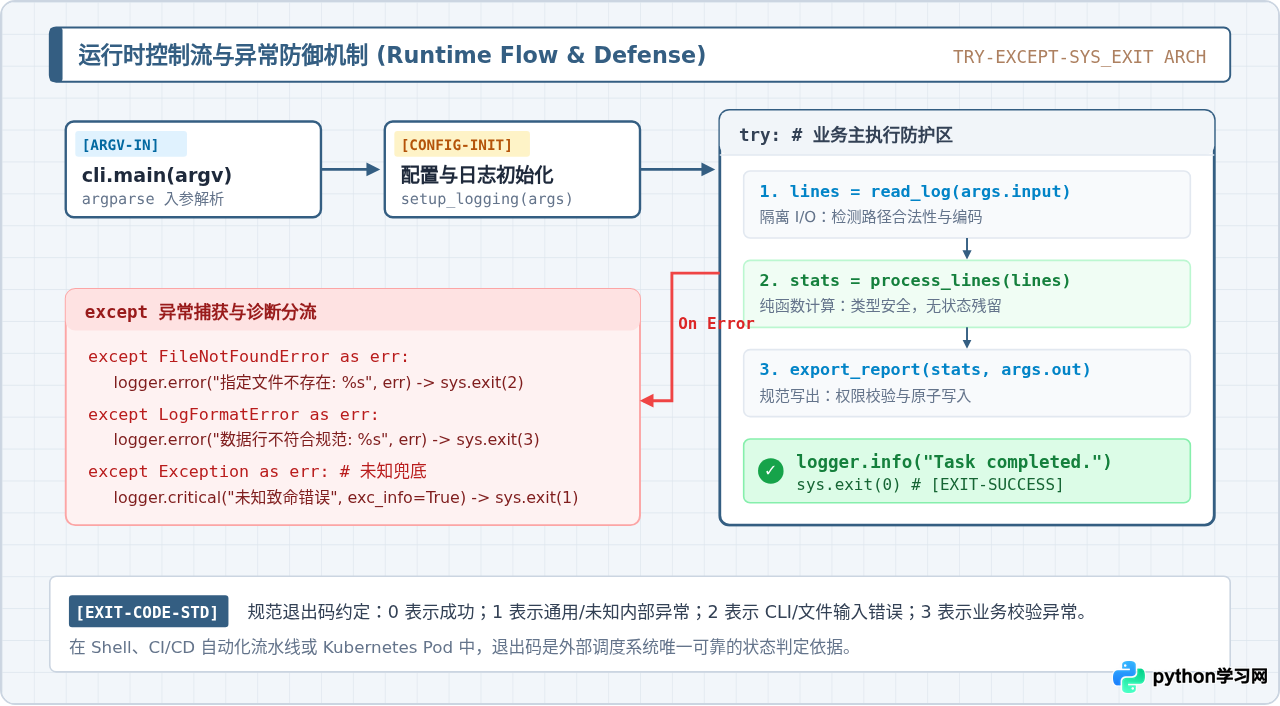
我们使用 Python 标准库 logging 替代全部 print,并建立分层异常拦截机制。
import logging

logger = logging.getLogger("log_reporter")

def setup_logging(verbose: bool = False) -> None:
    """配置日志格式与级别"""
    level = logging.DEBUG if verbose else logging.INFO
    formatter = logging.Formatter(
        fmt="%(asctime)s [%(levelname)s] %(name)s: %(message)s",
        datefmt="%Y-%m-%d %H:%M:%S"
    )
    handler = logging.StreamHandler(sys.stderr)
    handler.setFormatter(formatter)
    logger.setLevel(level)
    logger.addHandler(handler)

def read_log_records(file_path: Path) -> List[LogEntry]:
    """读取并安全解析文件,处理编码与格式异常"""
    entries: List[LogEntry] = []
    try:
        with file_path.open("r", encoding="utf-8", errors="replace") as f:
            for line_no, line in enumerate(f, start=1):
                entry = parse_log_line(line)
                if entry is not None:
                    entries.append(entry)
                else:
                    logger.debug("第 %d 行格式不匹配,已跳过", line_no)
    except PermissionError:
        logger.error("权限不足,无法读取文件: %s", file_path)
        raise
    except Exception as exc:
        logger.critical("读取文件遭遇未知故障: %s", exc, exc_info=True)
        raise
    return entries

def write_summary_report(
    output_path: Path, error_count: int, top_ips: List[Tuple[str, int]]
) -> None:
    """写出结果报表,确保目录存在"""
    output_path.parent.mkdir(parents=True, exist_ok=True)
    with output_path.open("w", encoding="utf-8") as f:
        f.write(f"5xx 服务器错误总数: {error_count}\n")
        f.write("异常请求高频 IP 统计:\n")
        for ip, cnt in top_ips:
            f.write(f"  {ip}: {cnt} 次\n")
    logger.info("报表已成功写出至: %s", output_path)
try: ... except: pass。这种做法会吞噬 KeyboardInterrupt(用户按下 Ctrl+C 无法退出)以及语法错误。只捕获明确可预料的异常类型(如 FileNotFoundError、PermissionError),其余未知异常记录到日志中并如实抛出。
五、第四步:规范的项目结构与依赖管理
当脚本的代码行数超过 200 行,或者包含多个功能模块时,将所有代码塞在单个文件里会使维护变得困难。现代 Python 社区推荐采用 src 布局(src-layout),有效防止开发期引入隐式导入污染。
log_reporter_project/
├── .gitignore
├── README.md
├── pyproject.toml              # 现代化构建与依赖声明 (PEP 621)
├── src/
│   └── log_reporter/
│       ├── __init__.py         # 包导出声明
│       ├── __main__.py         # 允许通过 python -m log_reporter 运行
│       ├── cli.py              # 命令行解析与主生命周期
│       ├── core.py             # 纯数据结构与指标计算
│       └── io.py               # 磁盘读写与日志格式化
└── tests/
    ├── __init__.py
    ├── test_core.py            # 纯逻辑单元测试
    └── test_cli.py             # 命令行端到端测试
1. 现代化项目元数据:pyproject.toml
使用标准的 pyproject.toml 声明项目信息,使程序具备 pip install 安装为全局系统命令的能力:
[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"

[project]
name = "log-reporter"
version = "0.1.0"
description = "Nginx 访问日志分析与异常报表工具"
readme = "README.md"
requires-python = ">=3.9"
authors = [
    { name = "Engineering Team", email = "dev@example.com" }
]
dependencies = []

[project.optional-dependencies]
dev = [
    "pytest>=7.0.0",
    "ruff>=0.1.0",
    "mypy>=1.0.0",
]

[project.scripts]
log-reporter = "log_reporter.cli:main_entry"
2. 编写首批自动化测试(tests/test_core.py)
借助解耦后的纯函数,使用 pytest 可以轻松覆盖各种边界场景:
import pytest
from log_reporter.core import LogEntry, parse_log_line, calculate_error_metrics

def test_parse_valid_log_line():
    sample = '192.168.1.10 - - [30/Oct/2026:12:00:00 +0800] "GET /api HTTP/1.1" 502 120'
    entry = parse_log_line(sample)
    assert entry is not None
    assert entry.ip == "192.168.1.10"
    assert entry.status_code == 502

def test_parse_corrupted_line():
    assert parse_log_line("短无效数据") is None
    assert parse_log_line("") is None

def test_calculate_error_metrics():
    entries = [
        LogEntry("10.0.0.1", 200),
        LogEntry("10.0.0.2", 500),
        LogEntry("10.0.0.2", 503),
        LogEntry("10.0.0.3", 504),
    ]
    err_cnt, top_ips = calculate_error_metrics(entries, top_n=1)
    assert err_cnt == 3
    assert len(top_ips) == 1
    assert top_ips[0] == ("10.0.0.2", 2)
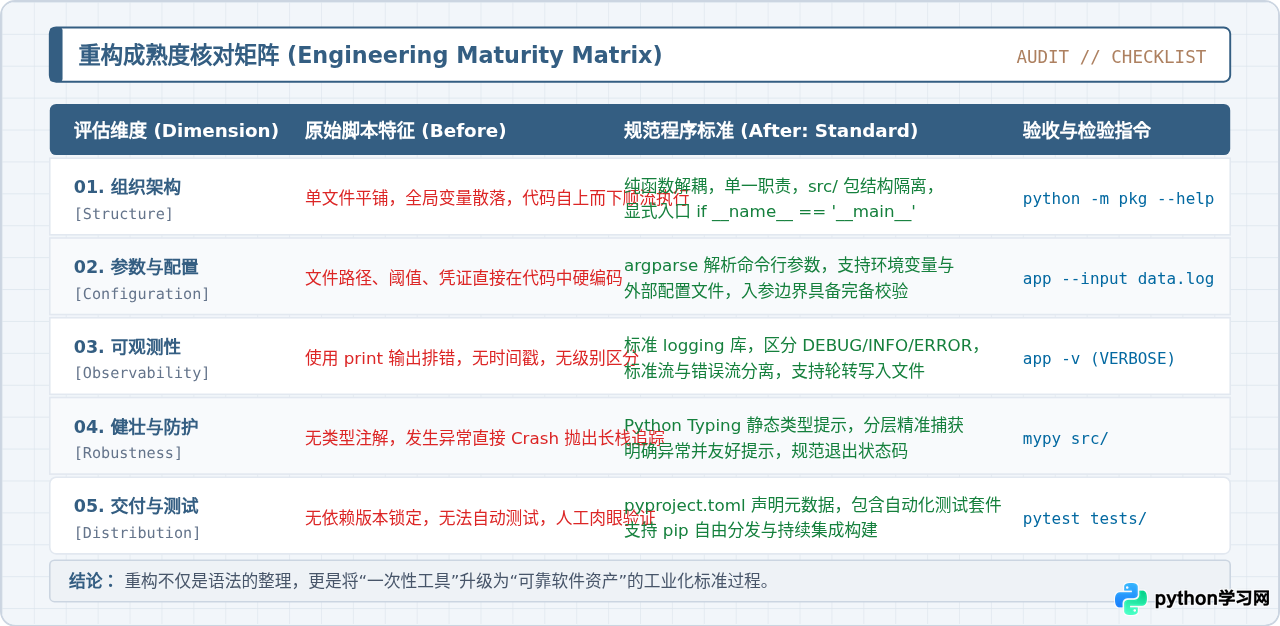
六、第五步:代码质检与重构自检矩阵
完成重构后,我们需要对程序进行工程质量检验。推荐使用现代化质检工具链:
- 代码检查与格式化(Ruff):执行
ruff check .与ruff format .,自动发现未使用的变量、未闭合的语句和格式违规。 - 静态类型检查(Mypy):执行
mypy src/,在无需运行代码的情况下捕捉可能的空指针与类型不匹配隐患。 - 测试验证(Pytest):执行
pytest -v,确认全量测试用例通过。
七、总结
将简单的 Python 脚本重构为规范程序,本质上不是追求代码的华丽,而是**为代码注入确定性与长久的可维护性**。整个重构过程遵循清晰的技术节奏:
- 提取纯函数:消除全局变量,分离计算逻辑与 I/O 副作用,使逻辑可单独测试。
- 规范入参与配置:通过
argparse与Path取代写死的路径,严格遵循if __name__ == '__main__':守卫与状态码规范。 - 健全观测与防御:用
logging替代裸print,精准捕获特定异常,杜绝直接崩溃。 - 建立工程标准:采用
src/目录布局,通过pyproject.toml固化依赖与入口,编写pytest单元测试提供质量守护。
按此标准重构后的程序,无论是由他人二次开发、集成到 CI/CD 自动化流水线,还是打包部署至容器生产环境,都具备稳定、透明、高可靠的工程基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









