

怎么为Python库开发CLI框架:argparse与Click实战指南
深入讲解如何为Python库构建专业命令行界面(CLI)。从核心架构、argparse与Click的实战对比、子命令设计到打包分发entry_points配置,手把手带你完成规范的CLI框架开发。
为Python库提供命令行界面(CLI),能够让用户在终端中直接调用核心能力,无需编写脚本即可完成数据转换、任务触发或环境诊断。开发高质量CLI的核心路径是:将底层业务逻辑与命令行解析层彻底解耦,选择适合的参数解析框架(内置的argparse或声明式的Click),并配置打包入口将Python函数暴露为系统可执行命令。本文将针对这套标准流程进行系统拆解,帮助你在实际项目中落地规范易用的CLI架构。
一、Python库CLI的整体分层架构
很多开发者在为已有Python库增加命令行工具时,容易把参数解析逻辑直接掺杂在核心业务模块中。这种紧耦合会导致代码难以编写单元测试,也限制了底层功能被其他Python代码作为纯SDK导入的能力。规范的做法是采用清晰的分层架构:底层是独立的Core API,中间是CLI命令控制器,最外层是分发入口。
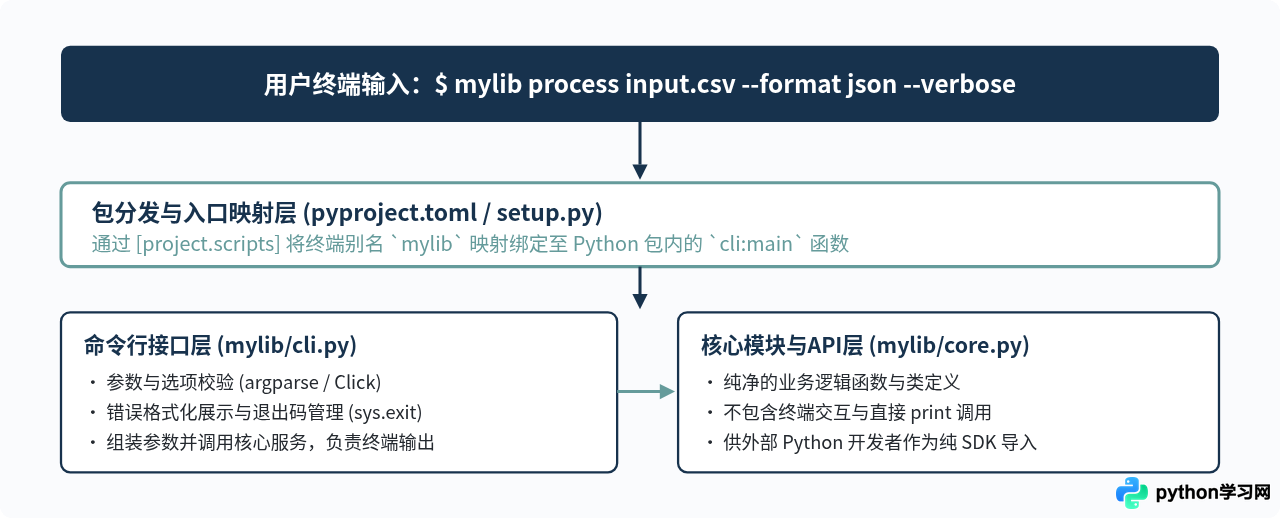
假设我们正在开发一个名为 mylib 的库,其主要功能是读取文件内容并执行转换。推荐的项目目录结构如下:
mylib_project/
├── pyproject.toml         # 项目配置与CLI入口声明
├── src/
│   └── mylib/
│       ├── __init__.py    # 暴露核心公开 API
│       ├── core.py        # 底层业务逻辑(无终端依赖)
│       └── cli.py         # 命令行界面交互与参数解析
在 mylib/core.py 中,核心函数不应该直接调用 print() 或读取 sys.argv,而应接收标准参数并返回结果或抛出异常:
# mylib/core.py
from pathlib import Path

def process_file(filepath: Path, fmt: str = "json") -> dict:
    """纯逻辑业务函数,可被其他Python代码直接复用"""
    if not filepath.exists():
        raise FileNotFoundError(f"文件未找到: {filepath}")

    # 模拟数据处理逻辑
    content = filepath.read_text(encoding="utf-8")
    return {
        "source": str(filepath),
        "target_format": fmt,
        "line_count": len(content.splitlines()),
        "status": "success"
    }
二、选型对比:argparse 与 Click
Python 生态中构建 CLI 的方案众多,其中最为通用且工业级验证的两种选择是标准库 argparse 和第三方知名库 Click。理解两者的设计理念是技术选型的关键。
| 对比维度 | 标准库 argparse | 第三方库 Click |
|---|---|---|
| 依赖情况 | 内置于 Python 标准库,无外部依赖 | 需安装外部包(pip install click) |
| 代码风格 | 面向对象与命令式 API,逐步添加参数与子解析器 | 函数装饰器驱动(声明式),优雅绑定参数与处理函数 |
| 子命令支持 | 支持(通过 subparsers),但嵌套和上下文传递较繁琐 | 天生支持组与子命令(Group),支持 Context 共享状态 |
| 类型转换与验证 | 基本支持 type=int 等原生类型,复杂校验需自定义函数 |
内置丰富类型(如 click.Path、click.Choice 等),校验更强大 |
| 用户体验 | 标准终端帮助输出,需手动处理部分色彩与交互 | 原生支持提示、确认、进度条、ANSI 颜色等丰富交互 |
选型建议:
如果你的库属于轻量级工具、标准库扩展或对零外部依赖(Zero-Dependency)有严苛要求,推荐使用 argparse;如果你的库功能丰富、涉及复杂的层级子命令(如 Git 风格的 tool subcmd --opt),或者需要进度条、文件路径自动校验等交互特性,Click 能显著提升开发效率与代码可读性。
三、基于 argparse 实现 CLI 框架
argparse 的基本开发流程是:实例化 ArgumentParser、通过 add_argument() 配置选项与参数、调用 parse_args() 解析,并将解析得到的数据传递给业务函数。
以下是支持子命令(如 process 处理文件、info 查看库信息)的完整 argparse 实战实现:
# mylib/cli.py (基于 argparse 的实现)
import argparse
import json
import sys
from pathlib import Path
from mylib.core import process_file

def build_parser() -> argparse.ArgumentParser:
    """构建参数解析器并配置参数结构"""
    parser = argparse.ArgumentParser(
        prog="mylib",
        description="mylib 命令行工具:用于处理文件转换和环境诊断"
    )
    parser.add_argument("-v", "--verbose", action="store_true", help="输出详细调试信息")

    # 注册子命令容器
    subparsers = parser.add_subparsers(dest="command", required=True, help="可调用的子命令")

    # 子命令: process
    proc_parser = subparsers.add_parser("process", help="转换并处理指定文件")
    proc_parser.add_argument("filepath", type=Path, help="待处理的目标文件路径")
    proc_parser.add_argument(
        "-f", "--format",
        choices=["json", "yaml", "xml"],
        default="json",
        help="转换的目标数据格式(默认为 json)"
    )

    # 子命令: info
    info_parser = subparsers.add_parser("info", help="输出当前库的运行环境与版本")
    info_parser.add_argument("--json", action="store_true", dest="as_json", help="以JSON格式输出")

    return parser

def main(argv=None) -> int:
    """CLI执行主入口,返回数字状态码"""
    parser = build_parser()
    args = parser.parse_args(argv)

    if args.verbose:
        print("[DEBUG] 启用详细输出模式")

    try:
        if args.command == "process":
            result = process_file(args.filepath, fmt=args.format)
            print(f"处理完成: {result}")
            return 0

        elif args.command == "info":
            meta = {"library": "mylib", "version": "1.0.0", "python": sys.version.split()[0]}
            if args.as_json:
                print(json.dumps(meta, indent=2))
            else:
                print(f"mylib v{meta['version']} (Python {meta['python']})")
            return 0

    except Exception as err:
        sys.stderr.write(f"执行出错: {err}\n")
        return 1

    return 0

if __name__ == "__main__":
    sys.exit(main())
运行结果示例:
# 查看自动生成的帮助信息
$ python -m mylib.cli --help
usage: mylib [-h] [-v] {process,info} ...

mylib 命令行工具:用于处理文件转换和环境诊断

positional arguments:
  {process,info}  可调用的子命令
    process       转换并处理指定文件
    info          输出当前库的运行环境与版本

options:
  -h, --help      show this help message and exit
  -v, --verbose   输出详细调试信息

# 执行子命令(示例输出)
$ python -m mylib.cli process data.txt --format yaml
处理完成: {'source': 'data.txt', 'target_format': 'yaml', 'line_count': 12, 'status': 'success'}
四、基于 Click 实现高质量 CLI 框架
与 argparse 必须手动维护命令分发与异常拦截不同,Click 采用了装饰器模式。每个子命令对应一个处理函数,参数声明紧随其上,整体语义更加直观。
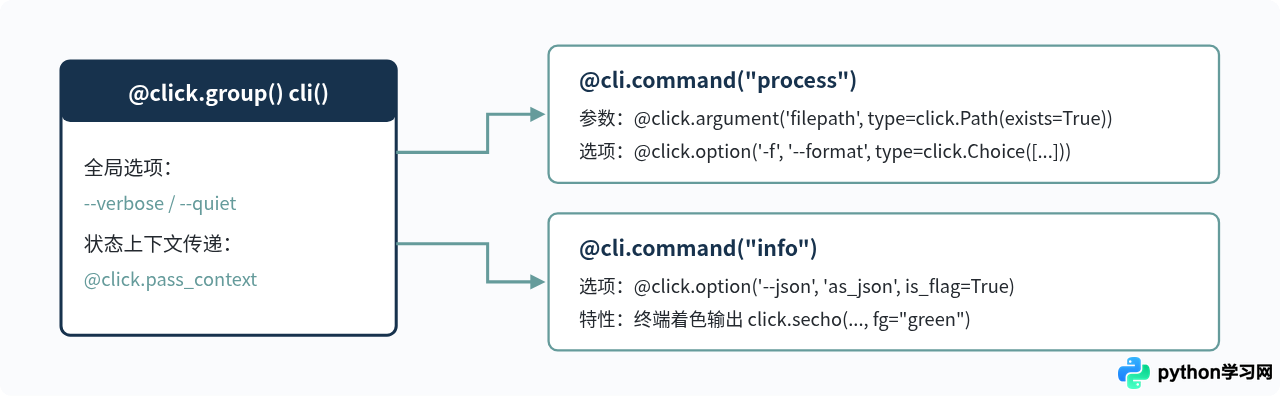
以下是使用 Click 重构后的完整 CLI 实现代码:
# mylib/cli_click.py (基于 Click 的实现)
import json
import sys
from pathlib import Path
import click
from mylib.core import process_file

@click.group()
@click.option("-v", "--verbose", is_flag=True, help="启用详细调试日志")
@click.pass_context
def main(ctx: click.Context, verbose: bool):
    """mylib 命令行工具:基于 Click 实现的文件处理套件"""
    # 将全局状态存储在 context 对象的 obj 中,供所有子命令继承使用
    ctx.ensure_object(dict)
    ctx.obj["VERBOSE"] = verbose
    if verbose:
        click.echo("[DEBUG] 全局调试日志已激活", err=True)

@main.command("process")
@click.argument("filepath", type=click.Path(exists=True, dir_okay=False, path_type=Path))
@click.option(
    "-f", "--format", "fmt",
    type=click.Choice(["json", "yaml", "xml"], case_sensitive=False),
    default="json",
    show_default=True,
    help="转换生成的目标格式"
)
@click.pass_context
def cmd_process(ctx: click.Context, filepath: Path, fmt: str):
    """处理并转换指定的数据文件"""
    try:
        result = process_file(filepath, fmt=fmt)
        click.secho(f"✓ 处理成功: {result}", fg="green")
    except Exception as err:
        click.secho(f"✗ 错误: {err}", fg="red", err=True)
        sys.exit(1)

@main.command("info")
@click.option("--json", "as_json", is_flag=True, help="以JSON格式输出")
def cmd_info(as_json: bool):
    """输出系统与库环境信息"""
    meta = {"library": "mylib", "version": "1.0.0", "engine": "Click"}
    if as_json:
        click.echo(json.dumps(meta, indent=2))
    else:
        click.echo(f"mylib v{meta['version']} (Engine: {meta['engine']})")

if __name__ == "__main__":
    main()
Click 自带了参数的合法性预检功能。例如通过 type=click.Path(exists=True),当用户传入不存在的文件时,Click 会在进入你的核心逻辑前自动拦截并给出友好的错误提示,无需在代码中手写重复的判断逻辑。
五、配置打包入口:将Python函数暴露为系统命令
完成 CLI 代码编写后,如何让用户在安装你的 Python 库之后,无需输入 python -m mylib.cli,而是像使用 git 或 npm 一样直接在终端键入 mylib 即可运行?答案是使用标准打包规范中的 entry points(可执行入口)。
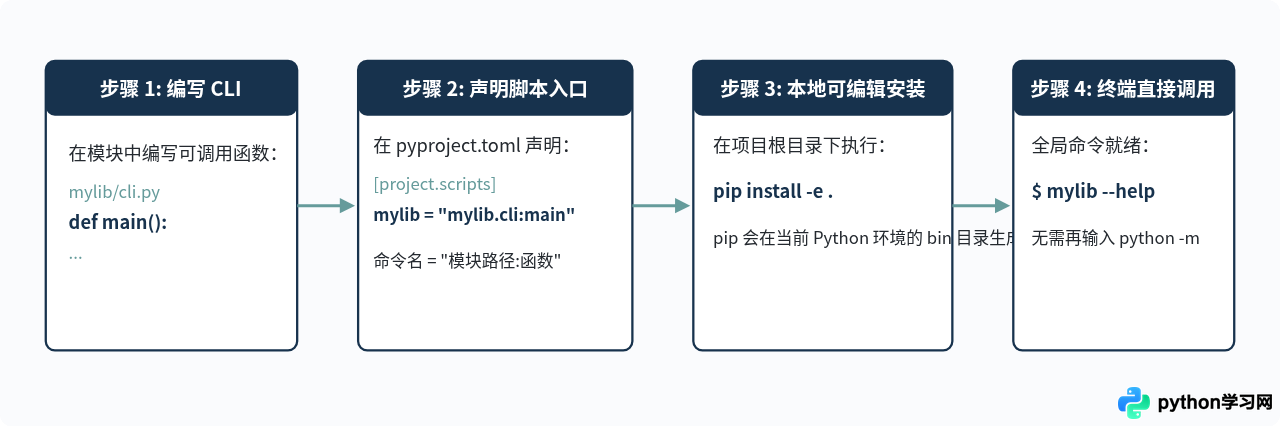
现代规范:在 pyproject.toml 中配置
现代 Python 项目推荐使用 pyproject.toml(基于 PEP 621 规范)。在配置文件中添加 [project.scripts] 节点即可:
# pyproject.toml
[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"

[project]
name = "mylib"
version = "1.0.0"
description = "A professional Python library with CLI support"
readme = "README.md"
requires-python = ">=3.8"
dependencies = [
    "click>=8.0.0",  # 如果采用 Click 框架
]

[project.scripts]
# 格式:命令行指令名称 = "包名.模块名:入口函数名"
mylib = "mylib.cli:main"
传统规范:在 setup.py 中配置
如果维护的是较早期的遗留项目,可以在 setup.py 中使用 entry_points 字段声明:
# setup.py
from setuptools import setup, find_packages

setup(
    name="mylib",
    version="1.0.0",
    packages=find_packages(where="src"),
    package_dir={"": "src"},
    install_requires=[
        "click>=8.0.0",
    ],
    entry_points={
        "console_scripts": [
            "mylib=mylib.cli:main",
        ],
    },
)
配置完成后,在项目根目录运行安装命令进行本地测试:
# 以可编辑(开发)模式安装当前包
$ pip install -e .

# 验证命令是否已经成功注册至系统 PATH
$ which mylib
/Users/developer/.venv/bin/mylib

# 运行验证
$ mylib info
mylib v1.0.0 (Engine: Click)
六、健壮 CLI 框架的设计要点与常见注意事项
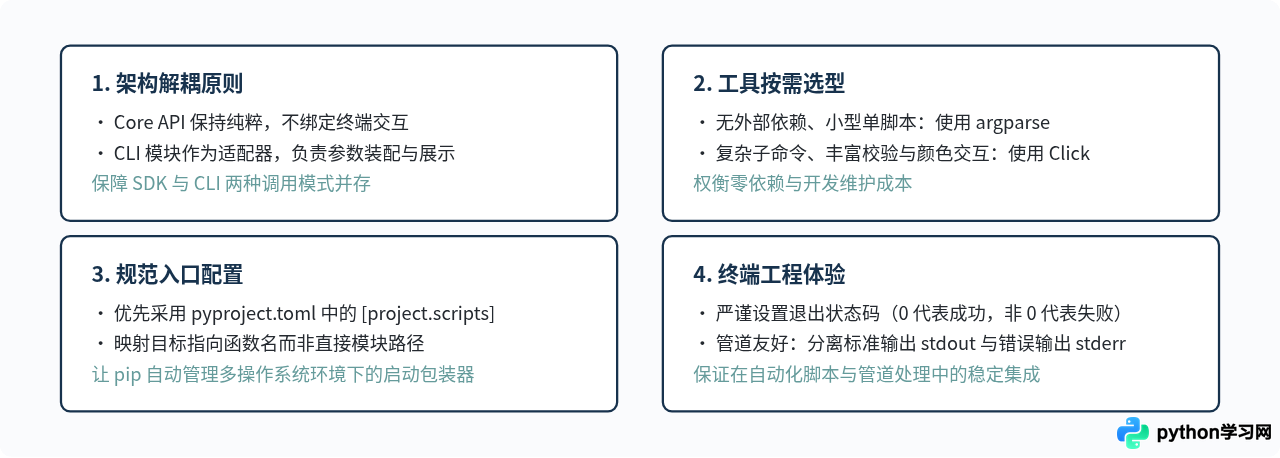
在设计和分发 CLI 框架时,除了让命令能够运行起来,还需要遵循良好的命令行交互设计规范:
- 标准退出码(Exit Codes): 程序正常完成退出时必须返回
0;遇到业务校验失败、文件缺失或未捕获异常退出时返回非0(通常为1)。这对于将 CLI 嵌入自动化 Shell 脚本或 CI/CD 流水线至关重要。 - 区分标准输出与错误输出: 常规数据、处理结果应当写入
sys.stdout;调试日志、警告和报错信息应当输出到sys.stderr。避免将日志与业务输出混在一起导致下游管道符解析失败(例如mylib info --json | jq .)。 - 参数解析层避免吞掉异常: 在 CLI 顶层应捕获已知业务异常并友好打印错误文案,但在开启
--verbose时,应保留打印完整的 Python Traceback 堆栈,方便排查故障。
七、总结
开发一个健壮的 Python 库 CLI 框架,关键并不在于代码量的多寡,而在于合理的职责划分。通过将业务逻辑保持在独立的模块中,利用 argparse 或 Click 处理入参和交互,最后借助 pyproject.toml 的 project.scripts 机制完成打包,就能让你的 Python 库在兼顾程序调用的同时,为终端用户带来丝滑且规范的使用体验。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









