

Cursor写python比VSCode快吗真实体验
深入对比Cursor与VS Code在Python实际开发中的效率表现,分析内核架构、跨文件上下文索引、多文件修改与调试排错的真实体验与边界。
一、同源内核下的机制差异:为什么感知速度不同
很多初次接触 Cursor 的 Python 开发者会误以为它是一款全新编写的独立 IDE。实际上,Cursor 是直接基于 VS Code 的开源核心(Code - OSS)进行二次开发的。这意味着在 Python 基础支撑层面,两者使用的是同一套基础设施:你的 .venv 虚拟环境选择、Conda 解释器管理、debugpy 调试适配器、以及基于 Pyright 或 Ruff 的代码静态分析,在 Cursor 中与在 VS Code 里几乎没有任何行为区别。
真正的速度分水岭发生在上层交互设计与上下文喂给大模型的方式上。在标准 VS Code 中配置 GitHub Copilot 时,Copilot 本质上是一个遵循 VS Code Extension API 规范的插件。插件运行在独立的 Extension Host 隔离进程中,对当前工程文件的读取、光标跳转和编辑器区域的修改都受到 API 暴露能力的限制。当需要跨文件感知上下文时,Copilot 往往只能以当前打开的激活标签页为主要参照物,遇到大型项目时常常“看前顾后遗漏核心定义”。
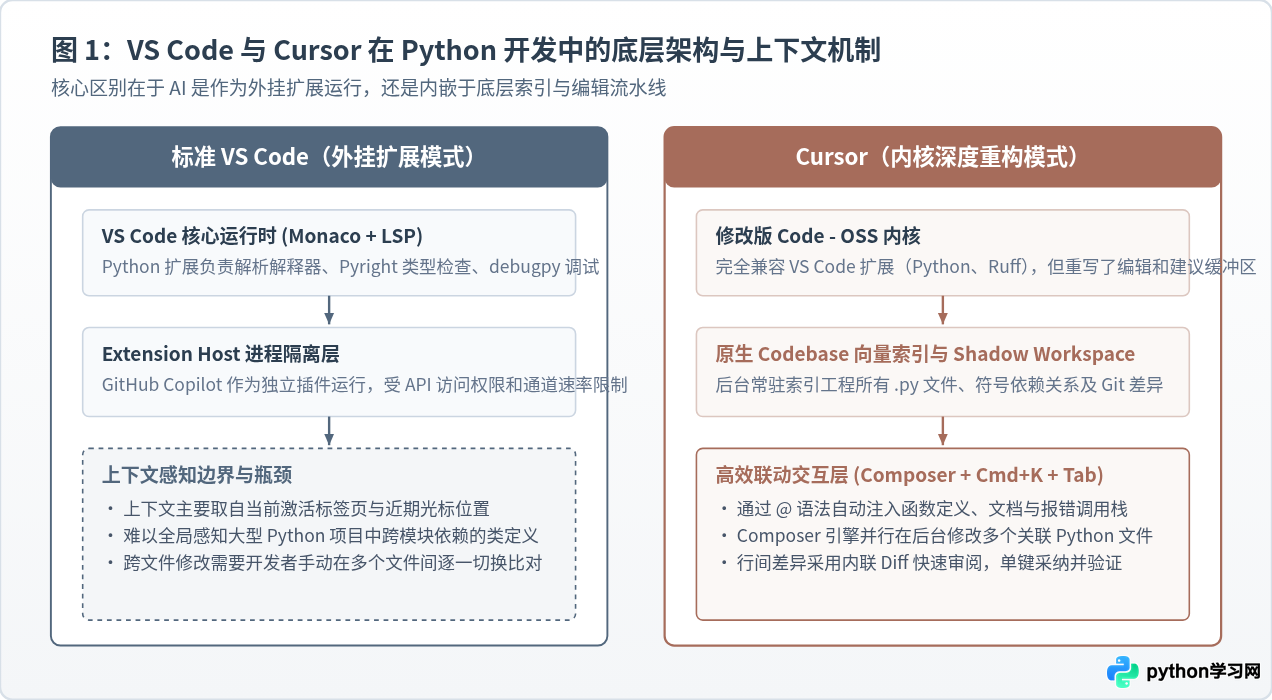
相比之下,Cursor 重写了编辑器的补全与建议调度管线。它在本地维护了一套基于向量嵌入与符号引用的 Codebase Indexing 机制,能够自动把整个 Python 工作区中的数据结构、类方法签名和配置常量建立索引。当你触发生成或补全时,Cursor 能直接通过 @codebase 语法把跨文件的调用链自动拼装为 Prompt 发送给底层大模型。此外,其内建的 Composer 能够在一个指令窗口内直接并行修改多个 .py 文件,省去了开发者反复来回切标签页、逐个复制粘贴的琐碎步骤。
二、Python 日常开发全流程的真实速度对比
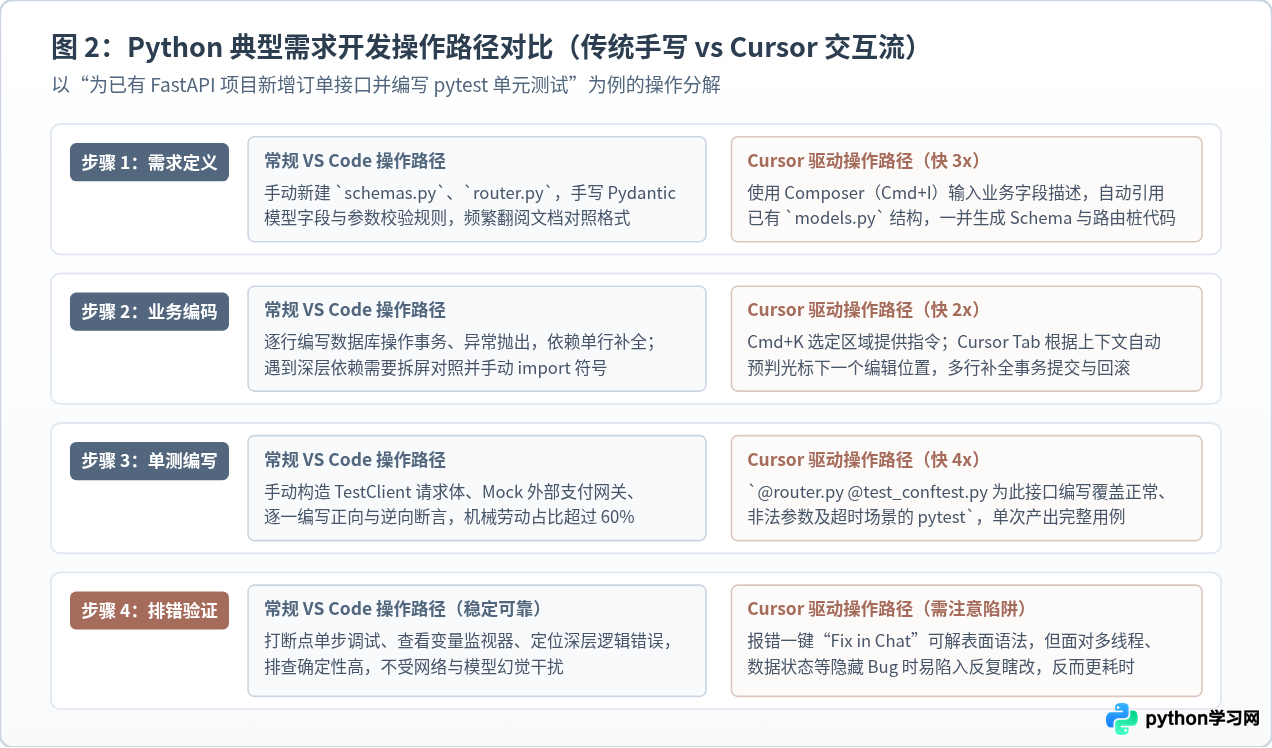
要客观评估两者究竟谁更快,必须将 Python 开发拆解到具体的编写阶段中。在实际工作中,一个典型的 Python 需求开发通常包含“骨架搭建”、“跨文件联动”、“测试编写”与“报错排查”四个核心环节。
1. 搭建接口脚手架与数据模型:Cursor 优势显著
以编写一个基于 FastAPI 的订单处理模块为例。在 VS Code 中,开发者通常需要手动新建 schemas.py、routers/order.py,然后一行行敲入 Pydantic 字段类型约束、枚举定义以及请求体验证。即使熟练使用代码片段(Snippets),也需要频繁在字段名称、类型和文档字符串之间切换移动光标。
而在 Cursor 中,打开 Composer(快捷键 Cmd + I 或 Ctrl + I),直接输入:
# Composer 提示词示例:
参考现有的 models/order.py 中的 SQLAlchemy 实体定义,
在 schemas/order.py 中创建对应的 OrderCreate、OrderResponse Pydantic 校验模型,
并在 routers/order.py 中添加创建订单与查询详情的异步接口骨架。
Cursor 能够在几秒钟内同时检索已有数据库模型定义,并自动在多个目标文件中生成类型对齐的骨架代码。开发者只需通过键盘方向键或内联 Diff 快速核对字段是否遗漏,点击 Accept All 即可完成。在这一阶段,编写耗时通常能缩短 60% 到 70%。
2. 行间编码与逻辑衔接:Cursor Tab 的预判能力
在编写具体业务逻辑时,很多 Python 代码属于模式化的逻辑衔接。例如:在服务层函数中接收参数、进行非空校验、调用数据库查询、处理 None 情况抛出 HTTPException、最后组装字典或模型返回。在标准 VS Code 中使用单行补全工具时,AI 通常只能顺着当前光标的位置往后推演半行到一行,且开发者需要不断按 Tab 键确认。
Cursor 的 Cursor Tab(即深度集成的 Copilot++ 模型)具备推测性多行跳转能力。当你在一个文件顶部新增了一个 status: str 字段后,光标移到下方的构造函数或序列化函数时,Cursor 会直接以灰字高亮预判你下一步要填写的逻辑,甚至能跨越数行直接把对应入参的映射逻辑补全,开发者只需连按两下 Tab 即可跳过大量重复敲击。
3. 单元测试与 Mock 数据构造:压倒性的省时场景
编写单元测试往往是 Python 项目中最消耗时间但代码重复度极高的工作。构造 pytest fixture、模拟外部 API 请求、填充各种边界参数的字典数据,纯手写非常枯燥。
在 Cursor 中,你可以针对刚才生成的路由文件直接发起指令:
# 在测试目录触发 Cmd + K 或 Composer:
@routers/order.py @conftest.py
为 order 路由编写完整的 pytest 测试用例。
覆盖以下场景:
1. 正常下单成功并返回 201 与完整数据;
2. 缺失必填字段返回 422 校验失败;
3. 商品库存不足时抛出业务异常 400;
4. 模拟外部支付网关超时并验证重试逻辑。
由于 Cursor 能够读取 conftest.py 中的共享 client 和测试数据库 session,它生成的测试用例能够直接使用项目已有的 mock 结构,绝大部分用例可以直接跑通,省去了反复调整 fixture 导入路径的繁琐时间。
三、哪些场景下 Cursor 并不比 VS Code 快
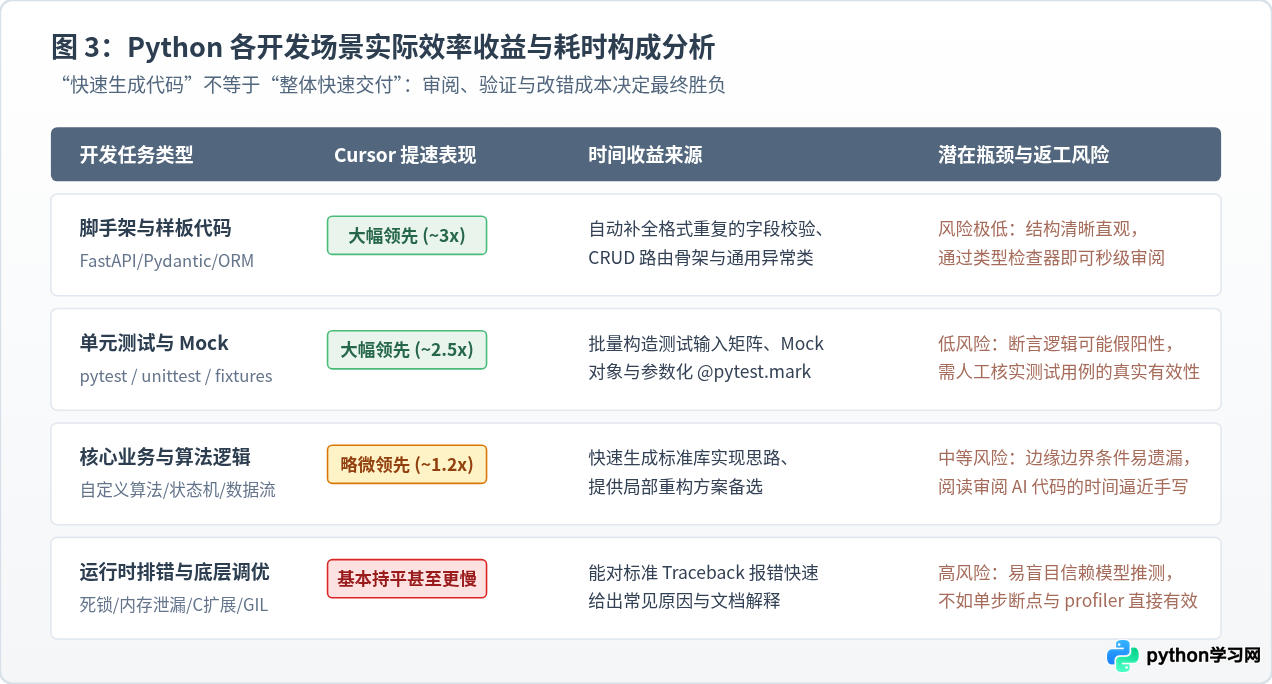
如果只看上面的样板生成场景,容易得出“Cursor 全面超越 VS Code”的片面印象。但在更深入的 Python 实战场景中,有两个关键瓶颈会严重抹平甚至反噬 Cursor 带来的效率收益。
1. 运行时复杂 Bug 诊断:盲信 AI 易陷入循环改错
当 Python 程序抛出一个非显式语法错误的深层异常(例如:SQLAlchemy 会话并发竞争、asyncio 事件循环死锁、或者跨模块依赖循环导入导致 ImportError: cannot import name ... from partially initialized module)时,点击 Cursor 报错面板中的 Fix in Chat 往往并不是最快的解决途径。
大语言模型倾向于给出“看起来合理”的局部修改,比如给某个局部变量套上全局锁,或者在函数内部重新写一次延迟导入。这种修改虽然能让当前报错消失,但往往破坏了原有的架构设计,并引发下游链条的二次报错。许多开发者在这个环节频繁让 AI 重新生成,来回折腾半小时,反而不如在原生 VS Code 中打一个标准断点(breakpoint() 或 F9),通过调试面板查看调用栈变量(Locals/Globals),两分钟内就能定位根本原因。
Run and Debug(Python Debugger)单步排查,远比直接贴 Traceback 问 AI 更快、更准确。
2. 版本特定 API 与专业领域库的幻觉陷阱
Python 生态演进极快,某些库在主版本升级时会弃用或调整大量方法签名。例如 Pandas 从 1.x 升级到 2.x,大量 append() 方法被废弃;LangChain 等处于高频迭代阶段的框架,几乎每个小版本的模块导出路径都会重组。
Cursor 的模型在生成这些代码时,经常会混淆新旧版本的调用方式,生成看似完备但运行时直接抛出 AttributeError 的废弃函数。开发者在审阅 AI 生成的代码时,必须保持高度警惕。如果把大量时间花在“阅读 AI 代码 - 运行报错 - 查官方文档 - 手动纠错”的闭环中,整体净交付速度反而明显落后于一开始就照着最新官方文档编写的标准手写流程。
四、关键细节与实操配置建议
如果你决定在日常 Python 任务中引入 Cursor,以下四项关键设置与习惯能够帮你避开效率陷阱,真正发挥其速度优势:
- 建立规范的
.cursorrules规则文件:在 Python 项目根目录下创建该文件,声明代码规范、环境要求与版本限制。例如明确写明“Python 3.11+”、“使用 Pydantic V2 语法,禁止使用已弃用的class Config”、“类型标注必须严格使用标准库typing”,这样能够直接消除 80% 因库版本更迭带来的幻觉。 - 巧用
.cursorignore排除无关目录:默认情况下,Cursor 会尝试索引工作区内的所有文件。如果项目中包含未加入排除列表的虚拟环境(.venv)、构建缓存(__pycache__)、静态数据包或海量日志文件,不仅会导致索引速度变慢,还会污染代码上下文的匹配精度。务必在.cursorignore中添加.venv/与*.csv等大文件目录。 - 保持小步生成与严密审阅:尽量避免让 Cursor 一次性生成数千行横跨数十个文件的巨型功能。最快的姿势是“人主导架构切分,AI 承包单文件或小模块落地”。每次生成控制在单个函数、一个模型类或一组单测范围内,利用行间 Diff 快速检查,确认无误再进入下一步。
- 保留并熟练使用 VS Code 原生快捷键:Cursor 完整继承了 VS Code 的键盘快捷键与扩展系统。熟练使用
Ctrl + `切换终端、F12查看定义跳转、Shift + Alt + F触发 Ruff 格式化,配合 Cursor 特有的Cmd + K和Cmd + I,才能达到行云流水的开发状态。
五、选型结论与总结
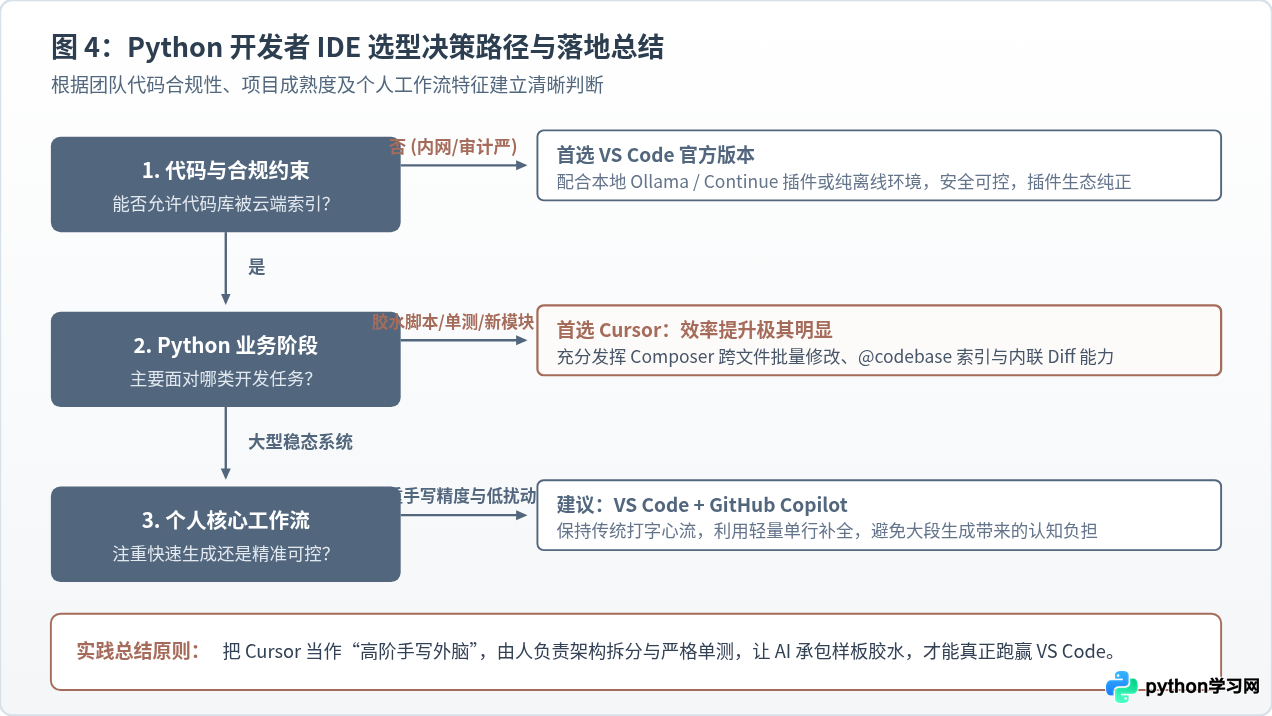
回到最初的核心问题:Cursor 写 Python 比 VS Code 快吗?
答案是:在代码产出与常规重构的“敲键盘阶段”,Cursor 依靠跨文件索引与多文件批处理能力,能够带来平均 2 倍以上的感知提速;但在项目架构设计、运行时底层调试与算法校验的“动脑阶段”,两者速度完全一致。
对于经常需要编写爬虫胶水脚本、FastAPI 接口服务、数据分析管道或快速验证原型的 Python 开发者而言,Cursor 能够为你卸下大量机械化输入负担,确实能显著提升整体交付速度。而对于处于严格合规内网、维护超大型闭源遗留系统、或者主要从事底层 C 扩展与性能 Profiling 的工程师,原生 VS Code 搭配轻量化本地工具依然是更加纯净且稳妥的选择。决定开发速度的从来不是工具生成的字符数量,而是开发者对业务逻辑的掌控力与验证效率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









