

大数据与人工智能领域:Python为何比Java更受欢迎?
深入剖析在现代大数据分析与人工智能研发场景中,Python凭借交互式探索效率、C/C++/CUDA底层高性能胶水架构以及垄断级算法生态超越Java的核心原因,并厘清两者在企业级生产系统中的真实分工与选型边界。
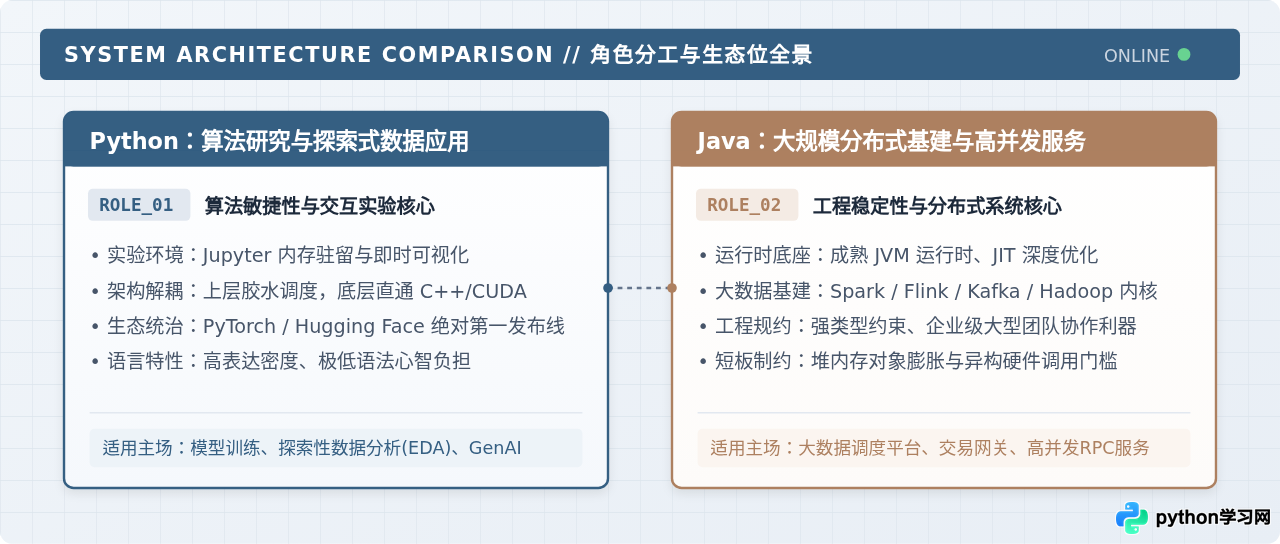
一、研发迭代吞吐率:交互式探索对传统编译周期的降维打击
在传统的企业级软件开发中,系统的核心诉求是“根据确定性需求,构建高可靠、易于长期维护的确定性服务”。强类型检查、严格的面向对象抽象和编译期校验为 Java 筑起了坚固的护城河。然而,大数据分析与人工智能研发面对的是一种截然相反的工作范式——探索性与不确定性。
数据科学家与算法工程师的日常工作并非直接编写上线服务,而是面对几百兆到数十吉字节未清洗的源数据,进行探索性数据分析(EDA):查看数据分布、排查缺失值、剔除离群样本、尝试几十种特征工程组合,并快速验证不同模型结构的效果。在这种场景下,反馈闭环的速度直接决定了研究探索的产出效率。
Python 配合 Jupyter Notebook 架构,天然支持内存状态常驻与单单元格执行。当加载一个 10GB 的数据集后,数据在内存中保持就绪状态,开发者可以毫秒级反复调整绘图与变换逻辑。相比之下,传统的 Java 强类型工程遵循典型的“修改源码 → 增量编译 → 打包 JAR → 启动 JVM 进程 → 重新加载数据”周期,哪怕借助 JShell 或测试脚本,也难以匹敌交互式笔记本的探索流畅度。
以下具体展示在“加载日志数据、清洗缺失值、按类别聚合计算指标并过滤低频项”的常见数据处理操作中,两者在表达密度上的直观差异:
import pandas as pd

# 读取并完成流水线过滤与聚合
df = pd.read_csv("user_events.csv")
result = (
    df.dropna(subset=["user_id", "revenue"])
      .query("status == 'CONFIRMED'")
      .groupby("category")
      .agg(total_rev=("revenue", "sum"), user_count=("user_id", "nunique"))
      .query("user_count >= 100")
      .sort_values(by="total_rev", ascending=False)
)
print(result.head())import java.io.FileReader;
import java.io.Reader;
import java.util.*;
import java.util.stream.Collectors;
import org.apache.commons.csv.CSVFormat;
import org.apache.commons.csv.CSVRecord;
public class DataAnalysis {
public static void main(String[] args) throws Exception {
Reader in = new FileReader("user_events.csv");
Iterable<CSVRecord> records = CSVFormat.DEFAULT.withFirstRecordAsHeader().parse(in);
// 强类型映射与内存流式分组过滤
Map<String, CategoryAgg> aggMap = new HashMap<>();
for (CSVRecord record : records) {
String userId = record.get("user_id");
String revStr = record.get("revenue");
String status = record.get("status");
String category = record.get("category");
if (userId == null || revStr == null || !status.equals("CONFIRMED")) continue;
double revenue = Double.parseDouble(revStr);
aggMap.computeIfAbsent(category, k -> new CategoryAgg())
.accumulate(userId, revenue);
}
List<Map.Entry<String, CategoryAgg>> result = aggMap.entrySet().stream()
.filter(e -> e.getValue().getUniqueUsers() >= 100)
.sorted((a, b) -> Double.compare(b.getValue().getTotalRev(), a.getValue().getTotalRev()))
.limit(5)
.collect(Collectors.toList());
}
}上述代码的差异不仅是代码行数的倍数关系,更是心智负担的本质差异。在 Python 中,数据结构是通用的 DataFrame 表格或 NumPy 张量,工程师只需关注数学变换与统计逻辑;而在 Java 中,开发者必须先为字段映射实体类、处理受检异常、手动管理集合聚合并编写规整的比较器。在算法探索阶段,这种额外的工程开销构成了巨大的摩擦力。
二、架构机制真相:Python 的“慢”为何没有拖累 AI 的“快”
计算机科学界公认:在原生纯 CPU 计算密集型基准测试中,Python 的执行速度通常比经过 JIT 深度编译优化的 Java 慢 10 到 50 倍。由此常产生一个困惑:既然 Python 如此缓慢,为什么极其消耗算力的人工智能与深度学习反而以 Python 为基石?
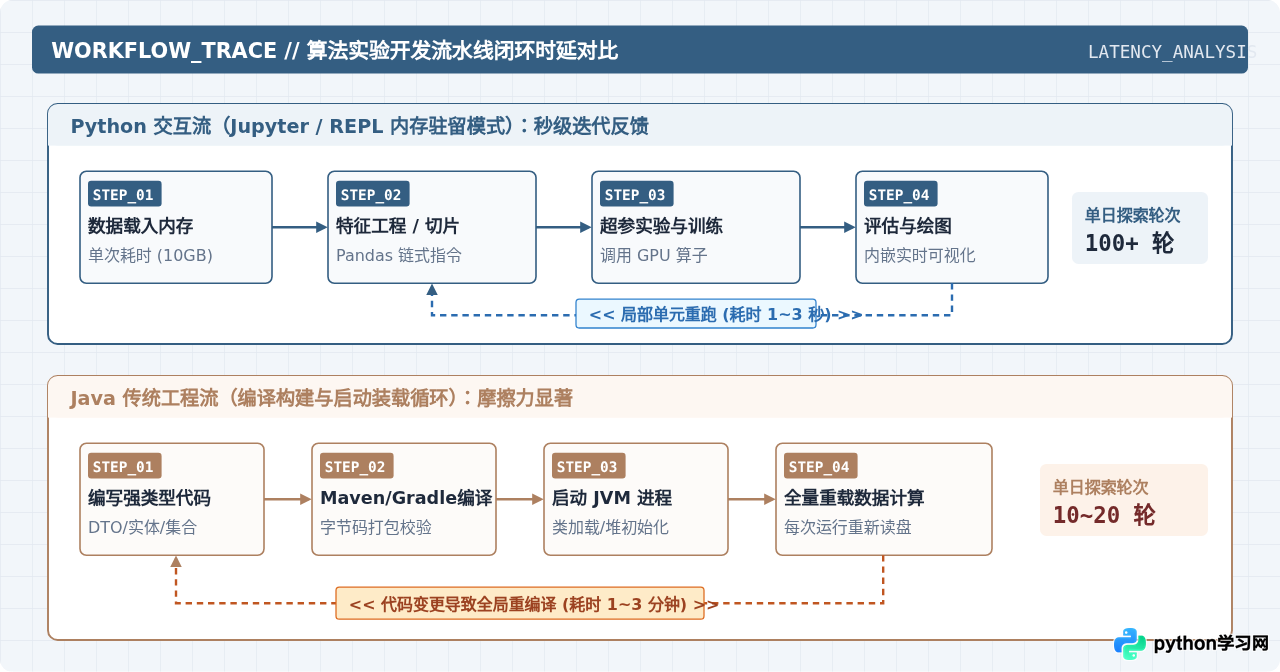
这一现象背后的核心技术机制是:现代 AI 框架将控制面与计算面进行了物理级解耦。
在深度学习模型中,99% 以上的时钟周期消耗在基础线性代数子程序(如 GEMM 通用矩阵乘法)、卷积算子、注意力机制(FlashAttention)以及显存搬运上。这些核心算子并非由 Python 执行,而是全部由 C++、Fortran(如 Intel MKL、OpenBLAS)以及 NVIDIA CUDA/cuDNN 编写并直接编译为底层机器指令。
Python 在这里承担的角色是高内聚、低开销的“配置与调度胶水”:
- 指令级图编排:Python 负责定义计算图拓扑、超参数配置和数据加载流水线。这个阶段执行一次仅需数十微秒。
- C-API 零拷贝调用:通过 PyBind11 或 CPython C-API,Python 传递的 Tensor 引用直接指向底层的堆外内存或 GPU 显存指针,不存在跨语言的数据序列化开销。
- 硬件原生并行:一旦底层 CUDA 核心被唤醒,运算完全运行在 GPU 上千个流多处理器(SM)中,此时 Python 解释器处于等待或异步分发状态,Python 解释器的单线程执行速度与全局解释器锁(GIL)根本不会成为计算瓶颈。
JVM 在海量异构张量计算中的工程制约
相比之下,Java 依托的 JVM 机制在设计初衷上是为长时间运行的企业级后端服务量身定做的,但在异构张量运算场景中遭遇了三大物理限制:
- 堆内存对象头开销与指针膨胀:Java 数组(如
double[][])实际上是“对象的数组”,包含多层引用与对象头(Mark Word、Klass Pointer),内存占用比连续的 C 结构体高出数倍,且数据在内存中是不连续分布的,破坏了 CPU/GPU 高速缓存行(Cache Line)的命中率。 - 垃圾收集器(GC)的停顿风险:当内存中加载几十吉字节的高维特征矩阵时,GC 线程遍历海量对象会产生灾难性的“Stop-The-World”停顿,严重干扰分布式协同计算的同步步调。
- 异构硬件与原生调用的历史包袱:Java 长期以来依赖 JNI(Java Native Interface)调用 C/C++ 动态链接库。JNI 存在明显的调用开销,无法安全、零拷贝地直接把 Java 堆内数据映射到 GPU 统一虚拟内存(UVM),增加了额外的内存拷贝开销。尽管近年的 Project Panama(FFM API)显著改善了这一现状,但生态早已在过去十年中被 Python-CUDA 阵营彻底占领。
三、网络效应与生态沉淀:从学术首发到工程落地的闭环
编程语言的兴衰往往遵循强烈的“网络效应”:越多人使用,沉淀的优秀库越多;库越多,新项目就越不可能选择其他语言。在人工智能与数据科学领域,Python 已经构筑了无可撼动的闭环生态链条。
这套生态闭环由底向上层层咬合,任何一环的替代都需要付出数以十年计的社区成本:
- 底层数值基础:以
NumPy为基石,统一了全语言的 N 维多维数组(ndarray)内存格式。后续所有库(Pandas、SciPy、Scikit-learn、PyTorch)全部遵守这一协议,实现了库之间的数据“零转换流通”。 - 表格与统计分析:
Pandas和新一代Polars为单机数据处理设立了行业事实语法标准;结合Matplotlib、Seaborn、Plotly,提供直接交互绘图支持。 - 经典机器学习:
Scikit-learn为整个行业确立了fit()/transform()/predict()的经典 API 范式,至今被各类模型框架沿用。 - 深度学习与大模型:
PyTorch凭借动态计算图(Eager Mode)与极佳的 Pythonic 体验,彻底击败早期过度工程化的框架,成为全球科研实验室与商业大模型(如 LLaMA、DeepSeek 等)的绝对主流研发平台。 - 现代 GenAI 基础设施:
Hugging Face Transformers、vLLM、LangChain、LlamaIndex均以 Python 为第一优先级构建。全世界绝大多数新论文开源代码、新模型权重脚本均首发且仅提供 Python 验证版本。
四、大数据领域的真实格局:引擎内核的 Java 与分析入口的 Python
在讨论这一问题时,很多人会提出反论:“在 Hadoop、Spark、Flink、Kafka 这些大数据基石中,Java 和 Scala 不是绝对主力吗?为什么说大数据领域也是 Python 更受欢迎?”
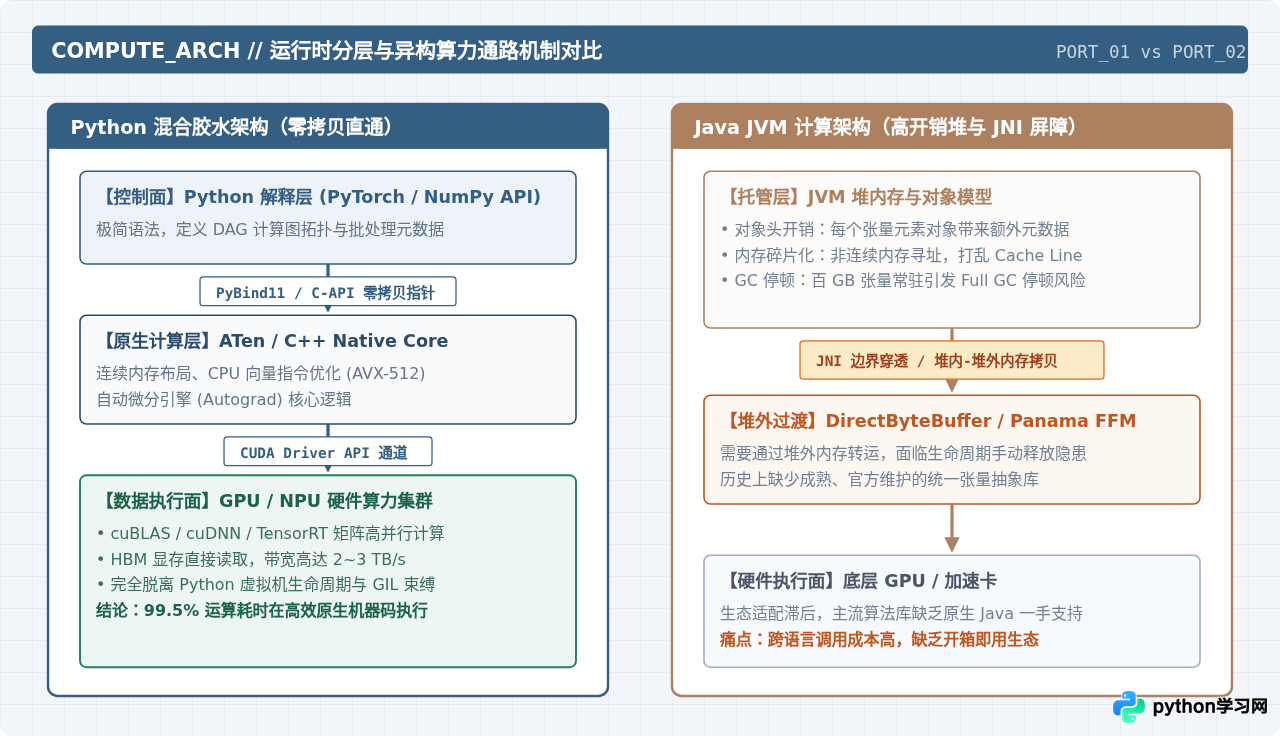
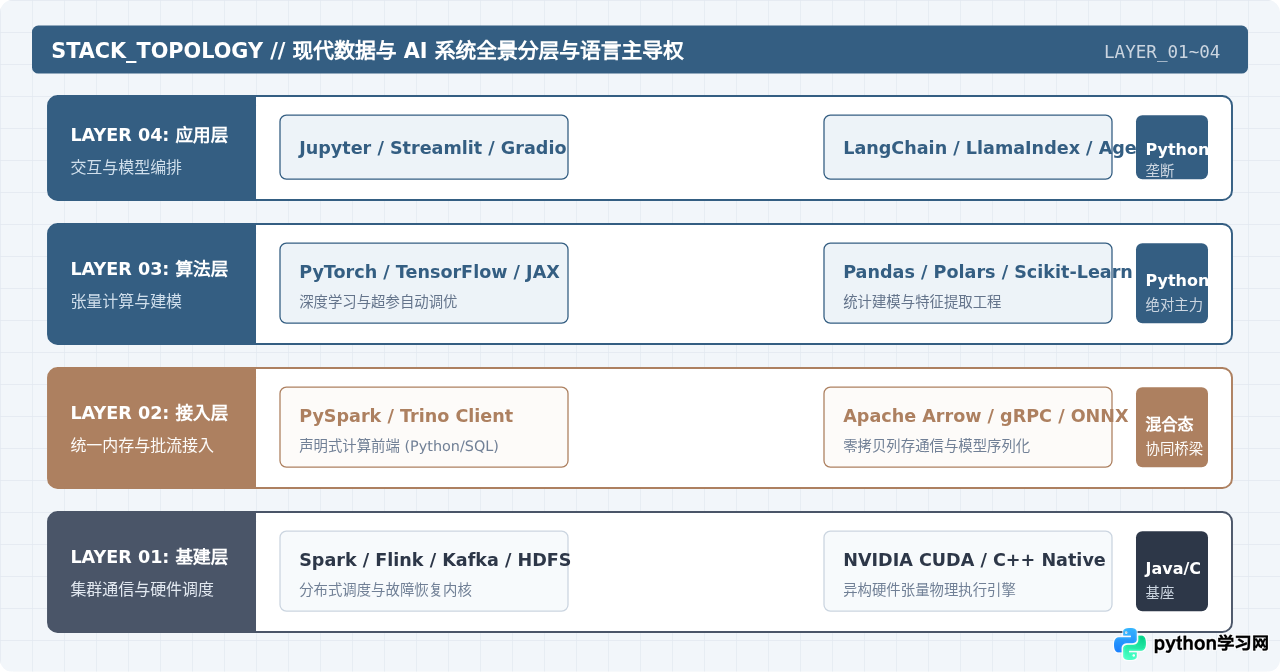
要澄清这个问题,必须清晰划分“分布式基建工程内核”与“业务数据计算与应用端”的职能分工:
| 分工维度 | 底层基础设施(Java / Scala / C++ 领地) | 业务分析与算法层(Python 领地) |
|---|---|---|
| 核心诉求 | 网络 I/O 吞吐、节点容错、分布式调度、内存分页管理 | 业务指标计算、探索性分析、特征衍生、模型预测 |
| 代表组件 | Spark Core, Flink Runtime, Kafka Broker, HDFS | PySpark, Pandas on Spark, DuckDB, Trino Python Client |
| 关键优势 | JVM 垃圾收集细调、无畏并发、极高系统长期稳定性 | 极低学习门槛、算法无缝集成、数倍提升数据交付速度 |
| 从业人群 | 大数据平台工程师、分布式系统研发专家 | 数据分析师、数据科学家、风控/推荐算法工程师 |
在大数据应用层,PySpark 的演进历程最具代表性。早期 PySpark 由于在 Python 进程与 JVM Executor 之间频繁通过 Socket 序列化传输数据(Pickle 协议),性能饱受诟病。但在引入 Apache Arrow 列式内存传输协议与 Spark Catalyst 逻辑优化器后,Python 编写的 DataFrame 操作被直接编译为优化后的分布式物理计划并在 JVM 集群中运行,Python 仅作为“声明式语言前端”。
因此,在大数据实际业务中,除了平台基础架构团队负责维护 Kafka、Flink 集群外,绝大多数业务线的数据分析与特征开发团队已经全面倒向 Python 和 SQL。Java 守住了底层的管网,而 Python 占领了流淌在管网中的水。
五、落地选型边界与工业级混合协同架构
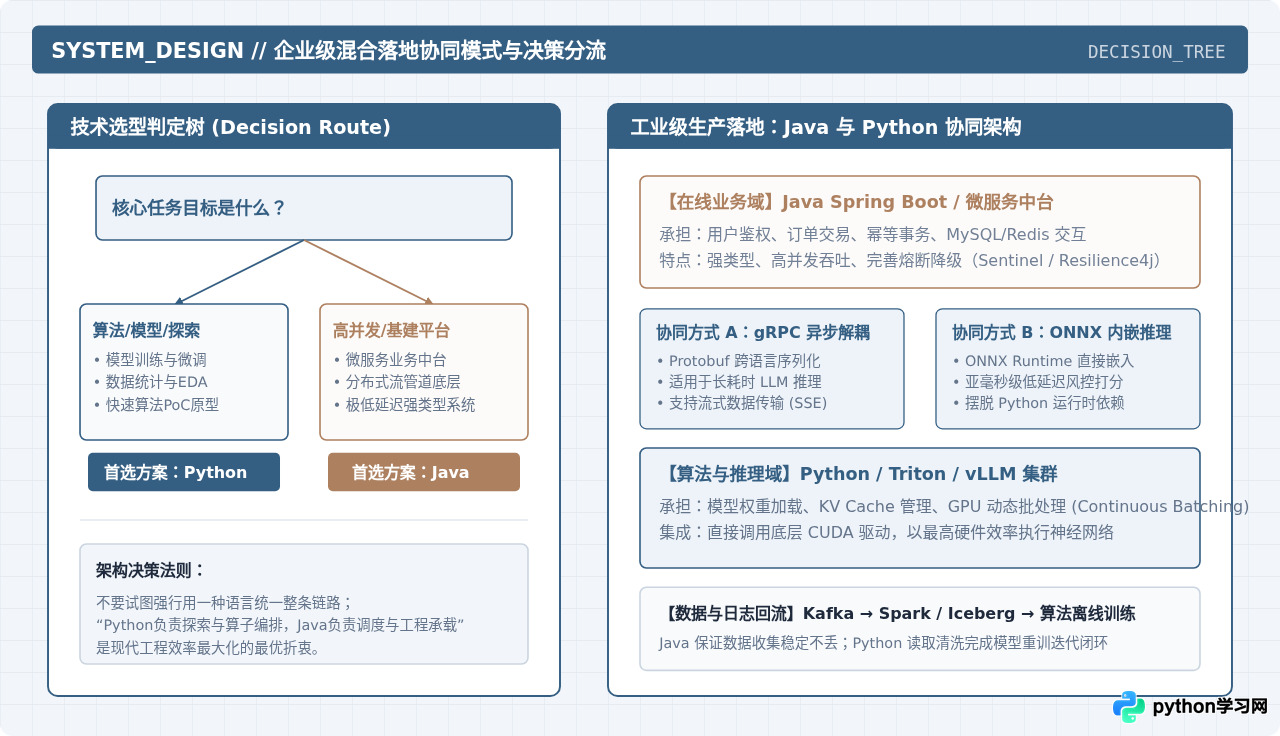
理解了两者的技术本质后,企业在实际技术选型中不应走向极端。理性的技术选型依据并非“非此即彼”,而是根据业务系统的关键工程指标(延迟、吞吐、迭代周期、团队构型)建立清晰的判断标准。
1. 明确的选型决策依据
- 必须选择 Python 的场景:
- 数据探索与统计建模:依赖高频可视化与交互式调试的业务场景。
- 深度学习与大模型全生命周期:包括预训练、LoRA 微调、提示词工程(Prompt Engineering)及 Agent 工作流。
- 快速原型验证(PoC):需要用最少的人力在数日内验证业务可行性。
- 坚守 Java 的场景:
- 超高并发企业网关与业务中台:每秒数万 QPS 的在线交易结算、鉴权风控系统,JVM 的吞吐与内存池化管理依然是业界顶尖水平。
- 核心大数据组件二次开发与运维:定制 Flink 算子、扩展 Spark 调度器、自研分布式存储系统。
- 超大型跨团队协同项目:数百人协作、接口强规约、依靠编译期约束避免运行时类型错误的后端工程。
2. 工业界主流架构:Java 业务层与 Python 算法层的协同模式
在现代化互联网与金融科技企业中,最成熟的生产落地范式是“双轨混合架构”:
Java 服务负责业务聚合、状态事务管理和对外提供稳定的 REST/gRPC 接口;当面临复杂模型打分或大语言模型推理时,Java 服务通过以下两种高效路径与算法层交互:
- 路径 A(解耦服务化调用):Java 业务网关通过高性能 RPC(如 gRPC / HTTP2)调用后端的 Python 推理服务(以 FastAPI / Triton Inference Server / vLLM 封装),兼顾业务稳定与算法敏捷。
- 路径 B(本地嵌入式推理):对于延迟要求在微秒/极低毫秒级的场景,Python 离线训练模型并导出为统一的
ONNX格式或TorchScript,Java 业务进程直接通过 ONNX Runtime Java API 或 Deep Java Library (DJL) 在本地加载并直接调用 C++ 底层推理引擎,彻底消除跨网络 RPC 与 Python 运行时的开销。
六、总结与关键注意事项
回顾大数据与人工智能的发展脉络,Python 对 Java 的优势从来不是纯粹语法层面的“简单易懂”,而是软件工程哲学在特定问题域的胜利:
- 数据探索阶段:交互式环境打破了编译枷锁,提供了十倍以上的实验反馈吞吐率。
- 高性能计算阶段:Python 极其务实地退化为高效控制胶水,将计算下沉至 C++/CUDA 硬件原生层,完美绕开了自身解释执行的性能缺陷。
- 产业生态阶段:学术界与开源社区的压倒性支持,形成了强者恒强的正向网络效应。
- 不要神化 Python 的并发性能:在需要原生多线程并发且逻辑无法下沉到 C 算子的纯 CPU 逻辑中,Python 的 GIL 依然是明显瓶颈。对于复杂的后端业务流水线,多进程(multiprocessing)或异步(asyncio)仅能部分缓解,超大规模高并发依然应交给 Java 或 Go。
- 不要忽视内存与类型安全:当 Python 项目规模扩张到数十万行时,动态类型的重构灾难屡见不鲜。在生产级 Python 仓库中,务必引入
typing类型注解,并配合mypy或ruff等严格的静态检查工具。 - 拥抱混合互补,拒绝语言偏执:在生产系统中,“Python 搞定模型与探索,Java / C++ 搞定网关、集群与吞吐”是业界经过真金白银验证的最优分工方式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









