

怎么利用Kimi网页版高效阅读文献并生成总结
本文详细讲解如何利用Kimi网页版高效阅读学术文献与技术报告,包含文档解析上传规范、分层提问策略、提示词模版、原文证据溯源与防幻觉验证方法,帮助读者快速沉淀结构化研究总结。
一、准备工作与文献上传规范
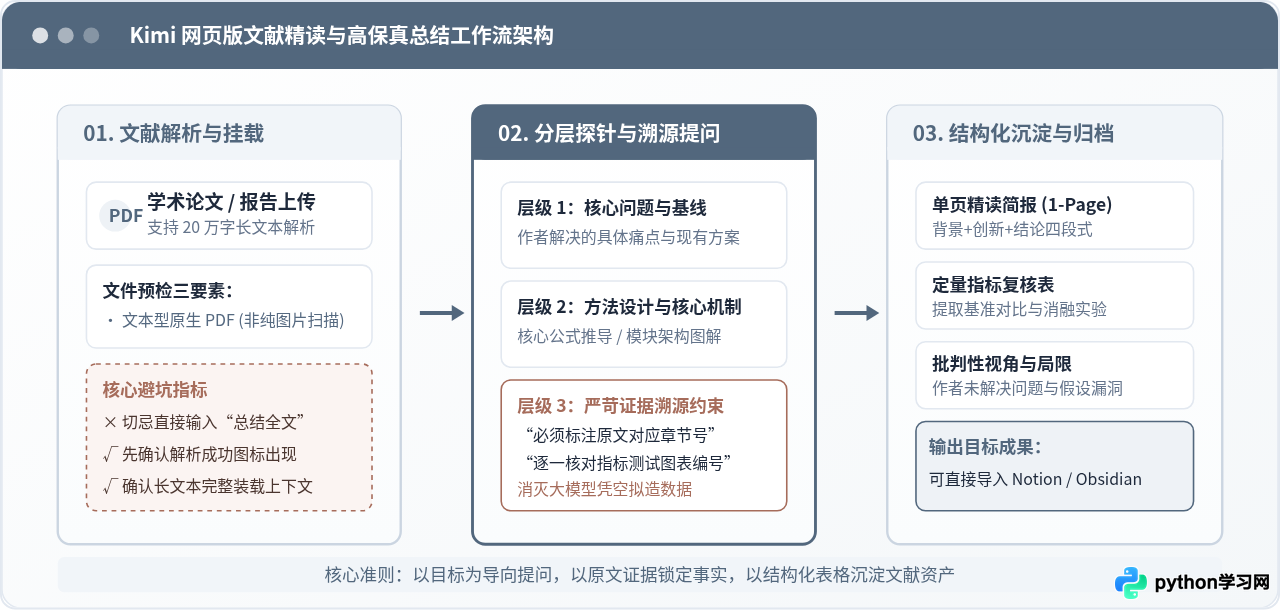
使用 Kimi 网页版(访问 kimi.moonshot.cn)阅读文献的第一步,是确保输入文档能够被模型精确解析。很多读者在上传文件后直接得到空泛答复,根源往往出在源文件本身的排版与格式不适配。大语言模型在网页端处理附件时,依赖后台解析引擎将二进制文件转换为纯文本分块。如果文件存在格式缺陷,模型在后续问答中就会因为“信息缺失”而产生不可控的幻觉。
1. 文件类型选择与预处理建议
在网页端操作时,建议优先使用原生的文本型 PDF(即可直接用鼠标选中文字、复制文本的 PDF 文件)或转换后的 Word (.docx) / Markdown (.md) 文件。
- 文本型 PDF(首选):包含完备的字符编码与排版层,Kimi 能够快速提取标题层级、正文段落和引用标号。
- 纯图片扫描件(需警惕):如果是老旧论文或图书扫描版,由于页面内无字符图层,Kimi 网页端的 OCR 识别精度会大幅下降,极易将数学公式、数据表格识别为乱码。建议在上传前使用本地 OCR 软件(如 Adobe Acrobat、ABBYY 或系统自带 OCR 工具)先行识别转为双层 PDF。
- 双栏与多栏混排处理:现代学术期刊常用双栏排版,Kimi 对主流英文双栏排版有内置解析优化,但为了防止 cross-column 串行,若遇到极其复杂的图文环绕页面,可转换为单栏 docx 后再上传。
2. 网页端上传的具体操作动作
进入 Kimi 对话主界面后,操作路径如下:
- 在底部输入框左侧,点击回形针形状的“添加附件 / 上传文件”图标,或直接将本地 PDF 文件拖拽进浏览器窗口。
- 文件进入上传队列后,输入框上方会出现带有文档名称的胶囊标签,并伴有进度动画。
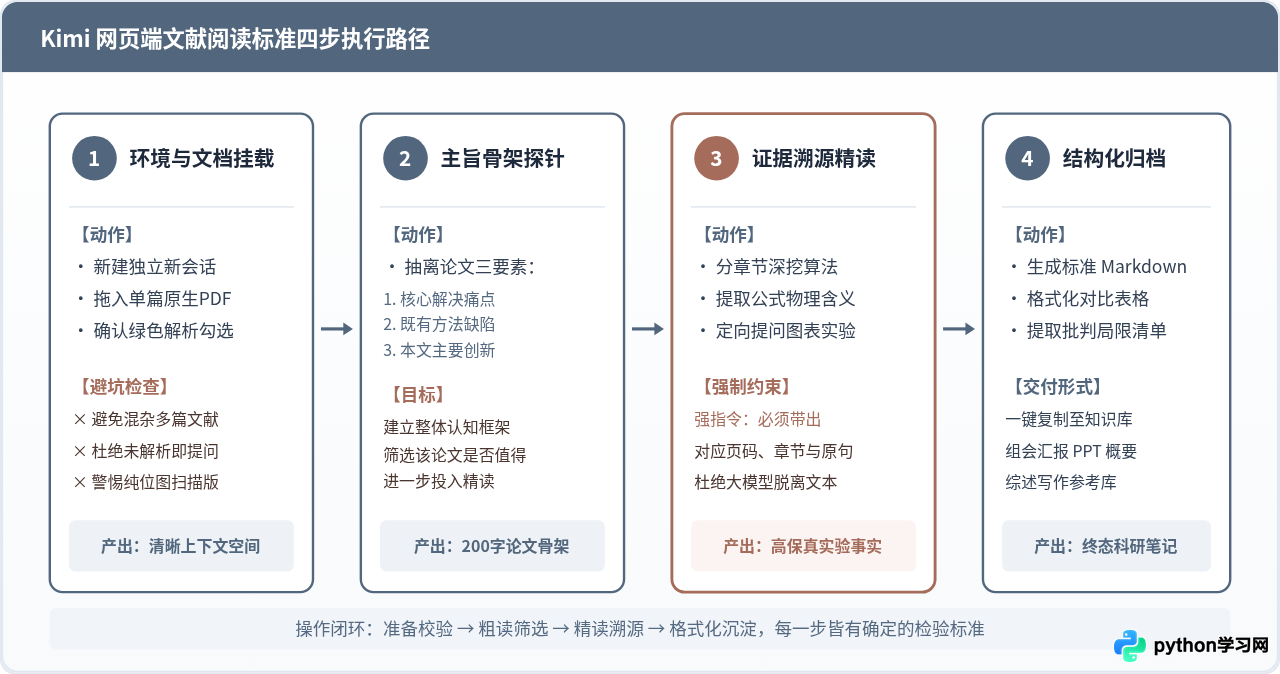
- 关键判定标志:请勿在文件上传动画还在旋转时立刻发送提问。必须等待文档标签右侧出现绿色的“解析完成”对勾标识,或者文档显示具体页数/字数标签。此时表示全文内容已被切片并完全注入会话的暂存上下文窗口。
二、阶段一:建立文献骨架(粗读与核心主旨锚定)
许多使用者在利用 AI 工具时最容易犯的错误,就是将整篇论文上传后直接输入“总结这篇文章的主要内容”。这种提问方式会得到看似洋洋洒洒、实则满篇废话的八股文总结。大语言模型面对模糊指令时,倾向于调用预训练记忆中的泛化常识进行润色,丢失了这篇特定文献真正独特的实验设计与边界条件。
高效阅读的第一阶段是“骨架锚定”。读者应当把 Kimi 当作一位读过该文献的学术助手,通过针对性极强的结构化探针,在 2 分钟内理清论文的核心逻辑支柱。
1. 骨架提取的四个核心维度
一篇优秀的学术论文或研究报告,其核心价值必然凝聚在以下四个具体问题中:
- 研究动机(Research Problem):作者试图解决该领域的哪一个具体技术瓶颈或理论争议?而不是宽泛的研究背景。
- 既有方案局限(Baseline Deficiencies):在本文出现之前,最前沿的 SOTA(State of the Art)方案存在什么致命弱点?
- 核心技术突破(Proposed Method):作者提出了什么全新的机制、架构、配方或证明思路?关键差异化在哪里?
- 关键定论(Main Conclusion):在标准基准数据集或工业场景下,本文获得了怎样的量化提升?
2. 骨架提取提示词模版
在上传并解析好文档后,第一轮对话直接复制以下提示词输入对话框:
预期输出效果与判断标准:收到 Kimi 的回复后,读者需要快速扫视其给出的具体术语和量化指标。如果回复中出现了具体的算法组件名(如“基于双向自注意力残差块”)、具体数据集名(如“ImageNet-1K / GLUE benchmark”)以及具体的提升百分比,说明模型成功锁定了原文中的真实片段;若回复中仅有“该模型显著提升了运算效率和泛化性能”等形容词,则说明该文献可能未给出充分实验,或需要进一步缩小范围追问。
三、阶段二:攻克技术细节与实验验证(精读与推导还原)
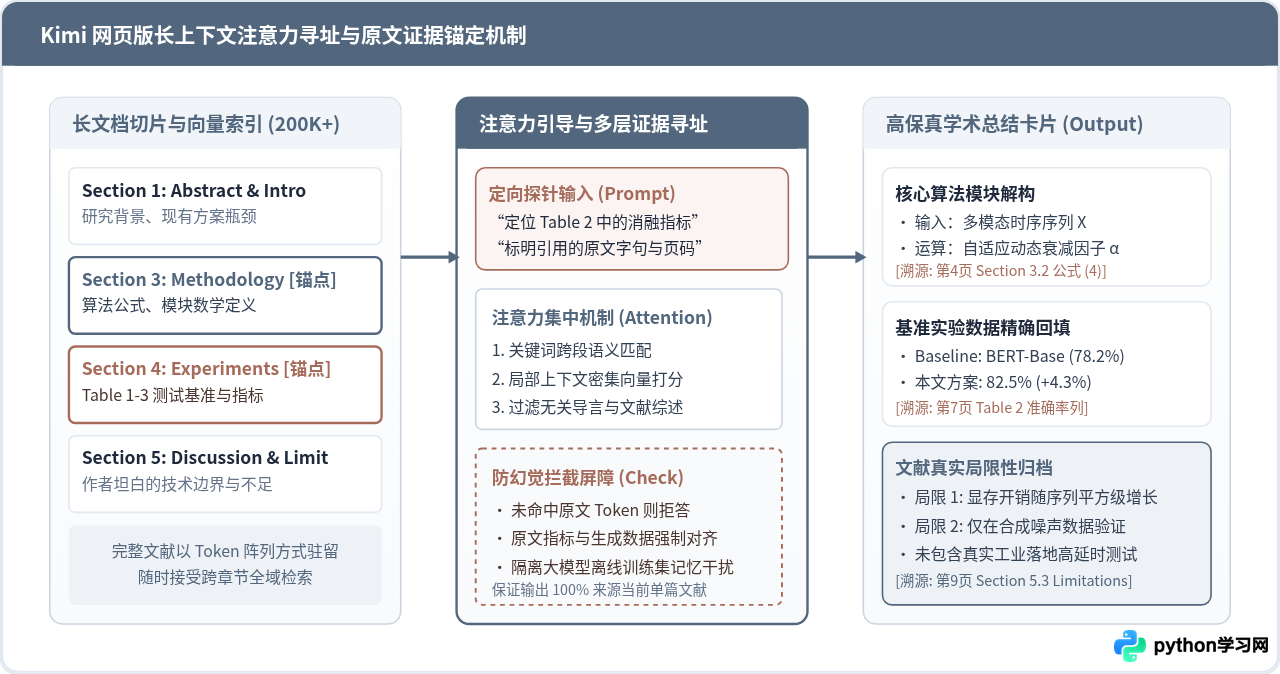
在通过骨架提问确认文献具有深入研读价值后,工作流进入最为关键的“精读阶段”。阅读学术文献的核心阻碍往往在于两处:其一是方法论章节(Methodology / Architecture)密集的数学公式推导与专业术语缩写;其二是实验章节(Experiments / Evaluation)中错综复杂的对比图表与消融实验。
1. 针对方法论的“穿透式”追问法
当遇到晦涩的数学公式或复杂的系统架构时,直接让 Kimi 翻译公式通常收效甚微。读者需要指示它还原“输入输出数据流”与“核心物理/业务意义”。
这种追问方式的奇妙之处在于:大模型将高深抽象的数学符号映射到了具体的数据流操作上。通过阅读 Python 伪代码中的矩阵相乘、归一化或残差连接,读者可以瞬间把握作者在底层到底执行了什么计算。
2. 针对实验图表的精准数值抓取
阅读文献中的实验部分时,切忌让 AI 总结“实验效果如何”。正确做法是直接指明图表编号:
- 对比基准锁定:“请查看正文中的 Table 1 和 Table 2。本文提出的模型在哪个具体数据集、哪项评价指标上超过了 SOTA 模型?超越了几个百分点?”
- 消融实验(Ablation Study)复盘:“请查看 Section 4.3 的消融实验部分。作者移除哪一个模块或参数时,性能下降最明显?这证明了该模块发挥了什么具体作用?”
- 图表趋势解释:“请根据 Figure 4 所示的曲线走势,解释随着参数 K 增大,错误率为什么先降后升?作者对此给出的理论解释是什么?”
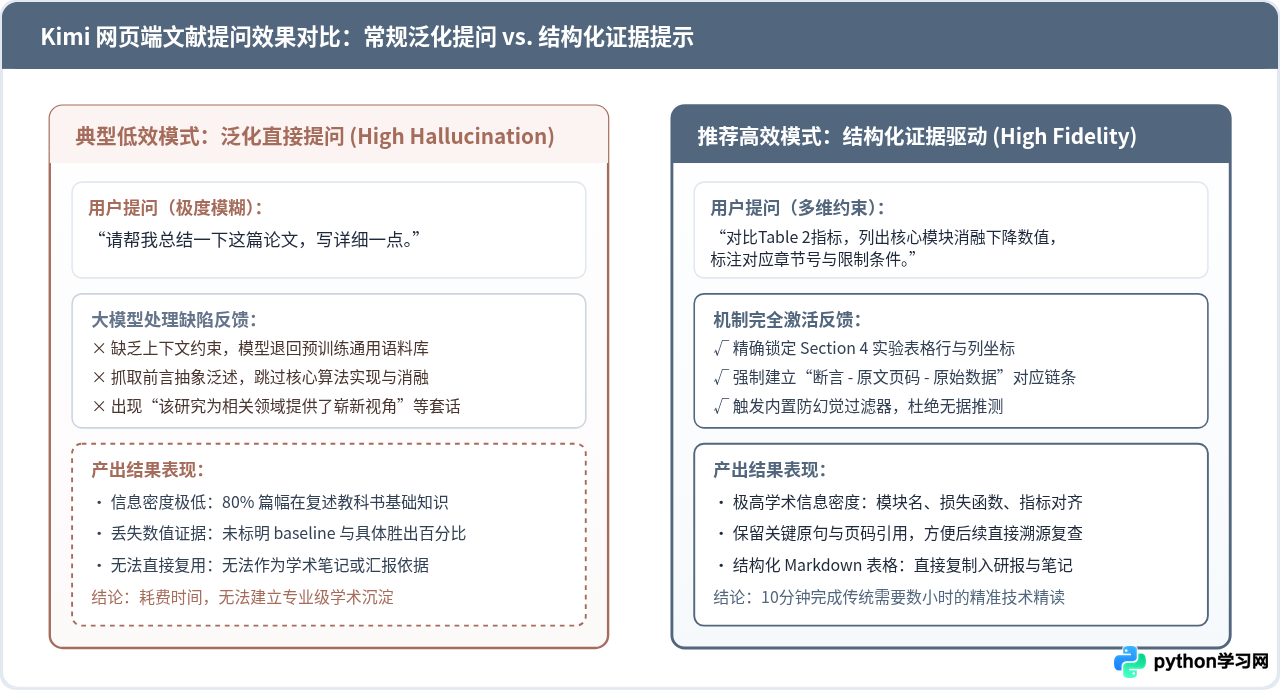
四、阶段三:高质量提示词设计与结构化总结输出
在完成对论文骨架与核心细节的逐项探针提问后,会话中已经积累了大量精准的事实性文本。此时进入最终的“结构化总结生成”环节。
生成总结的核心,在于规定严格的输出格式。大语言模型如果不加版式约束,会自动生成大量口语化的过渡句。通过给 Kimi 提供固定的 Markdown 模板,可以直接将对话内容转化为适合存入 Notion、Obsidian、Logseq 或组会汇报 PPT 的科研资产。
1. 一页式文献速览(One-Page Summary)标准模版
适用于快速建立文献库索引。直接在已解析文献的会话中发送:
2. 跨篇文献横向对比矩阵模版
如果读者正在进行开题报告或论文综述撰写,通常需要对比 2 到 3 篇同方向的经典论文。此时可以在同一个新会话中同时上传两篇文献(例如 Paper_A.pdf 与 Paper_B.pdf),然后执行以下指令:
五、交叉验证与局限性排查(避免大模型幻觉)
必须清醒地认识到:哪怕是具备超长上下文能力的先进模型,在面对长篇英文专业文献时,依然存在“注意力漂移”和“幻觉(Hallucination)”的可能。尤其当文献涉及冷门研究方向、作者自定义的全新缩写词,或者排版极为扭曲的附录表格时,模型容易把推测当成原文事实输出。
1. 逆向施压防幻觉提问法
模型往往倾向于迎合提问者。如果询问“本文的方法是不是在所有场景下都优于传统方案?”,模型可能会给出肯定的附和。要逼出模型的真实检验能力,应该采用“批判性逆向施压”:
- 追问反例:“在这篇文献的全部实验表格中,是否存在本文方法表现不如 Baseline 的指标或数据集?请明确指出是在哪一个表、哪一行。”
- 追问假设边界:“作者在实验中设置了哪些理想化条件?如果脱离了这些假设(例如输入数据存在大量缺失或高噪声),该算法是否还能正常运行?”
- 原文原句调取:“请直接摘录正文中讨论(Discussion / Limitations)部分的原话(英文原文),并附上所在页码。”
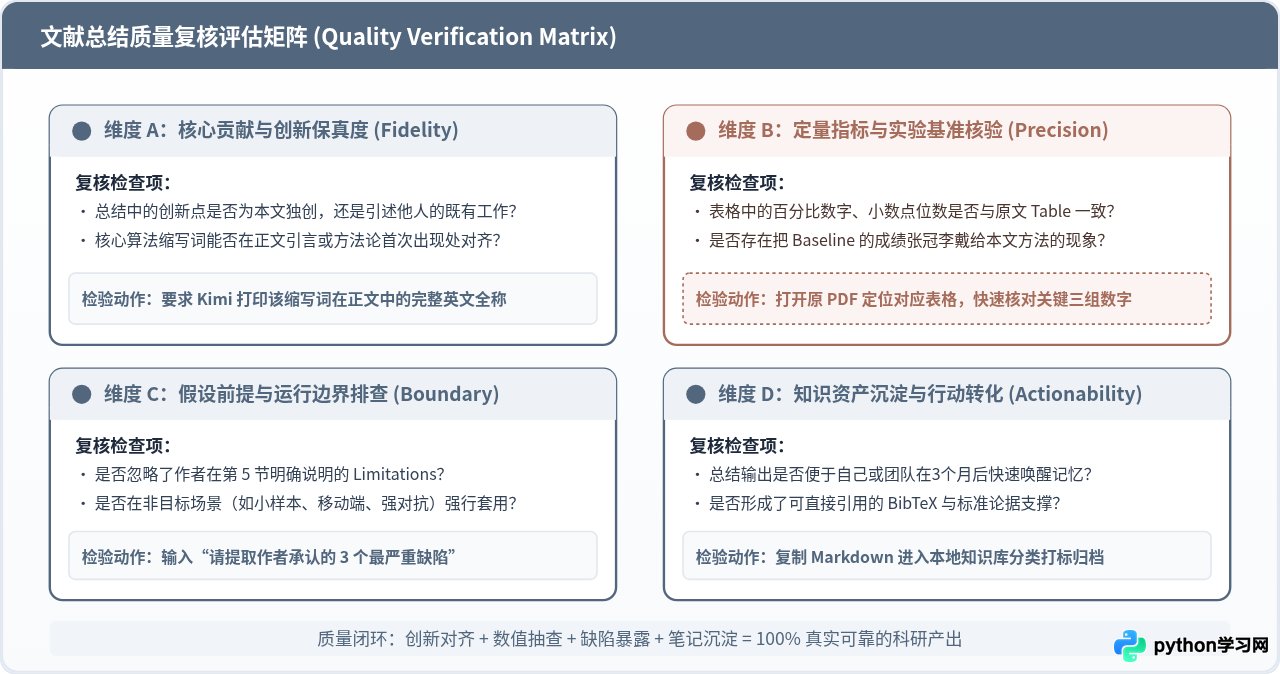
六、常见问题排查与使用限制说明
在长期使用 Kimi 网页版阅读学术文献的过程中,读者可能会遇到一些具体的异常情况。以下是常见技术问题的应对策略:
| 常见异常现象 | 根本原因分析 | 针对性解决操作 |
|---|---|---|
| 公式显示为乱码或占位符 | PDF 内部数学公式采用特殊内嵌字体(如 Type 3 / Computer Modern),文本解析器未能正确映射 Unicode 码位。 | 在输入框中向 Kimi 说明:“请参考公式 (3) 上下文的文字叙述,用标准 LaTeX 代码还原该公式”,或直接对公式区域截屏作为图片输入提问。 |
| 答复中混入了其他无关论文内容 | 在同一个会话中先后上传了多篇文献,长上下文缓存产生了跨文档的注意力注意力干扰。 | 点击左侧侧边栏“+ 新建对话”,在干净的新会话中仅上传目标单篇 PDF,确保上下文空间纯净。 |
| 上传后提示“文件解析失败” | 文件被设置了只读权限密码保护,或者文件体积超过网页端单文件解析上限。 | 使用 PDF 阅读器打印为“无密码新 PDF”,或者将正文附录(Appendix)拆分,仅保留 Main Body(前言至参考文献前)后重新上传。 |
| 输出内容笼统、回避具体数据 | 提问词过于简略(例如“总结本文”),模型默认采用低 Token 消耗的概要模式。 | 在提示词末尾强制添加约束:“必须包含原文具体指标数据、章节号及 Baseline 名称,字数不少于 800 字”。 |
知识沉淀:从对话框到个人知识库
在网页端获得满意的总结后,阅读工作尚未完全结束。网页端会话属于临时交互形态,历史记录虽然保存在侧边栏,但不利于未来的全局检索。高效的研究者会在完成会话后,执行最后的“归档动作”:
- 点击 Kimi 回复卡片右下角的“复制”按钮(直接获取完整的 Markdown 原文格式,保留表格与代码块)。
- 将内容粘贴到本地 Markdown 笔记软件(如 Obsidian、Logseq、Notion)中。
- 以
[年份]_[第一作者]_[论文简短关键词].md的标准规则重命名笔记文件,并将原文 PDF 附件进行关联超链接。
通过这套标准的“规范上传 → 骨架锚定 → 深度追问 → 结构化总结 → 交叉复核 → 本地归档”闭环,原本需要耗费大半天时间的文献精读工作,不仅可以在 20-30 分钟内高保真完成,更能确保沉淀下来的每一条笔记都有据可循、随时可用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









