

解决Python正则匹配中文乱码及特殊字符转义问题
深入剖析并解决Python正则表达式在匹配中文时的乱码、漏匹配问题,以及特殊元字符与动态参数转义导致的语法崩溃。涵盖Unicode编码机制、原始字符串r前缀、re.escape防御性处理及实战解决方案。
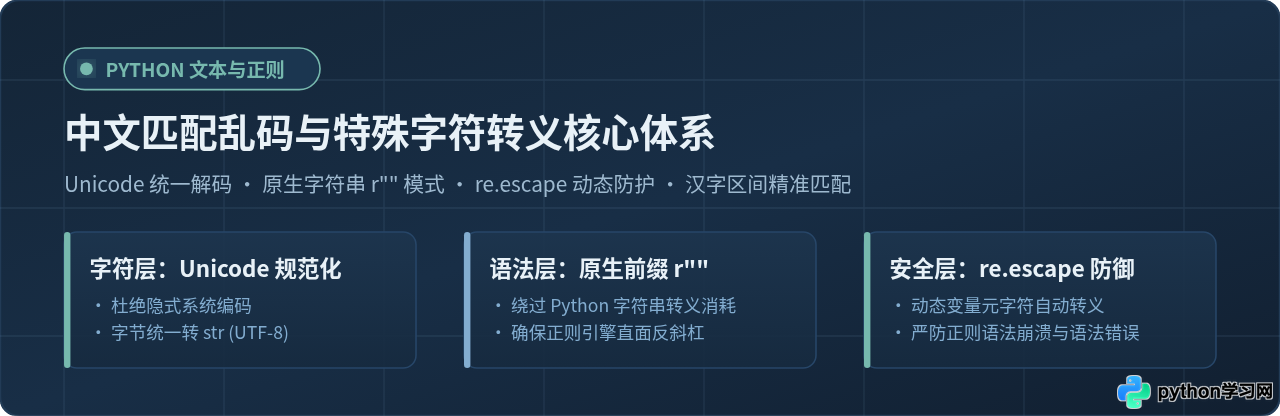
【通知】价格由 100 调整至 (150) 元,详情咨询 +86-10-xxxx)。当尝试使用 re.findall(r'[一-龥]+', text) 提取中文,或者根据外部动态变量构建正则去匹配括号中的内容时,常常直接遭遇两类典型障碍:要么提取结果为空、输出为 \xe4\xbd\xa0 等字节串乱码;要么直接抛出 re.error: missing ), unterminated subpattern 语法异常崩溃。这两个问题的本质分别位于不同层级:中文匹配乱码的根源在于数据流在 bytes 与 Unicode (str) 之间未正确解码统一,或字符集范围定义不全;而特殊字符报错的根源在于 Python 字符串字面量转义与正则引擎元字符转义之间的双重冲突。本文将针对这两个问题,提供清晰的排查流程、成因机制剖析、避坑规则及防御性实战方案。
一、故障现场:中文乱码与转义报错的典型复现
为了准确排查问题,首先需要明确这两类故障在 Python 程序中的真实表现形式。
1. 场景一:直接在未解码的字节流上匹配中文
许多网络请求库或底层文件读取方法(如 socket.recv() 或 open(..., 'rb'))返回的是 bytes 类型。如果在字节流上直接使用针对 Unicode 汉字范围的正则表达式,将导致空匹配或类型错误;若强行打印未经转码的字节串,就会看到 \xe4\xbd\xa0 之类的 16 进制表现。
import re

# 模拟网络原始接收到的 UTF-8 字节流
raw_bytes = b"\xe6\xac\xa2\xe8\xbf\x8e\xe4\xbd\xbf\xe7\x94\xa8 Python \xe6\xad\xa3\xe5\x88\x99"

# 错误尝试 1:直接拿 Unicode 正则匹配 bytes(将直接抛出 TypeError)
try:
    re.findall(r"[\u4e00-\u9fa5]+", raw_bytes)
except TypeError as e:
    print(f"抛出异常: {e}")

# 错误尝试 2:误用系统默认编码隐式解码,或者直接打印未格式化字节
print(f"原始字节形式显示: {raw_bytes}")
原始字节形式显示: b'\xe6\xac\xa2\xe8\xbf\x8e\xe4\xbd\xbf\xe7\x94\xa8 Python \xe6\xad\xa3\xe5\x88\x99'
2. 场景二:动态变量拼接引发元字符解析崩溃
在业务逻辑中,经常需要根据用户输入或外部配置作为关键词进行正则检索。如果外部参数中含有英文括号 ()、方括号 []、加号 +、星号 * 等正则元字符,直接通过 f-string 拼接会导致正则表达式语法非法,触发 re.error。
import re

# 外部动态传入的关键字,带有英文加号与括号
keyword = "C++(进阶版)"
text = "当前课程名:C++(进阶版),请提前预习。"

# 危险做法:直接字符串插值拼接
bad_pattern = rf"{keyword},请提前"

try:
    re.search(bad_pattern, text)
except re.error as e:
    print(f"正则编译崩溃: {e}")
在上面的示例中,++ 被正则引擎解析为“多个连续重复量词”,直接导致编译失败;若参数包含单个左括号 (,则会报错 missing ), unterminated subpattern。
二、中文匹配与乱码根治:排查流程与规范方案
解决中文匹配问题,核心是确保数据在传入正则引擎之前已经成为标准的 Unicode 字符(str),并采用完备的 Unicode 编码区间。
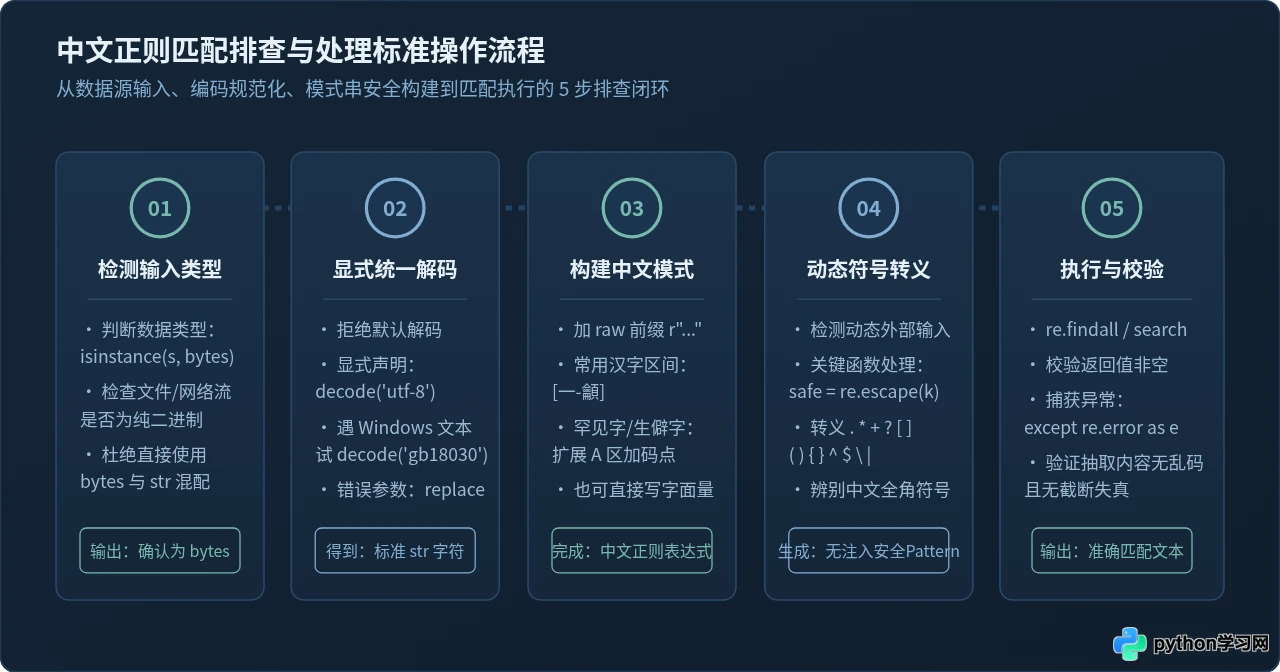
步骤 1:显式检查并统一数据类型为 str
绝不要依赖操作系统的默认环境编码,必须在业务入口处显式调用 .decode()。对于国内常见的数据来源,主要分为 UTF-8 和 GB18030 / GBK。如果不确定编码,可优先以 utf-8 解码,捕获 UnicodeDecodeError 后回退到 gb18030:
def safe_decode(raw_data: bytes) -> str:
    """将未知来源的二进制字节流安全解码为 Unicode str"""
    if isinstance(raw_data, str):
        return raw_data
    for encoding in ("utf-8", "gb18030", "gb2312"):
        try:
            return raw_data.decode(encoding)
        except UnicodeDecodeError:
            continue
    # 最终保底:替换无法识别的非法字节,避免程序崩溃
    return raw_data.decode("utf-8", errors="replace")
步骤 2:精准定义中文匹配的 Unicode 范围
在 Python 3 中,标准汉字对应的 Unicode 编码区间主要包括以下几个核心段落:
- 常用基本汉字:
[\u4e00-\u9fa5](涵盖常用 20902 个汉字,能满足 99% 的常见文本需求)。 - CJK 统一表意文字扩展 A 区:
[\u3400-\u4dbf](涵盖常见生僻字、古籍字、人名罕见字)。 - 全覆盖汉字表达式:
[\u4e00-\u9fff\u3400-\u4dbf](建议在档案、户籍或古籍文本清洗中使用)。
import re

text = "解析用户留言:张伟参加了【技术研讨会】,提交了报告。"

# 匹配连续中文字符串
chinese_pattern = re.compile(r"[\u4e00-\u9fa5]+")
results = chinese_pattern.findall(text)
print("提取到的中文词块:", results)
三、底层机制剖析:字符编码流与双层转义架构
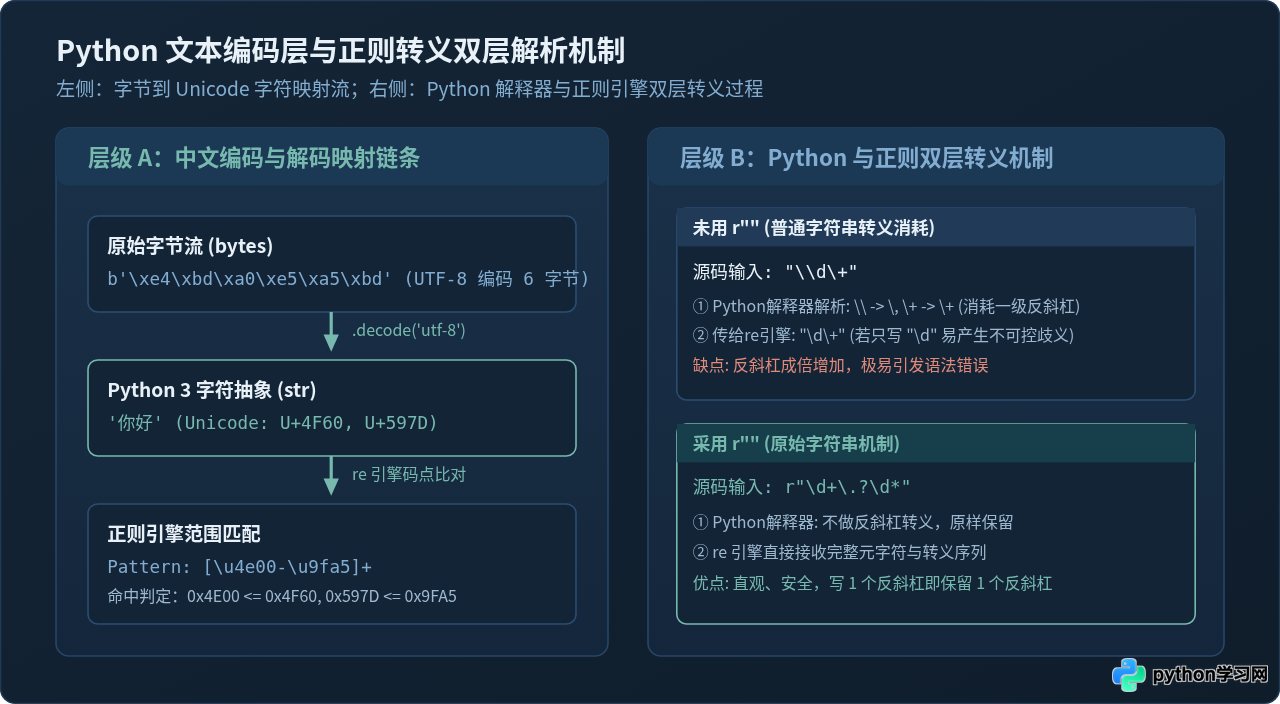
为什么 Python 正则在处理中文和特殊符号时容易产生困惑?理解 Python 字符串生命周期与正则编译器的双层工作机制是关键所在。
1. Python 3 字节与 Unicode 字符串的分离
在 Python 3 中,内存中的 str 对象本质上是 Unicode 字符序列,每个字符对应一个唯一的 Unicode 码点(Code Point)。而 bytes 是物理存储或网络传输时的二进制序列。
正则表达式引擎的 \u4e00 是基于字符码点进行数值区间比对的。当传入 str 时,正则引擎将字符转换为对应码点(例如“中”对应 0x4E2D),判断其是否处于 0x4E00 到 0x9FA5 之间;如果传入的是未解码的 bytes,每个中文字符被拆解成了 3 个十六进制字节(如 0xE4 0xB8 0xAD),码点匹配逻辑自然全部失效。
2. 语法解析层与正则引擎层的双层转义机制
特殊字符转义之所以容易出错,是因为文本在抵达正则引擎之前,先被 Python 解释器本身的字符串解析器处理了一次:
- 第一层(Python 字符串字面量解析):解释器读取源码中的双引号或单引号字符串,将
\n解释为换行,将\\解释为单个反斜杠\。 - 第二层(Regex 正则语法编译):正则引擎接收到第一层生成的字符串,再把
\d解释为数字,把\(解释为字面量括号。
如果编写普通字符串 "\\d",第一层解析后传给正则引擎的仅是 \d;如果想在普通字符串里匹配一个物理反斜杠字符 \,必须编写 "\\\\"(解释器将四个反斜杠压缩为两个,正则引擎再将两个反斜杠压缩为一个),这被称为“反斜杠地狱”。
r 前缀(如 r"\d+")。r 代表 Raw String(原始字符串),它告诉 Python 解释器不要对反斜杠进行字面量转义,原样交给正则引擎处理,从而彻底消除了第一层的转义损耗。
四、特殊字符转义避坑指南:规则、方法与全半角差异
1. 动态参数的安全防御:必须使用 re.escape()
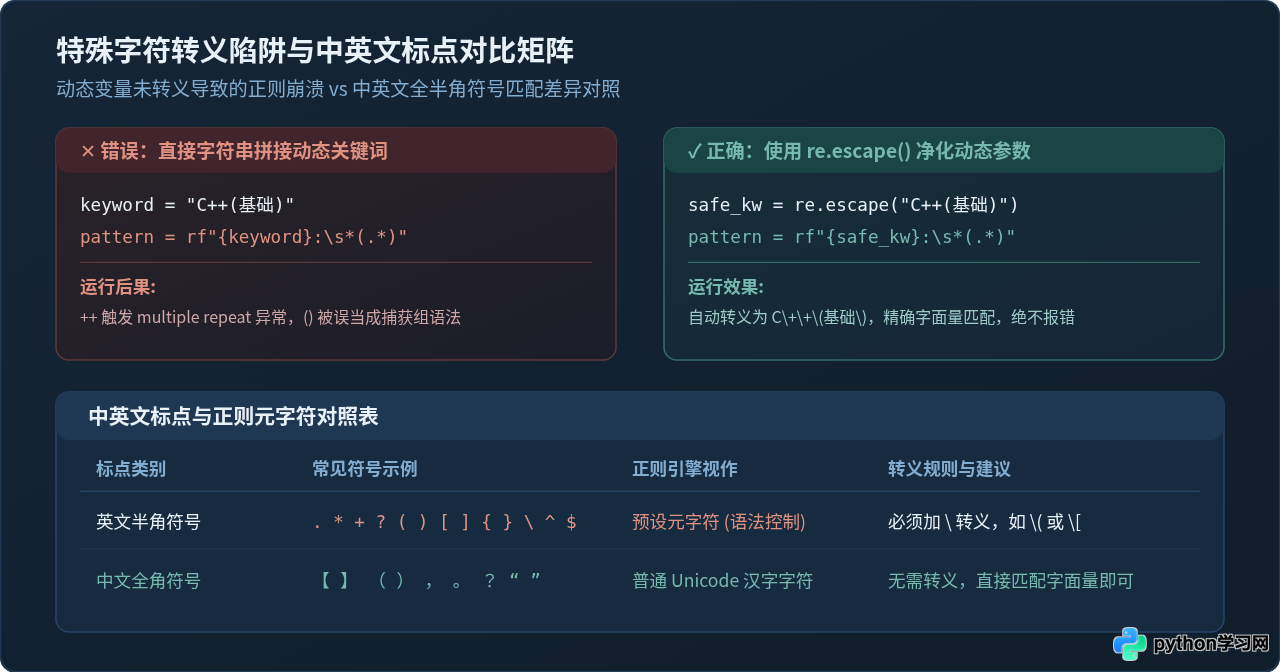
当正则表达式需要结合变量进行动态拼装时,绝不能假定变量仅包含普通字母或汉字。Python 提供了内置函数 re.escape(pattern),它会自动遍历输入字符串,在每一个 ASCII 标点与正则元字符前添加转义反斜杠。
import re

# 模拟含有特殊字符的搜索关键字
user_query = "iphone 14 (256G) + 保护壳?"
text_corpus = "特惠清单:iphone 14 (256G) + 保护壳? 现货秒发!"

# 使用 re.escape 进行全面转义
safe_keyword = re.escape(user_query)
print(f"转义后的模式串: {safe_keyword}")

# 安全构建完整正则表达式
match = re.search(rf"特惠清单:({safe_keyword})\s+", text_corpus)
if match:
    print(f"精准匹配成功: {match.group(1)}")
精准匹配成功: iphone 14 (256G) + 保护壳?
2. 中文全角标点与英文半角标点的混淆陷阱
在中文文本处理中,最常见的隐形 Bug 是混淆了中文全角标点与英文半角标点。下表总结了关键区别:
| 符号分类 | 典型代表字符 | 在正则引擎中的角色 | 书写与转义处理规范 |
|---|---|---|---|
| 英文半角符号 | ( ) [ ] { } . * + ? ^ $ \ | |
语法控制元字符 | 必须加反斜杠转义:\(、\[、\+ 等,否则触发语法解析 |
| 中文全角符号 | ( ) 【 】 { } 。 、 “ ” ! ? |
普通 Unicode 文本字符 | 无需反斜杠转义,直接按字面量书写:r"【(.*?)】" |
() 和方括号 【】 在正则引擎眼里与普通汉字“中”、“文”没有区别,不需要加反斜杠。如果在全角括号前加反斜杠(如 \(),虽然多数情况下能匹配,但在某些特定引擎模式或 strict 编译下会增加不必要的代码混乱;反之,如果在英文括号前漏加反斜杠,则会变成捕获组语法。
五、综合实战:构建高鲁棒性的文本提取模块
结合上述所有规则,我们实现一个可直接复用在生产环境中的中文与混合标点提取工具函数。该函数能够安全处理外部二进制输入、自动转码、安全注入动态参数,并精准提取结构化字段。
import re
from typing import Union, List, Optional

def extract_structured_chinese(
    raw_content: Union[str, bytes],
    prefix_keyword: Optional[str] = None
) -> List[str]:
    """
    从混合文本中安全提取中文与伴随信息

    参数:
        raw_content: 输入文本,支持 str 或 bytes
        prefix_keyword: 动态前缀关键字(可能含特殊元字符)
    返回:
        提取到的有效内容列表
    """
    # 步骤 1: 确保输入统一为标准 Unicode str
    if isinstance(raw_content, bytes):
        try:
            text = raw_content.decode("utf-8")
        except UnicodeDecodeError:
            text = raw_content.decode("gb18030", errors="replace")
    else:
        text = raw_content

    # 步骤 2: 构建安全模式串
    if prefix_keyword:
        # 对动态传入的外部变量使用 re.escape 过滤
        safe_prefix = re.escape(prefix_keyword)
        # 匹配前缀后的中文内容(支持中文全角书名号提取)
        pattern_str = rf"{safe_prefix}\s*[::]\s*【?([\u4e00-\u9fa5a-zA-Z0-9_\-\+]+)】?"
    else:
        # 无前缀时,匹配所有中文及全角中文词组
        pattern_str = r"[\u4e00-\u9fa5]+"

    # 步骤 3: 编译并执行正则匹配
    try:
        regex = re.compile(pattern_str)
        return regex.findall(text)
    except re.error as err:
        print(f"[ERROR] 正则表达式执行异常: {err}")
        return []

# --- 验证案例 1:处理包含特殊符号前缀的复杂文本 ---
sample_data_1 = "项目代号 C++(V2.0) : 【核心引擎模块-重构版】,状态正常。"
extracted_1 = extract_structured_chinese(sample_data_1, prefix_keyword="C++(V2.0)")
print("测试 1 提取结果:", extracted_1)

# --- 验证案例 2:处理二进制 GBK 编码混合输入 ---
sample_bytes_gbk = "服务标签: 【数据中心A区】".encode("gb18030")
extracted_2 = extract_structured_chinese(sample_bytes_gbk, prefix_keyword="服务标签")
print("测试 2 提取结果:", extracted_2)
测试 2 提取结果: ['数据中心A区']
六、排错总结与速查决策全景
在日常开发与排错时,可依据下述决策图快速定位问题根源并采取对应措施。
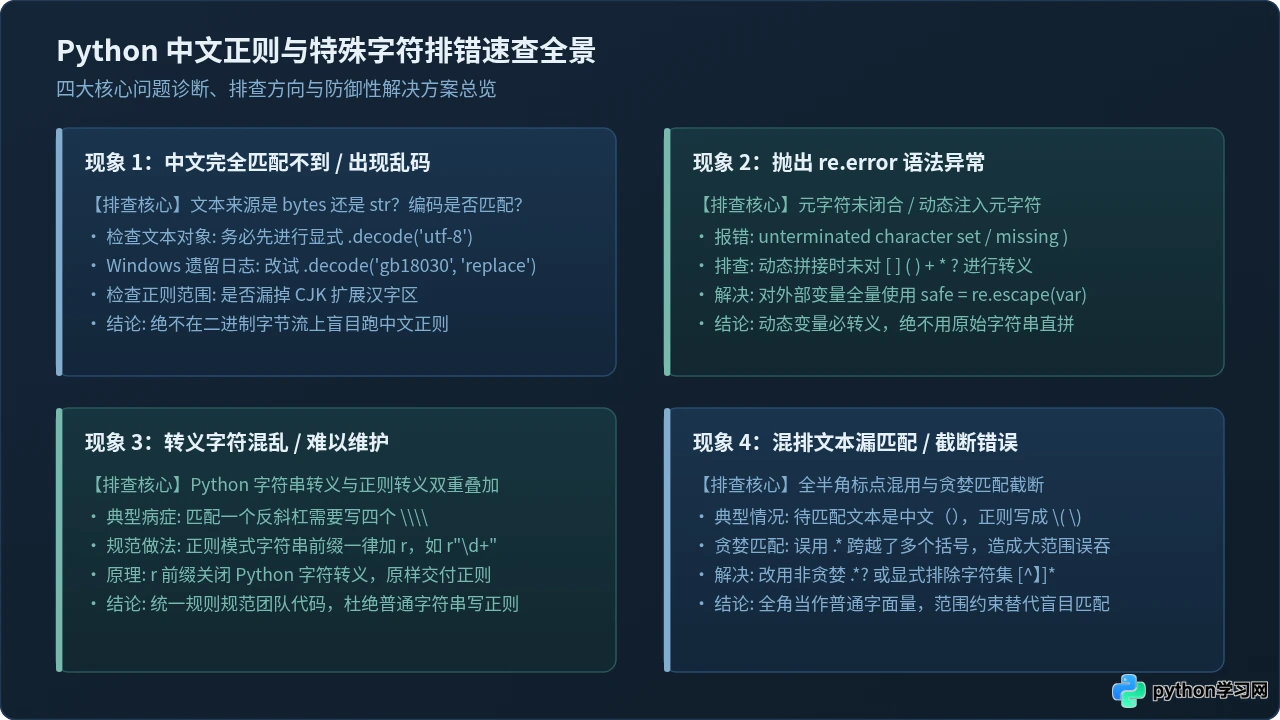
总结核心排错法则:
- 编码前置:正则引擎只管匹配逻辑,不管底层编码。凡涉及外部文件、网络数据,进入正则流程前必须显式解码为
str。 - 模式前缀必须加 r:无论正则表达式是否包含反斜杠,均养成
r"..."的书写习惯,彻底规避 Python 解释器的一级转义干扰。 - 动态变量必用 re.escape:任何来自用户输入、请求参数或外部配置的字符串,一旦需要拼装到正则表达式中,一律使用
re.escape()进行防护。 - 辨清标点全半角:中文全角标点(
【】())是普通字符,英文半角标点([]())是元字符。避免在全角标点上乱加转义,更要防止在半角标点上漏掉转义。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









