

学Python能做什么:数据分析、Web开发与自动化办公的核心应用
深入解析学Python能做什么:从自动化办公的批量报表处理、数据分析的清洗聚合可视化,到Web开发的高性能接口构建,全面阐述三大核心应用场景、操作流程、代码范例与技术路线选择。
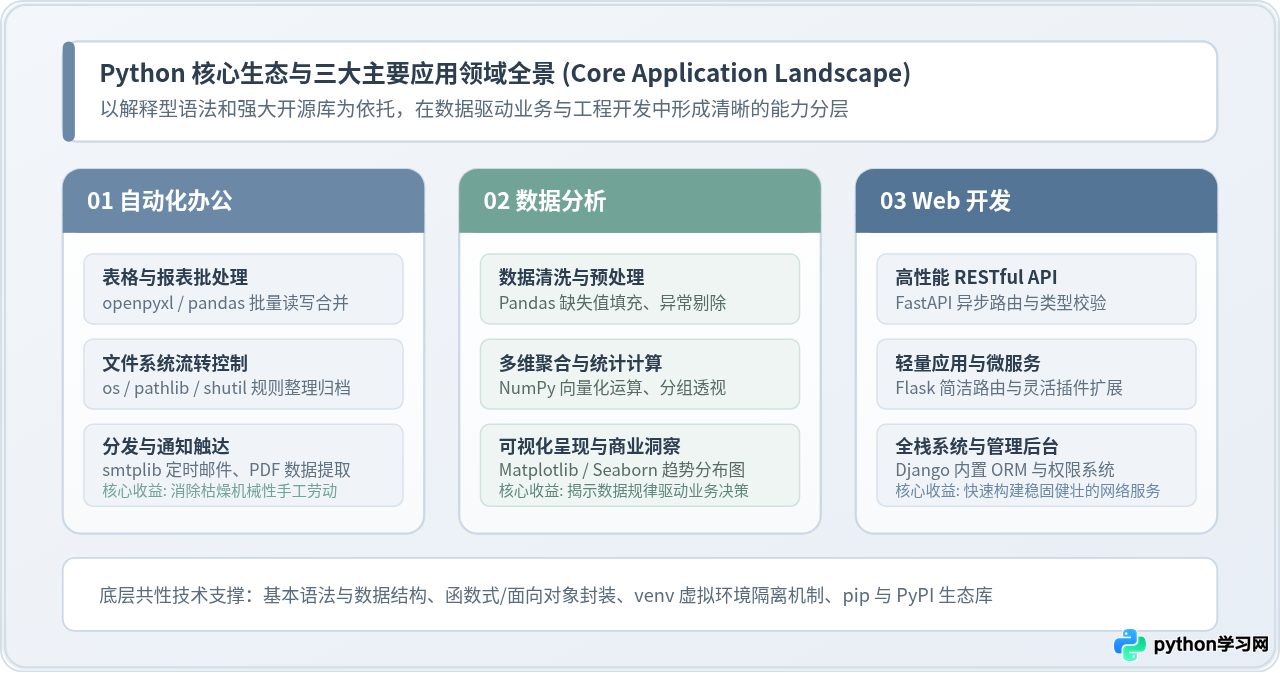
一、自动化办公:批量消除机械与重复劳动
在日常行政、财务、运营与业务协同工作中,大量时间往往被耗费在机械式的操作上,例如在几十个结构相似的 Excel 表格之间复制粘贴数据、按统一规则重命名成百上千个文档、按月份归档文件,或是定时给对应业务方分发特定格式的报表。这类工作的共同特征是:规则高度固定、步骤繁琐,人工操作不仅耗时冗长,而且极易出现疏漏或录入偏差。
Python 在自动化办公中的核心作用,是通过脚本把人工点击界面的操作转化为可重复执行的代码逻辑。标准库中的 os、pathlib、shutil 负责文件与目录遍历,第三方库 openpyxl 与 pandas 负责电子表格的读写与合并,smtplib 则能自动对接邮件服务器完成分发。
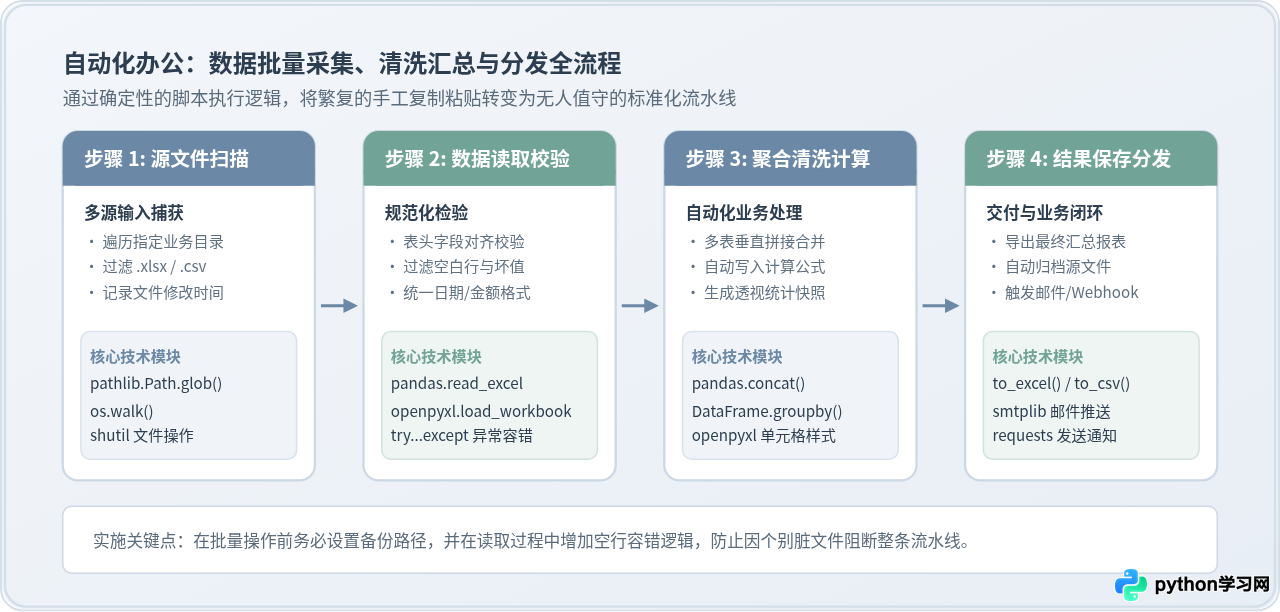
典型操作流程:跨表格数据自动化合并
以最常见的跨部门月度销售报表汇总为例,操作流程通常分为四个标准化步骤:
- 准备执行环境:安装表格解析所需的运行库(
pandas与openpyxl)。 - 扫描输入目录:使用
pathlib.Path检索指定文件夹下所有符合命名规范的工作簿文件,跳过临时文件(如以~$开头的缓存文件)。 - 提取与格式校验:逐个读取工作表,核对核心列名是否存在,剔除无效的空行,并为每条记录追加“来源文件名”以便核查。
- 汇总并写入成果文件:将清洗后的数据列表垂直拼接为一个统一的工作表,保存至归档目录。
完整代码示例:批量合并 Excel 销售明细
以下代码演示如何在一个脚本中完成指定目录下所有销售子表的检索、校验与合并。环境要求为 Python 3.8 及以上版本。
# -*- coding: utf-8 -*-
"""
脚本名称: merge_sales_reports.py
运行环境: Python 3.8+
依赖安装: pip install pandas openpyxl
"""
from pathlib import Path
import pandas as pd

def merge_excel_files(source_dir: str, output_filepath: str) -> None:
    source_path = Path(source_dir)
    # 检索目录下所有的 .xlsx 文件,排除 Office 打开时生成的临时缓存文件
    excel_files = [f for f in source_path.glob("*.xlsx") if not f.name.startswith("~$")]

    if not excel_files:
        print(f"提示:在目录 {source_dir} 下未找到有效的 .xlsx 文件")
        return

    data_frames = []
    required_columns = ["订单编号", "客户名称", "销售金额", "销售日期"]

    for file in excel_files:
        try:
            # 读取当前表格,并强制将订单编号转为字符串防止前导0丢失
            df = pd.read_excel(file, dtype={"订单编号": str})

            # 校验表头字段完整性
            missing_cols = [col for col in required_columns if col not in df.columns]
            if missing_cols:
                print(f"跳过文件 {file.name}:缺少必要字段 {missing_cols}")
                continue

            # 过滤全空行并补充数据来源标识
            df_clean = df.dropna(subset=["订单编号", "销售金额"]).copy()
            df_clean["来源文件"] = file.name
            data_frames.append(df_clean)
            print(f"成功解析: {file.name},有效记录: {len(df_clean)} 条")
        except Exception as err:
            print(f"读取文件 {file.name} 失败: {err}")

    if not data_frames:
        print("未提取到任何有效数据,终止合并操作。")
        return

    # 垂直合并全部 DataFrame
    merged_df = pd.concat(data_frames, ignore_index=True)

    # 确保输出目录存在并保存汇总表格
    out_file = Path(output_filepath)
    out_file.parent.mkdir(parents=True, exist_ok=True)
    merged_df.to_excel(out_file, index=False)
    print(f"\n合并完成!汇总文件已保存至: {output_filepath}")
    print(f"总计合并数据条数: {len(merged_df)} 条")

if __name__ == "__main__":
    # 指定测试目录与输出路径
    merge_excel_files(source_dir="./reports_input", output_filepath="./output/sales_summary.xlsx")
在实际办公环境中,经常会遇到 .xls(早期二进制格式)和 .xlsx 混杂的情况。读取 .xls 需要额外安装 xlrd<2.0.0,建议优先将历史文件统一转换。此外,表格中若存在合并单元格,非左上角单元格读取时会呈现 NaN,应在处理前使用 df.ffill()(前向填充)或在数据录入阶段规范为明细表结构。
二、数据分析:从多源原始数据到决策洞察
企业积累了海量的业务日志、订单明细、用户点击和市场调查数据,单纯依靠手工表格已经无法承载数十万乃至数百万行的数据体量。Python 成为数据分析领域事实上的通用语言,核心在于其拥有完整、高效且互相协作的工具生态:Pandas 提供了高效的二维表格容器(DataFrame),NumPy 提供底层的 C 语言级向量运算,而 Matplotlib 与 Seaborn 则能够将枯燥的数字矩阵转化为直观的可视化图表。
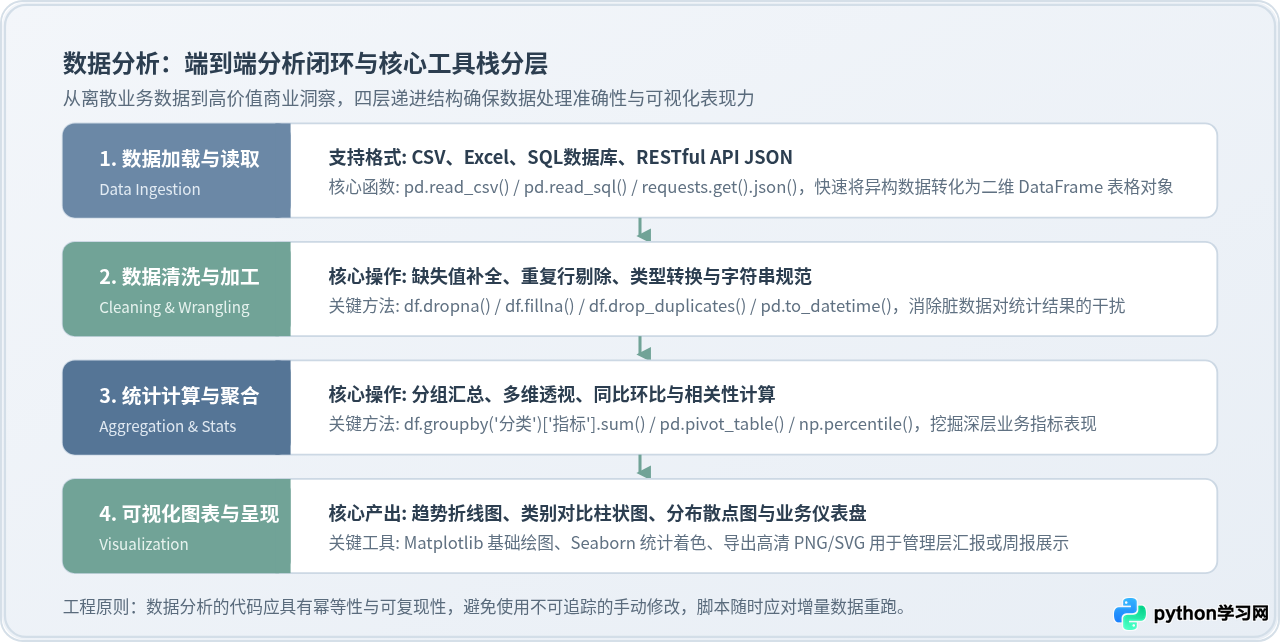
核心工作闭环与解决的问题
Python 数据分析不仅是简单的求和与均值计算,它涵盖了从数据接入到结论输出的完整闭环:
- 多源数据提取:通过单行代码即可对接 CSV、Parquet、企业级关系型数据库(如 PostgreSQL / MySQL)甚至网络接口。
- 数据清洗与特征构建:识别由于网络波动或人为漏填造成的缺失值,检测偏离正常范围的异常离群点,提取日期中的“星期几”、“月份周期”等业务特征。
- 多维透视与指标聚合:根据渠道、品类、地域等多维度对用户留存率、订单客单价、复购周期进行分组聚合计算(Group By / Pivot)。
- 可视化呈现与报告输出:自动渲染趋势折线图、品类对比柱状图与箱线分布图,并直接导出为高清矢量图或 PDF 报告。
完整实战示例:销售明细清洗、分组统计与可视化
以下代码演示如何加载原始销售记录,过滤异常退款记录,按商品品类统计成交总金额与订单量,并将结果绘制为柱状统计图。
# -*- coding: utf-8 -*-
"""
脚本名称: analyze_sales_data.py
运行环境: Python 3.8+
依赖安装: pip install pandas matplotlib
"""
import pandas as pd
import matplotlib.pyplot as plt

def run_sales_analysis(input_csv: str, output_chart: str) -> None:
    # 1. 加载数据
    df = pd.read_csv(input_csv)

    # 2. 清洗操作:剔除金额小于等于0的异常数据,补全分类缺失值
    df_clean = df[df["amount"] > 0].copy()
    df_clean["category"] = df_clean["category"].fillna("未分类")

    # 3. 多维聚合计算:按商品品类统计总销售额与平均客单价
    summary = df_clean.groupby("category").agg(
        total_revenue=("amount", "sum"),
        order_count=("order_id", "count"),
        avg_order_value=("amount", "mean")
    ).reset_index()

    # 按销售额降序排列
    summary = summary.sort_values(by="total_revenue", ascending=False)

    print("=== 销售品类汇总统计 ===")
    print(summary.to_string(index=False))

    # 4. 可视化绘制
    # 设置系统通用中文字体回退,防止乱码
    plt.rcParams["font.sans-serif"] = ["PingFang SC", "Microsoft YaHei", "SimHei", "sans-serif"]
    plt.rcParams["axes.unicode_minus"] = False

    fig, ax = plt.subplots(figsize=(8, 4.5))
    bars = ax.bar(summary["category"], summary["total_revenue"] / 10000, color="#6B88A6", edgecolor="#4B6584")

    ax.set_title("各商品品类月度总销售额(单位:万元)", fontsize=14, pad=15)
    ax.set_xlabel("商品品类", fontsize=11)
    ax.set_ylabel("销售额(万元)", fontsize=11)
    ax.grid(axis="y", linestyle="--", alpha=0.5)

    # 在柱形上方标注具体数值
    for bar in bars:
        height = bar.get_height()
        ax.annotate(f"{height:.1f}万",
                    xy=(bar.get_x() + bar.get_width() / 2, height),
                    xytext=(0, 3),
                    textcoords="offset points",
                    ha="center", va="bottom", fontsize=10)

    plt.tight_layout()
    plt.savefig(output_chart, dpi=200)
    plt.close()
    print(f"\n分析图表已成功生成并保存至: {output_chart}")

if __name__ == "__main__":
    # 模拟输入路径与图表导出路径
    run_sales_analysis("raw_sales.csv", "category_revenue.png")
在对筛选后的 DataFrame 进行列赋值时(例如 df[df['amount'] > 0]['status'] = 1),常常会触发 Pandas 的 SettingWithCopyWarning。这是因为切片可能返回的是原始数据的“视图”而非独立“副本”,导致赋值行为不可控。正确的做法是明确使用 .copy() 创建独立副本,或使用 df.loc[条件, '目标列'] = 值 进行显式定位修改。
三、Web 开发:快速构建服务接口与业务系统
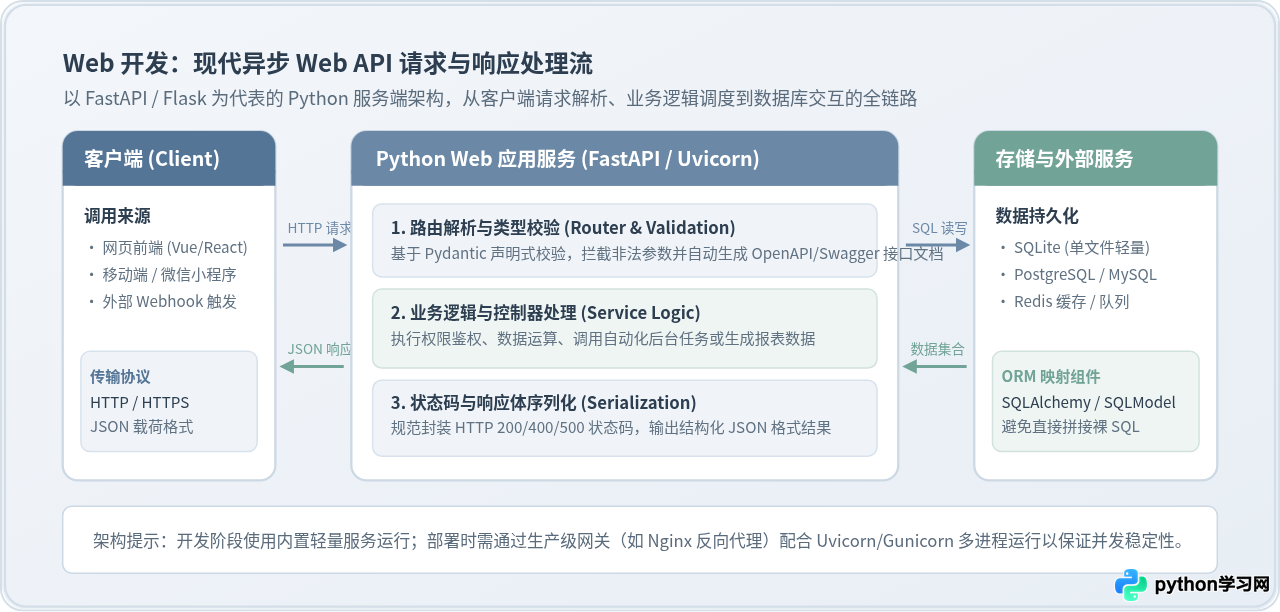
当数据分析的结果或自动化工具需要交付给团队其他成员使用时,本地脚本往往面临安装依赖繁琐、跨操作系统运行不一致的痛点。此时,将逻辑封装为 Web 服务或轻量级后台系统是最理想的交付形态。Python 在 Web 开发领域兼顾了开发敏捷度与高并发处理能力。
主流框架对比与技术选型依据
Python 拥有多款不同侧重点的成熟 Web 框架,根据项目规模与架构诉求可以做出明确选择:
| 框架名称 | 架构类型 | 核心优势 | 典型适用场景 |
|---|---|---|---|
| FastAPI | 现代异步微框架 (ASGI) | 性能媲美 NodeJS/Go、基于类型提示自动生成 OpenAPI 接口文档 | RESTful API 微服务、数据分析模型对外提供查询接口 |
| Flask | 轻量级同步微框架 (WSGI) | 极其简单、核心极小、插件生态极为丰富自由 | 小型业务工具、单页面展示、原型验证与脚本可视化 |
| Django | 全能大而全框架 (Full-stack) | 开箱即用的 Admin 管理后台、内置 ORM、权限认证与安全防护 | 中大型内容管理系统 (CMS)、企业内部综合运营中台 |
完整代码示例:使用 FastAPI 构建业务查询与任务触发 API
以下代码演示如何使用现代 FastAPI 框架快速搭建一个包含参数类型验证、数据查询与异步任务触发的 RESTful 接口服务。
# -*- coding: utf-8 -*-
"""
服务名称: main.py
运行环境: Python 3.8+
依赖安装: pip install fastapi uvicorn pydantic
启动命令: uvicorn main:app --host 127.0.0.1 --port 8000 --reload
"""
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional, List
import datetime

app = FastAPI(
    title="业务报表与数据查询服务",
    description="提供销售数据指标查询及自动化导出任务触发的 Web API",
    version="1.0.0"
)

# 内存模拟数据库记录
DATABASE = [
    {"order_id": "ORD-1001", "customer": "卓越科技", "amount": 12800.0, "status": "COMPLETED"},
    {"order_id": "ORD-1002", "customer": "新远物流", "amount": 8450.0, "status": "PENDING"},
    {"order_id": "ORD-1003", "customer": "华盛商贸", "amount": 25600.0, "status": "COMPLETED"},
]

# 声明请求数据结构模型 (Pydantic 自动进行类型与范围校验)
class TaskCreateRequest(BaseModel):
    task_name: str = Field(..., min_length=2, max_length=50, description="任务名称")
    date_range: str = Field(..., description="统计周期,如 2026-10")
    notify_email: Optional[str] = Field(None, description="接收汇总结果的邮箱")

# 1. GET 接口:根据订单状态查询记录
@app.get("/api/orders", summary="查询订单列表", tags=["订单管理"])
def list_orders(status_filter: Optional[str] = None):
    if status_filter:
        filtered = [item for item in DATABASE if item["status"].upper() == status_filter.upper()]
        return {"code": 200, "data": filtered, "total": len(filtered)}
    return {"code": 200, "data": DATABASE, "total": len(DATABASE)}

# 2. POST 接口:提交自动化报表导出任务
@app.post("/api/tasks/export", status_code=status.HTTP_201_CREATED, summary="创建报表导出任务", tags=["任务调度"])
def create_export_task(payload: TaskCreateRequest):
    # 模拟任务入队与触发
    task_id = f"TASK-{datetime.datetime.now().strftime('%Y%m%d%H%M%S')}"

    return {
        "code": 201,
        "message": "导出任务已提交调度中心",
        "task_id": task_id,
        "task_name": payload.task_name,
        "date_range": payload.date_range,
        "notify_target": payload.notify_email or "未设置邮箱(默认站内下载)"
    }

@app.get("/health", summary="健康检查接口")
def health_check():
    return {"status": "UP", "timestamp": datetime.datetime.now().isoformat()}
在本地开发时,添加 --reload 参数可以监控代码变动自动重启。但在正式生产服务器部署时,绝不能开启该参数。生产环境推荐使用 Gunicorn 管理多个进程,配合 uvicorn.workers.UvicornWorker 工作模式,并在最外层由 Nginx 负责反向代理与静态资源分发,从而保证高并发请求下的吞吐与稳定性。
四、三大方向选型决策与递进学习路线
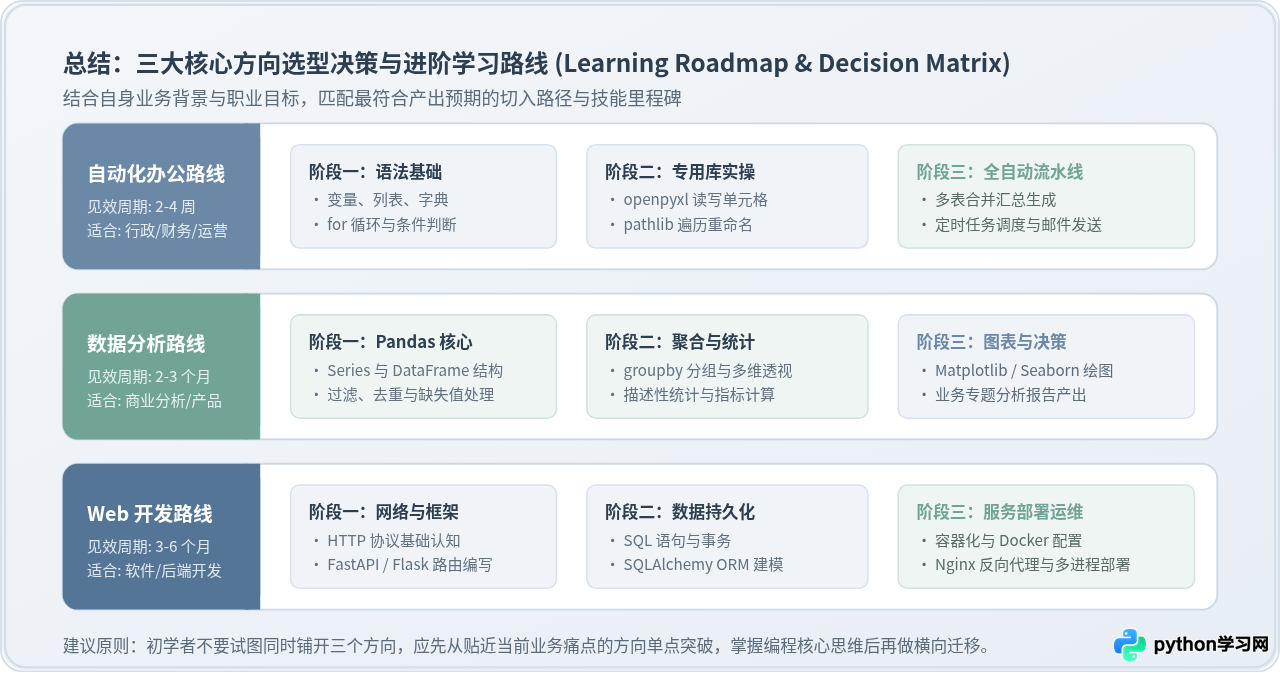
初学 Python 时最容易陷入的误区是“既要又要”:试图在掌握基本语法后,同时学习前端模板、数据可视化、深度学习模型与系统运维。由于各领域的专业背景与工具链深度差异极大,分散精力往往导致每一块都浅尝辄止。
合理的策略是围绕当前自身最紧迫的问题,单点切入并逐步拓展:
- 如果你是非技术岗位(行政/HR/财务/业务运营):优先深耕自动化办公。只需学习 Python 基础语法与
openpyxl、pathlib即可在 2 到 4 周内写出解决手头重复劳动的实用工具,能够立即在实际工作中产生正反馈。 - 如果你是商业分析师、产品经理或经常与报表打交道:直接切入数据分析。以
pandas和业务指标统计为重心,跳过复杂的面向对象设计与算法推导,专注于解决多维清洗、漏斗计算与图表展现。 - 如果你希望成为全栈或后端研发工程师:系统学习 Web 开发。从计算机网络基础(HTTP/TCP)、数据库设计(SQL、事务、索引)学起,结合 FastAPI 或 Django 构建具备用户鉴权、数据持久化与高可用特性的服务端系统。
开发环境准备与安全隔离规范
无论选择哪个方向,都强烈建议在开发之初建立虚拟环境隔离习惯。全局安装所有第三方库极易引发版本冲突或依赖污染。
# 1. 在当前项目根目录下创建专属虚拟环境(目录名为 .venv)
python3 -m venv .venv

# 2. 激活虚拟环境 (macOS / Linux)
source .venv/bin/activate
# 若为 Windows 系统,执行: .venv\Scripts\activate

# 3. 在隔离环境中安全安装所需依赖
pip install --upgrade pip
pip install pandas openpyxl fastapi uvicorn

# 4. 将当前依赖固化为清单文件,方便跨机器协同部署
pip freeze > requirements.txt
通过虚拟环境将每个项目的运行时完全隔离开来,能够确保在后续进行办公脚本分发、数据脚本调度或 Web 接口容器化部署时,均具备高度的一致性与可复现性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









