

Python列表中文排序:怎么使用sort()按拼音或笔画排序
详细讲解在Python中如何使用sort()方法对中文列表进行排序。剖析默认Unicode编码排序的问题,提供使用pypinyin与locale实现拼音排序的具体代码,并给出基于汉字笔画字典的多级笔画排序完整解决方案。
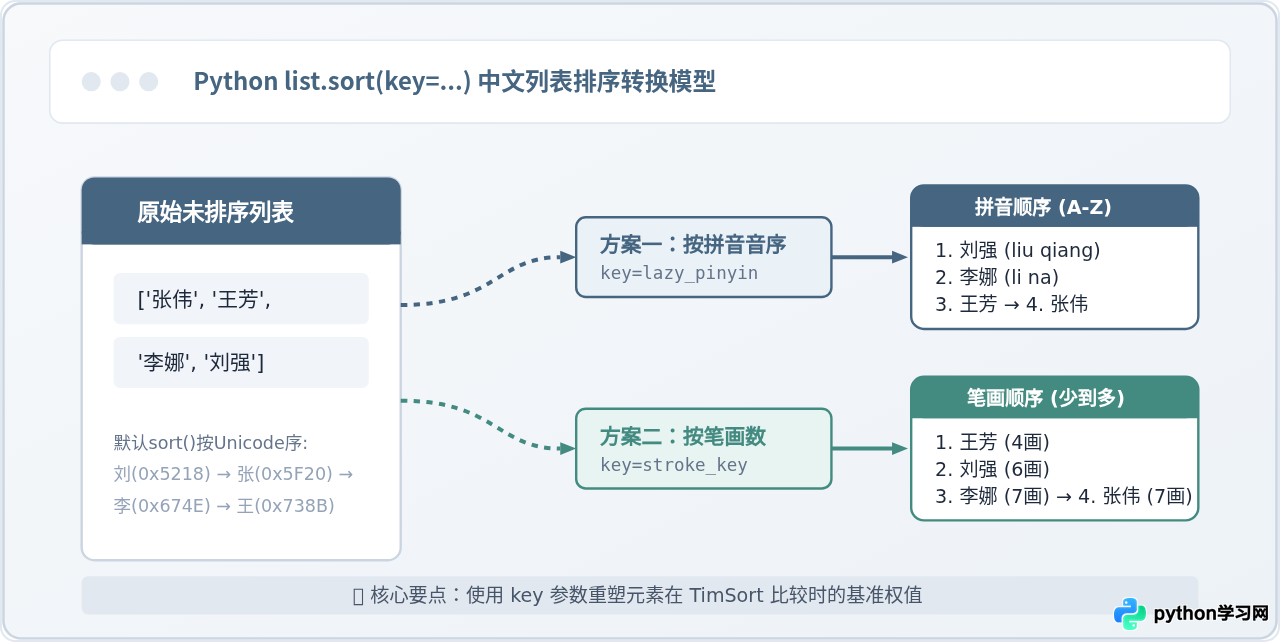
在 Python 中,内置的 list.sort() 和 sorted() 默认依据字符的 Unicode 码点数值大小进行比较,导致中文列表排序既不符合拼音字母顺序,也不符合汉字笔画顺序。要实现符合中文阅读习惯的排序,核心做法是向 sort() 的 key 参数传递一个特征提取函数:按拼音排序时,可通过第三方库 pypinyin 或系统内置的 locale 模块将中文字符转为拼音音序;按笔画排序时,则通过汉字笔画映射表将字符转为由笔画数构成的多级数值元组。
一、为什么默认的 sort() 对中文无效
在 Python 中,如果直接调用 list.sort() 对纯英文字符串排序,结果会严格遵循字典字母顺序(如 A 到 Z)。然而,当对中文列表执行该操作时,往往会产生出乎意料的乱序结果:
# 默认直接排序的示例代码
names = ["张伟", "王芳", "李娜", "刘强", "阿敏"]
names.sort()
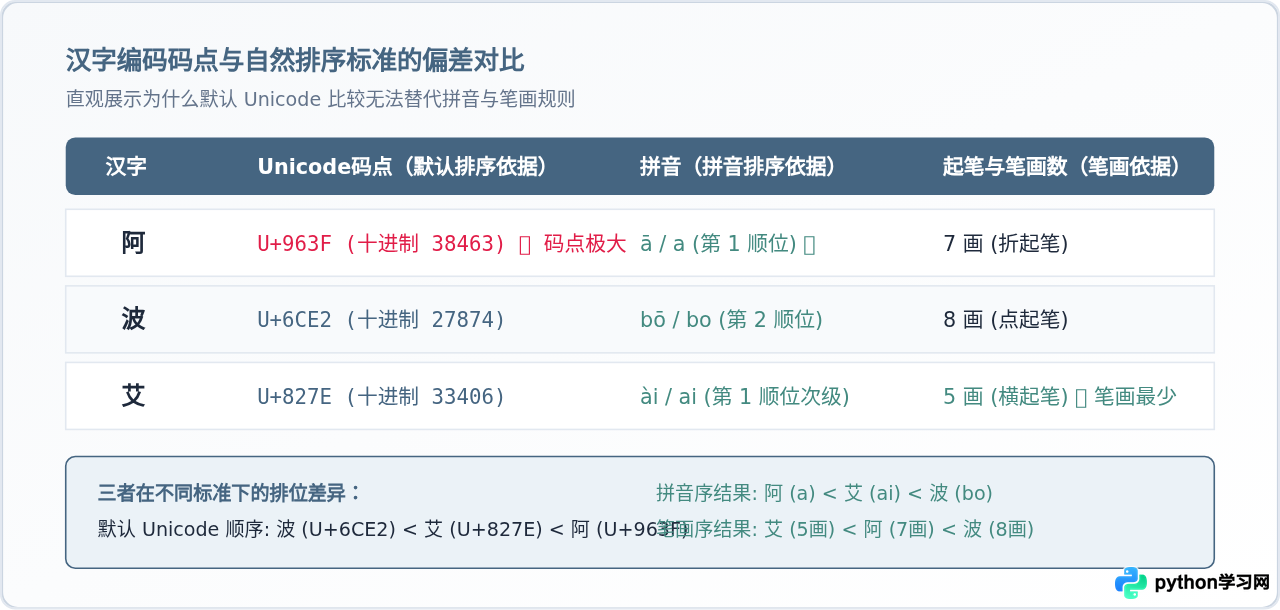
print(names)按照中文拼音习惯,“阿敏”(A)应当排在最前,“张伟”(Z)应当排在最后;按照姓氏笔画习惯,“王芳”(4画)也应在“张伟”(7画)之前。但实际输出中,“刘强”排在首位,“阿敏”反而在最后。
产生这一现象的根本原因在于:Python 内部对于字符串的比对,逐字符采用其 Unicode 码点数值(Code Point)。我们通过内置函数 ord() 查看这几个字符的十进制与十六进制码点:
'刘':码点为0x5218(十进制 21016)'张':码点为0x5F20(十进制 24352)'李':码点为0x674E(十进制 26446)'王':码点为0x738B(十进制 29579)'阿':码点为0x963F(十进制 38463)
Unicode 统一汉字编码表(CJK Unified Ideographs)主要依据部首和历史文献统筹收录,各个汉字的先后次序既不是拼音序,也不是笔画数序。因此,依赖默认比较逻辑,无法满足真实业务对中文次序的要求。
二、使用 sort(key=...) 的排序机制
Python 的 list.sort() 方法支持 key 参数。key 接收一个单参数函数,列表中的每个元素在参与排序比较前,都会先传入该函数计算出一个“特征值”(Key)。排序算法实际比较的是特征值的大小,排序完成后则保留原数据元素。
要实现自定义的中文排序,任务就清晰地拆解为:编写一个映射函数,把每个中文词条转换为代表其拼音或笔画权重的对象(如拼音字符串或由数字构成的元组)。
三、按拼音排序的实现方法
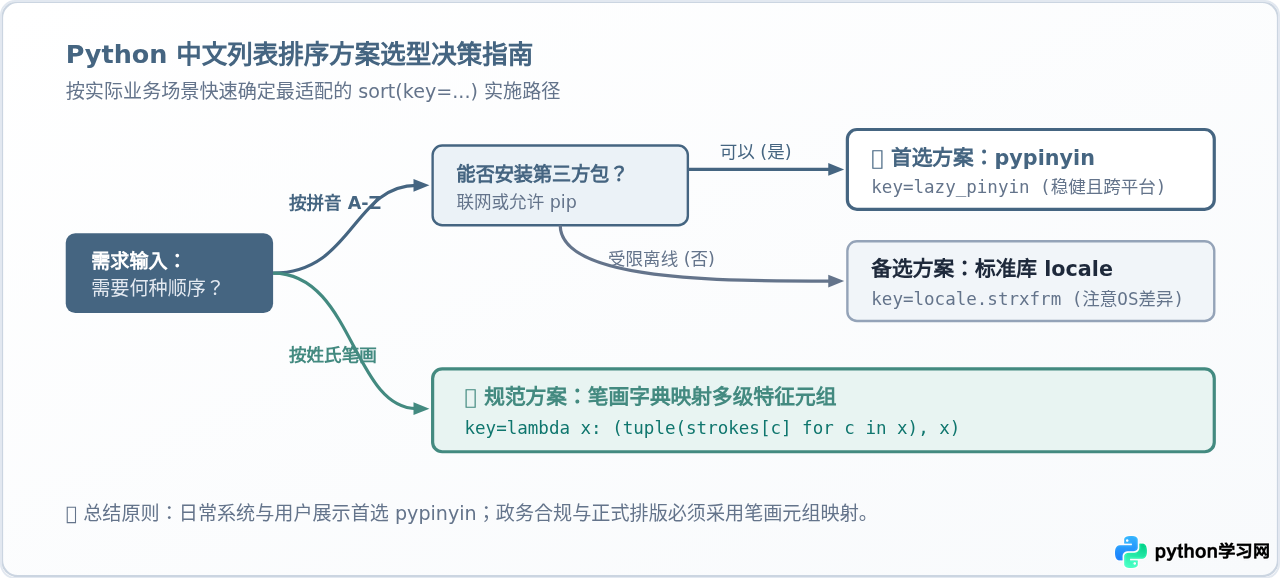
中文拼音排序有两种主流实现途径:一种是使用功能完善、跨平台无差异的第三方库 pypinyin;另一种是利用标准库的 locale 模块调用操作系统的语言环境。
方法 1:使用 pypinyin 库(推荐、跨平台一致)
pypinyin 是 Python 生态中处理汉语拼音的标准库。它能够精准将汉字转换为拼音,并支持音调、声母、韵母及多音字的处理。
首先在环境中安装该库:
pip install pypinyin
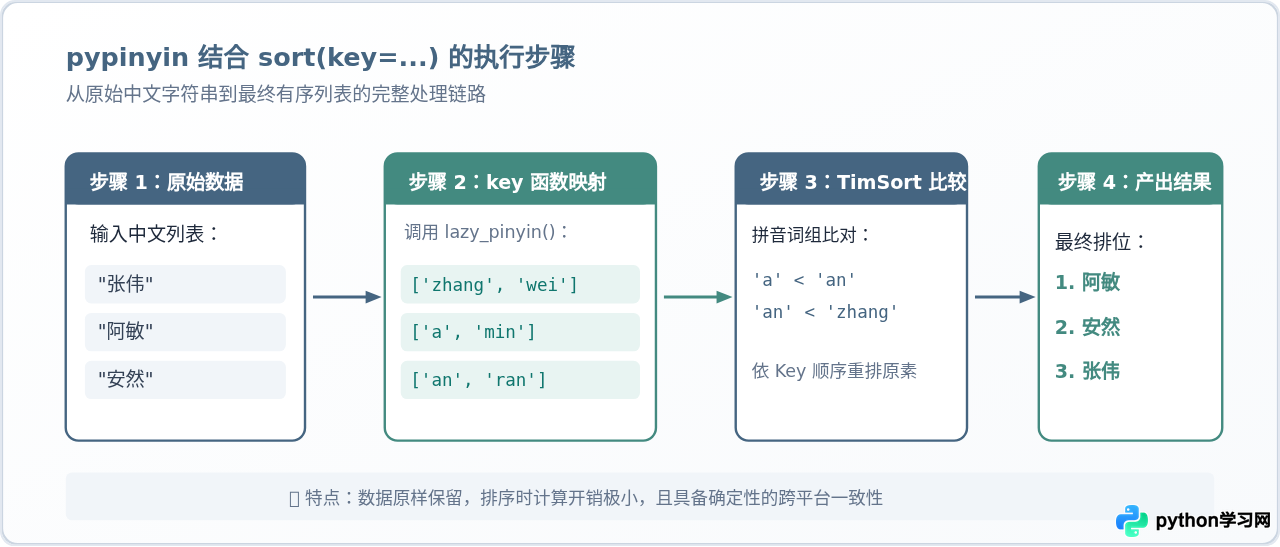
通过 pypinyin.lazy_pinyin 可以将中文字符串转换为拼音列表。将 lazy_pinyin 直接作为 sort(key=...) 的传入参数,即可实现标准的 A 到 Z 拼音升序排列:
from pypinyin import lazy_pinyin

names = ["张伟", "王芳", "李娜", "刘强", "阿敏", "安然"]

# 直接将 lazy_pinyin 函数作为 key 传递给 sort()
names.sort(key=lazy_pinyin)
print(names)对于
"阿敏",lazy_pinyin("阿敏") 返回 ['a', 'min'];对于 "安然",返回 ['an', 'ran']。
在 Python 中,列表之间的比较是按位置依次比对的。首先比较第一个元素的拼音:'a' 字典序小于 'an',因此 "阿敏" 排在 "安然" 前面。整个比对逻辑完全吻合汉语拼音词典规范。
考虑声调的精细拼音排序
当两个词语的无声调拼音完全一致时(例如“李霞”与“李夏”,无声调拼音均为 li xia),若希望进一步按照声调(一声、二声、三声、四声)严格排序,可以使用 Style.TONE3 样式,将声调转化为数字后缀(如 xia2、xia4):
from pypinyin import pinyin, Style

def pinyin_with_tone_key(word):
    # 将每个汉字转换为带声调数字的拼音列表,例如 '霞' -> 'xia2'
    raw = pinyin(word, style=Style.TONE3)
    return [item[0] for item in raw]

names = ["李夏", "李霞", "李峡"]
names.sort(key=pinyin_with_tone_key)
print(names)输出结果中,“峡”(xiá,二声,标记为 xia2)、“霞”(xiá,二声,标记为 xia2)、“夏”(xià,四声,标记为 xia4)实现了声调层面的精确排布。
方法 2:使用标准库 locale(无外部依赖)
如果运行环境处于严格受限的离线服务器,不允许通过 pip 安装第三方库,可以采用 Python 标准库提供的 locale 模块。
locale.strxfrm 会根据当前进程设置的区域字符规则,将字符串转译为一个用于直接比较的系统字节序列。代码如下:
import locale

# 设置区域为简体中文 UTF-8
locale.setlocale(locale.LC_COLLATE, 'zh_CN.UTF-8')

names = ["张伟", "王芳", "李娜", "刘强", "阿敏"]
names.sort(key=locale.strxfrm)
print(names)locale 的有效性高度依赖操作系统底层安装的语言包支持:
- 在 Linux 和 macOS 下,通常配置为
'zh_CN.UTF-8'或'zh_CN';若宿主机为精简版 Alpine Docker 镜像且未安装对应 locale 数据,运行setlocale会直接抛出locale.Error: unsupported locale setting异常。 - 在 Windows 操作系统中,区域字符串名称通常为
'Chinese_China.936'或'chs',与 POSIX 系统命名不兼容。
pypinyin。
四、按笔画排序的实现方法
在诸多正式场景(例如政府公文、选举投票名单、学术会议代表花名册、出版物编委会名单)中,中文姓名通常要求按照“姓氏笔画为序”进行排列。
Unicode 和 Python 标准库均未直接附带每个汉字的笔画属性。要实现按笔画排序,需要引入汉字到笔画数的映射表。
1. 笔画排序的规则体系
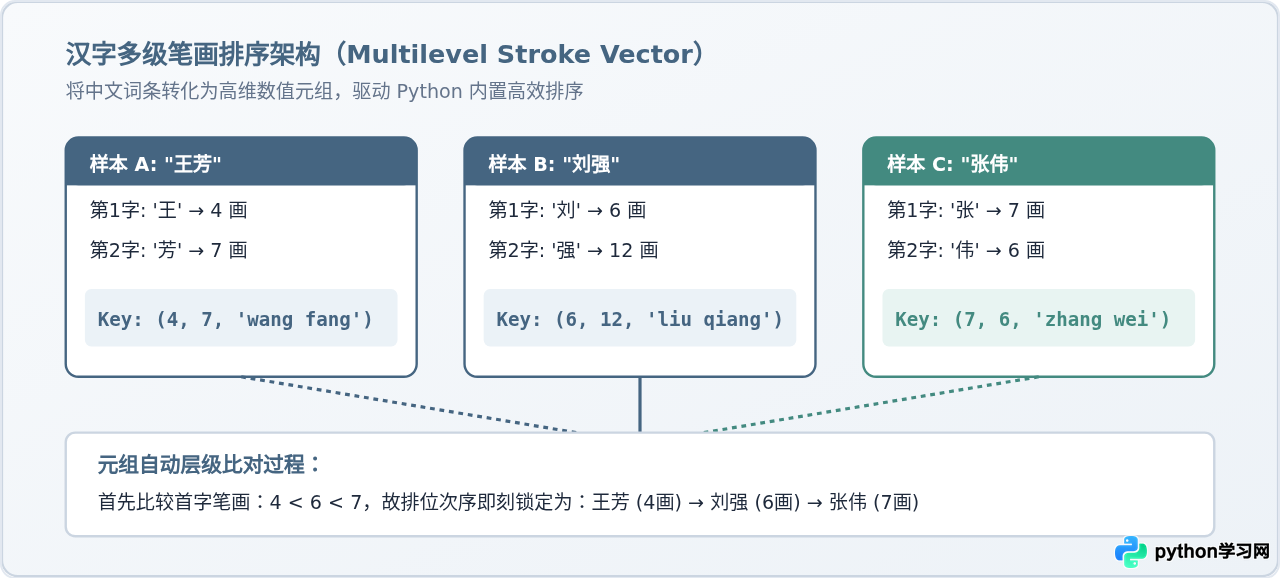
标准汉字笔画排序通常遵循以下三级比较规则:
- 第一级(首字笔画数):汉字笔画较少的字排在前面(如“王”4画排在“张”7画前)。
- 第二级(后续字笔画数):首字笔画相同时,依次比较第二字、第三字的笔画数。
- 第三级(同笔画平局决胜):各字笔画数均完全相同的情况下,按国家规范的笔形顺序(横、竖、撇、点、折)或汉语拼音字母顺序决胜。
2. 笔画排序的完整代码实现
下面我们构建一个具备实用性的笔画排序示例。在实际项目中,笔画数据库通常存储于 JSON 文件或 SQLite 中(覆盖常用 3500 到 7000 个现代汉语常用字)。代码中使用字典封装常用字笔画数,并构建复合元组作为 key:
# 常用汉字笔画映射字典(节选代表性汉字)
STROKE_DICT = {
    '丁': 2, '七': 2,
    '三': 3, '于': 3, '万': 3,
    '王': 4, '云': 4, '井': 4, '方': 4,
    '白': 5, '立': 5, '包': 5,
    '刘': 6, '华': 6, '伟': 6, '江': 6,
    '李': 7, '张': 7, '陈': 7, '吴': 7, '芳': 7,
    '周': 8, '林': 8, '赵': 8, '金': 8,
    '胡': 9, '柯': 9, '钟': 9,
    '徐': 10, '高': 10, '郭': 10,
    '黄': 11, '曹': 11, '梁': 11,
    '强': 12, '彭': 12,
}

def get_char_strokes(char):
    """查询单个汉字的笔画数,未收录字符返回极大值以排在末尾"""
    return STROKE_DICT.get(char, 99)

def stroke_sort_key(word):
    """
    构造笔画排序特征值元组:
    第一部分:每个字的笔画数元组,例如 "王芳" -> (4, 7)
    第二部分:词条本身,用于笔画数完全相同时保持确定性
    """
    strokes = tuple(get_char_strokes(char) for char in word)
    return (strokes, word)

names = ["张伟", "王芳", "李芳", "刘强", "白立", "丁一"]
# 执行排序
names.sort(key=stroke_sort_key)
print(names)通过该输出,各名字首字笔画依次为:丁(2画)< 王(4画)< 白(5画)< 刘(6画)< 李(7画)与 张(7画)。对于“李芳”与“张伟”,两者首字笔画相同(7画),接着比较第二字笔画:芳(7画)与 伟(6画),因而“张伟”紧随“李芳”。
若要覆盖全量通用规范汉字(8105 字),可以借助开源工具(例如
cn-strokes 或基于《现代汉语通用字笔顺规范》的数据文件),在服务启动时一次性加载为全局查找字典或 Trie 树,从而确保零额外运行时负担。
五、两种排序模式的综合对比与选型指南
根据项目要求与受众习惯,选择正确的中文排序逻辑至关重要。下表梳理了各类方案的核心差异:
| 排序维度 | 推荐方案 | 外部依赖 | 性能与平台兼容性 | 典型应用场景 |
|---|---|---|---|---|
| 按汉语拼音 | pypinyin |
需要 pip install pypinyin |
高性能,纯 Python / 跨平台行为完全一致 | 手机联系人列表、电商商品目录、字典检索 |
| 按拼音(无依赖) | locale.strxfrm |
标准库自带(零依赖) | 依赖宿主机 OS 语言包,跨平台存在差异 | 受限无外网环境、脚本轻量单机运行 |
| 按汉字笔画 | 汉字笔画字典映射元组 | 需外置笔画表(可打包进项目) | 字典哈希查找,执行极快,确定性强 | 党政机关公文、红头文件、选举投票花名册 |
六、核心总结与注意事项
-
不要原地直接
list.sort():直接排序只能得到无语义的 Unicode 码点顺序。务必传递key参数。 -
区分原地排序与新列表生成:
names.sort(key=...)会在原列表上原地修改,返回值为None;如果需要保留原列表不变并生成一个排好序的新列表,应使用sorted(names, key=...)。 -
多音字的边界情况:人名中存在罕见多音字(如“单”、“区”、“查”作为姓氏时分别读 shàn、ōu、zhā)。若应用场景对姓名准确性要求极高,
pypinyin支持自定义词典注入(通过load_single_dict或load_phrases_dict),可以在调用排序前精准修正姓氏发音。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









