

Python汉诺塔递归算法的时间复杂度为什么是O(2^n)
深入剖析Python汉诺塔递归算法的时间复杂度为什么是O(2^n)。结合Python完整代码、三步递归分治拆解、递推方程代换展开求解、满二叉递归树可视化以及运行计数实测,彻底讲透指数级复杂度的数学成因与物理下界。
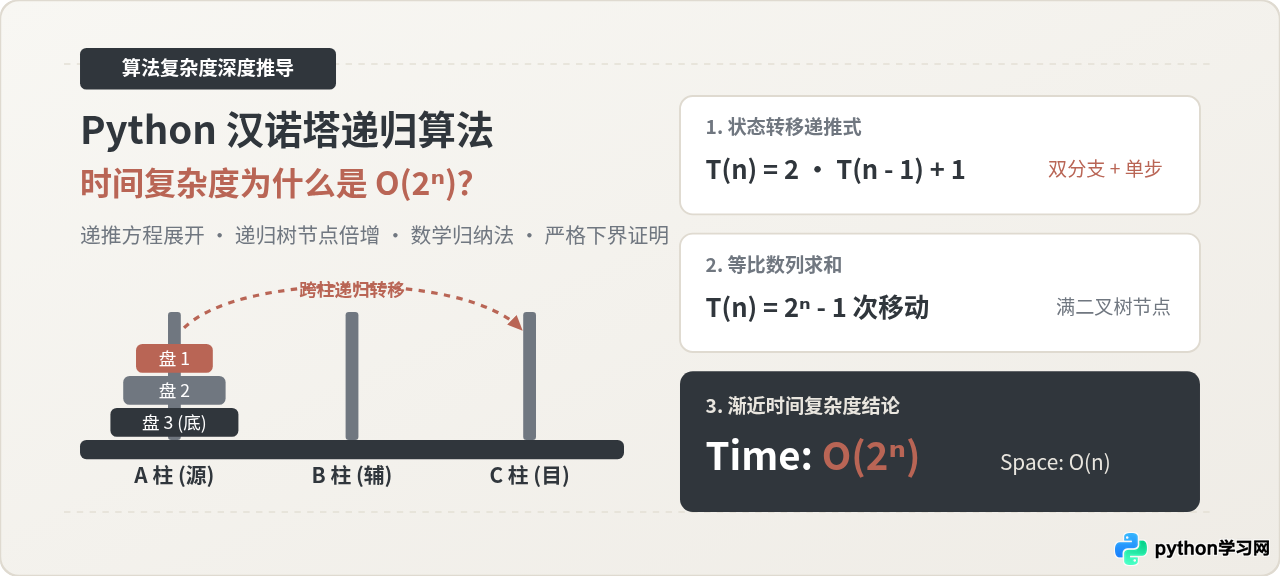
n 个圆盘的汉诺塔问题时,经典的 Python 递归算法每处理一个规模为 n 的问题,都必须将其分解为两个规模为 n - 1 的递归子任务和一次底盘移动。这构成了严格的状态递推方程 T(n) = 2T(n - 1) + 1。通过代换展开求和可知,总移动步数精确等于 2ⁿ - 1。由于每次移动盘子的操作开销为常数 O(1),忽略低阶项和常数系数后,整个算法的时间复杂度就是严格的 O(2ⁿ)。
一、汉诺塔问题的核心规则与 Python 递归实现
汉诺塔(Tower of Hanoi)源自古印度传说:三根立柱分别记为源柱(Source)、目标柱(Target)与辅助柱(Auxiliary)。在源柱上自下而上按直径由大到小叠放着 n 个圆盘。求解该问题必须严格遵循以下三条规则:
- 每次只能将某一根立柱最顶端的一个圆盘移动到另一根立柱上;
- 在任何移动过程中,三根柱子上的圆盘都必须保持“大盘在下、小盘在上”的秩序,绝不能出现大盘置于小盘之上的情况;
- 最终必须将所有
n个圆盘完整迁移到目标柱上。
当圆盘数达到 n 时,表面上看移动步骤错综复杂,但在分治思维(Divide and Conquer)的视角下,无论盘子总数多大,要把最大的第 n 个底盘从源柱移到目标柱,其上方压着的 n - 1 个小盘子必须先全部被移走,且它们只能暂存到唯一的辅助柱上。
基于这种逻辑,Python 的递归求解实现极其精炼:
def hanoi(n: int, source: str, target: str, auxiliary: str) -> None:
    """
    汉诺塔经典分治递归算法
    :param n: 当前需要转移的圆盘数量
    :param source: 起始柱(源柱)
    :param target: 目标柱
    :param auxiliary: 中转柱(辅助柱)
    """
    # 递归出口(Base Case):只剩 1 个圆盘时,直接移动并返回
    if n == 1:
        print(f"移动盘 1: {source} -> {target}")
        return

    # 步骤 1:将前 n-1 个盘子从 source 借助 target 移到 auxiliary
    hanoi(n - 1, source, auxiliary, target)

    # 步骤 2:将底层的第 n 个盘子直接从 source 移到 target
    print(f"移动盘 {n}: {source} -> {target}")

    # 步骤 3:将 n-1 个盘子从 auxiliary 借助 source 移到 target
    hanoi(n - 1, auxiliary, target, source)
观察上述 Python 代码结构,核心逻辑由三个连续操作组成。为了帮助初学者彻底看清算法骨架,我们将这三个操作映射为图 1 中的分治转移流程。
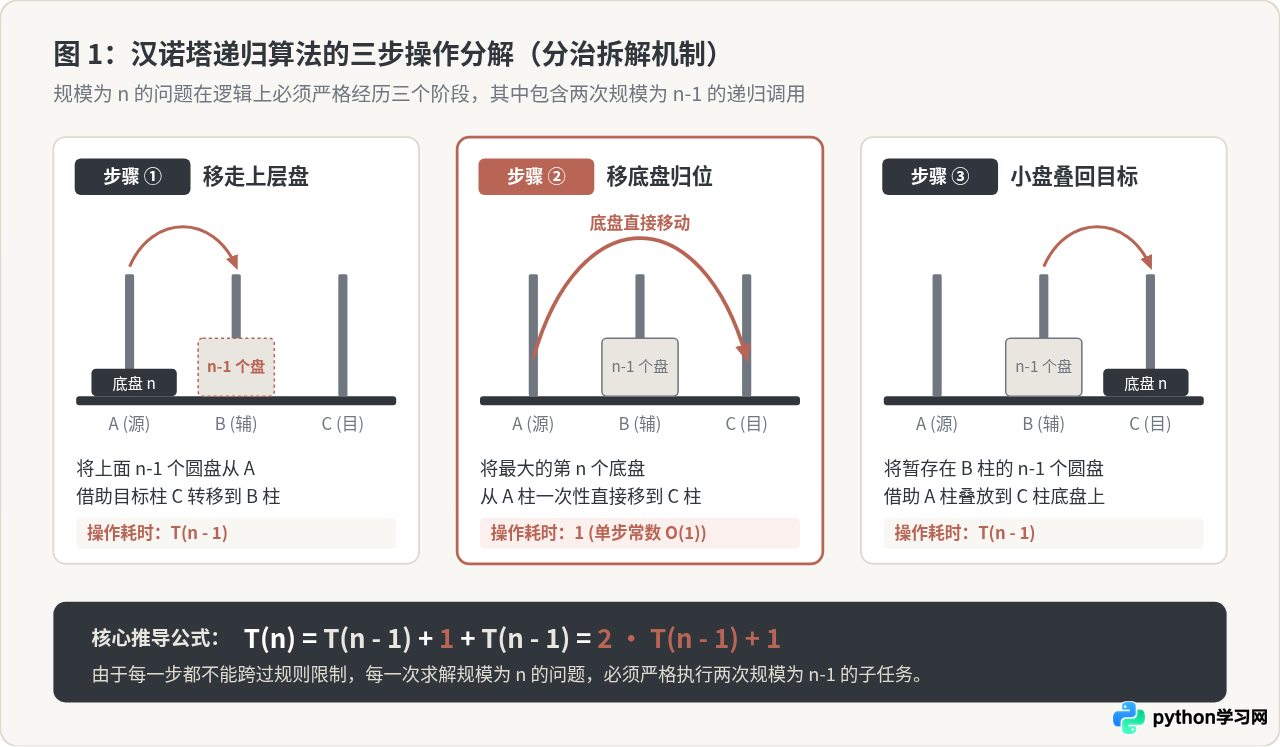
从图 1 可以清晰看到,代码中的每一次 hanoi(n) 调用都明确触发了:
- 一次规模为
n - 1的前置递归转移; - 一次单步移动输出操作(仅耗费
O(1)时间); - 一次规模为
n - 1的后置递归转移。
二、建立递推方程——从代码执行到数学模型
在算法分析中,我们用函数 T(n) 表示移动 n 个盘子所需的总基本操作次数(在 Python 代码中对应 print 打印移动指令的次数)。
当 n = 1 时,函数直接命中基准条件(Base Case),只需要做 1 次移动即可结束:
当 n > 1 时,根据代码中的三大操作步骤,总步数由两部分构成:两次对规模为 n - 1 的子问题的递归求解,加上 1 次底盘的实际移动。因此得到经典的状态转移递推方程:
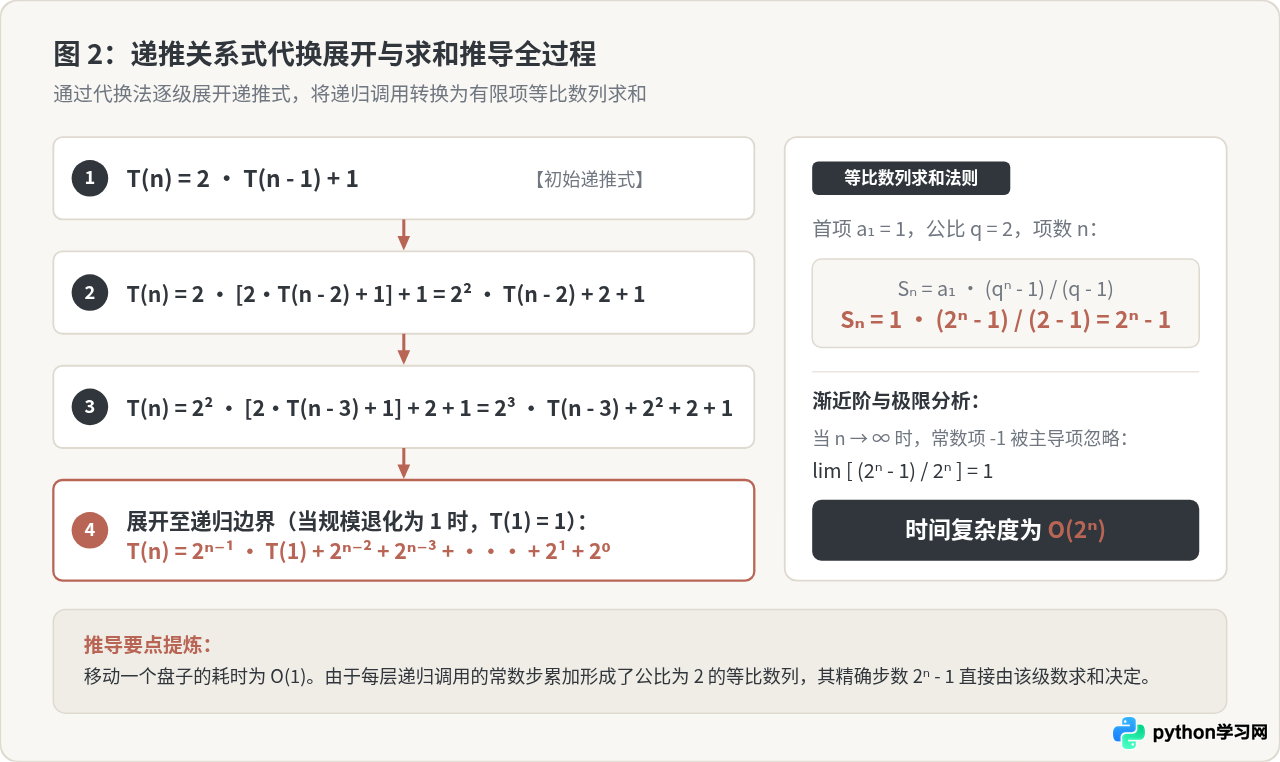
如何求解这个非齐次一阶线性递推方程?最直观且严格的方法是代换展开法(Iteration / Expansion Method)。图 2 详细拆解了这一展开与求和推导的完整链路。
代换展开法的逐步推导过程
我们将递推式反复代入自身,观察项与幂次的变化规律:
T(n) = 2 · T(n - 1) + 1
第 2 步代入 T(n-1) = 2·T(n-2) + 1:
T(n) = 2 · [2 · T(n - 2) + 1] + 1
= 2² · T(n - 2) + 2¹ + 2⁰
第 3 步代入 T(n-2) = 2·T(n-3) + 1:
T(n) = 2² · [2 · T(n - 3) + 1] + 2¹ + 2⁰
= 2³ · T(n - 3) + 2² + 2¹ + 2⁰
依此类推,将方程持续展开 k 步,其通用形式为:
当展开进行到第 k = n - 1 步时,括号内的参数退化为递归出口 T(n - (n - 1)) = T(1) = 1。代入可得:
= 2ⁿ⁻¹ + 2ⁿ⁻² + 2ⁿ⁻³ + ··· + 2¹ + 2⁰
这正是一个首项 a₁ = 1、公比 q = 2、总项数为 n 的标准等比数列求和。根据等比数列求和公式:
因此,移动 n 个盘子的精确操作次数为:
大 O 渐近阶确认
根据大 O 阶的数学定义,当 n → ∞ 时,常数项 -1 对增长速度的影响可以忽略。我们求两者比值的极限:
这从数学上严格确立了:Python 汉诺塔递归算法的时间复杂度为 O(2ⁿ)。
三、递归调用树剖析——指数级调用的几何根源
除了公式展开,理解递归复杂度的另一种更具几何直觉的方式是递归树(Recursion Tree)。
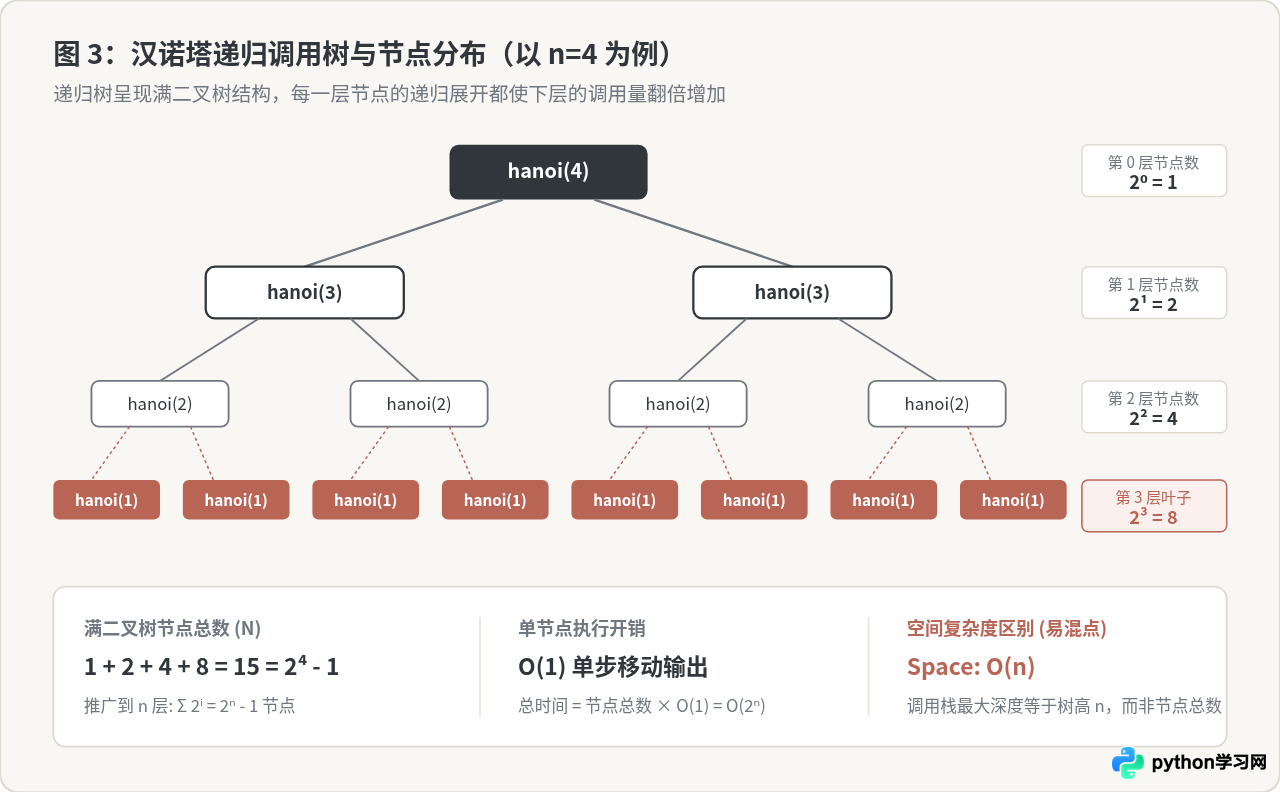
在函数执行过程中,每次调用 hanoi(n) 都会产生两个子调用 hanoi(n-1)。这意味着汉诺塔的调用结构本质上是一棵满二叉树(Full Binary Tree)。
逐层节点数统计
如图 3 所示,从根节点向下观察这棵调用树的层级结构:
- 第 0 层(根节点):只有 1 个调用
hanoi(n),节点数为2⁰ = 1; - 第 1 层:分裂为 2 个调用
hanoi(n-1),节点数为2¹ = 2; - 第 2 层:再各自裂变,得到 4 个
hanoi(n-2),节点数为2² = 4; - 第 i 层:调用节点数以 2 为底按指数级分裂,节点数为
2ⁱ; - 第 n-1 层(叶子层):达到递归出口
hanoi(1),共有2ⁿ⁻¹个叶子节点。
整棵二叉树的所有节点总数即为各层节点数之和:
树中的每一个节点在函数体内只做两件事:判断 n == 1,以及执行单次 print 输出。这两个操作都是单步完成的,耗费 O(1) 常数时间。将所有节点的运行时间累加,总时间就是 (2ⁿ - 1) × O(1) = O(2ⁿ)。
很多初学者误以为既然递归树上有 2ⁿ - 1 个节点,系统占用的内存空间也就是 O(2ⁿ)。这是极其严重的误区!
计算机在执行递归时采用的是深度优先搜索(DFS)机制。在任意一个特定时间点,程序只沿调用树的一条单一路径向下执行。当左子树执行完毕出栈释放后,才会进入右子树。
因此,Python 函数调用栈(Call Stack)在内存中同时存在的最大活动栈帧数量,等于递归树的最大深度 n。所以,该算法的辅助空间复杂度仅为 O(n),绝非 O(2ⁿ)。
四、Python 实测验证——计数器与时间倍增规律
理论推导给出了 T(n) = 2ⁿ - 1 的结论,我们可以在 Python 中加入步数计数器与调用计数器,实际运行代码进行量化验证。
class HanoiTracker:
    def __init__(self):
        self.move_count = 0  # 实际移动盘子步数
        self.call_count = 0  # 函数递归调用总次数

    def solve(self, n: int, src: str, dst: str, aux: str) -> None:
        self.call_count += 1
        if n == 1:
            self.move_count += 1
            return
        self.solve(n - 1, src, aux, dst)
        self.move_count += 1
        self.solve(n - 1, aux, dst, src)

# 运行测试:观察 n 从 1 到 10 的数据表现
tracker = HanoiTracker()
print(f"{'n':<4}{'实际步数':<10}{'理论步数(2^n-1)':<16}{'总调用次数':<12}{'步数倍率':<10}")
print("-" * 52)

prev_moves = 0
for n in range(1, 11):
    tracker.move_count = 0
    tracker.call_count = 0
    tracker.solve(n, "A", "C", "B")
    theory = (2 ** n) - 1
    ratio = f"{tracker.move_count / prev_moves:.2f}x" if prev_moves > 0 else "-"
    print(f"{n:<4}{tracker.move_count:<10}{theory:<16}{tracker.call_count:<12}{ratio:<10}")
    prev_moves = tracker.move_count
运行上述测试脚本,输出的标准量化数据如表 1 所示:
| 盘数 n | 实际移动步数 | 理论步数公式 (2ⁿ - 1) | 总调用次数 | 步数递增倍率 |
|---|---|---|---|---|
| 1 | 1 | 2¹ - 1 = 1 | 1 | - |
| 2 | 3 | 2² - 1 = 3 | 3 | 3.00x |
| 3 | 7 | 2³ - 1 = 7 | 7 | 2.33x |
| 4 | 15 | 2⁴ - 1 = 15 | 15 | 2.14x |
| 5 | 31 | 2⁵ - 1 = 31 | 31 | 2.07x |
| 6 | 63 | 2⁶ - 1 = 63 | 63 | 2.03x |
| 7 | 127 | 2⁷ - 1 = 127 | 127 | 2.02x |
| 8 | 255 | 2⁸ - 1 = 255 | 255 | 2.01x |
| 9 | 511 | 2⁹ - 1 = 511 | 511 | 2.00x |
| 10 | 1023 | 2¹⁰ - 1 = 1023 | 1023 | 2.00x |
实测结果完全印证了我们的理论推导:
- 精确契合性:无论
n取何值,实际移动步数与理论公式2ⁿ - 1100% 吻合,调用次数也精确等于2ⁿ - 1; - 渐近倍增规律:观察最后一列的增长倍率,随着
n的增大,后一项与前一项的比值迅速逼近2.00x。这正是指数底数2的现实体现——圆盘数每仅仅增加 1,算法的整体计算耗时就精确地翻一倍!
五、为什么不存在多项式时间解法?(算法下界与指数爆炸)
很多程序员在接触到 O(2ⁿ) 算法时,第一反应往往是:“这是不是因为递归写得太慢了?如果用循环、位运算或者动态规划,能不能把它优化到 O(n) 或 O(n²)?”
答案是:绝对不可能!因为 2ⁿ - 1 是汉诺塔移动操作的数学理论下界(Theoretical Lower Bound, Ω(2ⁿ))。
最优性数学归纳证明
我们可以用数学归纳法证明:任何遵循规则的合法算法,要将 n 个圆盘转移到目标柱,至少需要 2ⁿ - 1 步。
- 基础步(n=1):显然至少需要移动 1 次,
2¹ - 1 = 1,结论成立; - 归纳假设:假设移动
k个盘子至少需要2ᵏ - 1步; - 归纳递推:考虑
k + 1个盘子的场景。底部的最大盘必须从 A 移到 C。但在最大盘移动之前,上方的k个盘子必须全部位于某根辅助柱上(否则最大盘无法取出,或者目标柱上有小盘遮挡导致大盘不能放入)。根据归纳假设,转移这k个小盘至少耗费2ᵏ - 1步。接着移动底盘耗费 1 步。最后,必须再将这k个小盘从辅助柱转移到目标柱上,根据归纳假设这又至少需要2ᵏ - 1步。 - 因此,总移动步数下界为:
(2ᵏ - 1) + 1 + (2ᵏ - 1) = 2 · 2ᵏ - 1 = 2ᵏ⁺¹ - 1。结论对k + 1同样成立。
这表明,递归代码之所以慢,不是代码写得拙劣,而是问题本身的输出规模天然就是指数级的。只要要求程序给出每一步的操作步骤,输出规模就是 2ⁿ - 1 行,任何算法的时间复杂度下界必然是 Ω(2ⁿ)。
为什么归并排序也是分治递归,却是 O(n log n)?
这也是一道极具启发性的对比思考题:
- 归并排序(Merge Sort):每次将问题规模减半,即划分为两个规模为
n / 2的子问题,递推式为T(n) = 2T(n / 2) + O(n)。因为问题规模每次呈几何级数缩小,递归树的深度只有log n层,最终时间复杂度为高效的O(n log n)。 - 汉诺塔递归(Hanoi):每次问题规模仅仅减少 1,即划分为两个规模为
n - 1的子问题,递推式为T(n) = 2T(n - 1) + 1。这导致递归树深度高达n层,且整棵树没有任何剪枝,每一层都满员展开,最终导致调用总量呈2ⁿ爆炸式爆发。
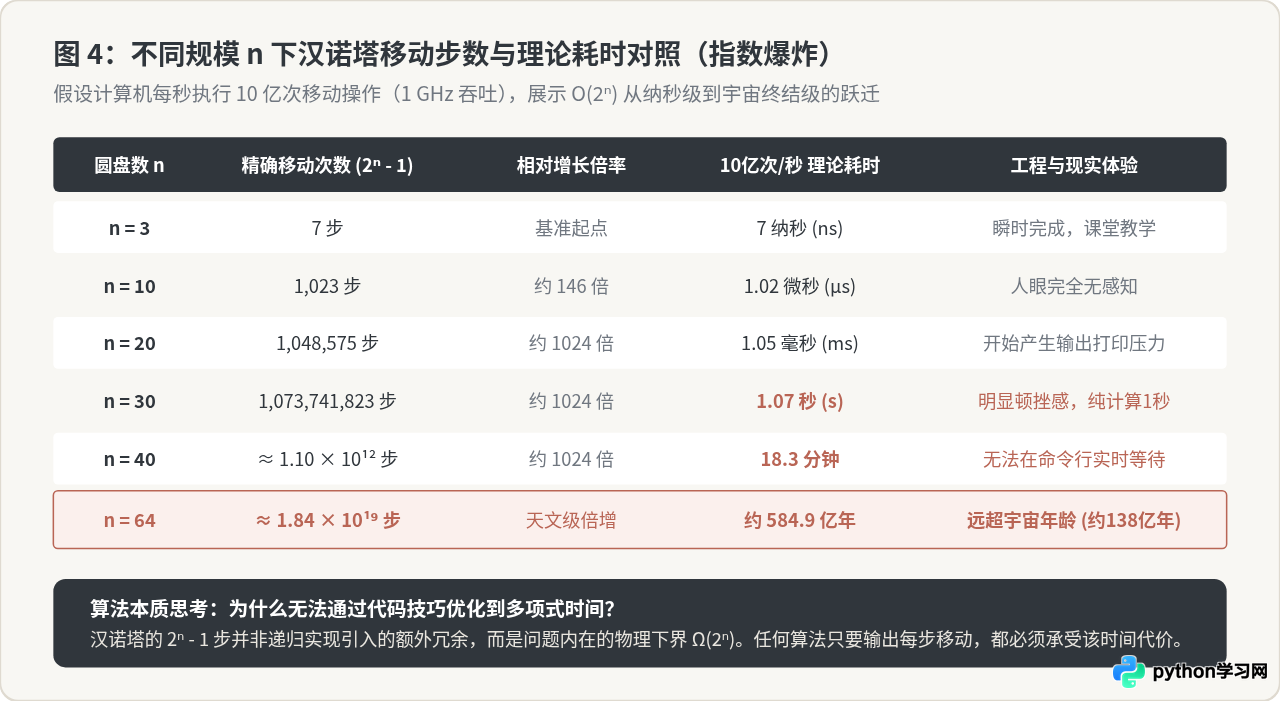
现实中的指数爆炸:64个圆盘的传说
在汉诺塔的印度传说中,神庙里有 64 个纯金圆盘。僧侣们夜以继日地搬动它们,预言说当 64 个盘子全部移至目标柱时,世界便将终结。
从图 4 的现实对照表中我们可以量化这个神话:
哪怕不靠人工,而是借助现代顶级 CPU,以每秒钟执行 10 亿次移动(1 GHz 持续吞吐)的高速持续运转,完成 64 个圆盘的全部搬移,所耗费的时间也高达:
而目前现代天文学测得的宇宙总年龄大约只有 138 亿年。也就是说,完成 64 阶汉诺塔所需的时间是宇宙至今历史的 4 倍以上!这就是指数级复杂度 O(2ⁿ) 在现实世界中的骇人威力。
六、核心总结与避坑速查
汉诺塔问题是计算机科学中最纯粹、最具代表性的指数级递归模型。理解它的时间复杂度,是建立算法复杂度直觉的重要基石。我们将本文的核心要点梳理如下:
| 分析维度 | 结论 / 表达式 | 说明与物理意义 |
|---|---|---|
| 递推状态方程 | T(n) = 2T(n-1) + 1 |
每次求解必须先移走前 n-1 盘,移底盘,再回移 n-1 盘 |
| 精确操作步数 | 2ⁿ - 1 步 |
首项为 1、公比为 2 的等比数列求和结果 |
| 时间复杂度 | O(2ⁿ) | 满二叉递归树节点总数,单节点操作耗时 O(1) |
| 空间复杂度 | O(n) | 系统递归栈的最大深度等于树高 n,切勿混同于时间复杂度 |
| 算法理论下界 | Ω(2ⁿ) | 由数学归纳法证明的最优步数,任何算法均无法突破此限制 |
| 规模递增规律 | 步数翻倍加一 | 圆盘数每增加 1,计算耗时与步数精确翻倍(2(2ⁿ⁻¹ - 1) + 1 = 2ⁿ - 1) |
总结来说,Python 汉诺塔递归算法之所以展现出 O(2ⁿ) 的时间复杂度,其根本原因在于分治策略的子任务划分规模为 n - 1 而非 n / 2。这种“每次分支翻倍、规模仅衰减 1”的结构,形成了深度为 n 的完全二叉展开树。正是这种几何级数的节点膨胀,最终铸就了指数级的时间复杂度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









