

主流Python AI库功能地图:TensorFlow、PyTorch与Scikit-learn分别能做什么
全面解析主流Python AI库Scikit-learn、PyTorch与TensorFlow的核心定位、功能边界、运行机制与选型依据,涵盖表格数据分析、深度学习模型研发及工业级部署全流程。
一、三大主流 AI 库定位分工与全景地图
很多开发者初学 Python 人工智能时容易陷入选择误区,例如盲目使用深度学习框架跑表格分类任务,或者尝试用 Scikit-learn 去训练卷积神经网络。要合理选型,首先需要明确三者在计算抽象层级、数据模态偏好与计算资源需求上的分工差异。
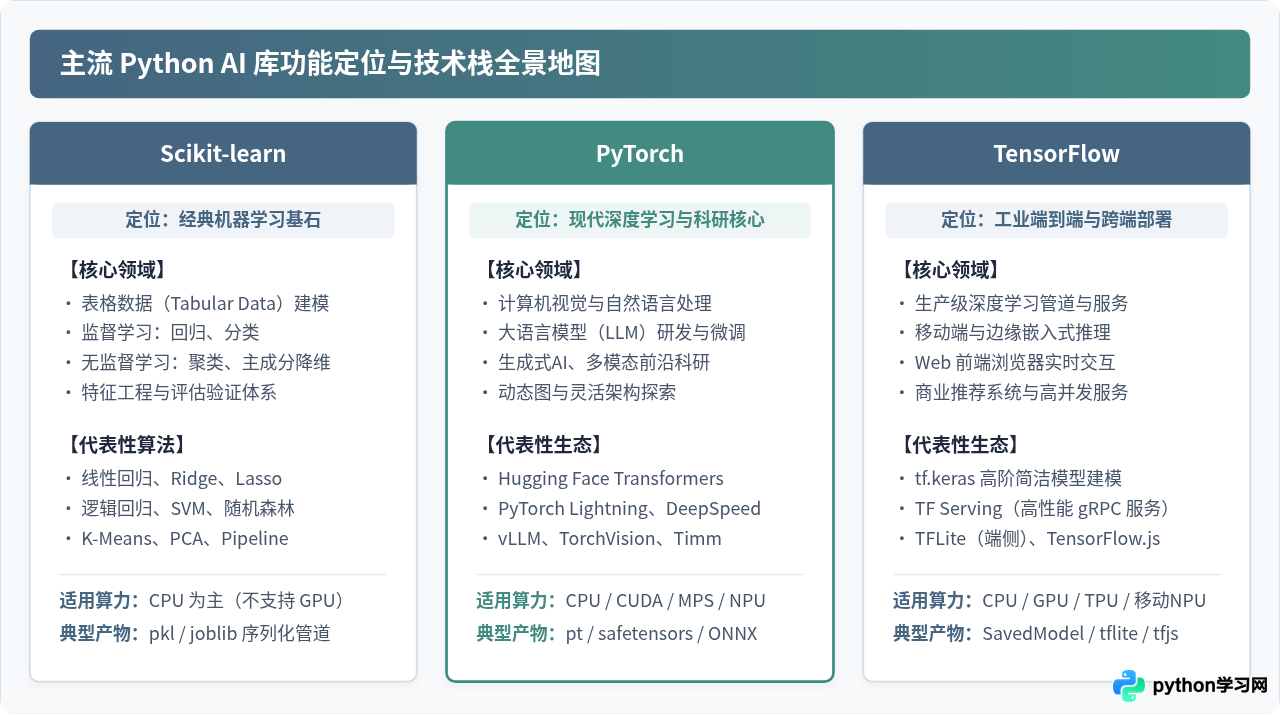
从底层计算逻辑来看:
- Scikit-learn 构建在 NumPy、SciPy 与 Cython 之上,面向中央处理器(CPU)优化,专注单机高内聚运算,不提供自动微分机制,也不支持 GPU 加速。
- PyTorch 是现代张量(Tensor)计算引擎与动态自动微分(Autograd)系统的集合体,与 NVIDIA CUDA、AMD ROCm、Apple MPS 等异构硬件深度绑定,主要解决高维非结构化数据(图像、文本、音频)的特征表征与复杂神经网络训练。
- TensorFlow 以计算图为底层支撑,配合 XLA 编译器和专门为分布式算力(GPU/TPU)打造的运行时,强调端到端从数据输入流水线到多端编译发布的完整闭环。
二、Scikit-learn 能做什么:经典机器学习与特征工程基石
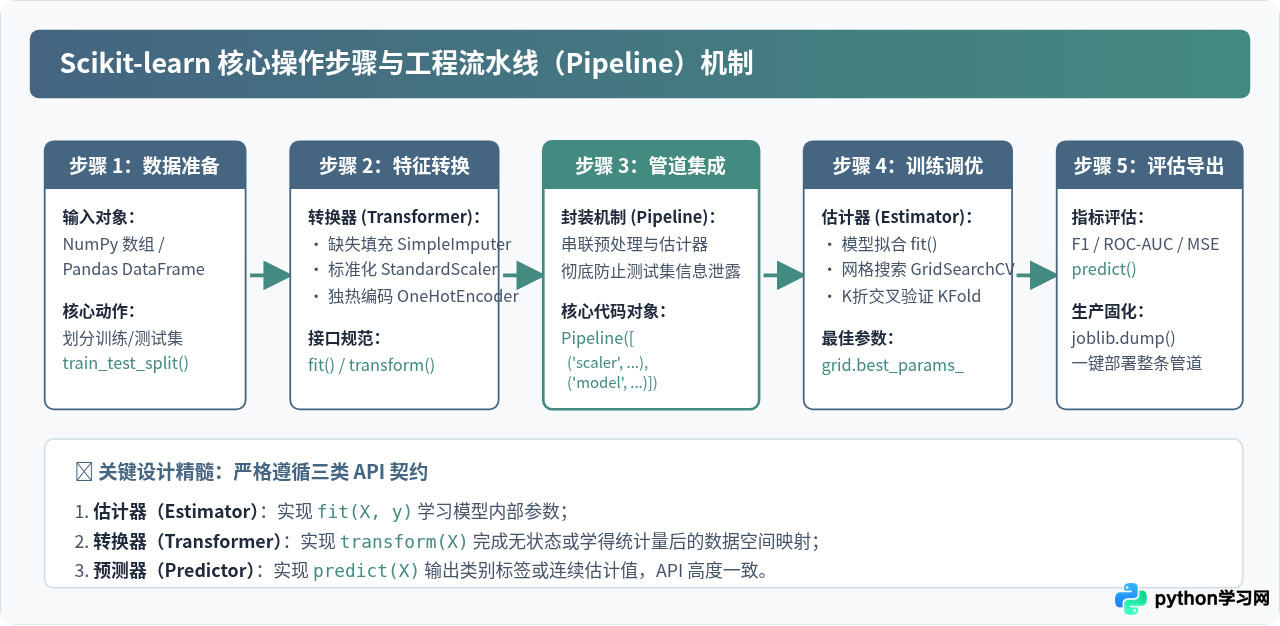
Scikit-learn 是处理结构化表格数据(如 Excel 表格、SQL 数据集、用户行为日志)的第一选择。它覆盖了从数据清洗、特征缩放、降维筛选到统计分类和回归模型的全部标准环节,其最大的优势在于极度严格且优雅的统一 API 规范。
1. 核心应用场景与模型支持
- 监督学习(分类与回归):包括普通最小二乘法、岭回归(Ridge)、套索回归(Lasso)、逻辑回归(Logistic Regression)、支持向量机(SVM)、决策树、随机森林(Random Forest)以及梯度提升决策树(GBDT)。
- 无监督学习(聚类与降维):包括 K-Means 聚类、DBSCAN 密度聚类、层次聚类、主成分分析(PCA)降维与 t-SNE 高维可视化。
- 模型评估与调优:提供完整的交叉验证(Cross-Validation)、超参数网格搜索(GridSearchCV)、随机搜索(RandomizedSearchCV)以及查准率、召回率、ROC-AUC 等数十种指标。
2. 典型实战代码:端到端流水线(Pipeline)
在实际工业实践中,Scikit-learn 最具价值的模块是 Pipeline。它将缺失值插补、特征缩放和估计器打包成单一对象,防止训练集与验证集产生统计信息泄露:
# 运行环境:Python 3.8+,需安装 scikit-learn
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report

# 1. 加载示例数据并划分训练集与测试集
X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 2. 构建包含标准化与分类器的流水线管道
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('rf', RandomForestClassifier(random_state=42))
])

# 3. 超参数搜索与5折交叉验证
param_grid = {
    'rf__n_estimators': [50, 100],
    'rf__max_depth': [3, 5, None]
}
grid = GridSearchCV(pipeline, param_grid, cv=5, scoring='f1', n_jobs=-1)
grid.fit(X_train, y_train)

# 4. 评估验证集表现
y_pred = grid.predict(X_test)
print(classification_report(y_test, y_pred))
Scikit-learn 并不适合处理原始图像像素、非结构化语音波形或超大规模序列文本建模;此外,它原生不支持 GPU 加速,对于千万级以上样本的大规模拟合,应搭配 LightGBM、XGBoost 或分布式框架处理。
三、PyTorch 能做什么:现代深度学习与科研大模型引擎
PyTorch 诞生之初便采用“动态计算图(Dynamic Graph / Eager Execution)”理念。它的代码风格高度贴合 Python 语言原生的书写习惯,计算与调试过程完全同步,这使它迅速取代老牌框架,成为全球人工智能学术界与大语言模型开源社区的事实标准。
1. 核心应用场景与生态地位
- 大语言模型(LLM)与生成式 AI:当前全球绝大多数顶级大模型(包括 LLaMA、DeepSeek、Mistral、ChatGLM 等)均以 PyTorch 编写训练并开源发布。
- 计算机视觉(CV)与多模态:目标检测(YOLO 系列)、图像分割、扩散模型(Stable Diffusion)、多模态视频理解。
- 科研探索与新型网络开发:通过重写
torch.nn.Module的forward函数,能够极其方便地实现条件动态分支、递归循环与自定义梯度算子。 - 现代分布式与编译加速:内置 DDP(Distributed Data Parallel)、FSDP(Fully Sharded Data Parallel)分布式训练框架,并通过 PyTorch 2.x 的
torch.compile获得接近 C++ 静态图的运行速度。
2. 典型实战代码:张量计算与神经网络定义
PyTorch 将数据流封装在 Tensor 中,并在前向传播时自动跟踪张量操作历史以构造梯度反传路径:
# 运行环境:Python 3.8+,需安装 torch
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 定义模块化神经网络结构
class MultilayerPerceptron(nn.Module):
    def __init__(self, input_dim, hidden_dim, num_classes):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(hidden_dim, num_classes)
        )

    def forward(self, x):
        return self.network(x)

# 2. 算力设备调度(优先 CUDA,次选 CPU)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = MultilayerPerceptron(input_dim=30, hidden_dim=64, num_classes=2).to(device)

# 3. 损失函数与优化器
criterion = nn.CrossEntropyLoss()
optimizer = optim.AdamW(model.parameters(), lr=1e-3)

# 4. 单步训练循环示例
dummy_inputs = torch.randn(16, 30).to(device)
dummy_labels = torch.randint(0, 2, (16,)).to(device)

optimizer.zero_grad()             # 清空累加梯度
outputs = model(dummy_inputs)       # 前向运算构建动态图
loss = criterion(outputs, dummy_labels)
loss.backward()                     # 反向传播计算梯度
optimizer.step()                    # 更新网络权重参数
print(f"当前批次损失: {loss.item():.4f}")
四、TensorFlow 能做什么:工业级全平台部署与端到端交付
TensorFlow 由 Google 主导研发,虽然在学术论文新算法开源比例上被 PyTorch 领先,但在成熟企业级工业生产、端侧移动设备(Android/iOS/IoT)和前端网页浏览器中,依然保持着无与伦比的工程部署优势。
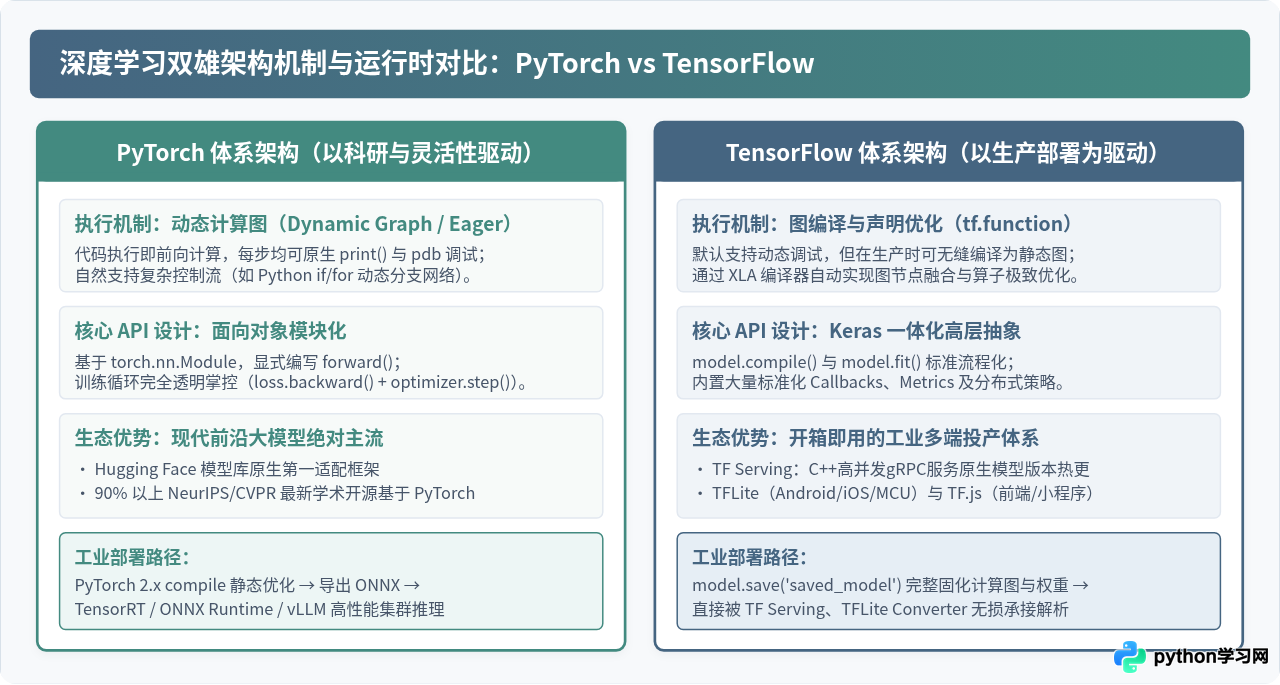
1. 核心应用场景与工具链体系
- Keras 高层极简建模:自 TensorFlow 2.0 深度集成 Keras 以来,支持通过
Sequential顺序模型或函数式 API(Functional API)极速组装神经网络,内建完善的EarlyStopping、ModelCheckpoint等回调体系。 - 企业级微服务部署(TF Serving):基于 C++ 编写的高性能模型服务,原生支持 gRPC 与 REST 接口,支持零宕机在线模型版本热切换与并发批处理(Batching)。
- 端侧边缘计算(TensorFlow Lite):专为手机移动芯片和微控制器打造的轻量级运行时,具备行业顶尖的 INT8 离线量化与硬件加速(NPU/DSP)驱动支持。
- 浏览器端推理(TensorFlow.js):直接在客户端利用 WebGL 或 WebGPU 运行深度学习模型,无需将用户敏感数据回传服务器。
2. 典型实战代码:Keras 建模与 SavedModel 导出
# 运行环境:Python 3.8+,需安装 tensorflow
import tensorflow as tf
from tensorflow.keras import layers, models

# 1. 利用 Keras 高层 API 快速堆叠模型结构
model = models.Sequential([
    layers.Input(shape=(30,)),
    layers.Dense(64, activation='relu'),
    layers.Dropout(0.2),
    layers.Dense(1, activation='sigmoid')
])

# 2. 编译模型:统一配置损失函数、优化器与评价指标
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-3),
    loss='binary_crossentropy',
    metrics=['accuracy']
)

# 3. 生产级固化导出为 SavedModel 格式
# 导出的目录包含计算图完整拓扑与参数,可直接加载进 TF Serving 或转成 TFLite
model.save('production_model')
print("SavedModel 导出完成,可直接用于 C++ TF Serving 或 TFLite 转换。")
五、选型决策指南:如何根据项目需求作出选择
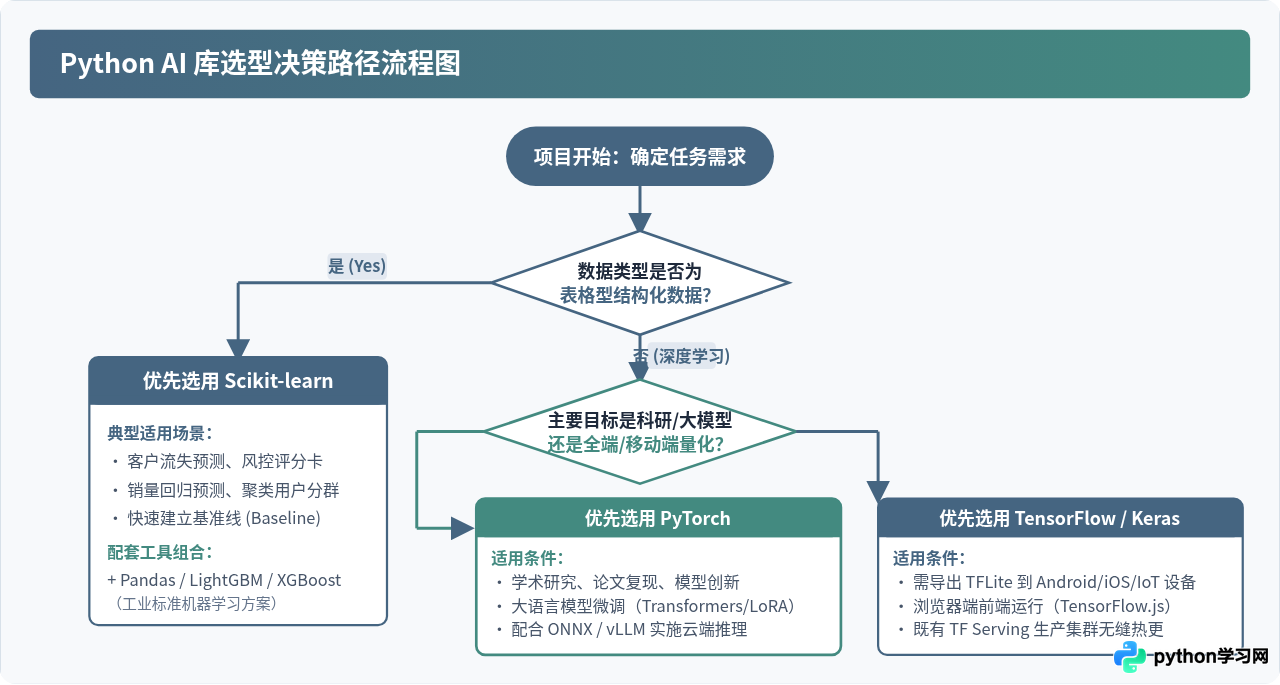
在面对具体业务需求时,选型并非“哪个库更先进”,而是“哪个库以最低的工程维护成本解决当前问题”。下图给出了典型 AI 项目的技术选型决策路径:
场景判断准则:
- 如果数据是表格结构且数据量在千万行以内:毫不犹豫选择 Scikit-learn(必要时引入 LightGBM 或 XGBoost)。深度学习在传统表格任务上的性价比与可解释性通常远逊于树模型流水线。
- 如果需要跟进前沿算法、进行模型结构创新或微调大模型:选择 PyTorch。Hugging Face、PyTorch Lightning 以及主流研究论文开源仓库均为 PyTorch 优先,避开了二次转换的巨大工程开销。
- 如果最终目标是交付至移动 App、微信小程序或工业级 C++ 高吞吐微服务:优先考虑 TensorFlow 的生态工具链,或采用 PyTorch + ONNX 的跨框架桥接方案。
六、综合对比与协同开发总结
在成熟的工业软件系统中,这三个库并非水火不容,而是常常在同一个数据平台中分工协同。例如,工程师常用 Scikit-learn 完成用户画像的特征预处理和聚类统计,将生成的高维离散特征送入 PyTorch 训练的多模态大模型中,最终通过标准模型交换格式(如 ONNX)固化,部署在高性能推理集群中。
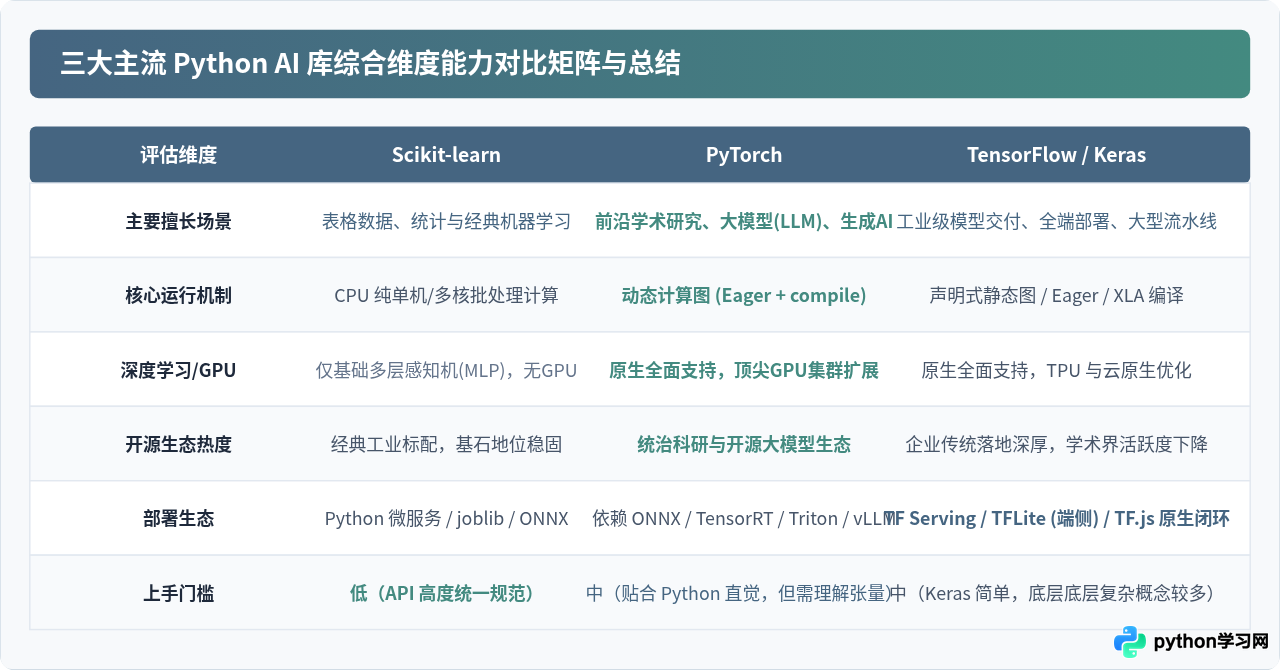
1. 避免“为了用深度学习而用深度学习”:在客户流失率预测、风控评分卡等场景,Scikit-learn 配合特征工程可在几毫秒内得出可解释预测,开发和部署成本极低。
2. 善用标准化桥梁(ONNX):当前 PyTorch 训练模型后导出为 ONNX,再接入 TensorRT 或 OpenVINO,已成为服务端主流优化路径,能兼顾 PyTorch 的开发敏捷性与工业级执行性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









