

Python怎么从嵌套列表或字典中提取指定数据
系统讲解在Python中从多层嵌套列表与字典中提取指定数据的实用方法,涵盖基础链式索引、防报错安全访问、批量列表推导、递归任意深度搜索及工具库选型。
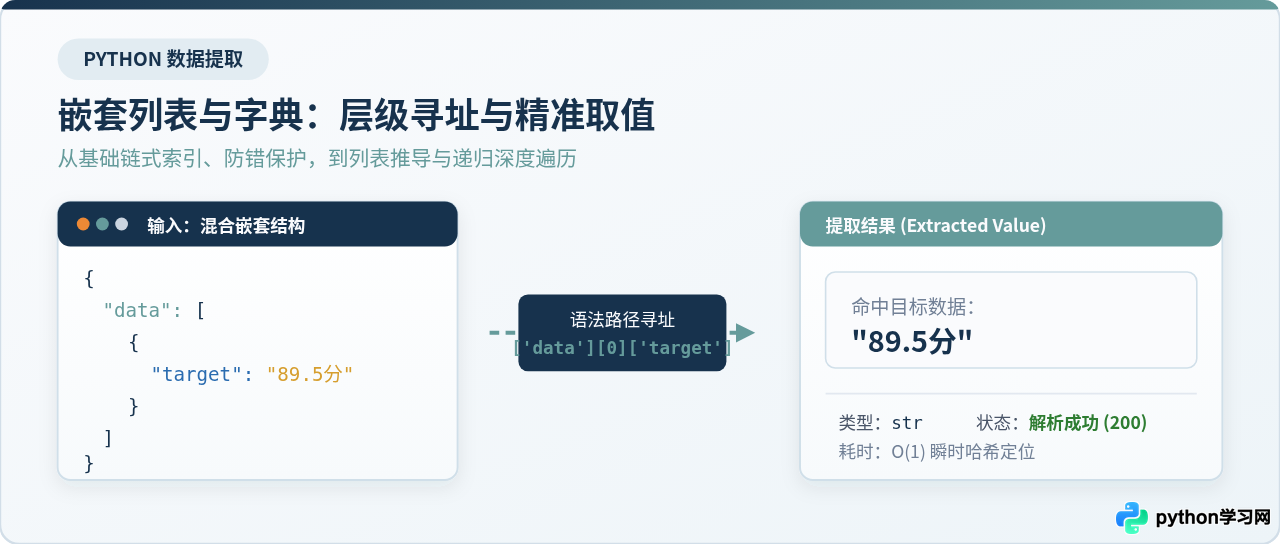
在 Python 中提取嵌套列表或字典中的数据,核心在于“分清当前层级的容器类型,按层级规则逐层解包定位”。面对已知结构的嵌套数据,最直接的方法是使用链式索引与键名访问;面对可能缺少键或索引越界的不稳定数据,应采用安全访问逻辑或异常保护;对于需要批量提取同类字段的场景,列表推导式能高效完成筛选;而面对嵌套深度不固定的树形数据,递归遍历则是最通用的解决方案。本文将按实际开发场景,依次解析这些提取策略的具体实现与避坑要点。
一、看清层级关系:链式索引与键访问基础
在 Python 中,嵌套数据通常是由字典(dict)和列表(list)互相包含构成的复杂树形结构。要提取深层数据,首先需要将嵌套路径拆解为单步操作:遇到字典就用键名(例如 ['key']),遇到列表就用从 0 开始的数字下标(例如 [0])。
为了直观展示这一规则,我们可以看一个综合了“字典内嵌字典、字典内嵌列表、列表元素又为字典”的典型场景:
# 示例:学校、班级与学生的综合嵌套数据
school_data = {
    "school_name": "实验一中",
    "campus": {
        "city": "北京",
        "classes": [
            {
                "class_id": "C101",
                "students": [
                    {"name": "李雷", "score": 92},
                    {"name": "韩梅梅", "score": 96}
                ]
            },
            {
                "class_id": "C102",
                "students": [
                    {"name": "张晓华", "score": 88},
                    {"name": "王建国", "score": 91}
                ]
            }
        ]
    }
}
假设我们的目标是提取出 C102 班级中第一位学生的名字(即 "张晓华")。我们不需要被复杂的外观所迷惑,只要按层级一步步分解:
- 外层第一步:
school_data["campus"]是一个字典,通过键"campus"进入校区字典; - 外层第二步:
...["classes"]同样是字典取值,获得包含两个班级的列表; - 定位班级:
C102是列表中的第 2 个元素,Python 索引从 0 开始,因此用下标[1]; - 定位学生列表:班级对象是字典,通过
["students"]拿到该班学生列表; - 定位具体学生:第一位学生是该列表的第 0 项,使用下标
[0]; - 提取目标属性:学生对象是字典,最终通过键
["name"]拿到字符串结果。
将上述分解连缀在一起,就是标准的链式提取代码:
# 完整单行链式寻址
target_name = school_data["campus"]["classes"][1]["students"][0]["name"]
print("提取结果:", target_name)  # 示例输出: 提取结果: 张晓华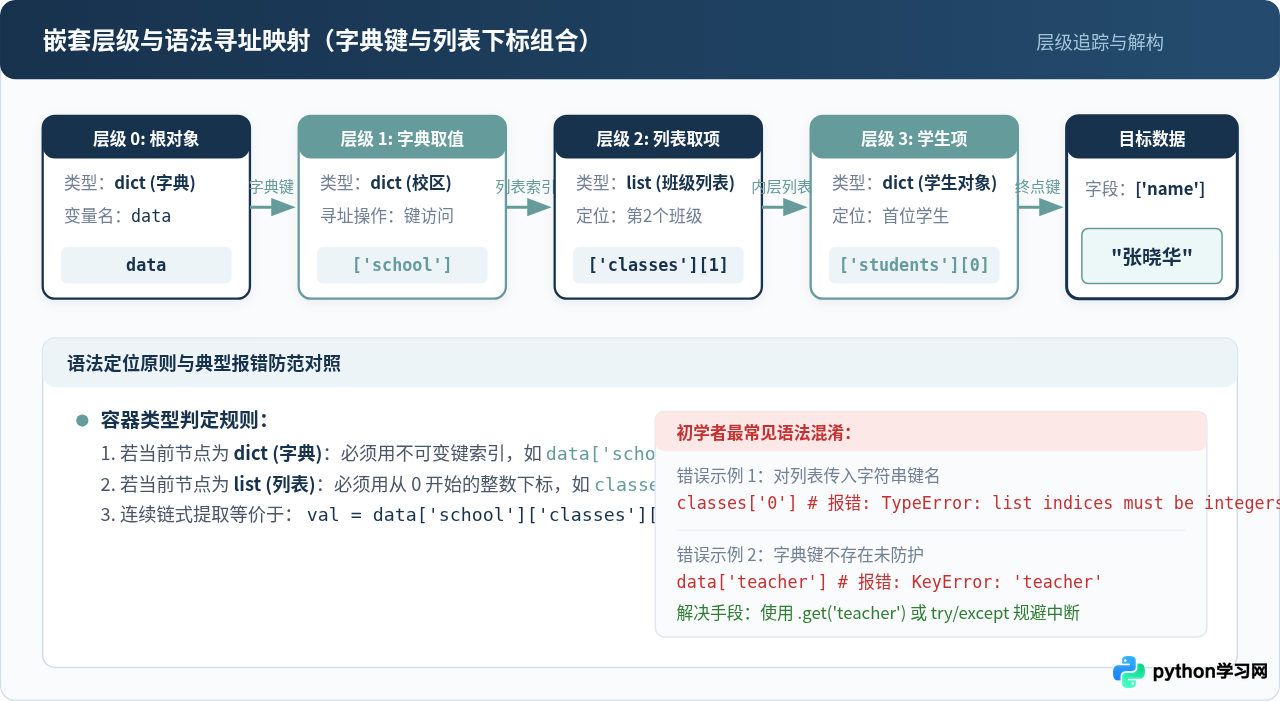
初学者最容易犯的错误是把字典的键和列表的下标混淆。如果对列表使用了字符串键(例如
classes["0"]),Python 会直接抛出 TypeError: list indices must be integers or slices, not str;反之,若对字典使用了数字索引而字典并不包含该数字键,则会抛出 KeyError。始终牢记:方括号里写字符串还是数字,取决于括号左侧当前对象的真实数据类型。
二、安全取值防崩溃:应对缺失键与越界索引
直接使用 data['key'] 或 data[0] 的前提是结构与数据绝对可信。但在实际工程中(如对接第三方 Web API、解析用户提交的 JSON),数据经常出现缺字段(Missing Key)、列表为空(Empty List)或为 null/None 的情况。直接访问会导致程序抛出异常而中断退出。
1. 字典的 .get() 与连环调用的空指针陷阱
字典提供了内置的 .get(key, default) 方法,当键不存在时会优雅返回 default(默认为 None),避免 KeyError。但许多人在多层嵌套中会写出如下代码:
# 常见错误写法:深层盲目 .get()
# 假设 user 字典中没有 profile 字段
user = {"id": 1001}
# 当 user.get("profile") 返回 None 后,对 None 调用 .get() 必然奔溃!
# 报错: AttributeError: 'NoneType' object has no attribute 'get'
name = user.get("profile").get("name")
要安全使用 .get() 进行链式读取,必须为每一层返回的空缺提供空字典 {} 作为保底:
# 正确的多层字典 .get() 兜底
name = user.get("profile", {}).get("name", "默认昵称")
print(name)  # 示例输出: 默认昵称
2. 通用安全提取函数:支持混合路径与自动容错
当路径中同时混杂字典键和列表数字索引时,.get() 便无能为力。此时编写一个轻量的通用路径提取函数 safe_get,是工业级代码中最常用的技巧:
def safe_get(data, path, default=None):
    """
    安全遍历嵌套字典和列表
    :param data: 根数据对象 (dict 或 list)
    :param path: 路径元组或列表,例如 ["campus", "classes", 0, "students", 0, "name"]
    :param default: 提取失败时的默认返回值
    """
    curr = data
    for step in path:
        if isinstance(curr, dict) and isinstance(step, (str, int)):
            curr = curr.get(step)
        elif isinstance(curr, list) and isinstance(step, int):
            if 0 <= step < len(curr):
                curr = curr[step]
            else:
                return default
        else:
            return default

        if curr is None:
            return default
    return curr

# 验证测试:当索引超出或键不存在时,程序不会崩溃,直接返回缺省值
result = safe_get(school_data, ["campus", "classes", 99, "students", 0, "name"], default="未找到")
print("安全提取结果:", result)  # 示例输出: 安全提取结果: 未找到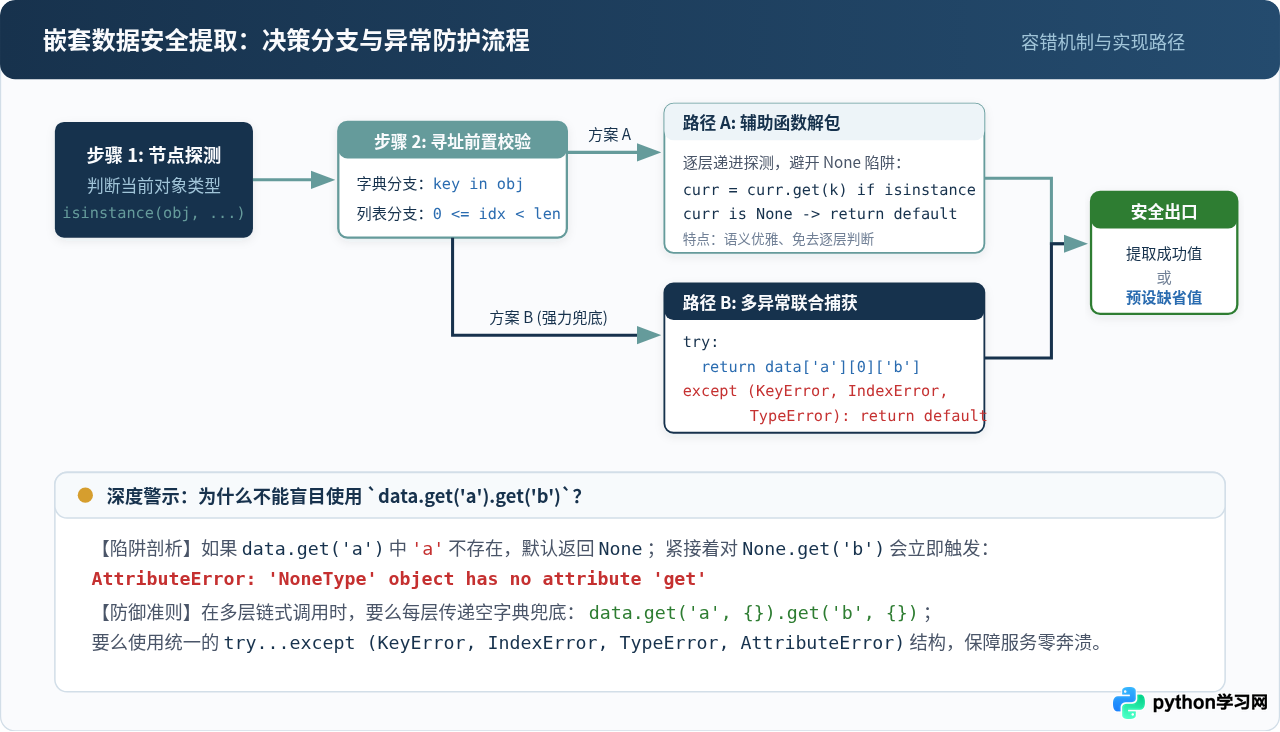
3. 简洁的 try...except 联合捕获方案
如果你不想引入额外的辅助函数,Python 原生的 try...except 同样极为高效。将可能抛出的异常一次性捕获,代码既扁平又符合 Pythonic 风格:
try:
    student_name = school_data["campus"]["classes"][0]["students"][0]["name"]
except (KeyError, IndexError, TypeError):
    student_name = "未知学生"

print("当前学生:", student_name)
三、批量提取与条件筛选:列表推导式的高效应用
除了一次提取单个字段外,开发中最常见的需求是从“字典列表”中批量提取某一属性的所有值,或者按条件展开提取特定字段。列表推导式(List Comprehension)是完成这一任务的最佳工具。
1. 批量提取同一字段列表
假设我们有一组商品订单数据,需要快速提取出所有订单的商品编号(sku_id):
orders = [
    {"order_id": 1, "item": {"sku_id": "A10", "price": 45.0}},
    {"order_id": 2, "item": {"sku_id": "B22", "price": 88.0}},
    {"order_id": 3, "item": {"sku_id": "C35", "price": 12.5}}
]

# 单行推导式完成提取
sku_list = [order["item"]["sku_id"] for order in orders if "item" in order and "sku_id" in order["item"]]
print("SKU列表:", sku_list)  # 示例输出: SKU列表: ['A10', 'B22', 'C35']
2. 多层嵌套解构与条件过滤
如果数据有多层嵌套列表,列表推导式允许编写多个 for 子句。其编写次序与传统多层 for 循环的嵌套层级完全一致(外层循环在前,内层循环在后):
# 目标:提取学校所有班级中,所有成绩 >= 90 分的学生名字
top_students = [
    student["name"]
    for cls in school_data.get("campus", {}).get("classes", [])
    for student in cls.get("students", [])
    if student.get("score", 0) >= 90
]

print("高分学生名单:", top_students)
# 示例输出: 高分学生名单: ['李雷', '韩梅梅', '王建国']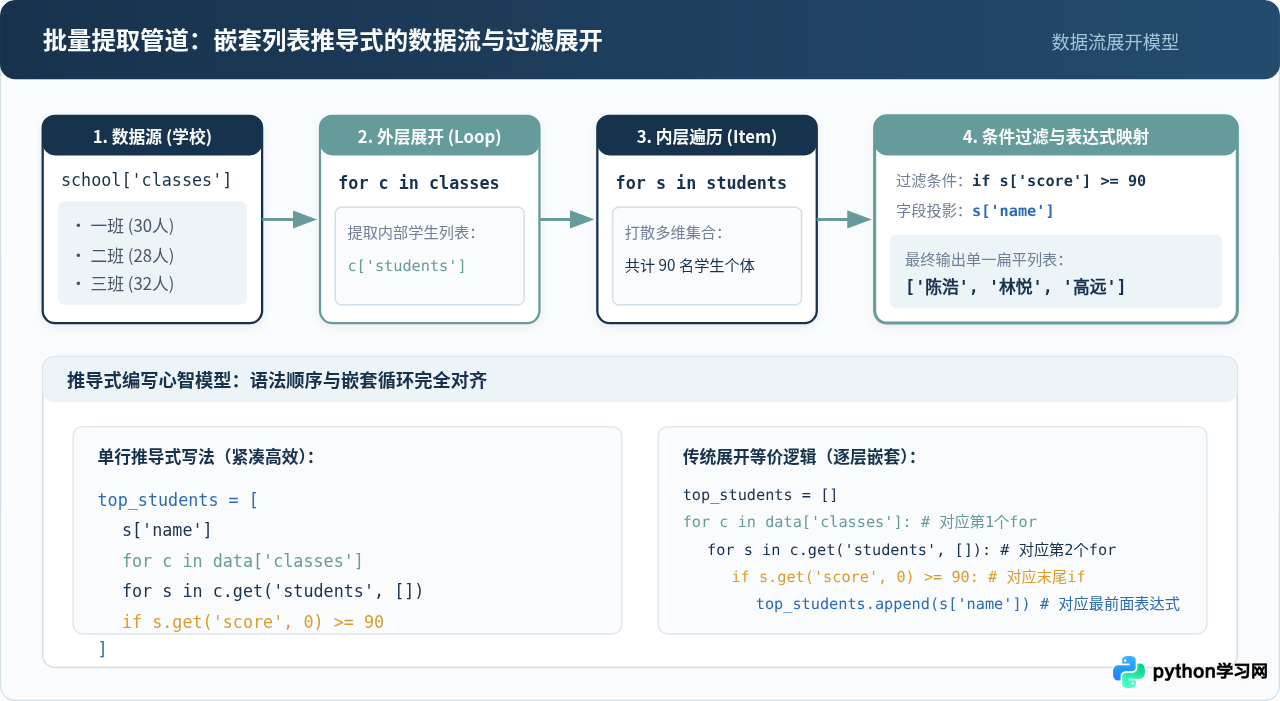
四、任意深度与未知结构:通用递归提取算法
在面对层次不规则、键可能出现在任意深度的树形 JSON 数据(例如组织架构树、评论多级嵌套、或者文件系统配置)时,链式代码无法穷举所有路径。此时需要使用递归(Recursion)自动下探所有分支。
下面是一个经过实践检验的通用提取函数,它能够在未知深度的复杂字典和列表中,搜索所有匹配指定键名(target_key)的数据:
def extract_all_by_key(obj, target_key):
    """
    递归遍历任意深度的字典或列表,收集所有与 target_key 匹配的值
    """
    results = []

    if isinstance(obj, dict):
        for k, v in obj.items():
            if k == target_key:
                results.append(v)
            # 递归探索子节点
            results.extend(extract_all_by_key(v, target_key))
    elif isinstance(obj, list):
        for item in obj:
            # 遍历列表中的每一个元素并递归搜索
            results.extend(extract_all_by_key(item, target_key))

    return results

# 测试不规则多层嵌套数据
messy_json = {
    "title": "总公司",
    "managers": [{"name": "王总", "level": 1}],
    "departments": [
        {
            "dep_name": "研发部",
            "manager": {"name": "李总监", "level": 2},
            "teams": [
                {"team_name": "后端组", "members": [{"name": "张工"}, {"name": "赵工"}]}
            ]
        },
        {
            "dep_name": "市场部",
            "manager": {"name": "刘总监", "level": 2}
        }
    ]
}

# 一行提取整个树中出现的所有 "name" 字段
all_names = extract_all_by_key(messy_json, "name")
print("提取到的全部姓名:", all_names)
# 示例输出: 提取到的全部姓名: ['王总', '李总监', '张工', '赵工', '刘总监']
该函数的运行原理是:每次进入函数时判断当前是字典还是列表。如果是字典,先检查当前层是否存在目标键并收集,随后对所有子值继续调用自身;如果是列表,则逐项递归下探;当既不是列表也不是字典时,递归自然收敛回退。
五、方案选型与技术总结
在 Python 日常开发中,提取嵌套数据并不存在所谓的“唯一最优解”,而是取决于数据源的可控程度与业务场景:
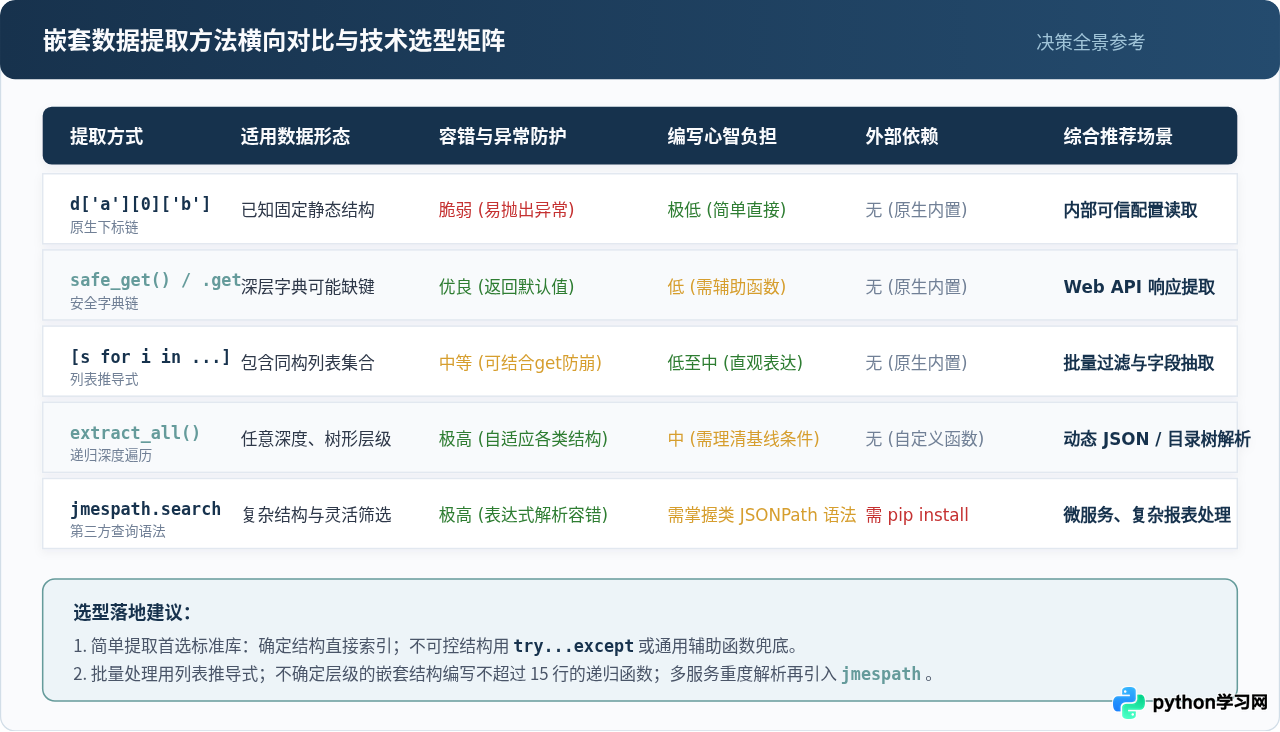
| 技术方案 | 典型代码特征 | 优点 | 缺点 | 推荐使用场景 |
|---|---|---|---|---|
| 原生链式索引 | data['a'][0]['b'] |
执行速度最快,无心智开销 | 一旦缺键或下标越界直接抛异常崩溃 | 静态配置、本地内部固定数据结构 |
| 链式 .get() 兜底 | data.get('a', {}).get('b') |
原生语法,可指定缺失缺省值 | 多层书写冗长,且不支持列表数字索引 | 简单浅层字典的数据解构 |
| 列表推导式 | [x['id'] for x in data] |
表达力极强,能同时完成遍历与过滤 | 嵌套超过 3 层时代码可读性明显下降 | 多条目批量抽取与条件清洗 |
| 通用递归函数 | extract_all(data, 'key') |
完全无视层级深度,自适应任意复杂树 | 消耗递归调用栈,不能精确定位特定路径 | 组织架构树、评论树、多层树形配置解析 |
| 成熟解析库 (jmespath) | jmespath.search('a.b[*].c', d) |
声明式语法,类似 XPath,功能极其强大 | 需要执行 pip install jmespath |
大型服务接口交互、复杂数据集成工程 |
面对嵌套列表或字典,最稳妥的处理步骤是:先打印
type(data) 或查看数据样本结构;已知明确路径且容错要求高时,使用 try...except (KeyError, IndexError, TypeError) 或通用 safe_get 函数;处理重复同构数据时优先使用列表推导式;面对未知深度的任意树形结构,编写简短的递归函数即可轻松解决。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









