

Python导入机器学习库失败怎么办?常见报错与解决
针对Python在导入scikit-learn、PyTorch、TensorFlow等机器学习库时常见的ModuleNotFoundError、DLL load failed、循环导入及版本冲突等报错,提供系统级的排查步骤、底层成因解释及可执行的解决方案。
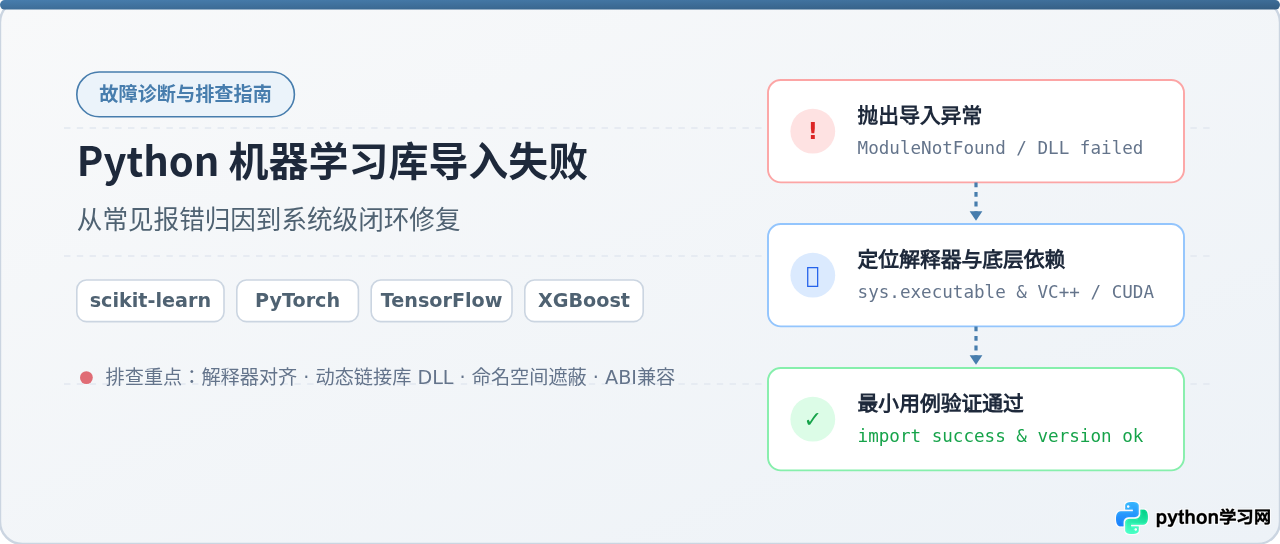
在运行机器学习项目时,执行 import sklearn、import torch 或 import tensorflow 抛出错误,极少是代码语法本身的问题,而通常源于运行解释器与安装环境错位、包管理名称与导入模块名称混淆、本地脚本同名遮蔽、底层 C/C++ 动态链接库缺失或依赖包二进制 ABI 不兼容。解决该问题的标准排查路径是:先定位脚本当前运行的具体解释器,再核对该环境中的安装包名与状态,接着排查工作区同名文件干扰,最后确认系统级动态链接库与依赖版本。
排查第一步:确诊“模块未找到” (ModuleNotFoundError)
ModuleNotFoundError: No module named '...' 是最普遍的导入报错。该错误意味着 Python 在其模块搜索路径列表中遍历了所有目录,均未能找到对应的包包体或入口脚本。遇到此错误时,无需盲目反复重装,先按照以下两项关键原因进行甄别。
1. 混淆了“包安装名”与“代码导入名”
在 Python 生态中,PyPI 注册的安装包名称与在代码中调用的顶层模块名称并不强制一致。机器学习领域尤为典型:
- scikit-learn:安装命令必须为
pip install scikit-learn,但在 Python 代码中导入时必须写为import sklearn。直接执行pip install sklearn安装的是一个空壳过渡包,容易引发版本脱节。 - OpenCV:安装命令为
pip install opencv-python或opencv-python-headless,而导入语句是import cv2。 - Pillow(图像预处理):安装命令为
pip install pillow,导入语句则是import PIL或from PIL import Image。 - PyYAML:安装命令为
pip install pyyaml,导入语句为import yaml。
2. 终端执行环境与 IDE/Jupyter 解释器未对齐
绝大多数“明明在终端执行了 pip install,运行脚本却依然提示 ModuleNotFoundError”的情况,都是由多环境错位造成的。例如:操作系统自带 Python、全局 Python 3.11、虚拟环境 .venv,以及 Anaconda 基础环境同时存在;用户在系统终端敲下 pip install,安装包被放置到了全局 Python 的 site-packages 中,但 VS Code 或 PyCharm 运行脚本时使用的却是项目的独立虚拟环境。
要确认当前脚本由哪一个解释器在执行,可以在抛错的代码最前部添加以下两行诊断代码:
import sys

print("当前执行的解释器路径:", sys.executable)
print("当前 Python 检索目录 (sys.path):")
for p in sys.path:
    print("  ->", p)
执行后,会得到类似如下的示例输出:
当前执行的解释器路径: /Users/username/project/.venv/bin/python
当前 Python 检索目录 (sys.path):
  -> /Users/username/project
  -> /Users/username/project/.venv/lib/python3.11/site-packages
此时便可以明确知道,当前代码是在 .venv 虚拟环境中运行的。为了彻底消除环境错位,永远不要在终端中直接敲裸命令 pip install,而是显式使用目标解释器调用 pip 模块:
# 在对应虚拟环境中,指定该环境的 Python 解释器执行安装
python -m pip install scikit-learn torch torchvision

# 或者显式指定解释器完整绝对路径
/Users/username/project/.venv/bin/python -m pip install scikit-learn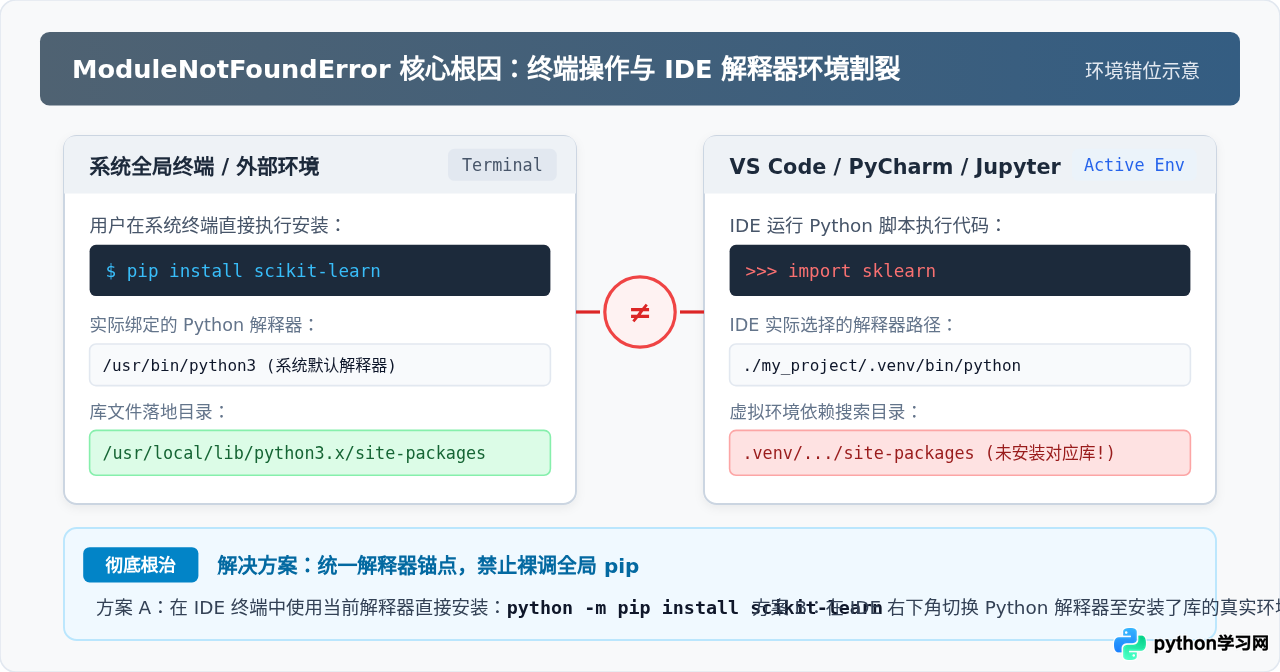
排查第二步:底层动态链接库加载失败 (ImportError: DLL load failed / .so / .dylib)
与常规纯 Python 脚本不同,机器学习与深度学习库(如 NumPy、SciPy、PyTorch、TensorFlow、XGBoost、LightGBM)的核心计算引擎均由 C/C++、Fortran 或 CUDA 编写,并编译为动态链接库(Windows 上的 .dll、Linux 上的 .so、macOS 上的 .dylib)。
当 Python 解释器找到了模块入口文件,但在操作系统级别尝试载入这些编译扩展时,如果底层缺少依赖库,就会抛出 ImportError: DLL load failed while importing ... 或 cannot open shared object file。
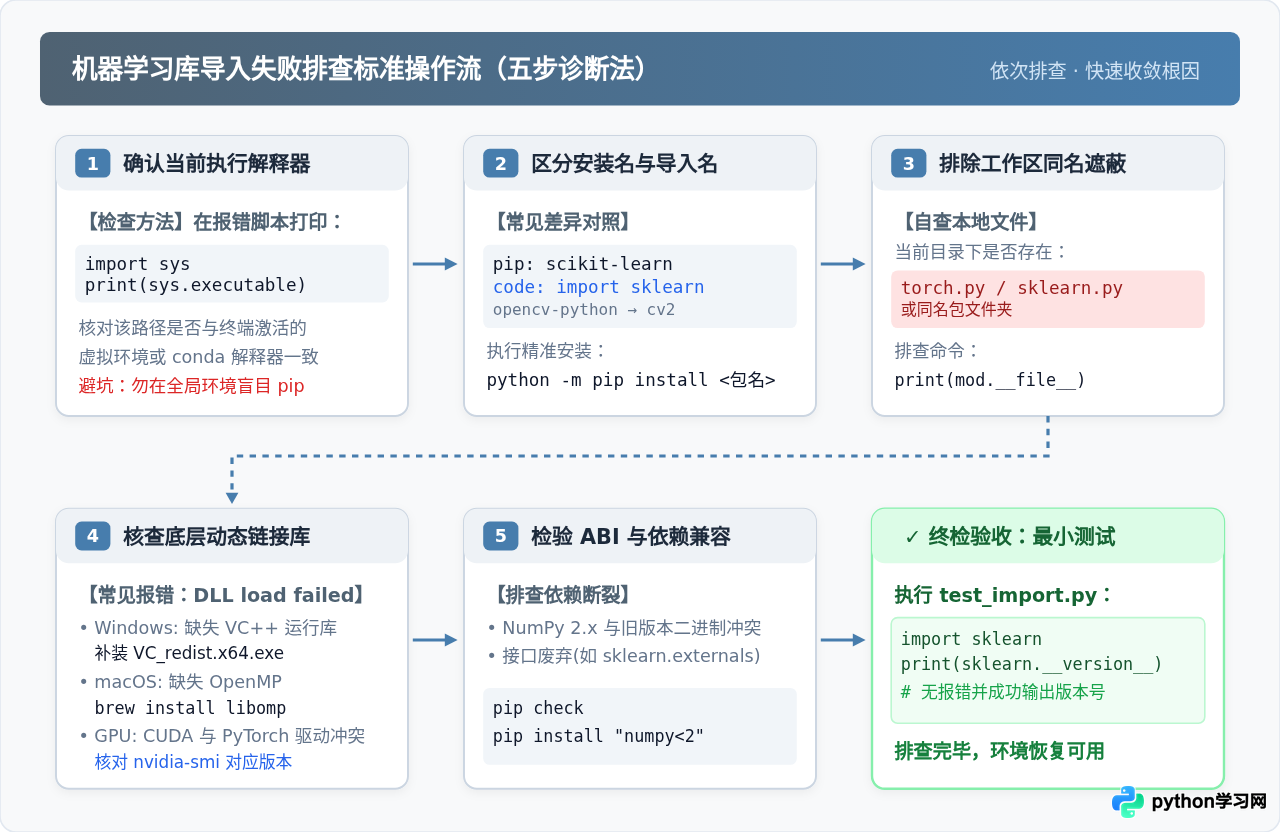
常见系统下的对症解决策略:
报错信息常表现为:ImportError: DLL load failed while importing _arpack: 找不到指定的模块。 或 DLL load failed while importing _multiarray_umath。这通常是操作系统缺少对应的 MSVC 运行库。从微软官方下载并安装最新的 Visual C++ 2015-2022 Redistributable (x64),安装后重启命令行即可解决。
在 macOS 上安装 LightGBM 或 XGBoost 后执行导入,经常抛出 Library not loaded: /usr/local/opt/libomp/lib/libomp.dylib 或类似找不到 libomp 的错误。这是因为 macOS 自带的 clang 编译器默认不携带 OpenMP 运行时。打开终端执行 brew install libomp 即可自动补全底层依赖。
如果导入 torch 时报错 ImportError: libtorch_cuda.so: cannot open shared object file,通常是在支持 CUDA 的环境中直接执行了纯 pip install torch,导致下载了与当前显卡驱动不匹配的版本。先在终端运行 nvidia-smi 查看驱动支持的最高 CUDA 版本,然后在 PyTorch 官网挑选对应的安装指令(如 pip install torch --index-url https://download.pytorch.org/whl/cu121)。
排查第三步:工作区文件同名冲突与循环导入
这是一个极其隐蔽但频繁出现在初学者中的陷阱。其典型错误表现形式有两种:
ImportError: cannot import name '...' from partially initialized module '...' (most likely due to a circular import)- 或者导入没有报错,但在使用时抛出:
AttributeError: module 'torch' has no attribute 'randn'、module 'sklearn' has no attribute 'datasets'。
同名遮蔽的发生机理
Python 启动时,解释器会自动将当前被执行脚本所在的目录放置在 sys.path 的第一个元素(索引 0)。在检索任何第三方模块或标准库之前,Python 都会优先在当前目录下寻找同名文件。
如果开发者在项目工作区随手创建了名为 torch.py、sklearn.py、random.py、test.py 的文件,或者创建了名为 torch/ 的文件夹,在执行代码时,import torch 不会去加载 site-packages 中的官方库,而是把本地这个空文件或练习脚本载入了进来。由于本地脚本正在执行 import torch,导致自己导入自己,触发未完全初始化(partially initialized module)的循环导入报错。
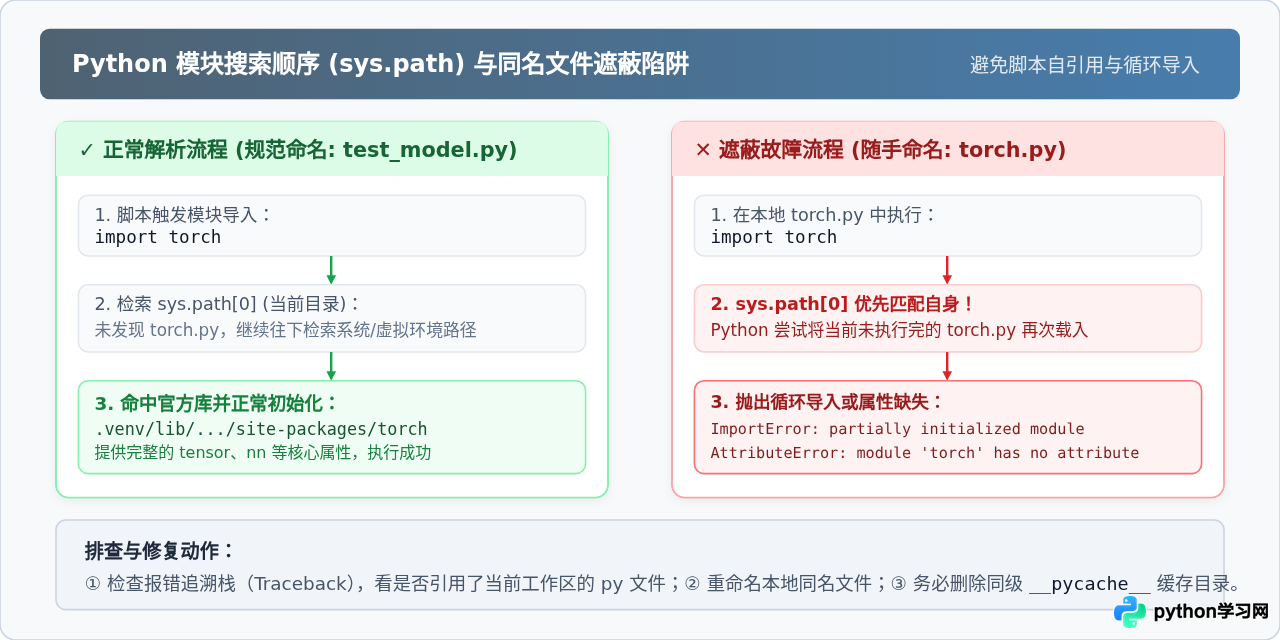
如何自查与修复同名冲突:
-
打印模块来源文件:在抛错的脚本中尝试打印
print(getattr(sklearn, '__file__', None))。如果输出路径指向了你当前项目目录下的sklearn.py,说明发生了同名遮蔽。 -
立即重命名本地文件:将
torch.py重命名为run_torch_demo.py,切忌使用任何第三方库或标准库的关键字命名。 -
清理
__pycache__缓存:重命名后,必须进入所在目录,删除同级自动生成的__pycache__文件夹。否则 Python 仍可能优先读取残留的torch.cpython-311.pyc字节码缓存。
排查第四步:依赖版本冲突与底层 ABI 不兼容
机器学习库之间有着非常深度的网状依赖关系。例如,Pandas、SciPy、Scikit-learn、PyTorch 几乎全部依赖底层核心 NumPy。当底层核心库发生重大版本更新或二进制接口(C-API / ABI)变动时,上层库若未重新编译,就会出现导入崩溃。
1. NumPy 2.0 与历史二进制轮子不兼容
NumPy 2.0 带来了底层的 ABI 架构改动。如果环境自动安装了 NumPy 2.x,而项目中安装的 PyTorch 或 SciPy 轮子是在 NumPy 1.x 规范下编译的,在执行 import torch 或 import scipy 时就会抛出致命错误:
A module that was compiled using NumPy 1.x cannot be run in NumPy 2.0.0 as it may crash.
ImportError: numpy.core.multiarray failed to import解决方法:在虚拟环境中锁定 NumPy 为兼容的 1.x 稳定版本,或者升级上层库到适配 NumPy 2 的最新版本:
# 回退并锁定 NumPy 到 1.x 最新长期支持版
python -m pip install "numpy<2"
2. 废弃接口与废弃子模块引发的 ImportError
许多老旧教程和开源代码仍在使用已经被官方废弃的引用路径。例如在 Scikit-learn 0.23+ 之后,sklearn.externals.joblib 已被彻底移除。若按照旧代码执行:
# 错误示例:旧版本已废弃路径
from sklearn.externals import joblib
# 抛出:ImportError: cannot import name 'joblib' from 'sklearn.externals'

# 正确写法:Scikit-learn 现代写法,直接导入独立维护的 joblib
import joblib
3. 使用 pip check 全面自检环境健康状态
在频繁安装、卸载各个机器学习库之后,环境中经常残留相互冲突的依赖项。可以在激活的环境中执行自检命令:
$ python -m pip check

# 示例正常输出:
No broken requirements found.

# 示例异常输出(存在依赖冲突):
scipy 1.10.1 requires numpy<1.27.0,>=1.19.5, but you have numpy 2.0.0.
终极解决全景矩阵与验收方法
为便于直观对照和快速收敛问题,下表将本文阐述的核心报错、表象特征与最佳处置手段进行了全景汇总:
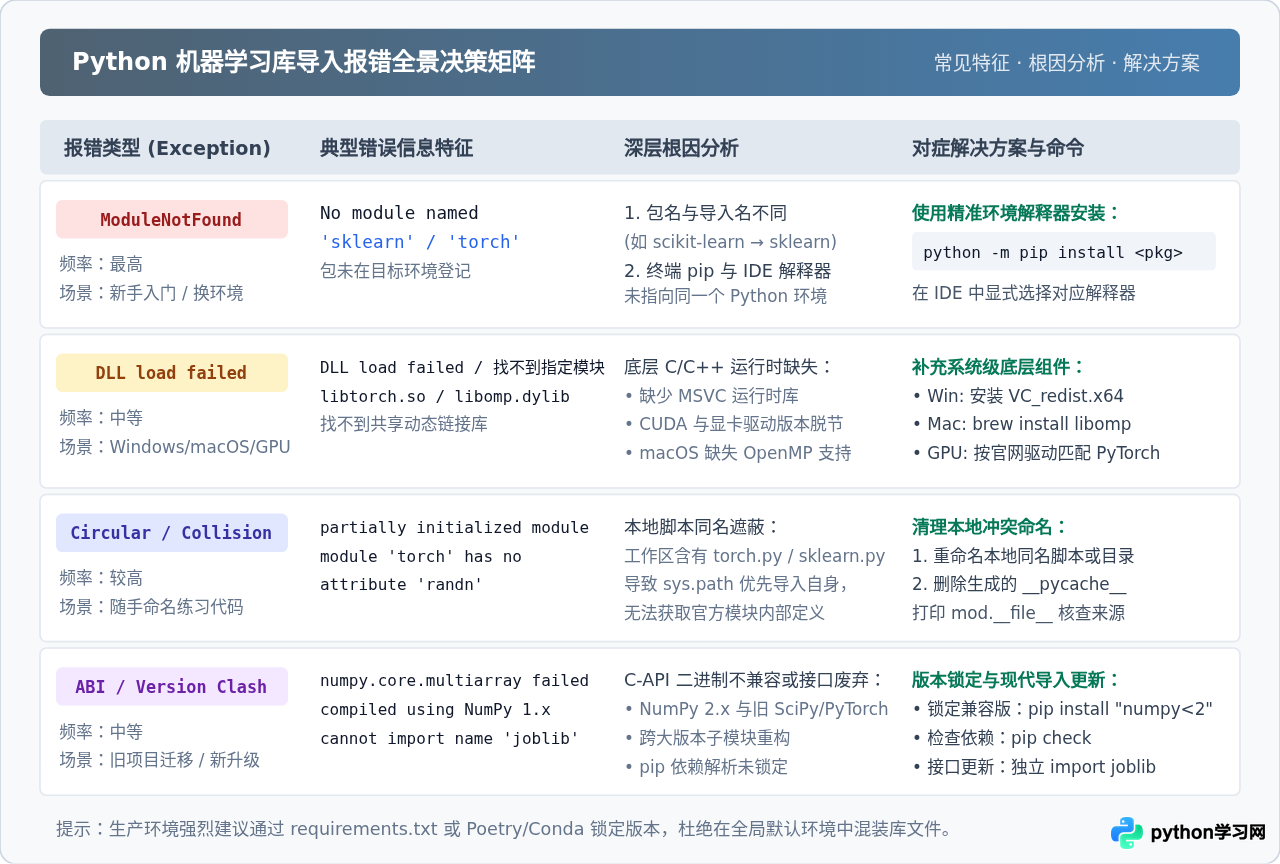
排查完毕后的最终验收步骤
按照上述步骤处理完成后,不要直接运行包含海量数据的大型训练脚本,而应新建一个独立的单文件 test_import.py,对所有核心库做一次最小化可用性验证:
import sys
print("[1] 解释器对齐校验:", sys.executable)

# 校验 scikit-learn
import sklearn
print("[2] scikit-learn 导入成功,版本号:", sklearn.__version__)

# 校验 numpy
import numpy as np
arr = np.array([1, 2, 3])
print("[3] numpy 计算正常,版本号:", np.__version__)

# 校验 torch
try:
    import torch
    x = torch.rand(2, 3)
    cuda_status = "可用" if torch.cuda.is_available() else "不可用/未配置GPU"
    print(f"[4] PyTorch 导入成功,版本号: {torch.__version__} (CUDA: {cuda_status})")
except ImportError as e:
    print("[4] PyTorch 暂未安装或无需使用:", e)

print("
>>> 全部核心模块验证通过,环境处于正常可用状态。")python -m venv .venv 或 conda create -n my_env),杜绝在操作系统的全局 Python 中堆砌相互冲突的算法库。开发完成后,及时导出 pip freeze > requirements.txt 锁定版本号,从源头上杜绝导入失败与环境漂移问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









