

Cursor是什么AI编辑器怎么写python
深入解析Cursor编辑器的底层特性与机制,详细讲解在Cursor中配置Python开发环境、使用Cursor Tab智能补全、Cmd+K行内编辑、Cmd+L上下文问答及Composer跨文件构建Python代码的完整实操流程。
一、Cursor 究竟是什么:底层架构与工作原理
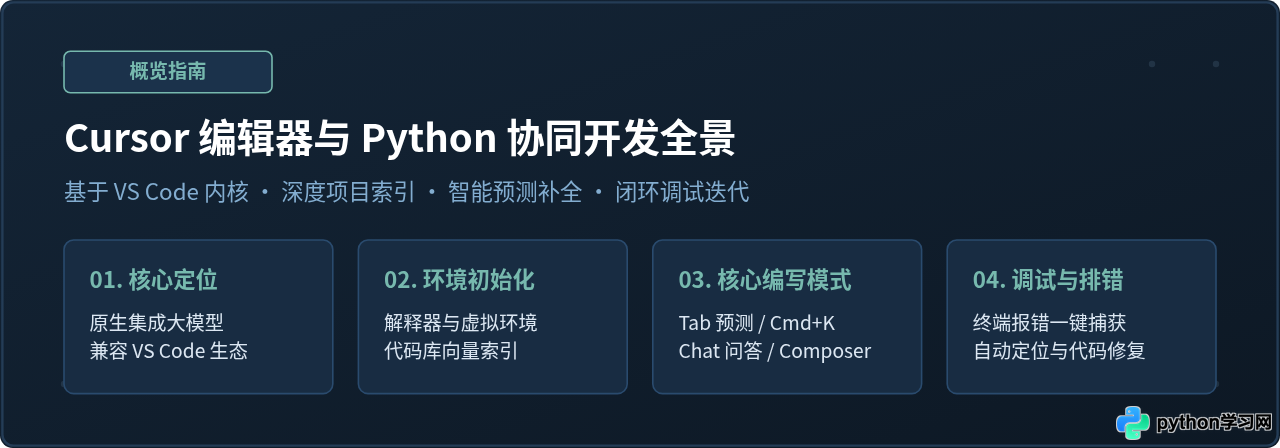
简单来说,Cursor 是一款将大语言模型(LLM)能力内嵌到编辑核心中的代码编辑器。它的外层完全基于开源的 Visual Studio Code 构建,因此它直接继承了 VS Code 的全部界面布局、按键映射、快捷键体系以及强大的扩展插件生态(包括 Python、Pylance、Jupyter 等官方扩展)。
但 Cursor 绝非只是给 VS Code 挂载了一个普通的侧边栏 AI 聊天插件,它与普通插件编辑器的核心差异主要体现在三点:
- 内核级事件拦截与多光标预测:Cursor 拥有自己的编辑器分支版本,可以在用户敲击键盘时预测下一个光标落点及多行变动,实现比普通补全更智能的
Cursor Tab。 - 全仓库向量索引(Codebase Indexing):Cursor 会扫描当前打开的 Python 项目文件夹,对所有
.py脚本、类型定义、注释和依赖进行嵌入向量计算。当你在提问或生成代码时,它能精准找到跨文件的函数声明与自定义类。 - 原生 Diff 审查机制:所有通过 AI 生成的代码并不会直接盲目覆盖原文件,而是通过类似 Git 的红绿差异比对界面呈现,让开发者一键接受(Accept)或放弃(Reject)。
二、准备工作:在 Cursor 中配置 Python 开发环境
许多刚接触 Cursor 的开发者常常有一个误解,以为既然有了 AI,就不需要安装本地 Python 解释器。事实正好相反:AI 负责构思、生成和修改代码文本,而语法校验、依赖解析、包补全与实际运行依然完全依赖本地 Python 环境。
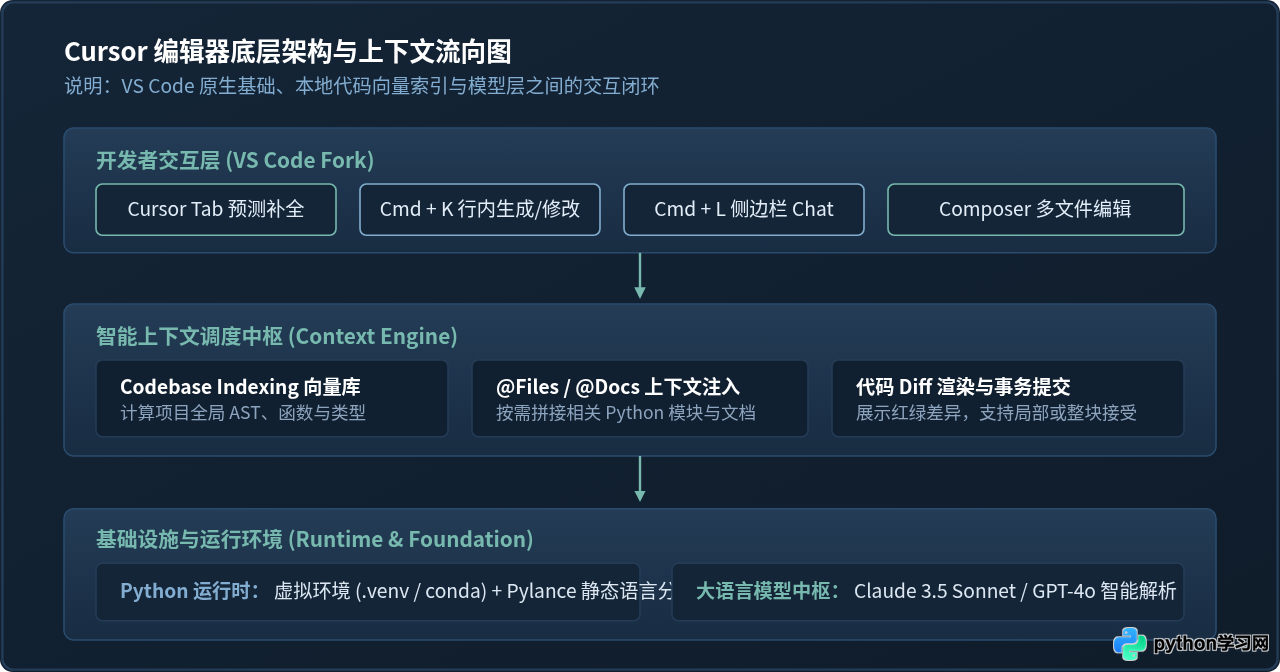
要让 Cursor 正确辅助你写 Python,必须按以下步骤完成环境配置:
1. 安装官方 Python 扩展
打开 Cursor 界面,点击左侧活动栏的 Extensions(扩展)图标(或按 Ctrl+Shift+X / Cmd+Shift+X)。搜索 Python,安装由 Microsoft 提供的官方扩展包。这将自动安装语言服务器 Pylance,为 Cursor 赋予代码跳转、类型检查与错误高亮能力。
2. 建立并激活独立的虚拟环境
在 Python 开发中,强烈建议每个项目使用独立的虚拟环境(Virtual Environment),避免全局三方库版本冲突。在 Cursor 内置终端(Ctrl+` 或 Cmd+`)中执行以下命令创建并激活虚拟环境:
# 进入项目根目录
cd /path/to/your/project

# 创建虚拟环境(以 Python 3 内置 venv 为例)
python3 -m venv .venv

# 激活虚拟环境 (macOS/Linux)
source .venv/bin/activate

# 激活虚拟环境 (Windows PowerShell)
# .venv\Scripts\Activate.ps1
3. 指定项目解释器(Select Interpreter)
按下快捷键 Ctrl+Shift+P(macOS 为 Cmd+Shift+P),输入并选择:
Python: Select Interpreter在下拉列表中,明确选择刚刚创建的 ./.venv/bin/python。配置完成后,Cursor 窗口右下角的状态栏会显示当前环境标识(如 ('.venv': venv))。
4. 确保 Codebase Indexing(代码库索引)处于活跃状态
点击右上角的齿轮设置图标进入 Cursor Settings -> 找到 Features 下的 Codebase Indexing。确认项目状态为 Indexed (100%)。若有新增的大批模块,可以点击 Resync Index 重新同步。只有完成索引,Cursor 在写 Python 时才能自动识别你在其他文件中定义的函数名和数据模型。
三、在 Cursor 中写 Python 的四种核心交互方式
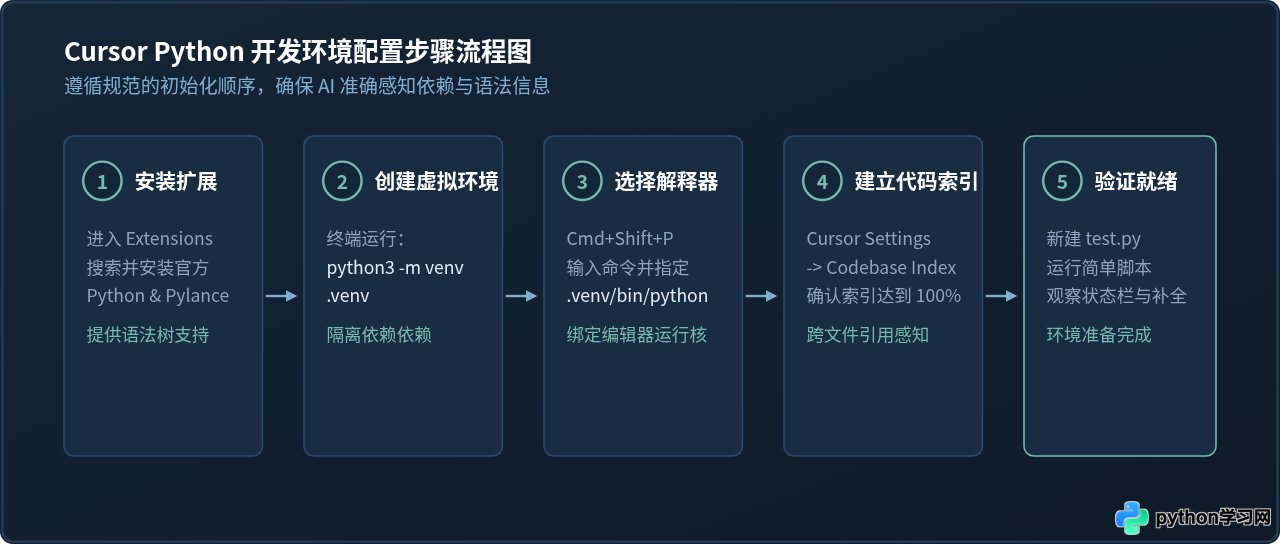
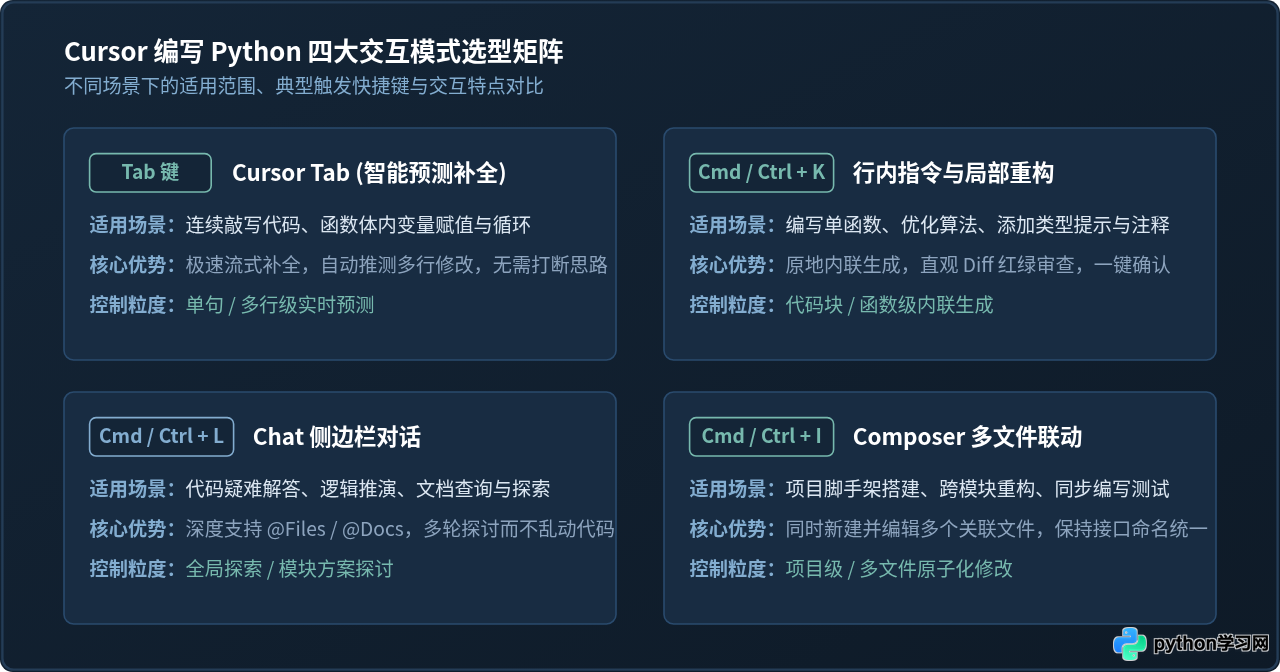
环境就绪后,进入实际写代码的环节。在 Cursor 中编写 Python,通常不是把需求写在外部网页聊天框里再粘贴回来,而是根据当前的开发粒度,灵活选用以下四种交互模式:
1. Cursor Tab:意图预测与多行续写
在编写 Python 函数时,Cursor 会实时分析当前文件的光标位置、导入的库以及临近代码结构。当你敲出函数名或 docstring 注释后,Cursor 会给出灰色半透明的建议代码:
- 按一下
Tab键:直接接受当前行或整段补全。 - 连续按
Tab:Cursor 会智能将光标推移到下一个建议编辑的位置(例如从函数体直接跳转到调用处的参数填充),极大减少机械键盘操作。
2. Cmd + K / Ctrl + K:行内精准生成与代码重构
这是日常编写具体 Python 函数或模块最常用的快捷方式。其使用场景分为两种:
- 空白行生成:在空白处按
Cmd+K,在弹出的输入浮窗中输入具体指令,例如:“编写一个用于解析 ISO8601 时间戳并返回本地时区的函数,要求使用 datetime 模块并做异常捕获”。Cursor 会在当前位置生成该函数。 - 局部选中重构:用光标选中一段已写好的代码(例如一个原本用
for循环写的耗时字典过滤),按Cmd+K输入:“改用字典推导式重写,并添加类型注解”。Cursor 会展示精确的红绿 Diff 比对,确认无误后点击Accept即可落地。
3. Cmd + L / Ctrl + L:侧边栏精准对话与上下文锚定
当你面临较复杂的架构设计、排查逻辑漏洞,或者需要针对特定文件提问时,按下 Cmd+L 打开右侧对话面板。此模式最关键的技术是 @ 符号上下文引用:
- 输入
@Files或@文件名.py:将指定的 Python 文件全文作为上下文喂给模型。 - 输入
@Folders:将整个目录的结构信息引入对话。 - 输入
@Codebase:让模型先对全局向量库进行混合语义检索,再给出综合解答。 - 输入
@Docs:引用官方或第三方库的公开文档(如FastAPI、Pandas官方文档)。
4. Composer(Cmd + I / Ctrl + I):多文件批量构建
如果你要从零搭建一个微型 Python 模块,往往需要同时新建 config.py、models.py、service.py 以及对应的 test_service.py。传统的单文件 AI 生成需要来回切换创建。而打开 Composer(Cmd+I),你可以直接下达复合指令:“基于 Pydantic v2 构建一套订单数据校验服务,包含数据模型文件 models.py、业务处理类 processor.py 和对应的 pytest 测试用例”。Cursor 会在左侧列出所有即将新增或修改的文件,并在右侧并行展示修改,支持一键全部保存(Accept All)。
四、实操示例:用 Cursor 编写一个标准的 Python 数据处理器
为了让步骤更加清晰,下面演示在 Cursor 中从零编写一个名为 LogMetricsProcessor 的 Python 数据处理类的全过程。
步骤 1:新建文件并使用 Cmd + K 引导骨架
在项目根目录下新建 log_processor.py 文件。在第 1 行直接按下 Cmd+K,输入明确的提示词:
“请编写一个名为 LogMetricsProcessor 的 Python 类。包含初始化方法、用于从 CSV 文件批量读取记录的方法 parse_csv、按用户 ID 聚合动作计数的 aggregate_metrics 方法。要求严格遵守 PEP 8 规范,使用 dataclass 封装单条记录,添加完整的类型提示(typing),并对文件不存在与格式异常进行恰当的捕获与日志记录。”
Cursor 迅速生成了完整的代码。点击浮窗右侧的 Accept 接受生成结果。以下为生成并落地的完整 Python 代码:
import csv
import logging
from dataclasses import dataclass
from pathlib import Path
from typing import Dict, List, Optional

# 配置模块日志记录
logging.basicConfig(level=logging.INFO, format="%(asctime)s - %(levelname)s - %(message)s")
logger = logging.getLogger(__name__)


@dataclass(frozen=True)
class LogRecord:
    """表示一条规范的用户行为日志数据结构"""
    user_id: str
    action: str
    timestamp: str
    ip_address: Optional[str] = None


class LogMetricsProcessor:
    """负责日志读取、有效性验证与指标聚合的处理类"""

    def __init__(self, source_path: str) -> None:
        self.source_path: Path = Path(source_path)
        self.records: List[LogRecord] = []

    def parse_csv(self) -> int:
        """读取 CSV 数据源,解析并过滤有效记录。返回成功读取的行数"""
        if not self.source_path.exists():
            logger.error("数据源文件不存在:%s", self.source_path)
            raise FileNotFoundError(f"文件未找到: {self.source_path}")

        loaded_count = 0
        try:
            with self.source_path.open(mode="r", encoding="utf-8") as file:
                reader = csv.DictReader(file)
                for line_num, row in enumerate(reader, start=2):
                    # 校验核心字段必填性
                    user_id = row.get("user_id", "").strip()
                    action = row.get("action", "").strip()
                    timestamp = row.get("timestamp", "").strip()

                    if not (user_id and action and timestamp):
                        logger.warning("第 %d 行数据缺失核心字段,已跳过: %s", line_num, row)
                        continue

                    self.records.append(
                        LogRecord(
                            user_id=user_id,
                            action=action,
                            timestamp=timestamp,
                            ip_address=row.get("ip_address"),
                        )
                    )
                    loaded_count += 1

            logger.info("成功加载 %d 条有效日志记录", loaded_count)
            return loaded_count

        except Exception as exc:
            logger.exception("解析 CSV 文件时发生异常: %s", exc)
            raise

    def aggregate_metrics(self) -> Dict[str, Dict[str, int]]:
        """按用户 ID 统计各项行为的频次"""
        metrics: Dict[str, Dict[str, int]] = {}

        for record in self.records:
            if record.user_id not in metrics:
                metrics[record.user_id] = {}
            user_actions = metrics[record.user_id]
            user_actions[record.action] = user_actions.get(record.action, 0) + 1

        return metrics


if __name__ == "__main__":
    # 模拟快速测试代码
    import tempfile

    # 创建一个临时测试 CSV 文件
    with tempfile.NamedTemporaryFile("w+", delete=False, suffix=".csv") as tmp:
        tmp.write("user_id,action,timestamp,ip_address\n")
        tmp.write("U101,login,2026-11-10T08:00:00,192.168.1.1\n")
        tmp.write("U101,click,2026-11-10T08:05:00,192.168.1.1\n")
        tmp.write("U102,login,2026-11-10T08:10:00,192.168.1.2\n")
        temp_path = tmp.name

    try:
        processor = LogMetricsProcessor(temp_path)
        processor.parse_csv()
        result = processor.aggregate_metrics()
        print("聚合结果:", result)
    finally:
        Path(temp_path).unlink(missing_ok=True)
步骤 2:使用 Cursor Tab 扩展单元测试
在当前目录下新建 test_log_processor.py。当你输入:
import pytest
from log_processor import LogMetricsProcessor
按下回车换行,Cursor 的 Cursor Tab 就会立即捕捉到上下文中的 parse_csv 和 aggregate_metrics 方法,自动给出完整的 test_parse_csv_file_not_found 和 test_aggregate_metrics_success 测试用例建议,按下 Tab 即可瞬间铺设好测试文件。
五、运行代码与一键修复报错(Fix in Chat)
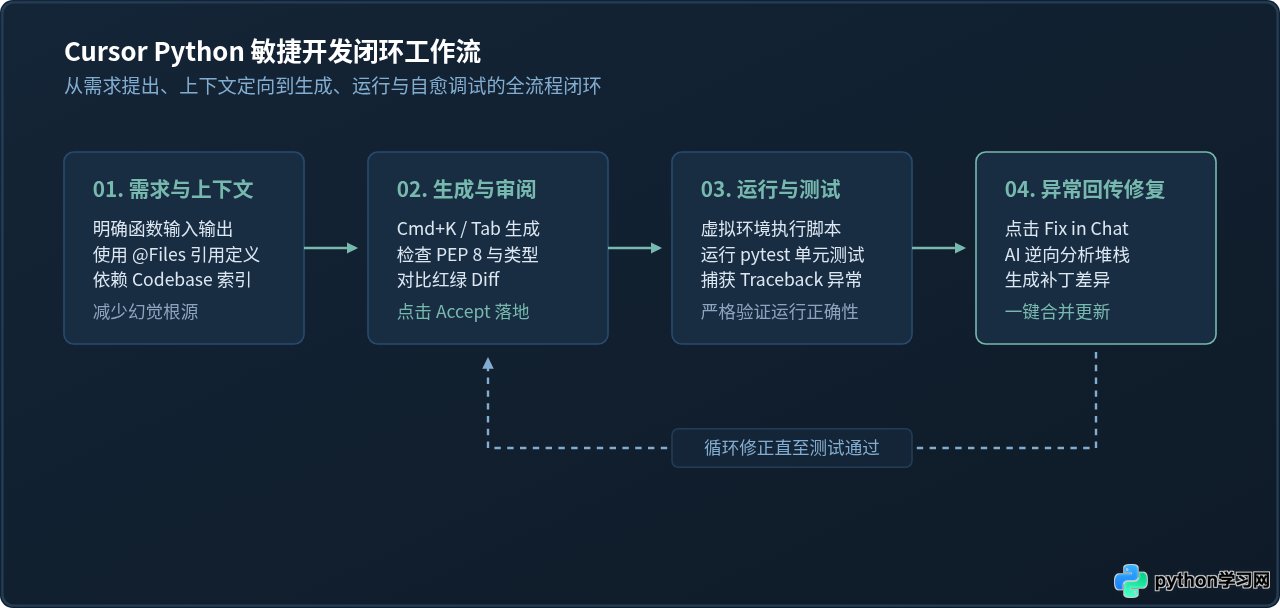
写完代码后,必须通过运行验证。Cursor 提供了与终端高度协同的报错修复闭环能力:
1. 终端运行与报错捕获
在 Cursor 底部终端中直接执行:
python log_processor.py如果由于数据类型或未安装三方库引发了异常(例如 ModuleNotFoundError 或 KeyError),终端输出红色的 Python 异常堆栈信息(Traceback)。
2. 使用“Fix in Chat”一键排查修复
在 Cursor 中,你可以直接划选终端中的报错堆栈信息,或者在出现报错后悬停在终端区域,点击弹出的 “Add to Chat” 或 “Fix in Chat” 按钮。Cursor 会自动完成三件事:
- 将具体的 Traceback 错误信息带入右侧 Chat 窗口。
- 根据堆栈精准定位到当前打开的某一行代码。
- 分析错误诱因,给出精准补丁,并在你点击 Apply 时直接将修改写回源文件。
六、写好 Python 的核心实践准则
在 Cursor 协助下写 Python,代码生成的上限很大程度取决于开发者给予的约束。以下几项务实准则能够大幅提升代码可靠性:
- 显式强制类型提示(Type Annotations):在提问或写注释时要求模型“使用严格的类型注解与 Pydantic/dataclass”。有了类型约束,Cursor 和 Pylance 能够第一时间发现参数类型错位。
- 控制修改粒度,避免“全盘重写”:尽量利用
Cmd+K针对单个函数或类进行操作。一次性要求重构整个庞大脚本,不仅消耗大量模型上下文,且容易遗漏原本已存在的边缘分支判断。 - 善用
.cursorrules固化团队规约:在项目根目录下创建.cursorrules文件,写入如“所有新函数必须包含中文 Google Style 文档字符串”、“单元测试一律使用 pytest”、“禁止使用全局变量”等规则。Cursor 在写任何 Python 逻辑时都会默认带入这些前置规范。
总结
Cursor 并不是一个简单的“问答机器人”,而是一套将现代大语言模型的语义生成能力与 VS Code 成熟 IDE 基础设施深度绑定的生产力环境。写 Python 时,最核心的动作不是被动等待 AI 给出答案,而是通过规范的环境配置(解释器与虚拟环境)、精准的交互模式选择(Tab、Cmd+K、Cmd+L、Composer)以及运行环境的严谨校验,让 AI 承担样板代码铺设、算法重构与异常追溯,开发者则专注在业务逻辑验证与架构把控上,构建起高效顺畅的开发闭环。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









