

Python内置函数有哪些?常用Built-in Functions分类详解
全面解析Python原生内置函数清单与分类机制。通过LEGB作用域查找原理、数学计算、序列迭代、对象反射及I/O操作等多维分类与高频避坑指南,帮助开发者高效选型并写出地道的Python代码。
在编写 Python 程序时,诸如 print()、len() 或 range() 等指令随时随地皆可调用,无需执行任何 import 导入操作。这些与生俱来的基础工具被称为内置函数(Built-in Functions)。在最新的 Python 3 标准库中,解释器直接暴露在顶层环境中的内置函数和基本内建类型总计约为 70 个。它们由底层 C 语言高度优化实现,是构筑 Python 高性能语法与地道习惯(Pythonic)的基石。
面对数十个内置函数,机械地死记硬背效率低下。本文将系统厘清内置函数在解释器中的加载机制,并按照数学计算、序列迭代、类型容器、对象自省、系统交互与高级执行六大高频场景展开逐项拆解与避坑说明。
一、内置函数的底层来源与作用域解析机制
打开任何 Python 交互式命令行(REPL),我们都可以通过访问内置模块 builtins 来检视当前环境拥有的全部内置标识符:
# 查看当前运行环境中所有的内置属性与函数清单
import builtins

all_builtins = [item for item in dir(builtins) if not item.startswith("_")]
print(f"内置符号总数: {len(all_builtins)}")
print("部分核心成员:", all_builtins[:10])
输出示例:
内置符号总数: 158
部分核心成员: ['ArithmeticError', 'AssertionError', 'AttributeError', 'BaseException', 'BlockingIOError', 'BrokenPipeError', 'BufferError', 'BytesWarning', 'ChildProcessError', 'ConnectionAbortedError']
在这 150 多个符号中,约半数是系统级内置异常类(如 ValueError、KeyError),其余约 70 个则是我们日常调用的内建函数与基本数据类型构造器。解释器在执行一个未声明来源的函数调用时,遵循著名的 LEGB 作用域解析规则。
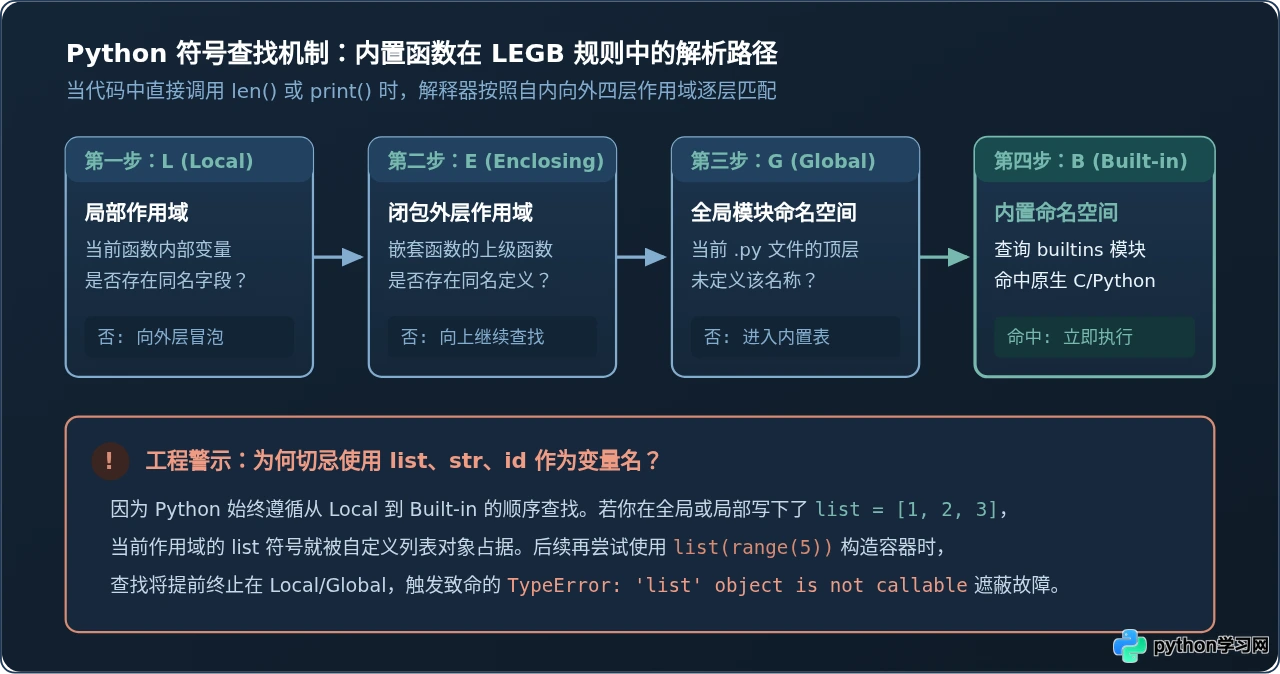
当我们在代码中书写 len("hello") 时,解释器按照固定步骤寻找目标符号:
- Local(局部作用域):首先排查当前函数体内是否定义了同名局部变量。
- Enclosing(嵌套外部作用域):若位于闭包函数内,则向上排查父级函数的命名空间。
- Global(全局作用域):排查当前模块(.py 文件)最外层是否定义了该同名变量。
- Built-in(内置命名空间):前三层均未命中时,才最终落入
builtins字典。
正因为 Built-in 处于解析链的最末端,如果在程序中将自定义变量命名为 list = [1, 2, 3] 或 str = "abc",全局或局部命名空间将立即截断对内置构造器的访问。后续代码执行 list(range(5)) 时,Python 将抛出 TypeError: 'list' object is not callable 错误。若需恢复,可通过 del list 删除当前变量,或使用 builtins.list() 显式调用。
二、常用内置函数核心分类详解
1. 数值计算与统计聚合
数学计算类内置函数用于处理基础数值的绝对值、四舍五入、极值运算与多项式聚合:
| 函数原型 | 功能概述 | 典型示例 | 工程细节与返回值 |
|---|---|---|---|
abs(x) |
求绝对值或复数模长 | abs(-42) -> 42 |
输入复数 abs(3+4j) 返回模长 5.0 |
round(number, [ndigits]) |
数值舍入 | round(3.14159, 2) -> 3.14 |
遵循银行家舍入法(四舍六入五成双) |
divmod(a, b) |
商与余数同步求解 | divmod(17, 5) -> (3, 2) |
相当于 (a // b, a % b),减少一次底层运算 |
pow(base, exp, [mod]) |
幂运算与模幂运算 | pow(2, 10) -> 1024 |
三参数 pow(base, exp, mod) 适合密码学快速求模 |
sum(iterable, start=0) |
序列累加求和 | sum([1, 2, 3], 10) -> 16 |
start 指定初始累加基准,不可用于连接字符串 |
min() / max() |
查找最小值 / 最大值 | max(['a', 'bbb'], key=len) -> 'bbb' |
支持 key 排序规则回调与空集合 default 保底参数 |
# 银行家舍入法特例分析(靠近偶数端舍入)
print(round(2.5))  # 输出 2 (2 是偶数)
print(round(3.5))  # 输出 4 (4 是偶数)

# min/max 配合 key 提取结构化数据极值
users = [{"name": "Alice", "score": 88}, {"name": "Bob", "score": 95}]
top_student = max(users, key=lambda u: u["score"], default=None)
print(f"最高分获得者: {top_student['name']}")
2. 序列操作与迭代流架构
Python 处理列表、元组、字符串等集合时,追求“高内聚与惰性计算”。核心内置函数构成了数据处理流水线。
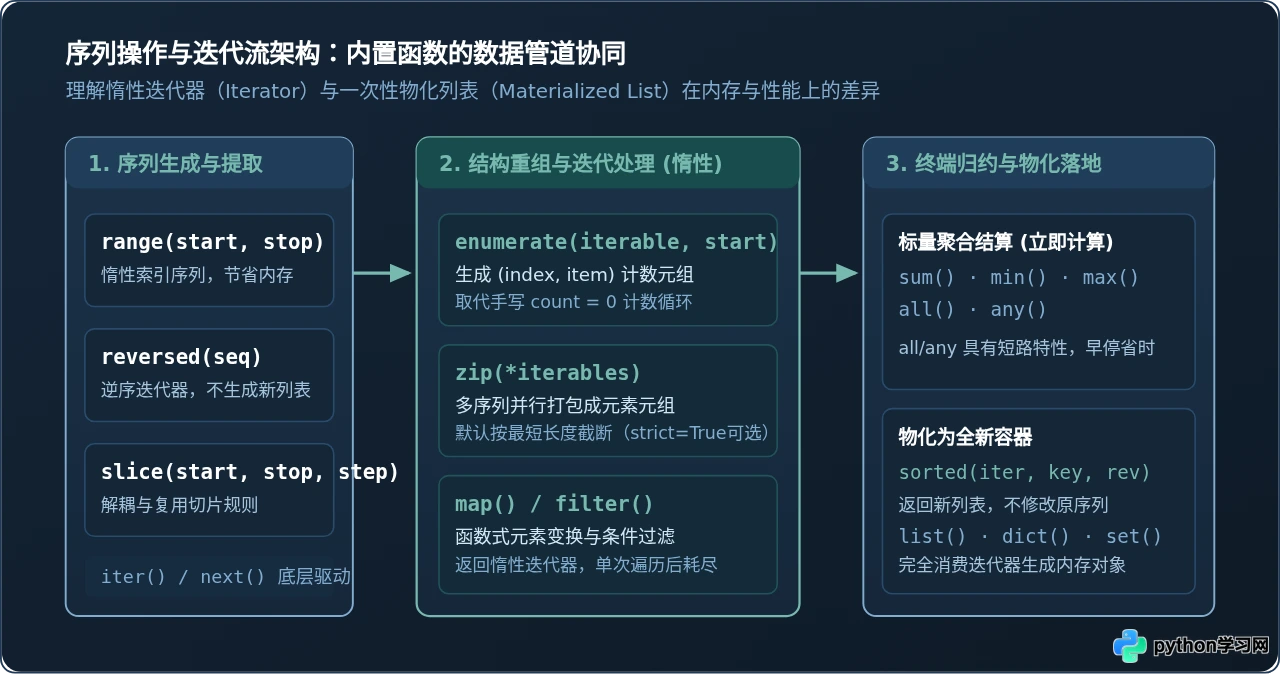
在日常开发中,应熟练运用以下几个高频迭代函数:
enumerate(iterable, start=0):将可迭代对象包装为包含序号和元素的元组迭代器。避免手写额外的index += 1递增计数器。zip(*iterables, strict=False):将多个序列对应位置的元素聚合配对成元组。在 Python 3.10+ 中,推荐在长度预期一致的场景下开启strict=True,以在输入长度不一致时立即抛出ValueError拦截逻辑缺陷。sorted(iterable, key=None, reverse=False):返回排序后的全新列表,原数据结构不受影响;与之相对的是list.sort()就地修改原地列表。reversed(seq):返回逆序迭代器,无需开辟完整新列表即可完成倒序扫描。
# 典型模式:并行迭代与带序号输出
headers = ["ID", "名称", "状态"]
values = [101, "服务节点A", "Running"]

# 使用 dict + zip 快速装配字典映射
row_dict = dict(zip(headers, values))
print("组装数据:", row_dict)

# 使用 enumerate 控制索引遍历
for idx, (k, v) in enumerate(row_dict.items(), start=1):
    print(f"列号 {idx}: {k} => {v}")
3. 逻辑判定与布尔归约
用于快速评估可迭代对象内元素的有效性状态:
bool(x):将目标值按照 Python 的 Truth Value Testing 规范判定为True或False。数字0、None、空容器([]、""、{})均视为假。all(iterable):当可迭代对象中所有元素均为真时返回True。如果序列中包含一个为假元素,立即短路返回False;若序列为空,恒为True(真空态)。any(iterable):只要可迭代对象中包含至少一个真值,立即短路返回True;若全部为假或序列为空,返回False。
# 典型场景:表单校验与权限门禁
permissions = [True, True, False]
can_access_all = all(permissions)  # False: 未满足全量条件
has_any_grant = any(permissions)   # True: 具备部分权限
print(f"全量授权: {can_access_all}, 最低权限: {has_any_grant}")
4. 对象检查与自省反射机制
Python 具备强动态反射能力。内置函数赋予开发者在运行时探查未知对象结构与安全操作属性的能力。
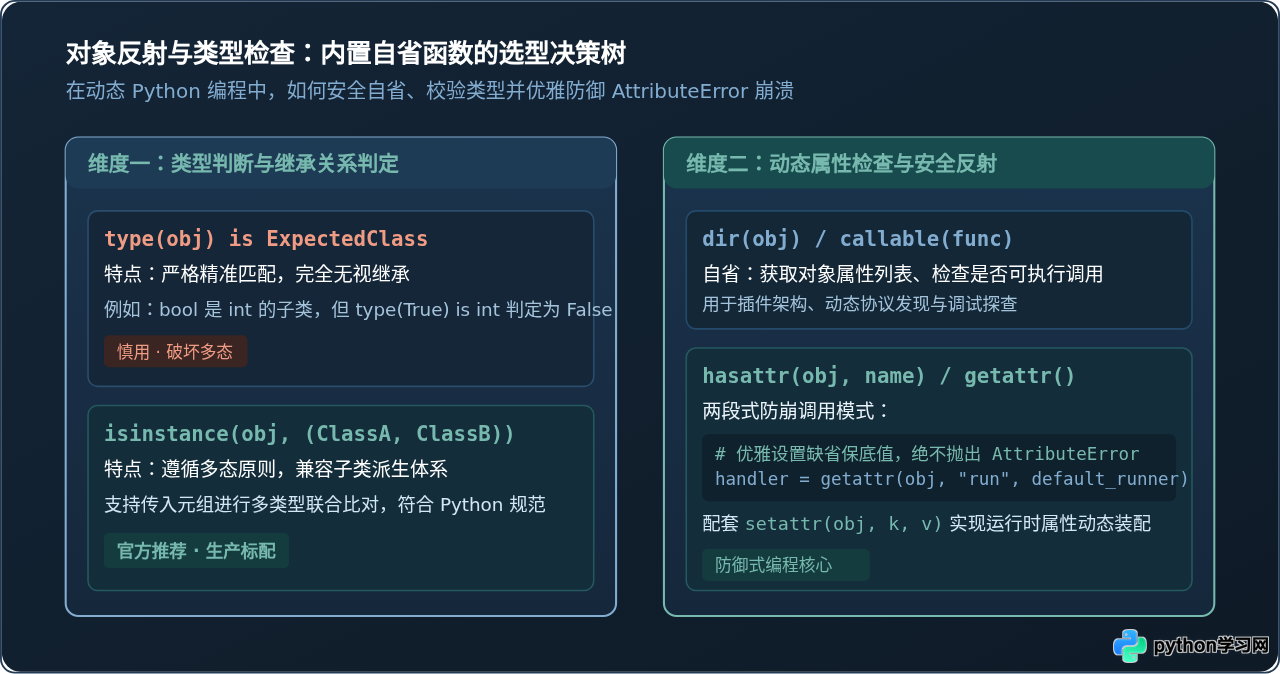
| 反射函数 | 作用与输入参数 | 工程推荐写法与对比 |
|---|---|---|
isinstance(obj, classinfo) |
检测对象是否属于指定类或其派生子类 | 支持元组匹配 isinstance(val, (int, float))。优于 type(),兼容多态继承。 |
issubclass(class, classinfo) |
检测一个类是否继承自另一个类 | 用于框架元编程与插件接口继承合法性校验。 |
getattr(obj, name, [default]) |
动态获取对象属性或方法 | 配置保底 default 参数,彻底避免抛出 AttributeError 崩溃。 |
hasattr(obj, name) |
判断对象是否存在指定属性 | 先检测后调用(LBYL 风格),但通常直接配合带默认值的 getattr() 更简洁。 |
setattr(obj, name, val) |
动态为对象装配属性或回调 | 用于动态打桩(Mock)、配置注入或 ORM 属性赋值。 |
callable(obj) |
判断目标是否为可执行对象(函数/类/实现了__call__) | 在调用动态加载的回调函数前作为防错门禁。 |
id() / hash() |
返回对象内存地址 / 对象的不可变哈希签名 | id(a) == id(b) 等价于 a is b;哈希值决定能否放入集合或作为字典键。 |
# 生产代码中的防御式属性获取与执行
class WorkerPlugin:
    def execute(self):
        return "任务执行成功"

plugin = WorkerPlugin()

# 1. 动态判断并提取可能存在的自定义清理方法
cleanup_func = getattr(plugin, "teardown", None)
if callable(cleanup_func):
    cleanup_func()
else:
    print("未提供 teardown 清理逻辑,跳过清理步骤")
5. 输入输出与运行环境交互
程序与终端、文件系统的交互离不开以下三个最底层的内置函数:
print(*objects, sep=' ', end='
', file=sys.stdout, flush=False)
: 除了默认打印,sep可自定义多个参数间的分隔符,end控制末尾换行行为,file可重定向输出至日志文件,flush=True强制清空标准输出缓冲区,适合控制台实时进度条输出。input([prompt]):暂停当前程序并读取用户在终端键入的一行字符串,统一返回str类型,需根据业务手动进行int()或float()转换。open(file, mode='r', buffering=-1, encoding=None, errors=None): 打开本地文件流。生产环境强烈要求显式声明encoding="utf-8",因为如果不显式传递,Windows 下解释器会默认使用当前操作系统的本地编码(如 GBK),导致跨平台读取时频繁出现乱码或UnicodeDecodeError。
# 规整的标准文本读取与实时缓冲刷新示范
with open("app_log.txt", mode="w", encoding="utf-8") as log_file:
    print("[INFO]", "系统初始化启动", sep=" | ", file=log_file, flush=True)
6. 高阶变换与动态执行(谨慎使用)
map(function, iterable)与filter(function, iterable):经典的函数式编程工具,返回惰性生成器。在现代 Python 规范中,对于简单逻辑,列表推导式(List Comprehension)比map/filter更具可读性且执行效率相近。eval(expression, globals=None, locals=None):执行由字符串形式表达的单个 Python 表达式并返回求值结果。高危风险函数:严禁对不受信任的网络输入或用户输入调用eval(),否则可能导致远程命令注入(RCE)。如需安全解析字符串字面量(如将字符串"[1, 2, 3]"转为列表),应使用ast.literal_eval()代替。exec(object, globals=None, locals=None):动态执行多行复杂的 Python 语句块,不返回直接结果,同样具备注入安全隐患。breakpoint():Python 3.7 加入的调试钩子,调用时自动调用底层pdb.set_trace(),是现代断点排查的标准写法。
三、内置函数使用中的高频易错点总结
诸如 zip()、map()、filter() 以及 reversed() 返回的都是单次迭代器,而不是保存在内存中的静态列表。一旦通过 for 循环或者 list() 遍历过一遍,该迭代器即刻枯竭。若在后续代码中尝试第二次遍历,将读不到任何数据:
data = zip([1, 2], ["a", "b"])
print(list(data))  # 输出: [(1, 'a'), (2, 'b')]
print(list(data)) # 输出: [] (已耗尽,第二次调用为空!)解决办法:如果数据需要多次反复使用,应在生成后立即显式调用 list() 或 tuple() 进行内存物化保存。
由于 IEEE 754 浮点数在计算机底层的二进制近似存储特性,某些十进制浮点数无法精确表示。例如 round(2.675, 2) 的实际计算结果为 2.67 而不是直觉上的 2.68,因为 2.675 在底层存储的值略小于该数字。涉及银行、交易和财务计算时,请直接引入标准库 decimal.Decimal 模块进行精准定点数舍入计算。
四、常用内置函数选型速查表
为了帮助日常编码快速做出工具选型,下表归纳了六大分类中最常用的 Built-in Functions 矩阵:
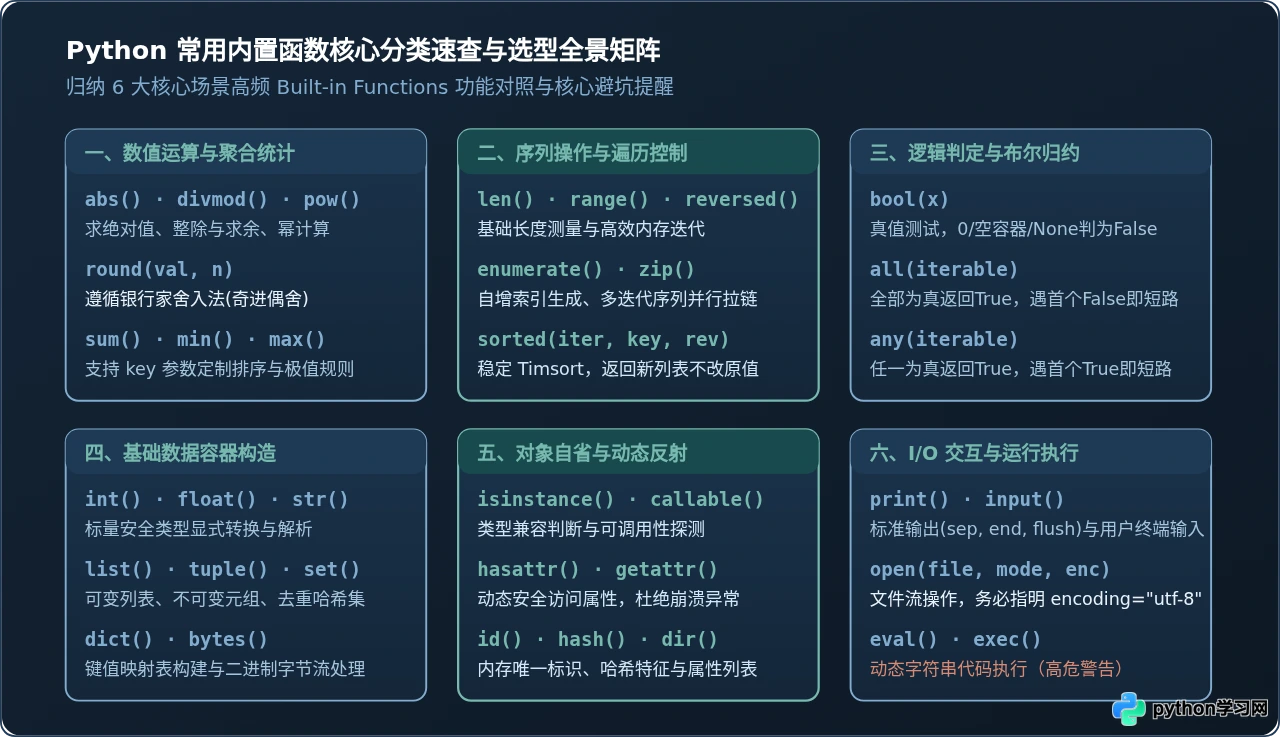
| 应用场景 | 首选内置函数 | 何时选用 / 最佳实践 |
|---|---|---|
| 计数与配对 | enumerate(), zip() |
需要同步获取元素及其数组下标,或同时并行遍历多个数据列时。 |
| 多维状态汇总 | all(), any() |
验证多个表单校验项全部通过,或至少命中一个权限策略的短路门禁。 |
| 非侵入式排序 | sorted() |
保持原始数据顺序不变的前提下生成排序结果,支持 key 复杂排序规则。 |
| 类型与继承检测 | isinstance() |
替代 type() == ...,确保面向对象继承多态特性能正常工作。 |
| 动态属性解耦 | getattr(), hasattr() |
根据字符串配置动态装配处理函数,配置默认值防止抛出异常崩溃。 |
| 跨平台文件写入 | open() |
必须主动指明 encoding="utf-8",杜绝跨系统运行时文本乱码。 |
掌握这批原生内置函数的功能边界与底层特性,不仅能使代码大幅精简、减少重复造轮子,更能充分利用 CPython 原生底层 C 实现的高执行效率,编写出兼具可读性与性能的地道 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









