

Python金融数据采集:股票与基金行情爬虫案例
面向金融量化分析与数据工程实践,深入讲解使用Python进行A股实时股票行情与公募基金历史净值时序数据的自动化采集。涵盖网络异步接口抓包逆向、轻量级HTTP请求构造、反爬频率保护、JSONP解析及Pandas时序清洗全流程。
requests 与 pandas 抓取 A 股实时股票行情列表与公募基金历史净值时序数据,同时解析数据反爬机制、接口参数逆向方法与关键的数据对齐陷阱。
一、金融行情数据传输机理与抓包定位
初次接触网络爬虫的开发者,往往习惯于把“爬网页”等同于“解析 HTML DOM 节点”。然而,金融行情具有实时变动频繁、数据结构规整、前端高频刷新的天然属性。各大证券门户与基金销售平台为了保证数以万计用户的低延迟浏览体验,绝不会在后端将几千只股票的最新价格逐一拼装到 HTML 标签里返回,而是采用“静态前端骨架 + 异步 API 批量获取数据”的架构。
这意味着,我们无需在 Python 中通过 BeautifulSoup 或 XPath 艰难地从密密麻麻的 <table>、<tr>、<td> 中抠取文字,更不需要启动占用数 GB 内存的 Selenium 或 Playwright 无头浏览器。直接定位底层数据 API,直接接收结构化的 JSON 或 JSONP 格式响应,采集速度可直接提升数十倍至上百倍。
常见看法:“金融网站防爬严密,页面很多图表和动态效果,必须用 Selenium 真实打开浏览器模拟翻页。”
实务修正:这种做法在金融数据采集场景下往往是“南辕北辙”。动态图表(如 ECharts、Highcharts)本身也是基于异步接口返回的数组渲染的;无头浏览器不仅消耗极高 CPU 与内存,还会在 navigator.webdriver、Canvas 指纹等层面暴露明显的自动化特征。真正的做法是打开浏览器开发者工具抓包,提取纯净的 HTTP 数据接口。
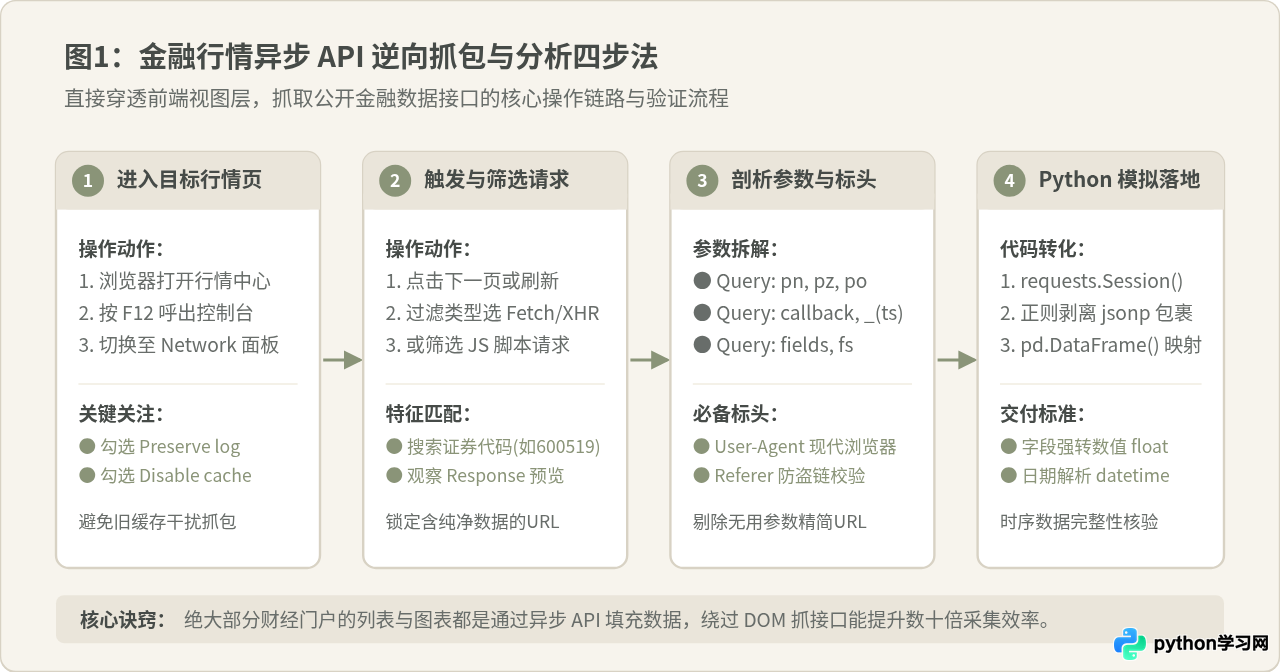
定位此类接口的标准步骤非常清晰:
- 开启开发者工具:在 Chrome 或 Edge 浏览器中访问股票或基金行情中心,按
F12展开控制台,切换至 Network(网络) 面板。 - 净化干扰项:勾选
Preserve log(保留日志)与Disable cache(停用缓存),将筛选标签切换至 Fetch/XHR 或 JS。 - 触发数据刷新:在页面上点击“下一页”或切换排序字段,观察网络面板新涌现出的网络请求。在过滤器中搜索特定股票代码(如
600519)或基金代码(如000001),通常能直接定位到返回数据的核心 URL。 - 精简请求参数:查看 Request Headers 与 Query String Parameters,剔除诸如前端随机追踪码、无用样式参数等冗余项,保留驱动数据分页与代码筛选的核心参数。
二、实战案例一:A股股票实时行情列表采集
国内公开行情中心(如东方财富网行情中心、新浪财经行情中心)均提供全市场的实时行情表格。通过抓包可以发现,股票列表请求通常指向一个包含证券类型、排序字段、分页索引与页长控制的统一接口。
1. 核心接口字段映射
金融接口为了减少传输字节数,键名往往采用代号形式(如 f12 代表证券代码,f14 代表名称,f2 代表最新价)。我们采集到数据后,必须在数据管道中建立语义清晰的映射字典:
| 原始字段代码 | 业务字段名称 | 数据类型 | 说明与清洗要求 |
|---|---|---|---|
f12 |
股票代码 (symbol) | 字符串 (str) | 需保留前导零(如 "000001"),不可转为整数 |
f14 |
股票名称 (name) | 字符串 (str) | 剔除多余空格与换行符 |
f2 |
最新价 (latest_price) | 浮点数 (float) | 原始数据通常需除以 100(或本身已是小数) |
f3 |
涨跌幅 (change_percent) | 浮点数 (float) | 单位为百分比(%),停牌或异常值需转为 NaN |
f5 |
成交量 (volume) | 整数 (int) | 单位通常为手(1手 = 100股) |
f6 |
成交额 (amount) | 浮点数 (float) | 单位通常为元,用于衡量市场资金活跃度 |
f9 |
市盈率动态 (pe_dynamic) | 浮点数 (float) | 亏损企业返回 "-",清洗时应转为 None 或 np.nan |
2. Python 完整采集代码
以下代码演示如何配置 requests.Session(),批量获取前两页(每页 50 只)A 股股票实时数据,并利用 pandas 清洗为规整的 DataFrame:
import time
import logging
import requests
import pandas as pd

# 配置基本日志格式
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class StockQuoteCrawler:
    """A股股票实时行情采集器"""

    BASE_URL = "https://push2.eastmoney.com/api/qt/clist/get"

    def __init__(self):
        self.session = requests.Session()
        # 配置合规标准的桌面端请求头
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                          "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
            "Referer": "https://quote.eastmoney.com/center/gridlist.html",
            "Accept": "application/json, text/javascript, */*; q=0.01",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        })

        # 字段代码与标准列名映射表
        self.field_map = {
            "f12": "symbol",          # 股票代码
            "f14": "name",            # 股票名称
            "f2": "latest_price",     # 最新价格
            "f3": "change_percent",   # 涨跌幅(%)
            "f4": "change_amount",    # 涨跌额
            "f5": "volume",           # 成交量(手)
            "f6": "turnover",         # 成交额(元)
            "f9": "pe_ratio",         # 动态市盈率
        }

    def fetch_page(self, page_index: int = 1, page_size: int = 50, retries: int = 3) -> list:
        """抓取单页股票行情数据,支持失败重试"""
        params = {
            "pn": page_index,
            "pz": page_size,
            "po": "1",          # 降序
            "np": "1",
            "ut": "bd1d9ddb04089700cf9c27f6f7426281",
            "fltt": "2",
            "invt": "2",
            "fid": "f3",        # 按涨跌幅排序
            "fs": "m:0+t:6,m:0+t:80,m:1+t:2,m:1+t:23", # 沪深主板与创业板
            "fields": ",".join(self.field_map.keys()),
            "_": int(time.time() * 1000)
        }

        for attempt in range(1, retries + 1):
            try:
                response = self.session.get(self.BASE_URL, params=params, timeout=5)
                response.raise_for_status()
                data = response.json()

                # 校验核心结构有效性
                diff_list = data.get("data", {}).get("diff", [])
                if isinstance(diff_list, list):
                    return diff_list
                return []
            except (requests.RequestException, ValueError) as err:
                logging.warning(f"第 {page_index} 页抓取失败(第{attempt}次重试): {err}")
                time.sleep(attempt * 1.0)

        logging.error(f"第 {page_index} 页最终抓取失败,跳过。")
        return []

    def crawl_market_quotes(self, total_pages: int = 2) -> pd.DataFrame:
        """按页抓取并清洗为结构化 DataFrame"""
        all_records = []
        for page in range(1, total_pages + 1):
            logging.info(f"正在抓取第 {page}/{total_pages} 页股票行情...")
            raw_batch = self.fetch_page(page_index=page)
            if not raw_batch:
                break

            for item in raw_batch:
                # 过滤并重命名键
                cleaned_item = {
                    standard_col: item.get(raw_key)
                    for raw_key, standard_col in self.field_map.items()
                }
                all_records.append(cleaned_item)

            # 礼貌性请求间隔,降低服务器压力
            time.sleep(0.6)

        df = pd.DataFrame(all_records)
        if df.empty:
            return df

        # 数据类型强转与异常处理
        df["symbol"] = df["symbol"].astype(str).str.zfill(6)
        numeric_cols = ["latest_price", "change_percent", "change_amount", "volume", "turnover", "pe_ratio"]
        for col in numeric_cols:
            df[col] = pd.to_numeric(df[col], errors="coerce")

        return df

if __name__ == "__main__":
    crawler = StockQuoteCrawler()
    stock_df = crawler.crawl_market_quotes(total_pages=2)
    print(f"\n抓取完成,共获得 {len(stock_df)} 条股票记录。前 5 条样本:")
    print(stock_df.head(5))
三、实战案例二:公募基金历史净值时序采集
与股票按秒更新的交易盘口不同,公募基金(开放式契约型基金)是以“日”为频次进行清算的。每个交易日闭市后,基金托管人与管理人进行会计估值,于当晚公布该交易日的单位净值(Unit Net Value)与累计净值(Accumulated Net Value)。
常见误区:“我看某基金单位净值从 3.5 元跌到了 1.8 元,这只基金是不是发生了严重亏损?”
原因解释:开放式基金在运作过程中会进行现金分红或份额拆分。发生分红拆分时,基金会主动从每份净资产中扣除分红金额派发现金,导致单位净值在除息日瞬间大幅回落。实际上投资者的总资产(份额净值 + 现金)并未亏损。
纠偏原则:在抓取基金净值并计算历史年化收益率、最大回撤等指标时,必须使用“累计净值”或计算“复权净值”。忽略这一点的时序分析,得出的投资结论将完全失真。
1. JSONP 协议解析技巧
国内主流基金数据平台(如天天基金网开放接口)的历史净值接口通常以 JSONP (JSON with Padding) 协议返回数据。请求格式如下:
jQuery183072_1714529000({
  "Data": {
    "LSJZList": [
      {"FSRQ":"2026-10-30","DWJZ":"1.2840","LJJZ":"3.8560","JZZZL":"0.82","SGZT":"开放申购","SHZT":"开放赎回"},
      {"FSRQ":"2026-10-29","DWJZ":"1.2735","LJJZ":"3.8455","JZZZL":"-0.45","SGZT":"开放申购","SHZT":"开放赎回"}
    ],
    "TotalCount": 1420
  }
})
JSONP 并不是标准 JSON,直接调用 response.json() 会报 JSONDecodeError。我们需要使用正则表达式将最外层的 jQuery...(...) 剥除,仅保留内部的 JSON 字符串。
2. 基金历史净值爬虫代码实现
import re
import json
import time
import logging
import requests
import pandas as pd

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class FundNetValueCrawler:
    """公募基金历史净值采集器"""

    BASE_URL = "https://api.fund.eastmoney.com/f10/lsjz"

    def __init__(self):
        self.session = requests.Session()
        # 基金接口严格校验 Referer 与 User-Agent
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                          "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/121.0.0.0 Safari/537.36",
            "Referer": "https://fundf10.eastmoney.com/",
            "Accept": "*/*"
        })

    @staticmethod
    def _extract_jsonp(raw_text: str) -> dict:
        """从 JSONP 字符串中利用正则提取出标准 dict"""
        match = re.search(r"^[a-zA-Z0-9_]+\s*\((.*)\)\s*;?$", raw_text.strip(), re.DOTALL)
        if match:
            json_str = match.group(1)
            return json.loads(json_str)
        # 如果不是严格 JSONP,尝试直接解析
        return json.loads(raw_text)

    def fetch_fund_history(self, fund_code: str, start_date: str = "", end_date: str = "", max_pages: int = 3) -> pd.DataFrame:
        """
        按基金代码获取历史净值时序
        :param fund_code: 6位基金代码,如 '000001' (华夏成长)
        :param start_date: 起始日期,格式 'YYYY-MM-DD'
        :param end_date: 截止日期,格式 'YYYY-MM-DD'
        :param max_pages: 抓取页数限制
        """
        records = []
        for page in range(1, max_pages + 1):
            params = {
                "fundCode": fund_code,
                "pageIndex": page,
                "pageSize": 20,
                "startDate": start_date,
                "endDate": end_date,
                "_": int(time.time() * 1000)
            }

            try:
                logging.info(f"正在获取基金 {fund_code} 净值:第 {page} 页...")
                resp = self.session.get(self.BASE_URL, params=params, timeout=5)
                resp.raise_for_status()
                data = self._extract_jsonp(resp.text)

                lsjz_list = data.get("Data", {}).get("LSJZList", [])
                if not lsjz_list:
                    logging.info("已无更多净值记录,结束翻页。")
                    break

                records.extend(lsjz_list)
                time.sleep(0.5)
            except Exception as e:
                logging.error(f"获取基金 {fund_code} 第 {page} 页失败: {e}")
                break

        if not records:
            return pd.DataFrame()

        df = pd.DataFrame(records)
        # 字段规范化映射
        df = df.rename(columns={
            "FSRQ": "date",                # 净值日期
            "DWJZ": "unit_net_value",      # 单位净值
            "LJJZ": "accum_net_value",     # 累计净值
            "JZZZL": "daily_growth_rate",  # 日增长率(%)
            "SGZT": "purchase_status",     # 申购状态
            "SHZT": "redemption_status",   # 赎回状态
        })

        # 时序转换与数值类型规整
        df["date"] = pd.to_datetime(df["date"])
        df["unit_net_value"] = pd.to_numeric(df["unit_net_value"], errors="coerce")
        df["accum_net_value"] = pd.to_numeric(df["accum_net_value"], errors="coerce")
        df["daily_growth_rate"] = pd.to_numeric(df["daily_growth_rate"], errors="coerce")

        # 按照日期升序排列(适应回测时序)
        df = df.sort_values(by="date", ascending=True).reset_index(drop=True)
        return df

if __name__ == "__main__":
    fund_crawler = FundNetValueCrawler()
    # 以华夏成长混合(000001)为例抓取最近记录
    fund_df = fund_crawler.fetch_fund_history(fund_code="000001", max_pages=2)
    print(f"\n基金 000001 净值时序采集完毕,共 {len(fund_df)} 条记录:")
    print(fund_df[["date", "unit_net_value", "accum_net_value", "daily_growth_rate"]].tail(5))
四、架构设计:DOM渲染 vs API直连的深度权衡
为了在生产环境中保障金融数据采集的稳定性与低故障率,我们需要在技术选型上树立严谨的工程思维。金融行情具有高时效、大批量的特点,下表系统性对比了两种爬虫路径的本质差异:
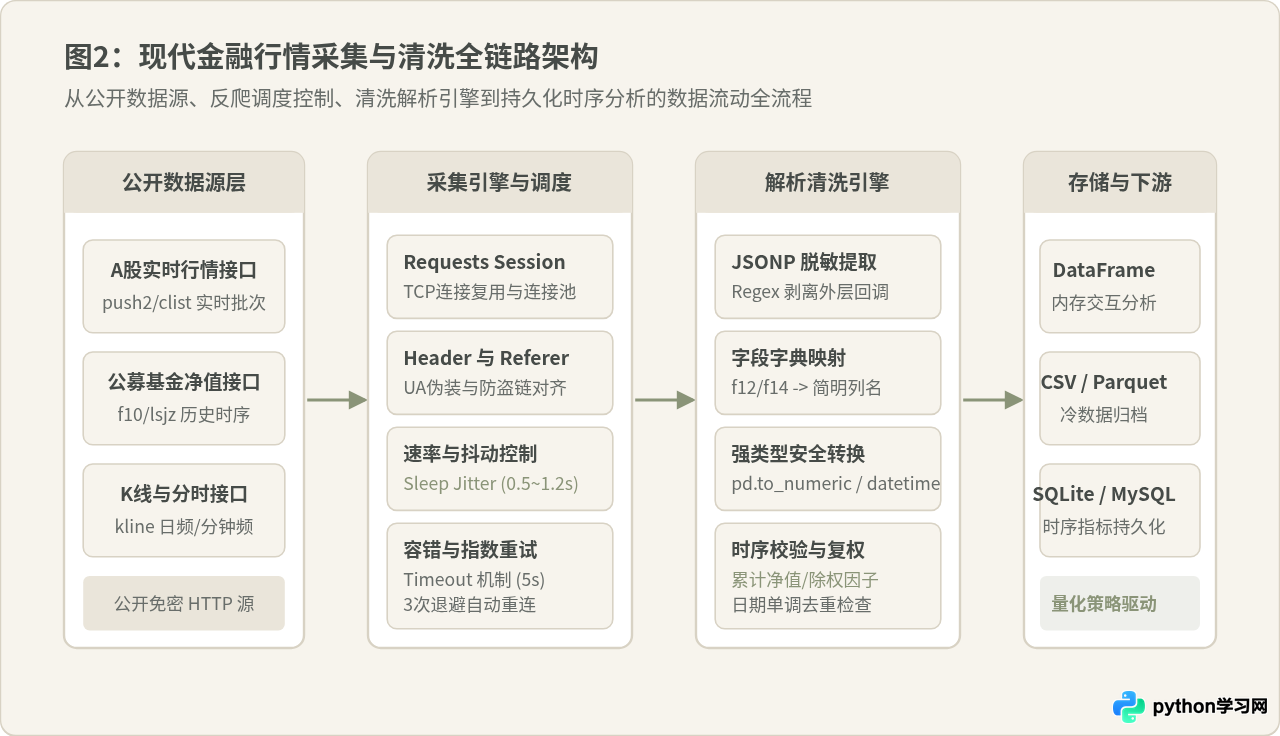
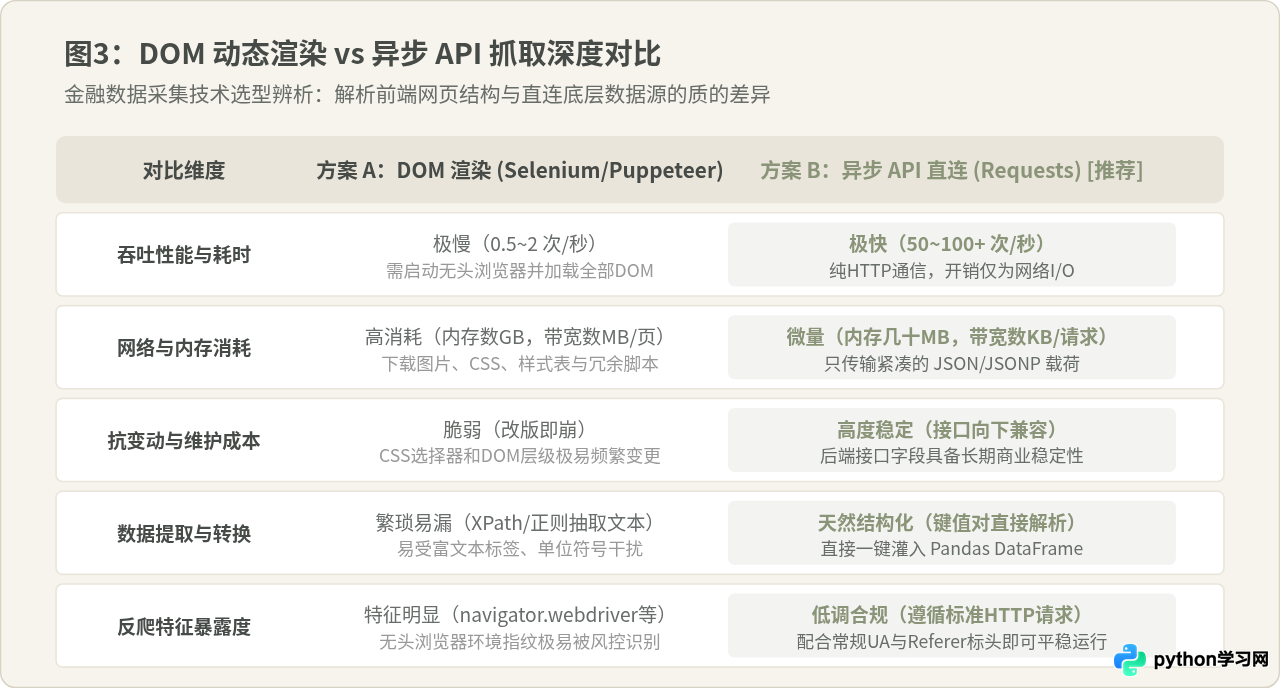
从架构角度看,直接基于公开 HTTP 接口的采集引擎具备极高的性价比。配合 requests.Session 复用底层 TCP 连接,可以规避无头浏览器频繁创建、销毁进程的巨大负担,将有限的服务器资源聚焦于数据校验与特征工程。
五、金融爬虫防反爬与工程健壮性设计
虽然公开行情接口通常没有强制的登录验证,但高频突发请求极易触发机房防火墙的 WAF(Web Application Firewall)风控策略,导致 IP 被临时拉黑封禁(返回 403 Forbidden 或连接被重置)。为保障采集任务长周期平稳运行,需严格贯彻以下防御性编程原则:
1. 自适应随机延时(Jitter)
固定周期的 time.sleep(1.0) 具有极其规律的机器指纹,非常容易被统计学风控模型捕获。在请求间隙引入正态分布或均匀分布的浮动延时(例如在 0.6 秒到 1.5 秒之间随机浮动),能显著平滑流量峰值:
import random
import time

def polite_sleep(base_seconds: float = 0.8, jitter: float = 0.4):
    """加入随机抖动的优雅睡眠"""
    sleep_time = max(0.2, base_seconds + random.uniform(-jitter, jitter))
    time.sleep(sleep_time)
2. 请求头(Headers)与防盗链对齐
许多开发者使用 requests 抓取时遭遇 403,往往是因为缺少了关键的 Referer 标头。金融机构的 CDN 节点通常设置了防盗链校验,若 Referer 为空或来自非官方域名,请求将被直接拒绝。务必确保 User-Agent 与 Referer 严格模拟真实网页的访问上下文。
3. 指数退避与自动熔断
网络抖动或远端服务端偶发波动在金融爬虫中是常态。切忌在抓取失败时立刻死循环重试,而应采用指数退避(Exponential Backoff)策略:第一次失败等待 1 秒,第二次等待 2 秒,第三次等待 4 秒。若连续多次失败,触发报警并暂停任务,保护本地 IP 免受拉黑。
六、金融数据工程质量保障与规范化总结
金融数据采集绝非“把文本存进数据库”就大功告成。由于后续往往直接对接投资回测模型或风险评估矩阵,数据的一致性、单调性与空值率必须经过严格的质量巡检。
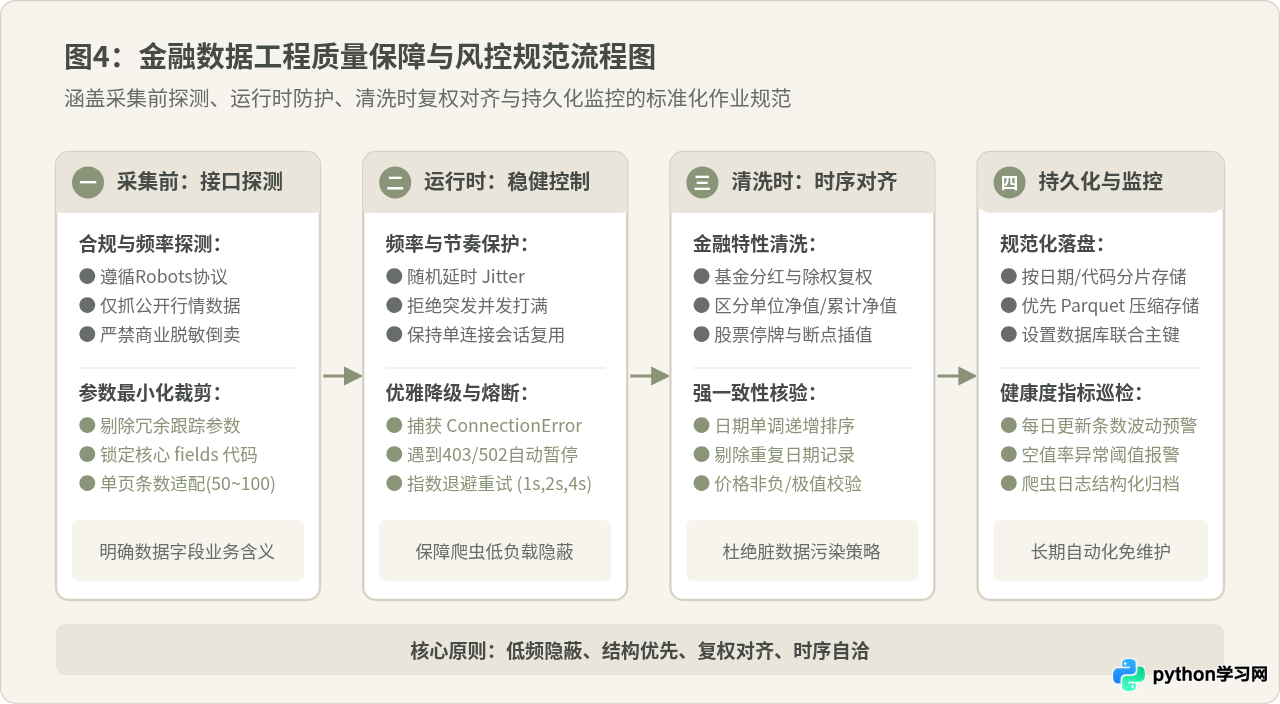
- 时间戳单调性校验:时序数据(如 K 线与基金净值)日期必须严格单调递增,严禁出现乱序、重复日期或未来时间戳。
- 数值界限合理性核验:股票价格必须大于 0;A 股除上市首日等特殊情况外,普通股票日涨跌幅正常处于 -10% 到 +10% 区间(科创板/创业板为 -20% 到 +20%),偏离阈值须自动触发警报。
- 除权除息与停牌标识:当股票停牌时,成交量为 0,价格通常沿用前一交易日收盘价;基金发生分红时,需明确记录分红金额,以便下游换算复权净值。
- 强类型持久化:证券代码必须统一固化为带前导零的字符串类型(推荐加上市场前缀,如
SH600519、SZ000001),严防因隐式转换为整数而丢失前导零;价格字段统一转为标准浮点数或高精度 Decimal。
持久化存储建议:对于个人或小团队中低频(日频、周频)的行情分析,推荐将清洗后的时序数据按“代码/年份”分区持久化为轻量高效的 Parquet 文件或存入 SQLite 关系型数据库;对于高频分笔(Tick)数据,则宜采用专业的时序数据库(如 TDengine、ClickHouse)进行列式压缩归档。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









