

Python中可迭代对象与迭代器的区别:for循环实质转换机制详解
深入解析Python中可迭代对象(Iterable)与迭代器(Iterator)的核心区别,从抽象协议、内存模型到CPython字节码层面详解for循环的实质转换与执行机制。
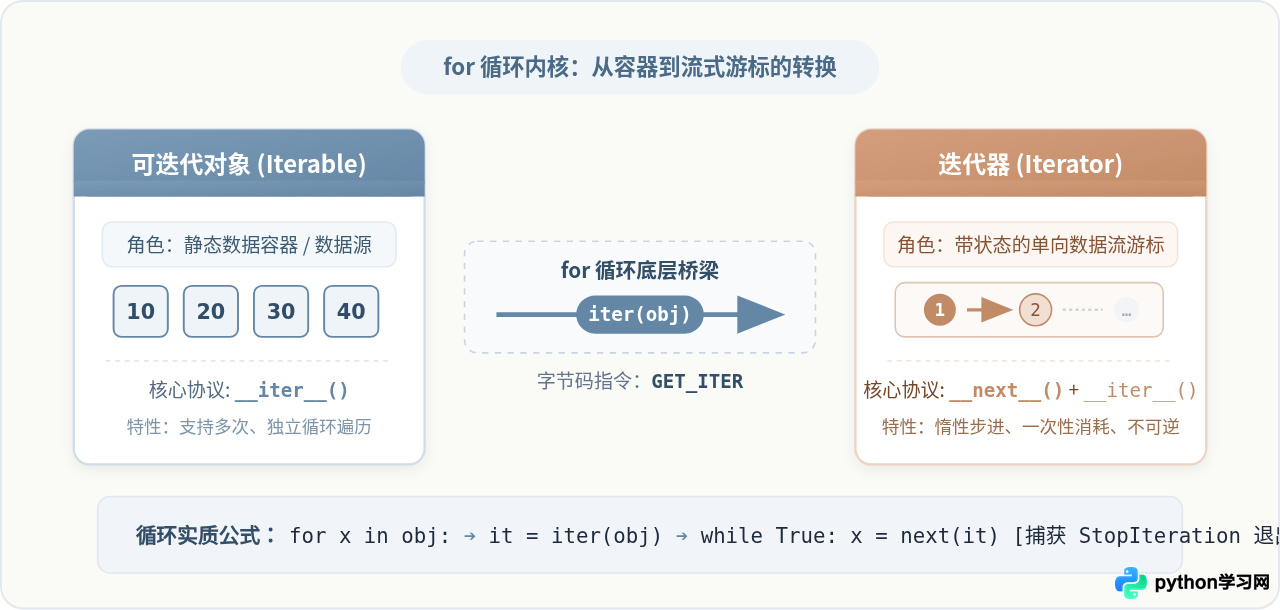
for 循环本质上是一个语法糖,其底层会自动调用 iter() 将目标容器转换为迭代器,再通过无限循环与 next() 步进提取数据,并在捕获 StopIteration 异常后优雅退出。本文将从协议定义、转换流程、内存行为和底层字节码四个维度完整拆解这一核心机制。
一、核心定义:可迭代对象与迭代器的协议分工
Python 并没有通过严格的类型继承来束缚多态,而是采用“鸭子类型(Duck Typing)”与“协议(Protocol)”。判断一个对象到底属于可迭代对象还是迭代器,唯一的依据是它实现了哪些魔术方法。
1. 可迭代对象(Iterable)
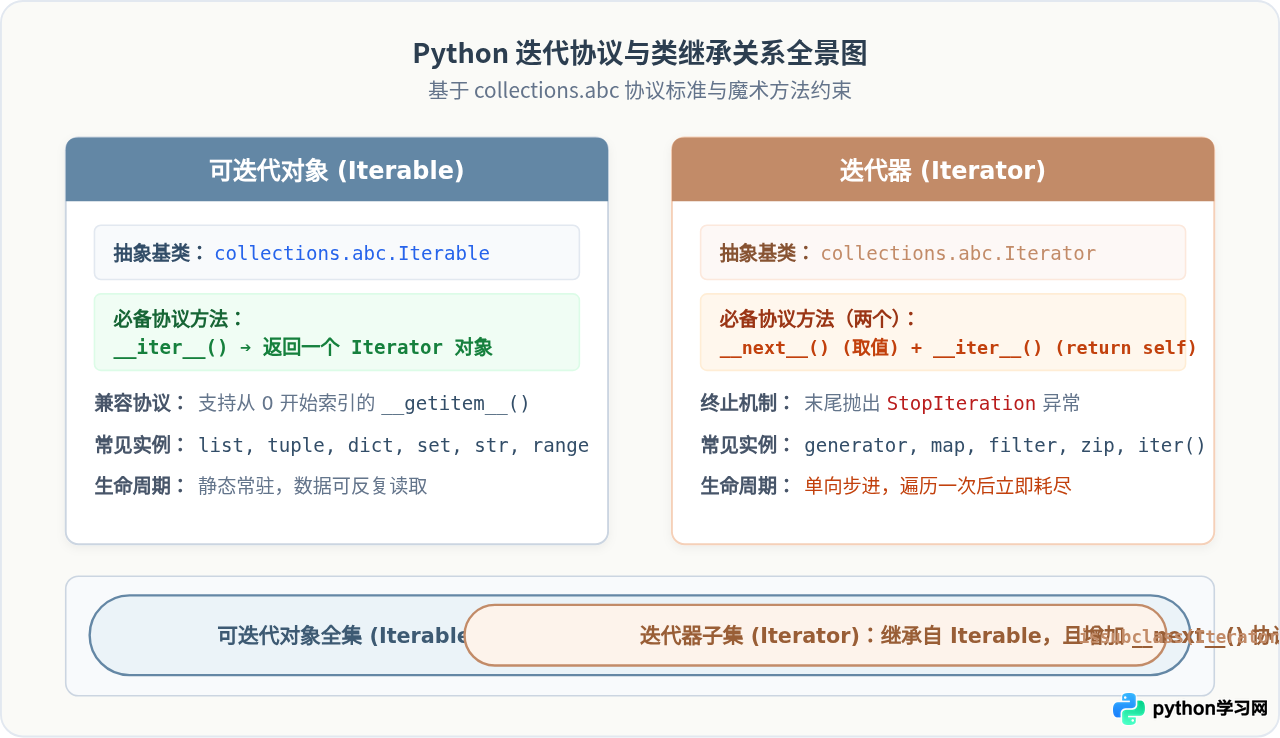
可迭代对象是具备遍历潜力的实体。只要一个对象能够向外界提供一个用于遍历自身的迭代器,它就是可迭代对象。在 Python 协议中,满足以下两个条件之一即可:
- 标准协议:实现了
__iter__()方法,且该方法返回一个合法的迭代器对象。 - 序列后备协议:实现了
__getitem__()方法,且能够接受从0开始的整数索引依次取值(当找不到__iter__时,Python 解释器会回退尝试该路径以兼容传统序列)。
日常编码中常见的 list、tuple、dict、set、str 以及 range 等,都属于典型的可迭代对象。它们通常在内存中完整存储或具备固定的计算规则,支持重复遍历。
2. 迭代器(Iterator)
迭代器是真正执行遍历动作、记录当前遍历进度的流式数据发生器。它必须同时实现以下两个魔术方法,即完整的迭代器协议(Iterator Protocol):
__next__():返回流中的下一个可用元素。如果数据已全部产生完毕,必须抛出StopIteration异常来标识迭代终止。__iter__():直接返回迭代器自身(通常即return self)。这使得迭代器本身也成为一个合法的可迭代对象,可以直接传入for循环中。
3. 代码验证二者的从属关系
通过标准库 collections.abc 模块提供的抽象基类,我们可以通过具体代码精准验证对象的类型归属:
from collections.abc import Iterable, Iterator

numbers = [10, 20, 30]

# 验证普通列表
print(isinstance(numbers, Iterable))  # 输出: True
print(isinstance(numbers, Iterator))  # 输出: False(列表是可迭代对象,但不是迭代器)

# 获取列表对应的迭代器
num_iter = iter(numbers)
print(isinstance(num_iter, Iterable)) # 输出: True(所有迭代器都是可迭代对象)
print(isinstance(num_iter, Iterator)) # 输出: True
从输出可以明确得出结论:所有的迭代器都是可迭代对象,但可迭代对象并不一定是迭代器。list 本身不具备 __next__() 方法,无法直接调用 next(numbers),否则会直接引发 TypeError: 'list' object is not an iterator。
二、机制揭秘:for 循环的底层实质转换机制
在日常开发中,我们写下 for item in collection: 时,语法看起来非常直观。但 CPU 与解释器无法直接对一个复杂的集合结构凭空进行“逐项扫描”。Python 解释器在执行 for 循环时,实质上做了一系列严密的等价转换。
1. Python 伪代码等价还原
一段常规的 for 循环代码在解释器中的运行机制,完全等价于下方的 while 循环与异常捕获逻辑:
# ==================== 语法糖写法 ====================
for item in ["A", "B", "C"]:
    print(item)

# ==================== 底层实质执行逻辑 ====================
_source = ["A", "B", "C"]

# 第一步:隐式调用 iter() 获取迭代器
_iterator = iter(_source)

# 第二步:开启无限循环,通过 next() 逐个步进提取
while True:
    try:
        item = next(_iterator)
    except StopIteration:
        # 第三步:捕获到终止信号,优雅退出循环
        break
    else:
        # 第四步:若成功获取元素,则执行循环体
        print(item)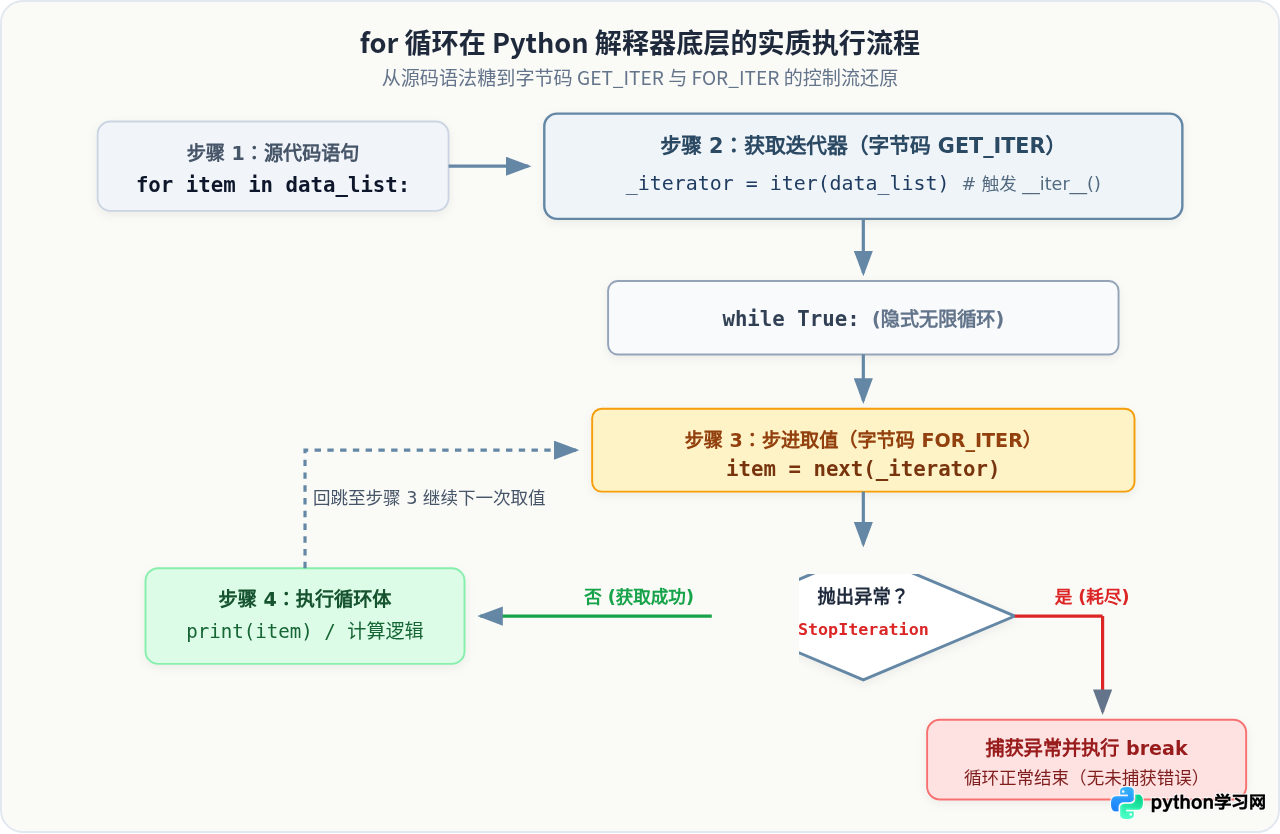
2. CPython 字节码层面验证
我们可以使用 Python 内置的 dis 模块反编译简单的 for 循环函数,观察解释器生成的真实字节码指令:
import dis

def run_loop():
    for x in [1, 2]:
        pass

dis.dis(run_loop)
在标准 CPython 3 运行环境下,控制台会输出类似如下的汇编级字节码指令:
  2           0 BUILD_LIST               0
              2 LOAD_CONST               1 ((1, 2))
              4 LIST_EXTEND              1
              6 GET_ITER                           <-- 关键指令 1:从栈顶对象获取迭代器
        >>    8 FOR_ITER                 4 (to 18) <-- 关键指令 2:尝试取出下一个元素
             10 STORE_FAST               0 (x)
             12 JUMP_BACKWARD            3 (to 8)  <-- 回跳继续循环取值
        >>   18 LOAD_CONST               0 (None)  <-- 迭代器耗尽后自动跳转到此(循环结束)
             20 RETURN_VALUE
字节码中的两步极为关键:
GET_ITER:对应底层 C 函数PyObject_GetIter(),负责检查对象并返回对应的迭代器游标。FOR_ITER:对应底层 C 函数tp_iternext,每次循环检查是否有下一个值。如果有,将值压入虚拟机计算栈供循环体使用;如果迭代器耗尽,内部吞掉StopIteration并将程序计数器跳转到循环体之后的代码地址。
三、行为与内存特性的三项核心差异
在搞清了协议与转换机制后,可迭代对象与迭代器在实际运行过程中的具体行为差异主要体现在以下三个方面:
1. 状态可复用性与一次性消耗
可迭代容器对象在遍历时,每次调用 iter() 都会产生一个全新的独立迭代器,因此容器可以被无数次循环遍历。而迭代器自身就是游标本身,游标只能单向向前推进,遍历完一次后便进入耗尽状态(Exhausted)。
raw_list = [1, 2, 3]
list_iterator = iter(raw_list)

# 第一次对迭代器遍历
print(list(list_iterator))  # 输出: [1, 2, 3]

# 第二次对同一迭代器遍历
print(list(list_iterator))  # 输出: [](已耗尽,不会重新从头开始!)

# 对原始列表重新遍历
print(list(raw_list))       # 输出: [1, 2, 3](容器不受影响)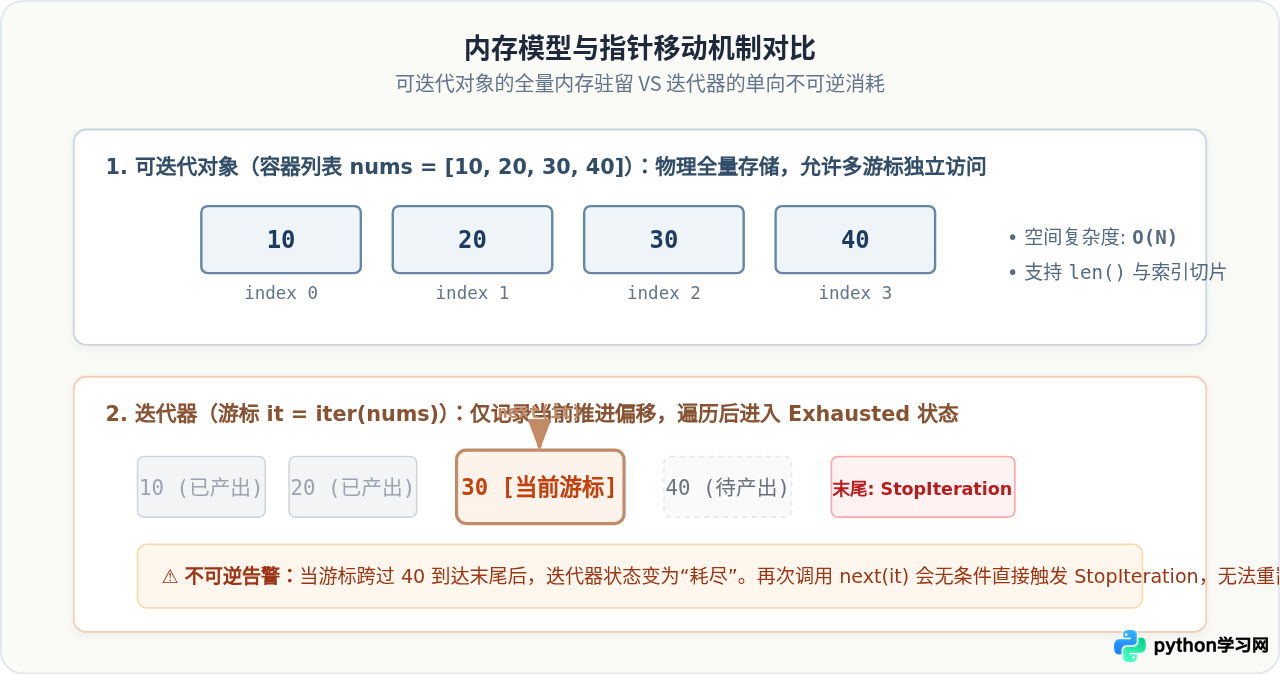
2. 内存空间占用:O(N) 还是 O(1)
对于包含数百万甚至数千万级元素的场景,两者在内存表现上有质的区别。列表等可迭代对象必须把每个元素都在内存中分配空间并长期保持;而迭代器采用惰性求值(Lazy Evaluation),只有在被外部调用 next() 的瞬间才会动态计算并产出下一个值,计算完即丢弃上一项,其内存空间占用始终为常数阶 O(1)。
import sys

# 创建包含 1,000,000 个整数的列表容器
big_list = [i for i in range(1_000_000)]
print(sys.getsizeof(big_list))      # 输出约: 8448728 字节 (约 8.4 MB)

# 创建对应的一百万个整数生成器(迭代器)
big_iter = (i for i in range(1_000_000))
print(sys.getsizeof(big_iter))      # 输出仅: 200 字节 (极小的游标元数据)
3. 支持的内置操作不同
可迭代容器通常支持计算总长度 len(obj) 和按索引切片 obj[0];但迭代器不支持 len() 也无法使用索引访问。因为流式数据可能是动态产生、甚至无限延展的(例如从套接字网络流或文件读取),在未完整读取之前无法预知总数。
四、动手实现:自定义可迭代对象与迭代器
为了从代码骨架上彻底掌握这种设计模式,我们可以模仿内置 range,编写一套严格分离的可迭代容器类与专属迭代器类。
class CountdownIterator:
    """专属迭代器:负责维护单向递减的内部游标状态"""
    def __init__(self, current_val):
        self.current = current_val

    def __iter__(self):
        return self  # 满足迭代器协议自反性

    def __next__(self):
        if self.current <= 0:
            raise StopIteration  # 计数归零时主动触发终止异常
        val = self.current
        self.current -= 1
        return val


class CountdownContainer:
    """可迭代对象:作为数据源配置,每次遍历创建新的游标"""
    def __init__(self, start):
        self.start = start

    def __iter__(self):
        # 每次调用返回一个全新的独立迭代器
        return CountdownIterator(self.start)


# 验证:可迭代对象可以反复进行多次 for 循环
timer = CountdownContainer(3)

print("第一次倒计时遍历:")
for n in timer:
    print(n, end=" ")  # 输出: 3 2 1

print("
第二次倒计时遍历:")
for n in timer:
    print(n, end=" ")  # 输出: 3 2 1 (完好重复,未受之前遍历影响)
五、避坑指南:生产环境中的常见错误
初学者常希望通过两层
for 循环生成笛卡尔积。如果外层和内层共用同一个由 iter() 产生的迭代器,当外层循环执行第一轮时,内层循环就会把迭代器中的元素全部抽干。等外层进入第二轮时,内层直接捕获 StopIteration 退出,导致结果严重缺失。若需多次扫描,务必传入容器本身或在内层通过 list() 固化数据。
在
for item in my_dict: 或 for x in my_list: 内部直接进行 del 或 append 操作,会导致底层的索引游标与物理存储映射发生错位,Python 针对字典和集合会直接抛出 RuntimeError: dictionary changed size during iteration,列表则可能产生漏读元素的问题。正确做法是遍历切片副本 for x in my_list[:]: 或通过推导式构建新集合。
六、总结与决策导图
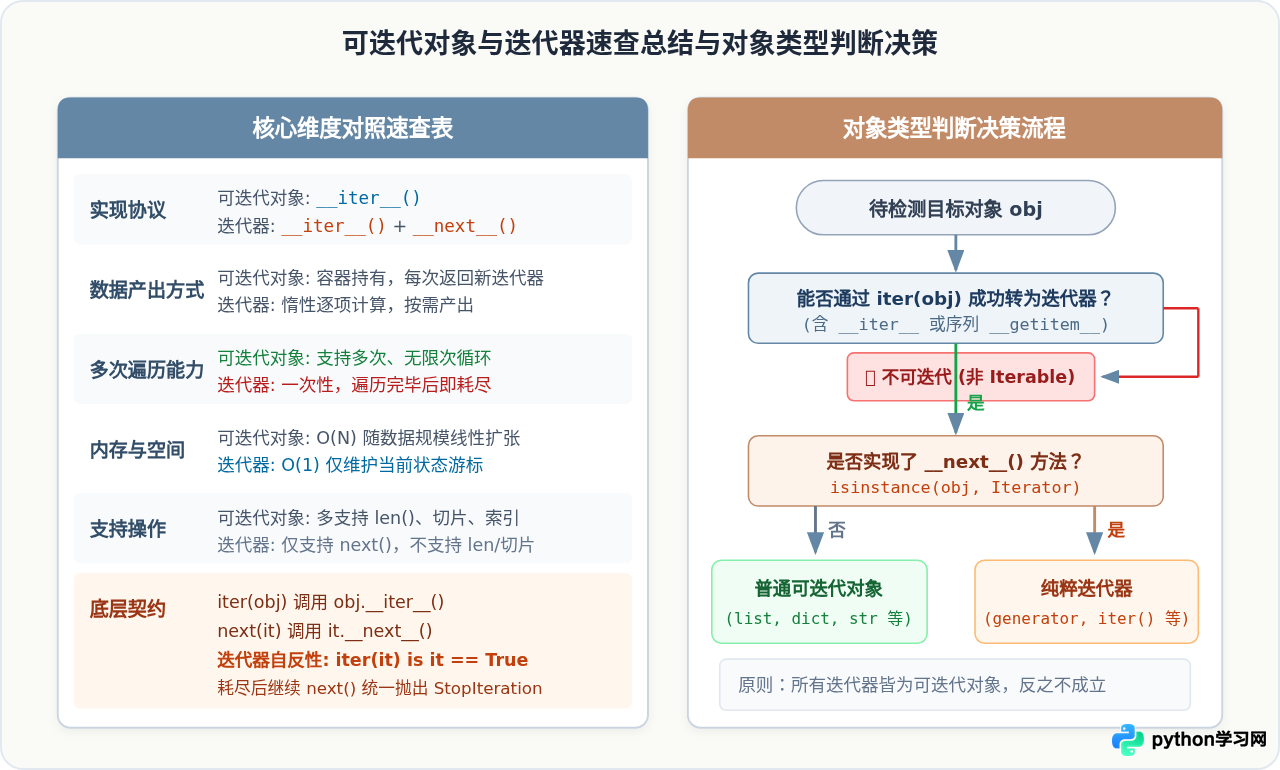
掌握可迭代对象与迭代器的区别,是理解 Python 高级特性(如生成器、上下文管理器、协程以及流式数据处理)的基石。在需要永久保存、随时根据索引随机访问、需要获取长度的场景下,优先选用列表、字典等普通可迭代容器;在面临大规模日志处理、超大文件流读取或数据管道流水线时,积极利用迭代器及生成器以大幅节省内存。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









