

Python itertools模块:实现无限循环与高级迭代技巧

在处理大规模流式数据、实时传感器采样或轮询调度任务时,开发者经常面临一个经典困境:直接在内存中构建完整列表容易导致内存耗尽,而传统的 while True 循环配合手动计数器又显得冗长且容易引入逻辑漏洞。Python 标准库自带的 itertools 模块正是为了解决这一痛点而设计的利器。它基于 C 语言底层的迭代协议实现,采用惰性求值(Lazy Evaluation)机制,无论处理的数据规模多大,都能保持恒定的 O(1) 内存占用。本文将详细讲解 count、cycle、repeat 等无限迭代器的底层运作与安全消费模式,并延伸探讨切片截断、流式级联与多源聚合等高级迭代技巧,帮助你写出高效、优雅且健壮的 Python 代码。
一、为什么需要 itertools:迭代器与内存友好型流处理
理解 itertools 的核心在于掌握“迭代器”(Iterator)的工作方式。常规的 Python 容器(如 list、dict)是预先分配内存并将所有元素保存在 RAM 中的;而 itertools 返回的均为迭代器对象,它们不会预先计算所有元素,而是在每次调用 next() 时动态生成下一个值。
这种按需计算的特性带来了两大关键优势:
- 内存开销恒定:即使生成包含上亿个元素或者理论上无止境的数据流,内存开销仅相当于维护一个内部指针状态。
- 计算延迟消除:调用函数时瞬间返回生成器对象,无需等待全量数据在内存中准备完毕即可立即开始下游消费。
二、无限循环迭代器:count、cycle 与 repeat 的实现与安全消费
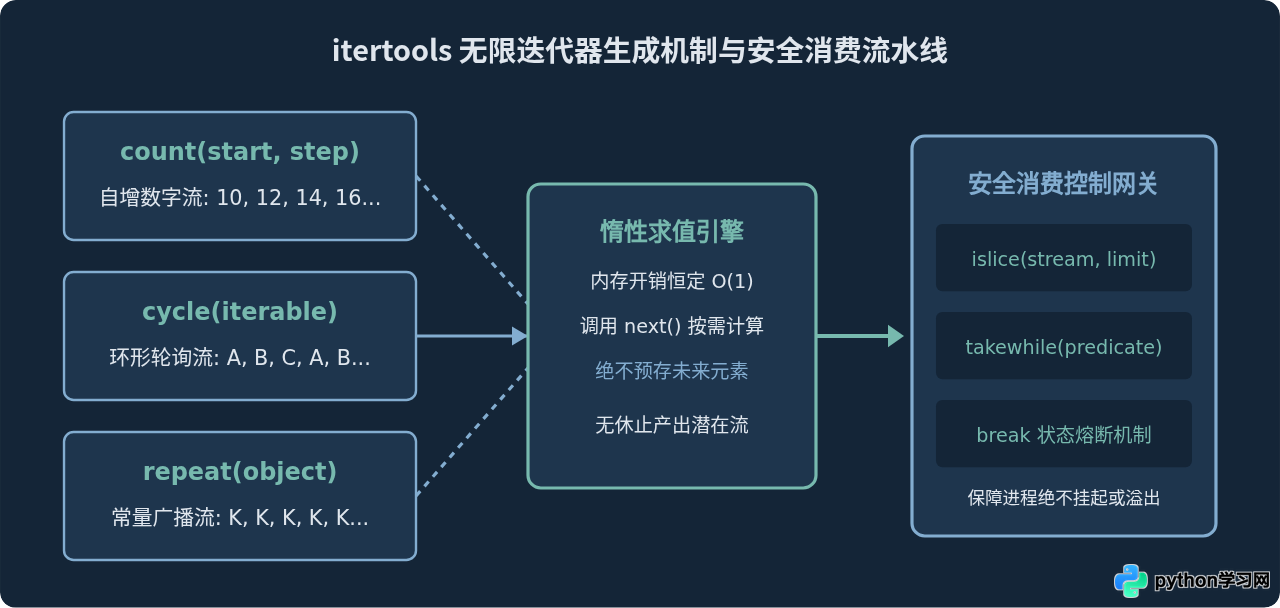
itertools 提供了三个基础的无限迭代器:count()、cycle() 和 repeat()。它们在没有外部终止条件的情况下会永远迭代下去,非常适合用来构建时序流水线、轮询分发以及常量参数广播。
1. count(start=0, step=1):自增序列发生器
count 接收起始值 start 和步长 step(支持整数或浮点数),返回一个等差递增的无限序列。它常用于为无序事件分配自增递增序列号、构建时间戳步长,或替代全局变量计数器。
import itertools

# 示例:模拟生成以 1000 开始、步长为 5 的订单序列号
order_counter = itertools.count(start=1000, step=5)

for _ in range(4):
    order_id = next(order_counter)
    print(f"生成的订单号: {order_id}")

# 示例输出:
# 生成的订单号: 1000
# 生成的订单号: 1005
# 生成的订单号: 1010
# 生成的订单号: 1015
2. cycle(iterable):有限序列的无限环形轮询
cycle 会先将传入的可迭代对象逐一产出,并在内部缓存这些元素。当序列遍历结束时,它会重新从第一个元素开始,永无休止地循环下去。这在实现多服务器负载均衡的轮询分发(Round-Robin)、循环状态机变换或色彩循环填充中非常实用。
import itertools

# 示例:三台后端服务节点的轮询任务调度
nodes = ["Worker-A", "Worker-B", "Worker-C"]
balancer = itertools.cycle(nodes)

tasks = [f"Task-{i}" for i in range(1, 7)]
for task in tasks:
    assigned_node = next(balancer)
    print(f"分派 {task} -> {assigned_node}")

# 示例输出:
# 分派 Task-1 -> Worker-A
# 分派 Task-2 -> Worker-B
# 分派 Task-3 -> Worker-C
# 分派 Task-4 -> Worker-A
# 分派 Task-5 -> Worker-B
# 分派 Task-6 -> Worker-Ccycle 会在内存中缓存迭代过的所有元素。如果向 cycle 传入一个非常庞大的生成器,其内部缓存将持续膨胀,最终退化为占用大量内存。因此,请确保传入 cycle 的是规模受控的序列。
3. repeat(object, [times]):常量单值重复与参数广播
repeat 会无限次(若未指定 times)或指定次数输出同一个对象。它最常用的场景是配合 map() 或内置多进程 starmap(),向批量处理函数提供固定不变的配置参数。
import itertools

# 示例:计算不同数字的固定 3 次方,使用 repeat 传递指数
numbers = [2, 3, 4, 5]
powers = map(pow, numbers, itertools.repeat(3))

print(list(powers))
# 示例输出:[8, 27, 64, 125]
4. 无限迭代器的安全消费准则
使用无限迭代器时,最忌讳直接使用 list(count()) 或未设中断条件的 for x in cycle(...),这会直接耗尽服务器内存或导致程序陷入死锁。消费无限迭代器必须遵循以下安全准则:
- 使用 islice 限制最大提取步数:限定无论何时最多只取前 N 项。
- 在循环体内设置确定性的 break 条件:依据业务指标(如时间超时、阈值命中)适时跳出。
- 结合 takewhile 实现谓词驱动退出:一旦数据偏离预设范围即刻终止。
三、序列条件切片与动态过滤技巧
处理流式数据时,我们往往需要根据特定业务规则截取数据片段。常规列表切片 list[start:stop] 需要将全量数据加载在内存中且仅支持可索引序列,而 itertools 提供了能直接作用于生成器的切片与条件过滤工具。
1. islice(iterable, [start], stop, [step]):流式切片
islice 允许我们对任何不可索引用、单向流动的生成器进行切片。它会在内部逐步步进迭代器,静默消耗掉 start 之前的元素,返回 start 到 stop 之间的元素,且在达到 stop 后立即停止迭代。
import itertools

# 示例:从无限计数器中安全截取第 10 到第 15 个奇数
odd_numbers = itertools.count(start=1, step=2)
slice_result = itertools.islice(odd_numbers, 10, 15)

print(list(slice_result))
# 示例输出:[21, 23, 25, 27, 29]
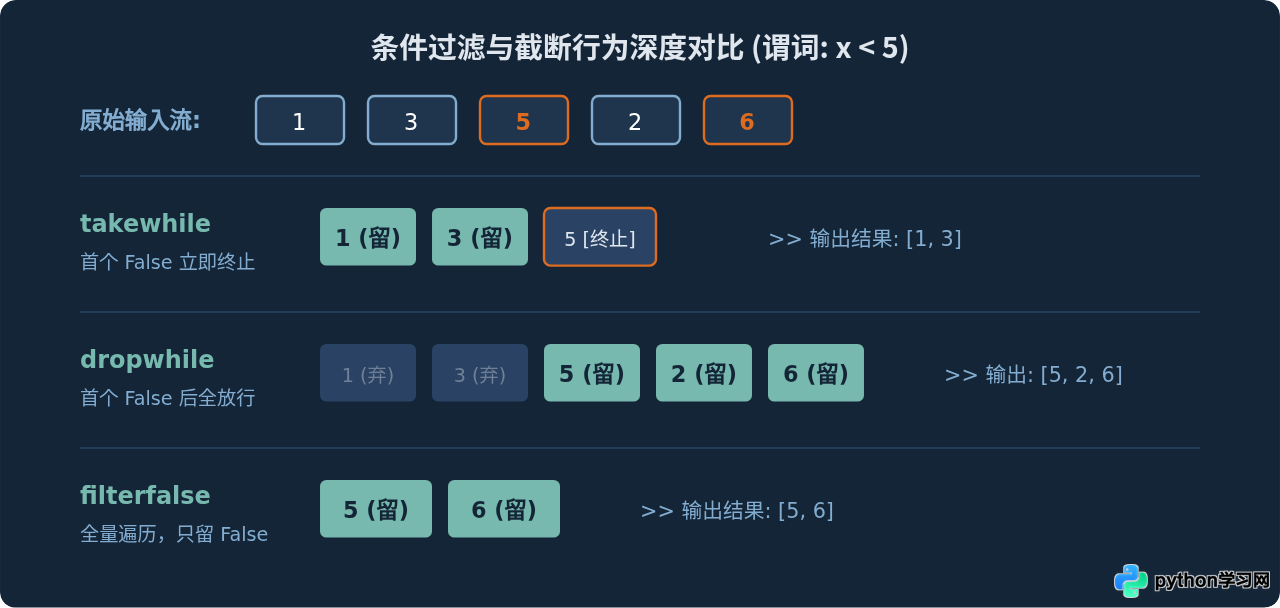
2. takewhile 与 dropwhile:状态驱动的前置截断与启动
这两个函数非常容易被混淆,但它们的逻辑截然相反,是流式数据清洗的利器:
- takewhile(predicate, iterable):从头开始验证条件,只要条件为
True就保留元素;一旦遇到第一个使条件为False的元素,立刻永久停止迭代。即使后续还有满足条件的元素也直接忽略。 - dropwhile(predicate, iterable):从头开始验证条件,只要条件为
True就丢弃元素;一旦遇到第一个使条件为False的元素,从此开始保留该元素及后续的所有元素,不再执行条件判断。
import itertools

raw_stream = [2, 4, 6, 9, 10, 12, 1, 3]

# 示例 1:获取开头的连续偶数,遇到奇数即止
take_res = list(itertools.takewhile(lambda x: x % 2 == 0, raw_stream))
print(f"takewhile 结果: {take_res}")
# 输出: [2, 4, 6] (因为 9 是奇数,直接截断终止)

# 示例 2:跳过开头的连续偶数,从第一个奇数开始保留所有后续项
drop_res = list(itertools.dropwhile(lambda x: x % 2 == 0, raw_stream))
print(f"dropwhile 结果: {drop_res}")
# 输出: [9, 10, 12, 1, 3] (从 9 开始全部输出,即使 10 是偶数也不会被丢弃)
3. filterfalse(predicate, iterable):取反高效过滤
与内置函数 filter() 保留符合条件的元素相反,filterfalse() 仅保留使判断函数返回 False 的项。当过滤判断逻辑的“否定形式”更简洁时,使用 filterfalse 能显著提升代码可读性与执行效率。
四、多序列重组与高级流式聚合
面对分散在多个文件、接口或不同生成器中的数据,如何以低内存成本高效组装?itertools 提供了流水线式的级联合并与聚合工具。
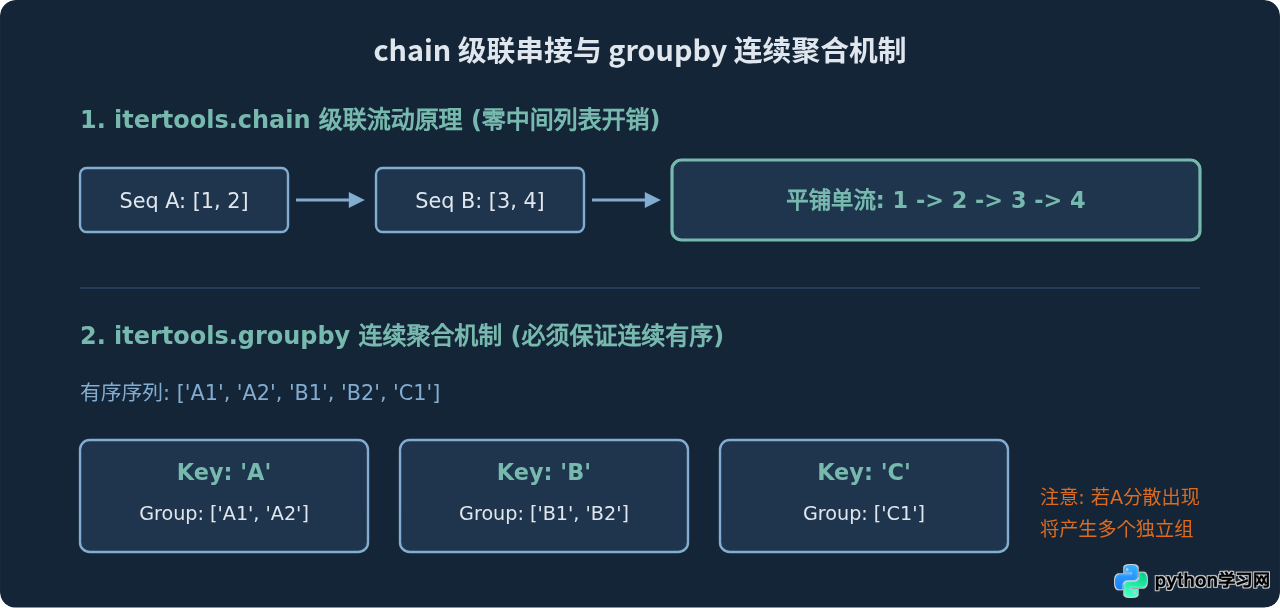
1. chain 与 chain.from_iterable:无缝多源级联
chain 接收多个可迭代对象作为参数,把它们串成一条单向流动的数据链条。与使用加号拼接列表(list_a + list_b)不同,chain 不会创建任何中间大列表,只有当第一个迭代器完全耗尽时,才会透明地无缝切换到下一个迭代器。
import itertools

# 示例:流式处理多个批次的数据
batch_1 = [101, 102]
batch_2 = (201, 202, 203)
batch_3 = [301]

unified_stream = itertools.chain(batch_1, batch_2, batch_3)
for item in unified_stream:
    print(item, end=" ")
# 示例输出:101 102 201 202 203 301
如果数据源本身是一个生成可迭代对象的迭代器(例如读取包含成百上千个小文件的生成器),则可以使用 chain.from_iterable(iterable),它具备极致的内存惰性。
2. groupby:连续有序数据的聚类陷阱与正确用法
groupby 用于将序列中具有相同键(key)的元素聚合在一起。然而,这也是 itertools 中最容易产生 bug 的工具:它只聚合相邻连续的相同元素。如果未排序的数据中出现了分散的相同键,它们将被划分为不同的组别!
import itertools

users = [
    {"dept": "Dev", "name": "Alice"},
    {"dept": "Dev", "name": "Bob"},
    {"dept": "Ops", "name": "Charlie"},
    {"dept": "Dev", "name": "David"},  # 注意:Dev 被 Ops 隔断了!
]

# 错误示范:未排序直接 groupby
print("--- 未排序直接分组 ---")
for key, group in itertools.groupby(users, key=lambda x: x["dept"]):
    print(key, list(group))
# 输出结果会出现两个不同的 'Dev' 组!

# 正确做法:必须先根据分组 key 排序
print("\n--- 先排序后分组 ---")
sorted_users = sorted(users, key=lambda x: x["dept"])
for key, group in itertools.groupby(sorted_users, key=lambda x: x["dept"]):
    print(key, [u["name"] for u in group])
# 输出正确聚类:
# Dev ['Alice', 'Bob', 'David']
# Ops ['Charlie']groupby 返回的 group 本身也是一个惰性迭代器。当外层循环进入下一次迭代时,前一个 group 的内部指针会被废弃。因此若需持久保留分组数据,必须在循环内部将其立即转换为 list(group)。
3. zip_longest(*iterables, fillvalue=None):长序列对齐
内置的 zip() 函数在任一输入迭代器耗尽时即刻停止(按最短对齐)。而 zip_longest 则以最长序列为准,对已耗尽的短序列自动使用 fillvalue 补齐缺失值,非常适合用于二维表格数据填补与多通道数据对齐。
五、生产环境避坑指南与典型实战场景
在实际生产工程中,结合 itertools 能够以极少代码量优雅实现原本复杂的调度与批处理逻辑。
1. 实战场景:大文件流式批量分片处理(Chunking)
在读取几千万行的超大日志文件或数据库导出文件时,通常需要按固定批量(比如每批 1000 行)提交给写入端。借助 islice 可以实现一个通用的无内存积压批处理生成器:
import itertools

def chunk_stream(iterable, size):
    """通用流式分块生成器:无论数据多大均不爆内存"""
    iterator = iter(iterable)
    while True:
        chunk = list(itertools.islice(iterator, size))
        if not chunk:
            break
        yield chunk

# 模拟 10 条日志的处理过程,按每批 3 条分块
log_events = (f"Log_Record_{i}" for i in range(1, 11))
for batch_idx, batch in enumerate(chunk_stream(log_events, 3), start=1):
    print(f"Batch {batch_idx}: 提交 {len(batch)} 条记录 -> {batch}")

# 示例输出:
# Batch 1: 提交 3 条记录 -> ['Log_Record_1', 'Log_Record_2', 'Log_Record_3']
# Batch 2: 提交 3 条记录 -> ['Log_Record_4', 'Log_Record_5', 'Log_Record_6']
# Batch 3: 提交 3 条记录 -> ['Log_Record_7', 'Log_Record_8', 'Log_Record_9']
# Batch 4: 提交 1 条记录 -> ['Log_Record_10']
2. 生产陷阱:迭代器单次消费与 tee 的内存代价
Python 迭代器具有“阅后即焚”的特性。一旦迭代完成,迭代器就变为空,再次遍历将无法获取任何数据。为了“复制”迭代器,itertools 提供了 tee(iterable, n=2)。
但必须注意:tee 并没有真正克隆底层内存,它通过在内部保存一个 FIFO 缓存队列来实现多个游标的共享。如果其中一个分支迭代器飞速向前运行,而另一个分支停滞不前,中间产生的所有数据都会堆积在内存队列中,导致内存急剧消耗。因此,在内存敏感型场景中,建议尽量避免让 tee 分支产生过大的步进差。
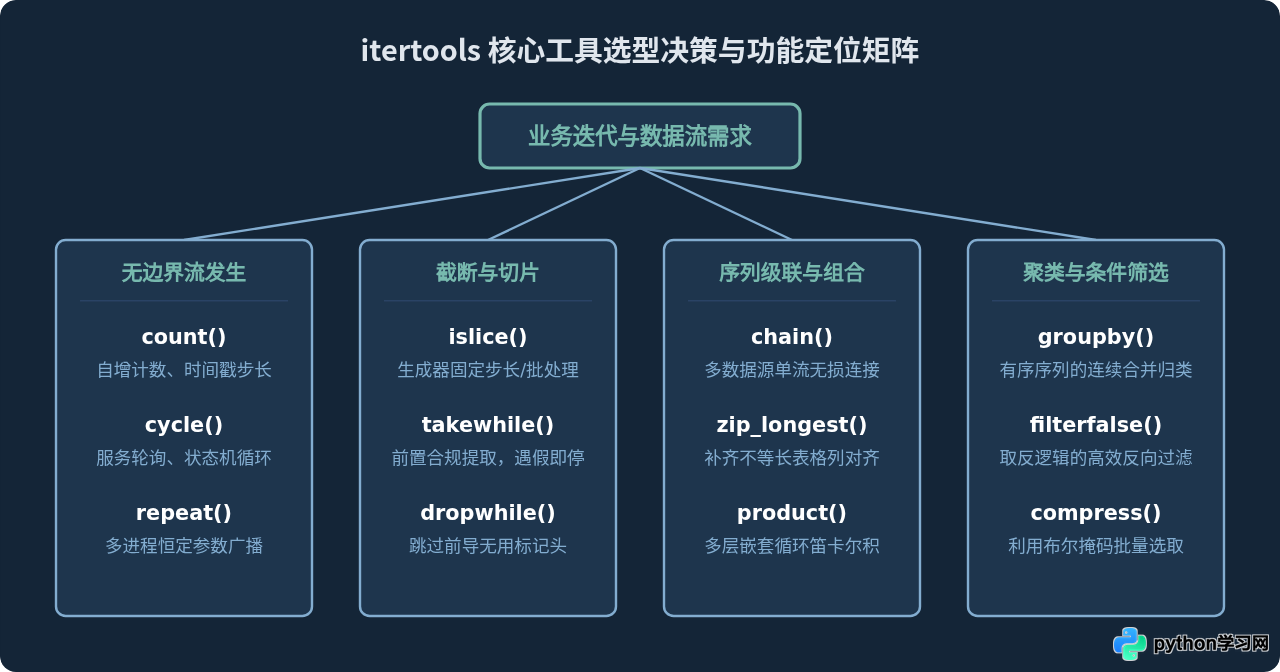
六、itertools 核心方法速查与选型决策
为了在开发中快速对号入座,下表对模块内的常用函数进行了分类整理:
| 分类 | 核心方法 | 参数简记 | 核心用途与典型场景 |
|---|---|---|---|
| 无限迭代 | count() |
start, [step] |
无边界自增数列,用于序号发放、全局计数 |
cycle() |
iterable |
序列无限首尾相连循环,用于轮询负载均衡调度 | |
repeat() |
elem, [times] |
常量元素固定或无限重复,配合 map 广播固定参数 | |
| 切片与过滤 | islice() |
seq, [start], stop, [step] |
生成器轻量分片与批处理分块,内存零浪费 |
takewhile() |
pred, seq |
谓词为真时保留,遇到首个假立即截断 | |
dropwhile() |
pred, seq |
谓词为真时丢弃,遇到首个假后全量输出 | |
| 组合与聚合 | chain() |
*iterables |
扁平化串联多个序列,多源流水线合并 |
groupby() |
seq, [key] |
按连续键聚合元素(使用前必须显式排好序) | |
zip_longest() |
*iterables, fillvalue |
对齐不等长序列,自动填补缺失默认值 |
熟练运用 itertools 不仅能让你的代码更符合 Pythonic 风格,更能从根本上重塑程序的数据流动机制。在日常编码中,当遇到需要嵌套多层 for/while 循环、手动维护临时累加变量或为大列表切片而焦虑内存时,优先打开 itertools 工具箱,构建低耦合、高吞吐的流式计算流水线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









