

为什么Python的range对象是序列类型?

range 具有“惰性生成数值”的特征而将其误认为是迭代器或生成器;但在官方数据模型定义中,range 属于不可变序列类型(Sequence)。本文将直接解释 range 作为序列类型的本质原因、它所满足的序列协议契约,以及依托算术等差规律实现的常数级(O(1))高效访问与包含测试机制。
一、核心回答:序列协议契约与类型归属
Python 判断一个对象是否为“序列类型”,依据的不是该对象在内存中是否连续物理存储所有元素,而是它是否完整履行动作协议契约。在 Python 官方抽象基类体系(collections.abc)中,序列(Sequence)必须满足以下核心特征:
- 确定长度:支持
len()函数,能够瞬间返回集合内元素的总数。 - 下标索引:支持通过正负整数下标直接提取元素(
obj[i]),并支持越界检测抛出IndexError。 - 切片运算:支持切片语法(
obj[start:stop:step]),切片后返回该类型的子序列。 - 高效包含测试:支持
x in obj操作,能够快速检索某个值是否在集合中。 - 反向与查找方法:提供
index()与count()方法,并支持通过reversed()进行反向遍历。 - 可重入与多次遍历:对象本身不是一次性消耗的状态机,可以被多个独立的
for循环反复迭代,每次迭代均从头开始。
通过 Python 标准库的类型检查工具可以清晰验证这一关系:
from collections.abc import Sequence, Iterator

r = range(0, 10, 2)

print(isinstance(r, Sequence))  # 示例输出: True
print(isinstance(r, Iterator))  # 示例输出: False
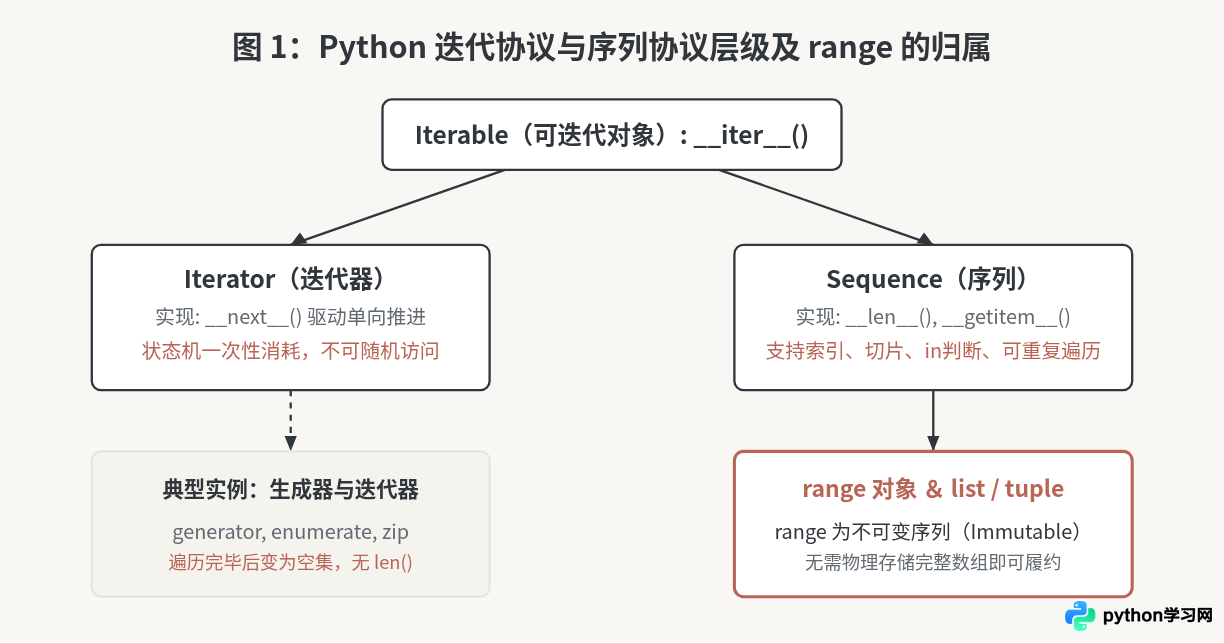
可以看到,range 对象是标准的 Sequence,但并不是 Iterator。它遵循的是不可变序列规范,其类型层级与契约划分如下图所示。
二、核心机制:基于等差数列参数的 O(1) 存储与计算
通常读者习惯将“序列”等同于“存放在连续物理内存里的数组”(如 C 语言数组或 Python 的 list)。而 range 能够成为序列的核心技术前提在于:它的所有元素符合严谨的等差数列规律。
一个 range 对象在 Python 内部只保存三个核心整数参数:
start:序列的起始数值(默认为 0)。stop:序列的终止上界(不包含该值)。step:步长(默认为 1,不能为 0)。
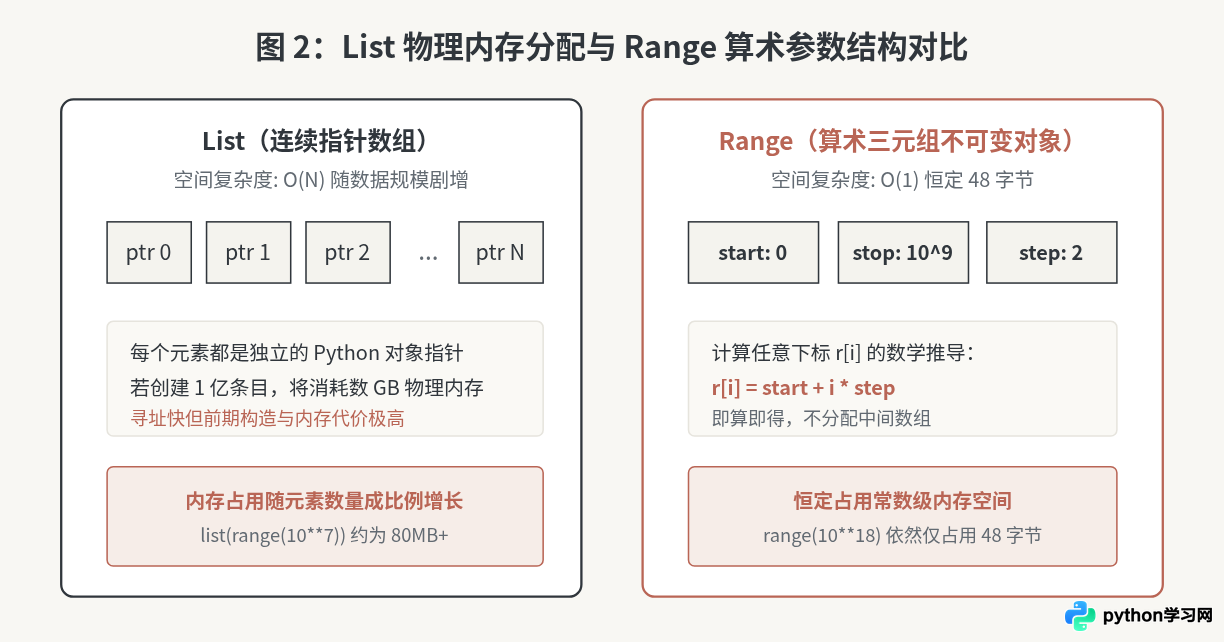
正因为只有三个属性,无论请求的范围是 range(10) 还是 range(10**12),它在内存中占用的空间是完全固定且微乎其微的。如下代码展示其实际内存表现:
import sys

r1 = range(10)
r2 = range(10_000_000)

print(sys.getsizeof(r1))  # 示例输出: 48 (字节)
print(sys.getsizeof(r2))  # 示例输出: 48 (字节,内存完全一致)
当执行下标访问 r[i] 时,解释器无需从头遍历,而是直接利用算术公式快速计算出结果:
value = start + index * step
如果计算索引为负数,则自动转换为 index = len(r) + i。若索引不在合法区间内,则直接抛出 IndexError。这种即时计算机制保证了下标访问的时间复杂度为严格的常数级 O(1),与真实数组访问完全一致。
三、序列特权实证:切片与 O(1) 包含测试
如果一个对象仅仅是可迭代或生成器,它将无法执行以下两项关键操作:切片(Slicing)与高效判定(Membership Test)。这也是 range 必须被设计为序列的核心价值所在。
1. 切片操作仍然返回 range 对象
对列表切片会复制对应区间的元素产生新列表;对生成器执行切片语法则会直接抛出 TypeError: 'generator' object is not subscriptable。
而 range 支持完整的切片语法。因为任意等差数列的子等差切片,其数学形态依然是严格的等差数列。解释器通过简单的代数变换直接计算出新切片的 sub_start、sub_stop 和 sub_step,返回一个新的 range 对象:
r = range(10, 100, 5)
sub = r[2:8:2]

print(sub)        # 示例输出: range(20, 50, 10)
print(list(sub))  # 示例输出: [20, 30, 40]
2. 包含判定(in)的 O(1) 数学推导
对于常规迭代器或链表结构,检测 x in obj 需要从头开始逐个比较,直到匹配或到达终点,时间复杂度为 O(N)。如果一个迭代器有 10 亿个数字,查询一个大数字将耗费数秒并直接耗尽迭代器。
而在 range 中,Python 底层实现利用了同余方程直接计算,整个过程只需进行两次大小比较与一次取模运算,运算耗时与数据总量完全无关(O(1)):
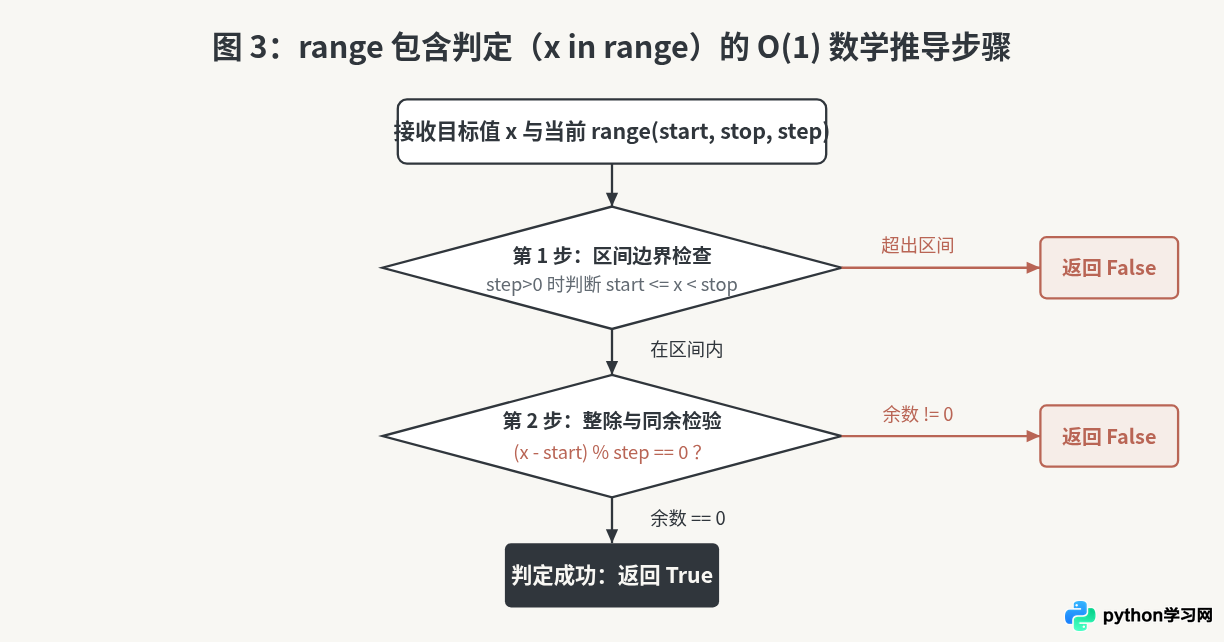
这一特性的实用价值极为显著:执行 999_999_999 in range(1_000_000_000) 在 Python 3 中耗时几乎为 0 毫秒;但如果是遍历迭代器,则需要经历 10 亿次 __next__() 调用并耗费数十秒 CPU 时间。
四、设计演进:从 Python 2 的 xrange 到 Python 3 的 range
理解 range 为什么是序列类型,还需要回顾 Python 的设计演进史:
- Python 2 的阶段:在 Python 2 中,
range()会直接生成一个装满所有元素的普通列表(list),而xrange()则是一个专用的惰性生成序列类型。xrange已经具备了索引和长度支持,但切片等高级序列操作支持并不完整。 - Python 3 的统一:Python 3 彻底移除了浪费内存的
range列表实现,将原有的xrange重构并正式命名为range。同时将其规范化为完备的不可变序列,使其不仅支持遍历,而且完全遵循Sequence协议的所有数学语义。
五、序列与迭代器的核心差异全景总结
为了在日常开发中准确区分并选用相应结构,下表及图示总结了 range、常规迭代器(如生成器)与实体列表在关键特性上的行为对照:
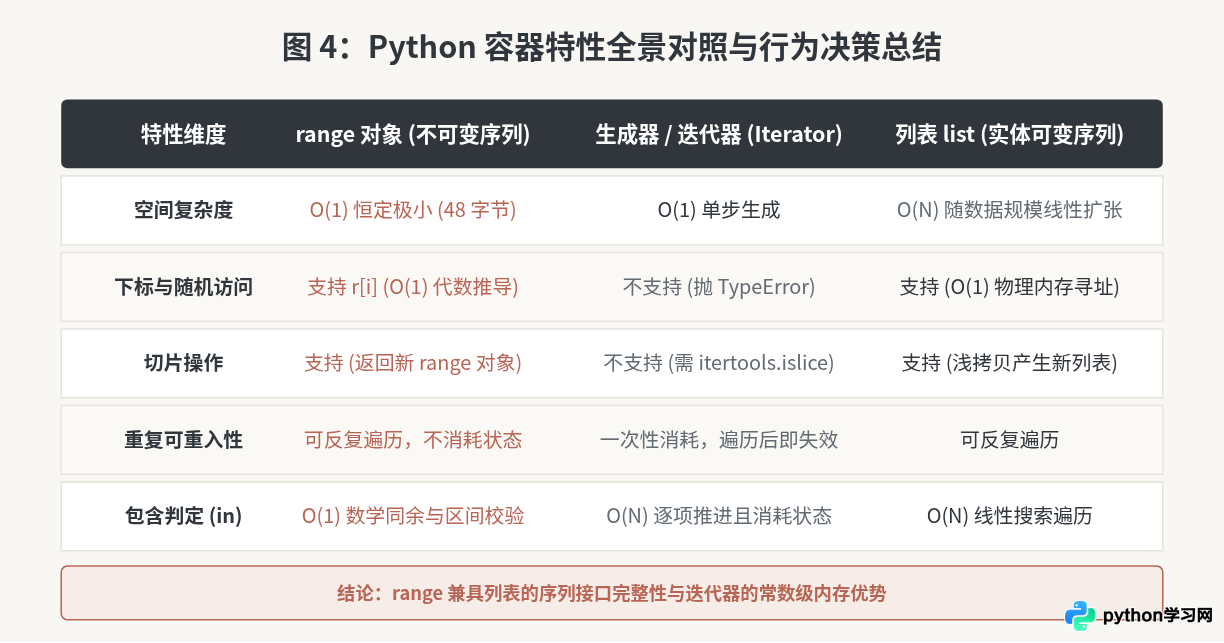
range 定义为序列类型,本质上是因为它在不预先分配内存的前提下,通过等差数列参数完整满足了 Sequence 协议所要求的确定长度、随机索引、切片运算、可重复迭代以及常数级包含测试能力。这使得开发者既能够享受类似实体列表的便利操作接口,又能获得极致轻量的常数级内存开销。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









