

Java编译执行与Python解释执行的原理区别及性能影响
深入解析Java的静态编译+JIT动态编译机制与Python的动态字节码解释执行机制在底层原理、内存布局、指令分发与多核并行上的根本区别,并提供具体的性能量化与技术选型建议。
很多初学者常听人说“Java 速度快,Python 速度慢”,或者反过来认为“两者都会生成字节码(.class 与 .pyc),原理其实差不多”。这两种认知都只看到了表象。要想在实际架构设计与技术选型中做出精准判断,必须从“代码如何变成硬件电信号”的执行流水线说起。
一、从源码到硬件指令:两者的执行流水线差异
计算机 CPU 只能执行对应架构(如 x86-64 或 ARM64)的机器指令(0101 机器码)。任何高级语言都要解决“如何把人类可读的代码翻译给硬件执行”的问题。Java 与 Python 都引入了“字节码(Bytecode)”作为中间媒介,但在何时编译、谁来编译以及执行时是否生成原生机器指令上存在根本差异。
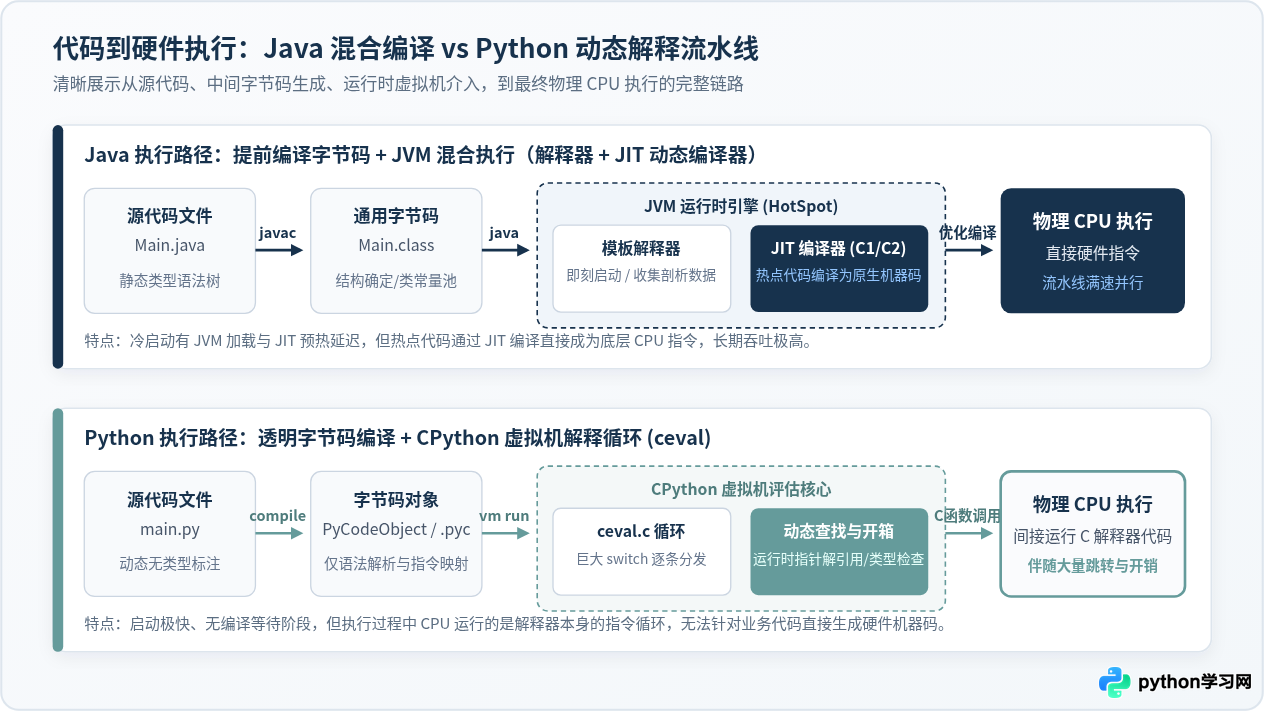
1. Java 的混合执行模式:AOT 字节码 + 运行时 JIT 动态编译
Java 并非传统 C/C++ 那样一次性生成平台相关的二进制可执行文件,也非纯粹的解释执行。它采用经典的混合执行模式(Mixed Mode):
- 前端静态编译阶段:开发者执行
javac Main.java时,编译器完成词法分析、语法分析、语义分析及严格的静态类型检查,生成与平台无关的Main.class字节码文件。此时的编译并不涉及具体 CPU 指令。 - 虚拟机加载与初始化:运行
java Main时,JVM(如 OpenJDK HotSpot)启动,通过类加载器将字节码载入方法区,完成校验与链接。 - 解释执行起步:JVM 内部的模板解释器(Template Interpreter)首先快速介入,逐条将字节码映射为预设的机器指令小片段并立即执行。这一阶段让程序无需漫长的编译等待即可迅速启动。
- 运行时热点侦测与 JIT 编译:在执行过程中,JVM 计数器会实时追踪高频调用的方法(Invocation Counter)和循环(Backedge Counter)。当一段代码执行频次突破阈值,HotSpot 启动 JIT(Just-In-Time)编译器将其动态编译为经过极致优化的原生机器码,存入 CodeCache。后续执行直接由物理 CPU 满速调度,不再经过解释器。
2. Python 的纯解释循环:透明语法编译 + 解释器逐条分发
官方标准实现 CPython 的执行模型虽然也有编译动作,但目的完全不同:
- 透明字节码编译:运行
python main.py时,CPython 首先在内存中对源码进行词法解析与抽象语法树(AST)构建,将其编译为 Python 字节码对象(PyCodeObject)。如果引入了模块,CPython 会在__pycache__目录缓存.pyc文件以避免重复解析语法。 - 虚拟机指令分发:与 Java JIT 不同,CPython 在运行时不会将字节码翻译为原生机器指令。它启动一个庞大的 C 语言函数循环(核心位于
ceval.c的_PyEval_EvalFrameDefault),每次从字节码流中取出一个操作码(Opcode),通过巨大的switch-case语句或计算跳转表(Computed Goto)寻找对应的 C 实现函数并调用。
3. 字节码视角实测对比:同一个加法循环
我们通过反编译工具观察两者在底层指令层面的本质差异。以下是一段简单的累加计算:
// Java 代码片段
public class LoopTest {
    public static int sumLoop() {
        int sum = 0;
        for (int i = 0; i < 10000; i++) {
            sum += i;
        }
        return sum;
    }
}

// 执行命令:javac LoopTest.java && javap -c LoopTest
// 输出关键字节码片段(示例):
Code:
   0: iconst_0        // 将常数 0 压入操作数栈
   1: istore_0        // 存入局部变量 0 (sum)
   2: iconst_0        // 将常数 0 压入操作数栈
   3: istore_1        // 存入局部变量 1 (i)
   4: iload_1         // 读取 i 到栈顶
   5: sipush 10000    // 压入常数 10000
   8: if_icmpge 21    // 若 i >= 10000 则跳转至 21 结束
  11: iload_0         // 读取 sum
  12: iload_1         // 读取 i
  13: iadd            // 执行整型加法(类型已在编译期静态确定为 32 位 int)
  14: istore_0        // 存回 sum
  15: iinc 1, 1       // 局部变量 i 递增 1
  18: goto 4          // 跳转回循环开头
  21: iload_0
  22: ireturn
可以看到,Java 字节码中的指令具有明确的强类型修饰(如 iload、iadd、istore 专用于 32 位整型)。JVM JIT 在编译这段代码时,甚至可以做循环展开(Loop Unrolling)或直接推导出高斯求和公式,生成仅需几个寄存器指令的汇编代码。
再观察 Python 的等价代码与反编译字节码:
import dis

def sum_loop():
    total = 0
    for i in range(10000):
        total += i
    return total

# 执行命令:python -c "import dis; from test import sum_loop; dis.dis(sum_loop)"
# 输出关键字节码片段(Python 3.11+ 示例):
  2           0 RESUME                   0
  3           2 LOAD_CONST               1 (0)
              4 STORE_FAST               0 (total)
  4           6 LOAD_GLOBAL              1 (range)
             18 LOAD_CONST               2 (10000)
             20 PRECALL                  1
             24 CALL                     1
             34 GET_ITER
        >>   36 FOR_ITER                 8 (to 54)
             38 STORE_FAST               1 (i)
  5          40 LOAD_FAST                0 (total)
             42 LOAD_FAST                1 (i)
             44 BINARY_OP                0 (+)
             48 STORE_FAST               0 (total)
             50 JUMP_BACKWARD            8 (to 36)
        >>   54 LOAD_FAST                0 (total)
             56 RETURN_VALUE
在 Python 的字节码中,BINARY_OP 0 (+) 并没有任何类型信息。在执行这一步时,CPython 根本不知道 total 和 i 是整数、浮点数、字符串还是重写了 __add__ 的自定义对象。每一次循环,解释器都必须通过指针检查它们的对象类型并动态寻找加法操作实现。
二、核心运行机制深潜:JIT 动态编译与解释循环的底层鸿沟
造成两者吞吐性能量级差距的核心,不仅是执行流程的形式差异,更在于虚拟机的内部运行机制。
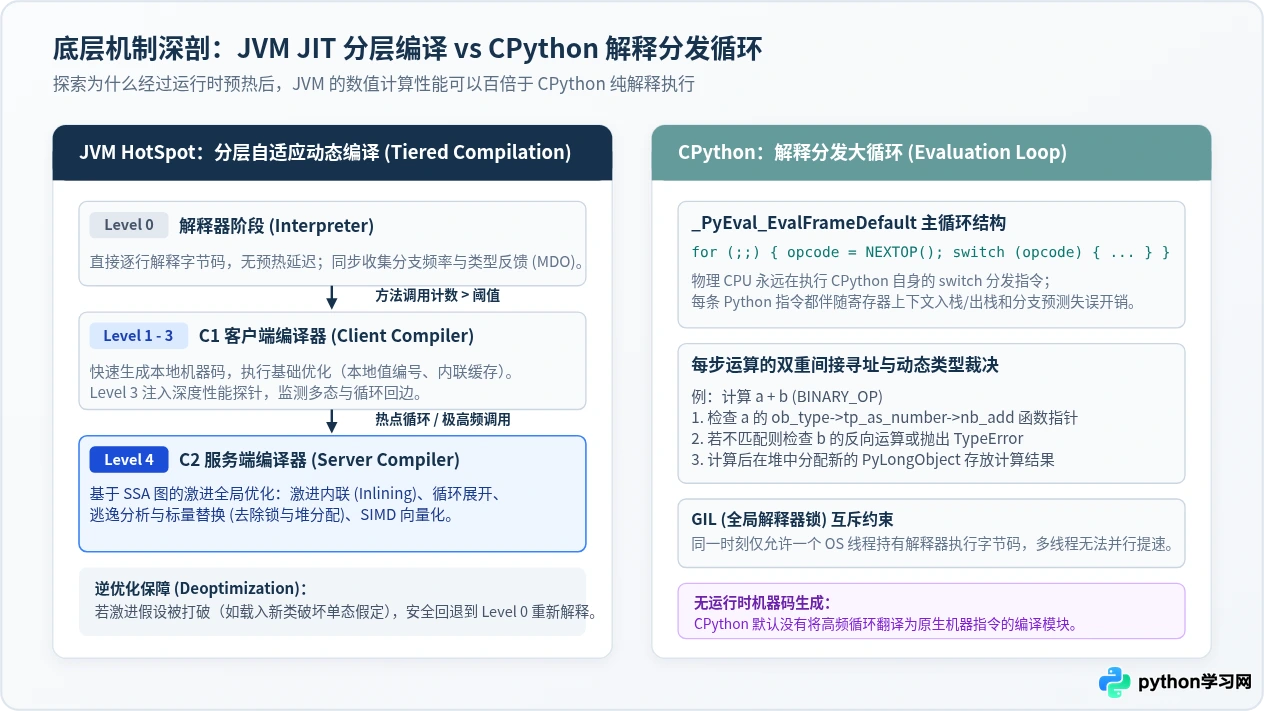
1. HotSpot 的多层自适应编译(Tiered Compilation)
现代 JVM(如 OpenJDK HotSpot)采用分层编译策略,精细平衡启动速度与峰值吞吐:
- Level 0(解释器):程序刚启动时使用模板解释器,完全不花费编译时间,同时在关键分支处插入计数探针,收集方法调用频次与分支预测数据。
- Level 1 - 3(C1 客户端编译器):当某个方法达到轻量热点阈值,JVM 在后台启动 C1 编译器。C1 编译速度极快,进行局部优化(如内联缓存 Inline Cache、常量折叠),立即将热点方法替换为初步机器码。
- Level 4(C2 服务端编译器):当方法或循环极为高频(热点代码)时,C2 编译器介入。C2 会进行非常激进的全局优化:
- 方法内联(Inlining):消除函数调用的调用栈压栈与跳转开销。
- 逃逸分析(Escape Analysis):判断对象是否只在当前线程或方法内使用;若不逃逸,直接将堆对象拆散为栈上局部变量(标量替换),彻底免除 GC 压力与内存分配开销。
- 循环向量化(SIMD):利用 CPU 的 AVX/SSE 指令集,单指令同时操作多个数据。
2. CPython 的指令分发开销与 GIL 约束
相比之下,标准 CPython 的解释循环面临三重先天性能制约:
- 指令分发开销(Dispatch Overhead):CPU 运行的是解释器本身的
for(;;) switch(opcode)逻辑。每执行一条 Python 业务指令,CPU 都需要完成一次取指、解码、跳转,导致分支预测器(Branch Predictor)频繁失效,流水线停顿。 - 动态属性与方法解析(Dynamic Attribute Lookup):Python 的一切属性都在字典(
__dict__)或类型槽中。即便一个普通的加法或属性读取,底层也伴随着多次哈希计算与链表遍历。 - GIL(全局解释器锁)的并发屏障:为了保证 CPython 内存管理(引用计数)的安全,GIL 强制要求任何时刻只能有一个系统线程执行 Python 字节码。这意味着即便服务器有 64 核 CPU,纯 Python 多线程程序在进行数值密集型计算时,不仅无法利用多核,反而因线程上下文切换与锁竞争而比单线程更慢。
三、内存与类型系统的代价:静态原生标量 vs 动态包装对象
许多人低估了内存布局对 CPU 运行效率的决定性影响。在现代计算机硬件体系中,CPU 访问 L1 缓存只需约 1 纳秒(约 4 个时钟周期),而访问主内存(DRAM)却需要 60 到 100 纳秒(数百个周期)。因此,数据是否紧凑、是否缓存行友好直接决定了性能上限。
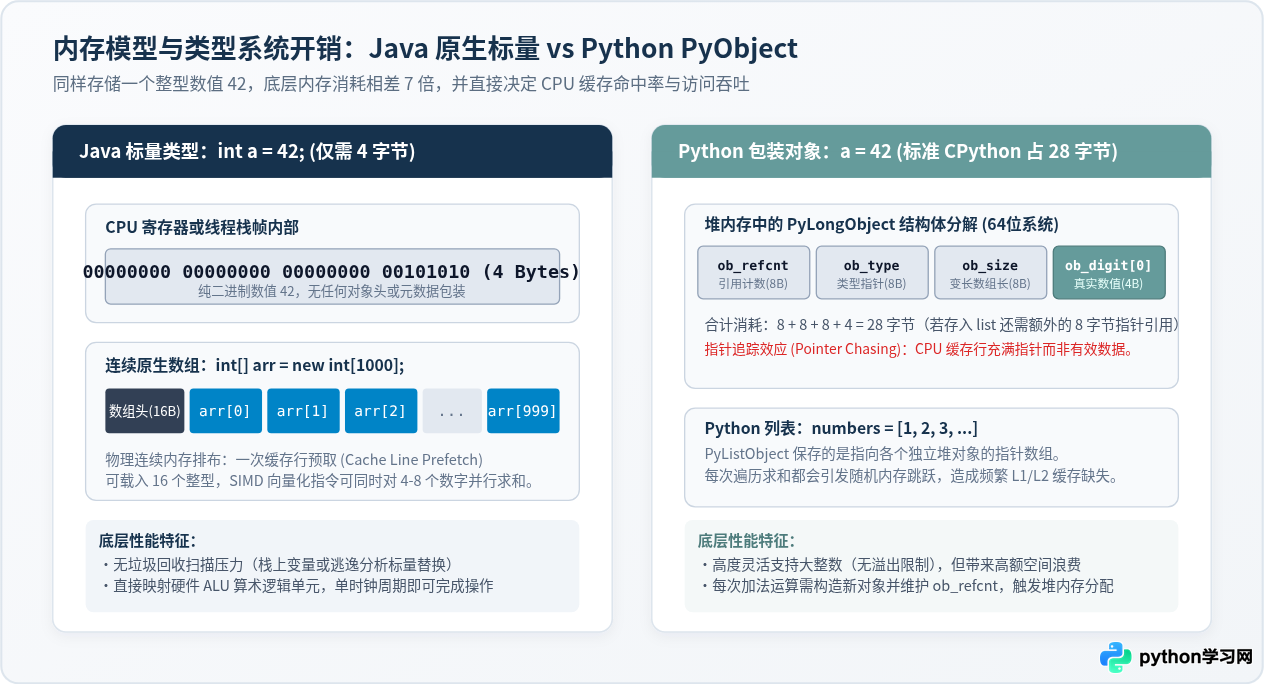
1. 数据表示的内存差距:4 字节 vs 28 字节
以整型数字 42 为例:
- Java 中的
int a = 42;:占用纯粹的 4 个字节,直接存储在 CPU 寄存器或当前栈帧中。如果要分配 1000 万个整数的数组int[] arr,在内存中是一整块连续的、仅占约 40MB 的物理内存。CPU 在读取时,硬件预取器(Hardware Prefetcher)会自动将相邻数据一次性加载到 L1/L2 缓存行,产生极致的吞吐率。 - Python 中的
a = 42:Python 中“一切皆对象”。42 在 CPython 内部是一个完整的PyLongObject结构体(64 位系统下):ob_refcnt(引用计数):占用 8 字节ob_type(指向类型对象的指针):占用 8 字节ob_size(记录变长数值长度):占用 8 字节ob_digit[0](存储实际数值):占用 4 字节(通常填充至 8 字节对齐)
[1, 2, ...],不仅每个元素占用 28 字节,列表本身还要额外存储 80MB 的指针数组,总内存消耗超过 360MB(相差近 9 倍)。
2. 指针追逐(Pointer Chasing)与缓存缺失
在遍历包含 1000 万个整数的 Python 列表时,CPU 每次读取指针后,都需要跨越漫长的主内存去访问指针所指向的各个分散堆对象。这种现象被称为指针追逐。CPU 的 L1/L2 缓存命中率极速下降,大部分时钟周期都在苦苦等待内存数据到达,算力被严重浪费。
四、性能影响的实际表现与量化场景
基于上述底层原理,Java 与 Python 在实际软件工程各维度的表现呈现出鲜明的两极分化:
| 对比维度 | Java (JVM 混合编译) | Python (CPython 解释执行) | 实际影响与技术表现 |
|---|---|---|---|
| CPU 密集型运算 (大循环、矩阵、排序) |
极高(通常在 C/C++ 的 1.2x ~ 2x 范围内) | 较低(原生速度通常慢于 Java 10x 到 50x) | Java 经 JIT 消除抽象与向量化后满速运行;Python 纯解释循环与对象开销过大。 |
| 冷启动速度 | 较慢(通常 200ms ~ 数秒) | 极快(通常 10ms ~ 50ms) | JVM 需要启动 Runtime、加载核心库;Python 解释器轻量装载,非常适合短生命周期 CLI。 |
| 基线内存占用 | 较高(空载通常 30MB ~ 100MB+) | 极低(空载仅需 8MB ~ 20MB) | JVM 需要为类元数据、堆结构、CodeCache 预留空间;Python 运行时占用极其小巧。 |
| I/O 密集型并发 (Web 服务、数据库读写) |
极高(基于 Netty NIO 或 Loom 虚拟线程) | 极高(基于 asyncio 异步协程生态) | 两者性能差距显著缩小(瓶颈在网络等待与系统调用),开发效率与生态成为主导因素。 |
| 多核并行计算 | 原生多线程支持多核真并行调度 | 受 GIL 限制,CPU 密集任务需借助多进程 | Java 能充分释放现代数十核 CPU 的算力;Python 依靠 Multiprocessing 需要处理跨进程序列化开销。 |
五、总结与技术选型决策
理解编译执行与解释执行的本质差异,最终目的是为技术架构选型提供严谨的决策依据。没有绝对的好与坏,只有与业务场景的最佳契合:
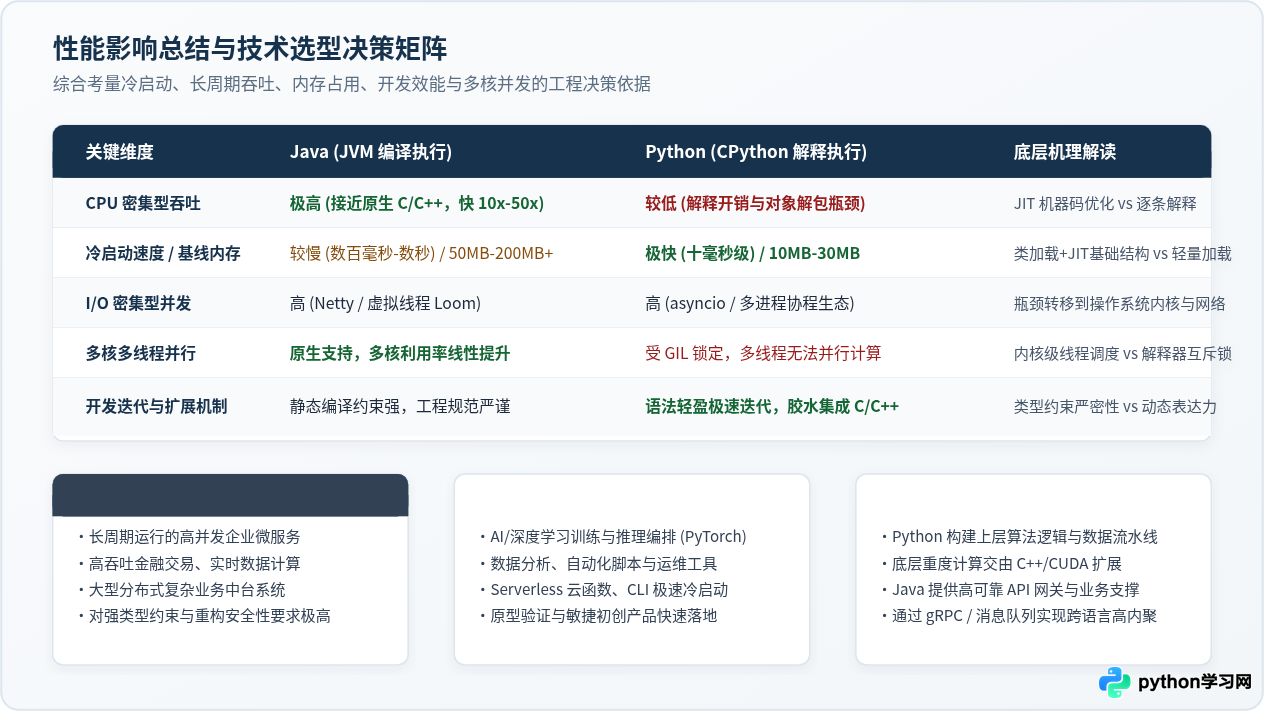
1. 优先选择 Java 的典型工程场景
- 长周期运行的企业级微服务与中后台系统:高并发服务有充分的时间完成 JIT 预热,能长期保持接近底层的极高吞吐率;强静态类型系统保障数十万行代码的大型团队协作与安全重构。
- 高频交易、数据实时流处理(如 Flink、Kafka):对毫秒级持续处理吞吐有刚性要求,需要多核并行计算与可控的内存模型。
- 全天候常驻多核并发服务:能够充分利用数十个 CPU 核心进行共享内存并行计算。
2. 优先选择 Python 的典型工程场景
- AI/机器学习模型研发与数据分析:依托高度成熟的底层 C/CUDA 加速生态,上层代码简洁轻快,能以最快速度完成算法验证。
- 自动化脚本、运维工具与短生命周期 CLI:极低的冷启动时间(毫秒级)和极小的内存占用,避免了 JVM 启动预热的笨重感。
- Serverless 云函数与初期原型验证:极速冷启动不仅降低计费时长,还能大幅缩短产品从想法到上线的交付周期。
3. 现代混合协同的最佳工程范式
在当前业界成熟的大型架构中,“Java + Python 协同作战”已成为标准范式:使用 Python 高效构建上层数据分析管道、AI 推理编排与快速业务实验;使用 Java 承载高并发业务中台、高可靠 API 网关与分布式资产沉淀,两者通过 gRPC 或消息中间件通信,兼收 Java 的极致吞吐与 Python 的敏捷生产力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









