

Python和Java的运行机制与性能差距有多大
深入对比Python与Java的底层运行机制、解释器与JIT编译原理、内存模型及在CPU计算、网络IO与并发场景下的真实性能差距,并提供工程选型与性能调优建议。
在纯算力消耗的 CPU 密集型任务中,Java 通常比标准 Python(CPython)快 10 到 50 倍以上;但在涉及网络传输、数据库查询等 I/O 密集型场景中,两者的实际业务吞吐差距通常会收窄至 1.5 到 3 倍以内。造成这一性能鸿沟的核心原因,是底层运行机制的本质不同:Python 依赖动态解释器在运行时逐条推断类型并执行字节码,同时受制于全局解释器锁(GIL);而 Java 依托高度成熟的 JVM,结合强静态类型与即时编译(JIT)技术,在运行期直接将热点字节码编译为原生硬件机器码。
一、代码是如何跑起来的:执行管线全流程对比
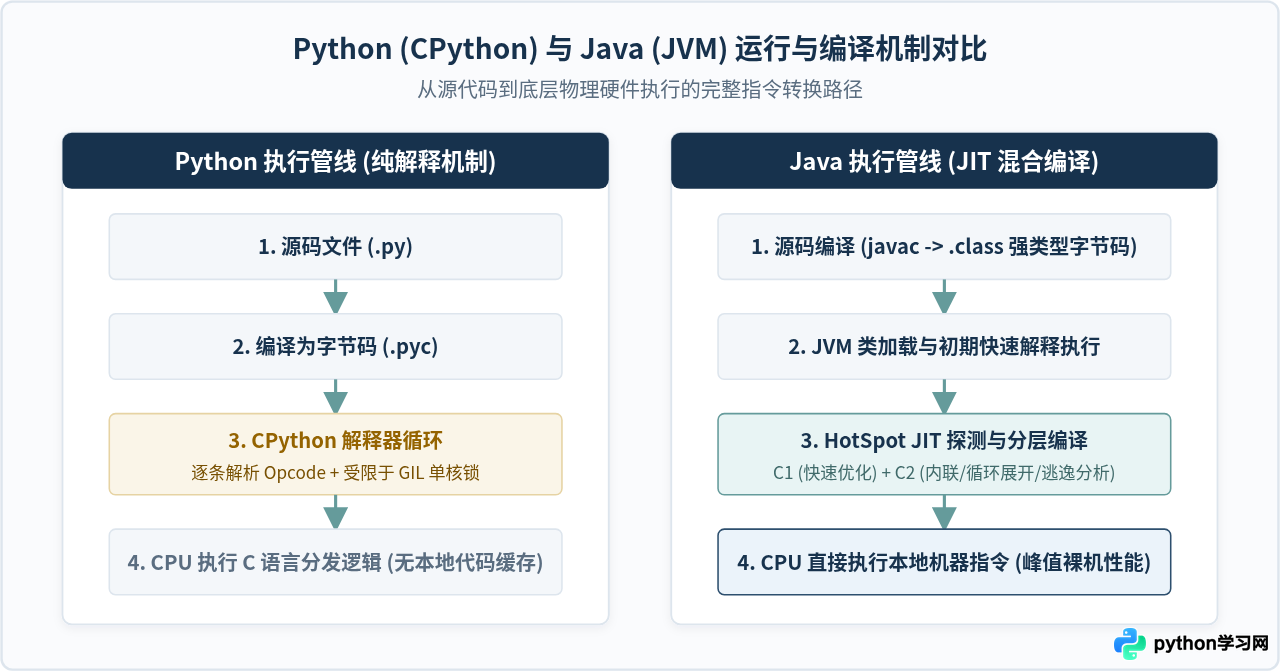
要看清两者的性能差距,必须先了解源代码从文本文件转变为 CPU 机器指令的完整物理链路。许多初学者常将 Python 称为“解释型语言”,将 Java 称为“编译型语言”,但从现代运行架构来看,两者都经历了“源码到字节码”的阶段,真正的性能分水岭出现在字节码之后的执行阶段。
1. Python(CPython)的解释执行链路
当你在终端输入 python script.py 时,官方默认解释器 CPython 会执行以下动作:
- 词法与语法分析:将
.py文本文件解析为抽象语法树(AST)。 - 编译为字节码:AST 被编译为供 Python 虚拟机识别的字节码指令集,并视情况持久化缓存为
.pyc文件。 - C 语言求值循环解释:CPython 的核心是一个庞大的 C 语言主循环函数(早期为
PyEval_EvalFrameEx,新版本为PyEval_EvalFrameDefault)。虚拟机维护着一个巨大的switch-case结构,每次从字节码流中取出一个操作码(Opcode),根据当前操作码调度对应的 C 函数执行。
在这个过程中,CPython 并不会把这些字节码变成 CPU 能够直接执行的汇编机器指令,每一行代码的每一次循环,都是在 C 语言的函数栈中再走一遍解释与调度逻辑。
2. Java(HotSpot JVM)的即时编译管线
Java 的运行模型分为静态前置编译与运行时分层动态编译两个阶段:
- 前置编译(javac):开发者编写的
.java源码由javac静态编译器检查语法并严格校验类型,直接生成平台无关的.class字节码文件。 - 类加载与初始解释:Java 虚拟机(JVM)启动后,类加载器将字节码载入内存,初期由 JVM 解释器快速执行,以保证应用能立即启动。
- 热点探测(HotSpot Detection):JVM 在后台持续统计方法调用计数器和循环回边计数器,当发现某段代码被频繁执行(即“热点代码”)时,触发 JIT(Just-In-Time)编译器。
- 分层 JIT 编译优化(C1 与 C2):
- Client 编译器(C1):进行基础优化并生成高效机器码,编译延迟极低。
- Server 编译器(C2):进行极其激进的全局优化(如全局值编号、逃逸分析、方法内联、循环展开与向量化),直接将字节码转化为与当前 CPU 架构完全匹配的本地裸机指令。
- 本地机器码全速执行:优化完成后,下一次执行该热点方法时,程序直接跳转到 CPU 机器指令内存区域运行,彻底脱离虚拟机解释层。
二、底层机制深剖:为何差距可达数十倍
即便同样是在内存中做一次简单的 1 + 1 循环累加,Python 的耗时也常常是 Java 的数十倍。这一悬殊表现并非单一模块导致,而是由数据类型系统、对象内存布局、并发模型与编译器深度优化四重机制共同决定的。
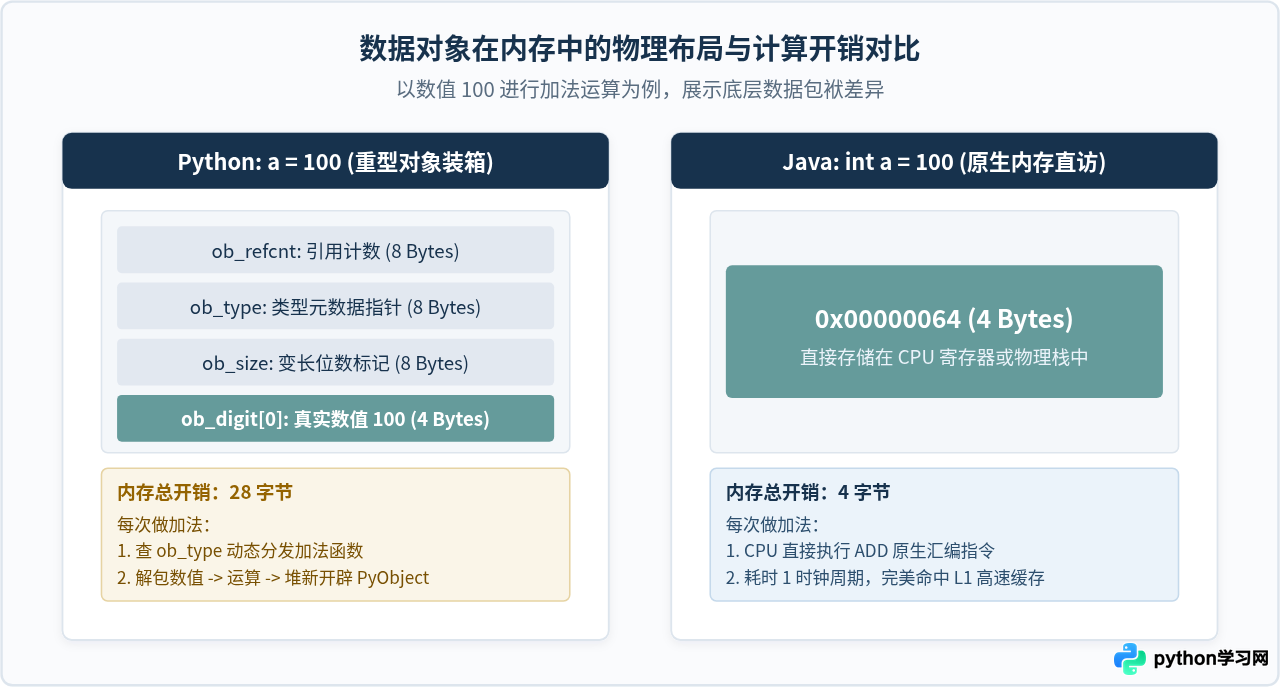
1. 动态类型检查与“万物皆对象”的装箱开销
在 Java 中,基本数据类型(如 int、long、double)是直接存储纯数值的裸数据:
int count = 100; // 在栈或寄存器中仅占用 4 字节连续内存
执行 count + 1 时,现代 CPU 只需调用一条简单的 ADD 汇编指令,1 个时钟周期内即可完成。
但在 Python 中,一切数据皆为堆对象。哪怕是一个微小的数字 100,底层也是一个完备的 C 语言结构体 PyLongObject:
// CPython 底层结构简化示意
struct _longobject {
    PyObject_VAR_HEAD; // 包含 8 字节引用计数 ob_refcnt + 8 字节类型指针 ob_type
    digit ob_digit[1]; // 实际数值存储数组
};
这带来两个严重的性能拖累:
- 内存膨胀与缓存失效:一个 64 位系统上的 Python 整数至少占用 28 字节,是 Java 原生
int(4字节)的 7 倍。巨额的内存碎片使得 CPU 极难命中 L1/L2 高速缓存。 - 动态类型查找开销:执行
a + b时,Python 无法提前假定两者是整数。解释器必须先取出ob_type指针,检查对象的类型魔术方法,在动态类型分发表中查找对应的加法实现(tp_as_number->nb_add),提取出数值后,再在堆中申请一块新内存构造全新的PyLongObject放回。整个过程需要几十次内存跳转与指针解引用。
2. JIT 的进阶黑魔法:方法内联与逃逸分析
JVM 拥有工业界极其强大的 C2 即时编译器。在程序执行数千次之后,JVM 会收集丰富的性能剖析数据(Profiling Data),并实施以下激进优化:
- 方法内联(Method Inlining):消除小方法调用的出入栈与参数传递开销,直接将调用处替换为方法体代码。
- 循环展开与向量化(SIMD):将原本单步循环的代码自动改写为 4 步或 8 步并行,甚至利用 CPU 的 AVX 指令集单指令处理多条数据。
- 逃逸分析(Escape Analysis):如果分析证明一个对象的作用域不会逸出当前方法,JVM 会将原本要在堆中分配的对象“标量替换”直接打散到 CPU 寄存器或物理栈中,彻底省去堆分配与 GC 负担。
这些高级编译技术,是标准 CPython 解释器完全不具备的。
3. 多线程与并发锁:GIL 与真多线程
多核 CPU 普及的今天,并行能力是性能的关键支撑:
- Python 的全局解释器锁(GIL):由于 CPython 内存管理依赖引用计数,为了防止多线程并发修改引用计数导致内存损坏,GIL 强制规定同一进程内任何时刻只能有一个系统线程在执行 Python 字节码。这意味着无论你在服务器配置了 32 核还是 64 核 CPU,纯 Python 编写的多线程密集计算程序都只能跑满单个核心,甚至因多线程争抢 GIL 锁带来额外的上下文切换损耗。
- Java 的操作系统级原生多线程:Java 的
Thread(以及 JDK 21 引入的虚拟线程 Virtual Thread)直接映射到操作系统的内核线程。多线程并行计算可以毫无阻碍地跑满所有物理核心。
三、多维业务场景真实性能差距量化
脱离具体业务场景谈性能没有实际指导意义。在工程实践中,我们必须把“纯计算”、“网络 I/O”和“系统冷启动”分开考量。
场景一:CPU 密集型(纯循环累加与算法模拟)
为了直观展示两者的执行差距,以一段最典型的 1 亿次数值累加操作为例:
# Python 原生循环示例
def test_calc():
    total = 0
    for i in range(100_000_000):
        total += i
    return total
// Java 原生循环示例
public static long testCalc() {
long total = 0;
for (long i = 0; i < 100_000_000L; i++) {
total += i;
}
return total;
}在现代主流 x86/ARM 服务器处理器上运行上述代码:
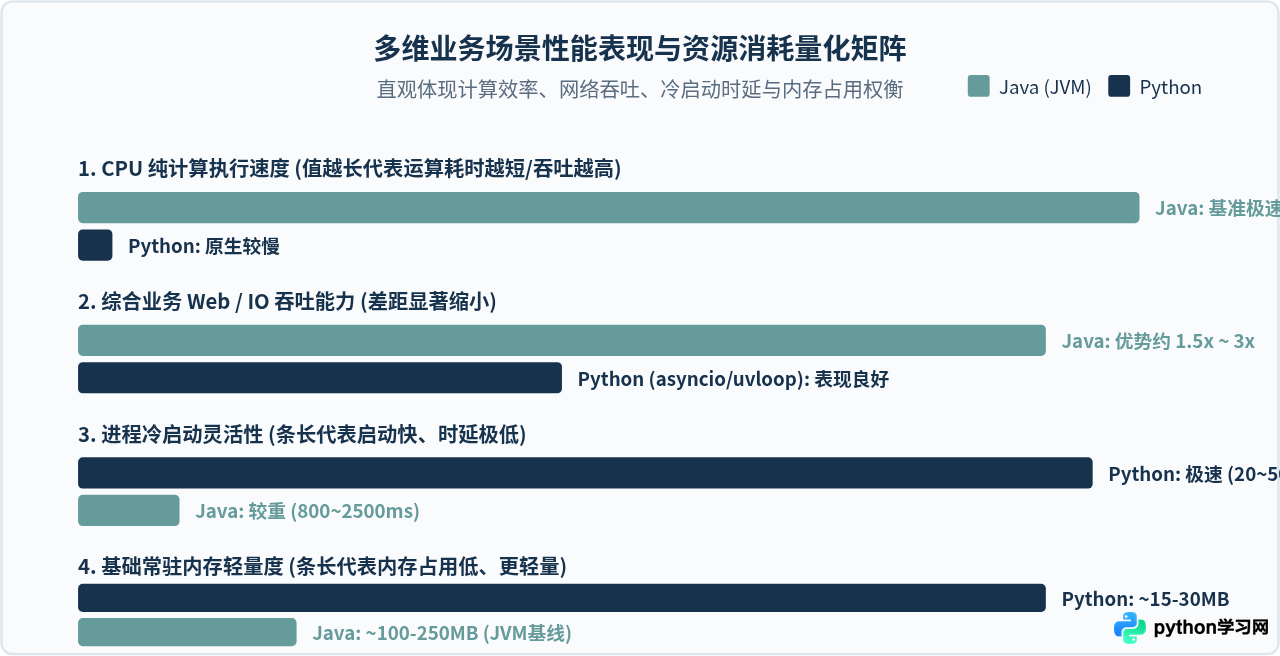
- Python (CPython 3.11+):耗时约 3.5 秒到 5.2 秒。每次循环都要经过字节码解包与变量更新。
- Java (HotSpot JDK 17/21):耗时约 0.04 秒到 0.08 秒。JIT 编译器迅速将代码编译为机器汇编,甚至可能在内联后直接利用寄存器完成向量累加。
- 差距倍数:Java 比 Python 快 40 到 80 倍。如果在多核并行场景下,由于 Java 可以无缝使用全部核数而 Python 受制于 GIL,多核综合吞吐差距可进一步拉大到百倍以上。
场景二:I/O 密集型(Web API、微服务与数据库操作)
在典型的 Web 业务中,绝大部分时间花费在等网络数据包、等磁盘读写以及等外部数据库(如 PostgreSQL / Redis)返回结果上。
当使用成熟的异步生态(如 Python 的 FastAPI + uvicorn + asyncpg 对比 Java 的 Spring Boot + Netty)时:
- 单个简单“Hello World”响应的纯吞吐测试中,Java Netty 往往能达到 20 万到 40 万 QPS,而 Python 异步服务通常在 3 万到 7 万 QPS 之间,差距在 3 到 5 倍。
- 在接入真实数据库、包含业务序列化与校验的典型业务链路中,系统吞吐受限于数据库连接池与 SQL 查询耗时,两者的整体接口响应时延差异通常缩小到 1.2 到 2 倍以内。
场景三:冷启动时间与基础常驻内存
在无服务器计算(Serverless/FaaS)、命令行工具(CLI)以及资源极度敏感的边缘容器中,性能的定义从“运行速度”转为了“启动速度与资源占有率”:
- Python:解释器启动极其轻快,冷启动仅需 20ms 到 50ms,初始常驻内存(RSS)通常只有 15MB 到 30MB。
- Java:由于 JVM 庞大的运行时、类加载机制与字节码验证流程,传统 Java 程序的冷启动往往需要 800ms 到 2.5 秒以上,初始常驻内存通常在 100MB 到 300MB 之间。
四、弥合鸿沟:Python 与 Java 各自的性能突围手段
现实开发中,我们不需要非黑即白地评价两种技术。双方生态为了解决自身的短板,都演进出了成熟的工程应对方案。
1. Python 如何摆脱性能掣肘
- 胶水语言特性 + C/Rust 原生扩展:这是 Python 在数据分析与人工智能领域称霸的核心法宝。NumPy、PyTorch、Polars 等核心计算库,本质上只是用 Python 作为高级接口,其核心数值运算全都在 C++、Fortran 或 Rust 中编译为紧凑的原生指令运行,完全绕过了 CPython 的解释循环与 GIL 限制。
- PyPy 替代解释器:对于无法重写为底层扩展的纯 Python 业务逻辑,可以使用 PyPy 替换标准 CPython。PyPy 内置了强大的 JIT 编译器,能在运行时将纯 Python 代码提速 4 到 10 倍。
- 多进程架构:通过
multiprocessing模块或基于 Gunicorn/Uvicorn 启动多 Worker 进程,彻底绕开单个 GIL 限制,跑满多核 CPU。
2. Java 如何解决冷启动与高内存负担
- GraalVM Native Image(AOT 静态编译):现代 Java 支持将代码在构建期通过 AOT(Ahead-Of-Time)技术直接编译成平台专有的独立可执行二进制文件。这消除了 JVM 启动开销与动态解释阶段,让 Java 程序的冷启动时间骤降至 10ms 以内,基础常驻内存降低到 20MB,完美适应云原生微服务与 Serverless 场景。
- 下一代低延迟垃圾收集器:ZGC(Z Garbage Collector)与 Shenandoah GC 已实现对数 TB 堆内存进行亚毫秒级(<1ms)停顿的垃圾回收,保证了高并发服务极度平稳的 P99 响应曲线。
五、技术选型决策与最佳组合策略
理解了两种语言的运行机制与性能差距后,架构决策就不再凭个人偏好,而是依据明确的业务约束进行权衡:
| 对比维度 | Python (CPython) | Java (HotSpot JVM) | 选型建议 |
|---|---|---|---|
| 核心性能上限 | 纯计算偏弱,需依赖外部底层扩展库 | 极高,全速执行本地机器码 | 高频计算密集型核心必须选 Java 或底层语言 |
| 多核并发吞吐 | 受限 GIL,通常使用多进程横向扩展 | 原生多线程与虚拟线程,天然利用全核 | 高吞吐网络后台服务首选 Java |
| 开发与迭代效率 | 动态类型,语法精炼,生态库极度丰富 | 静态强类型,工程结构严密,代码量偏多 | 算法试验、数据管道、敏捷业务首选 Python |
| 内存与启动特性 | 轻量敏捷,开箱即用,极低冷启动延迟 | 常驻堆内存基线较高,传统模式启动较慢 | 运维脚本、轻量任务、自动化工具选 Python |
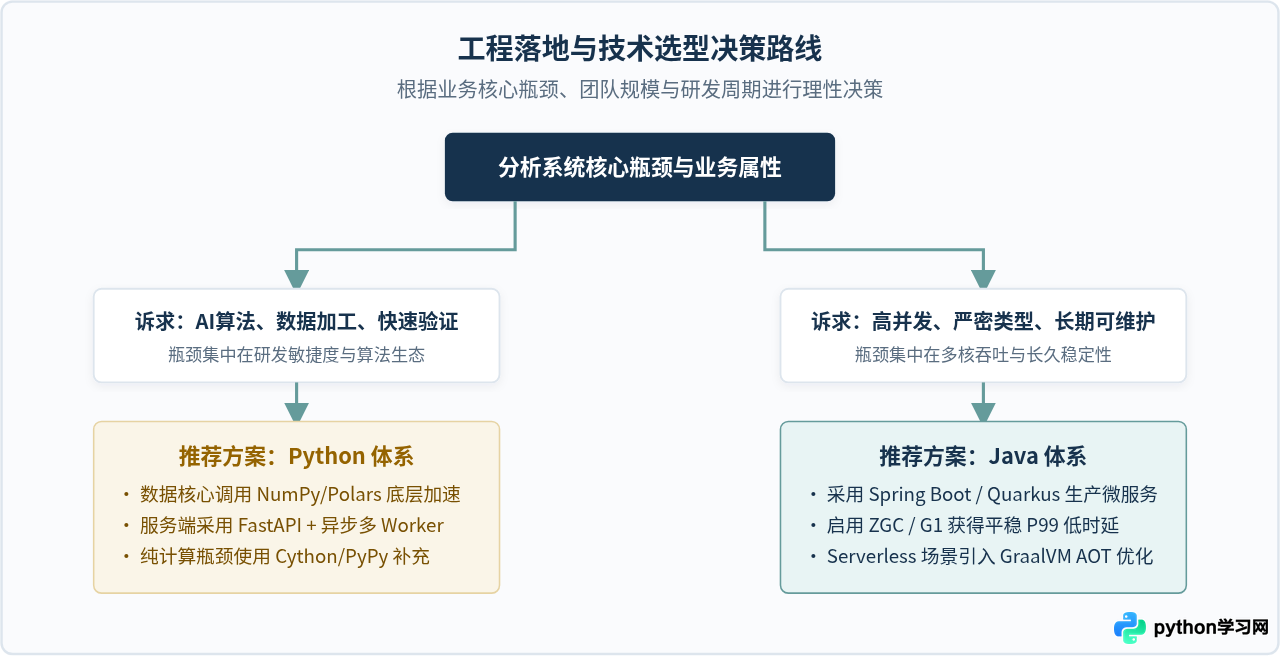
总结: Python 与 Java 的性能差距是“动态解释哲学”与“静态即时编译哲学”在工程权衡上的必然结果。如果追求极致的 CPU 单机计算上限、高吞吐多线程并发以及大型工程的静态类型安全性,Java 是当之无愧的工业级基石;而如果追求极高的开发试错速度、轻便敏捷的原型构建以及强大的 AI/数据科学胶水能力,Python 则是无出其右的利器。现代成熟的技术团队往往采用“双剑合璧”的架构:由 Python 负责上层算法研发与业务胶水,由 Java 或底层编译型系统承载高并发服务底座,各自在其最擅长的战场发挥最大价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









