

Python连接MySQL时怎么设置charset避免中文乱码
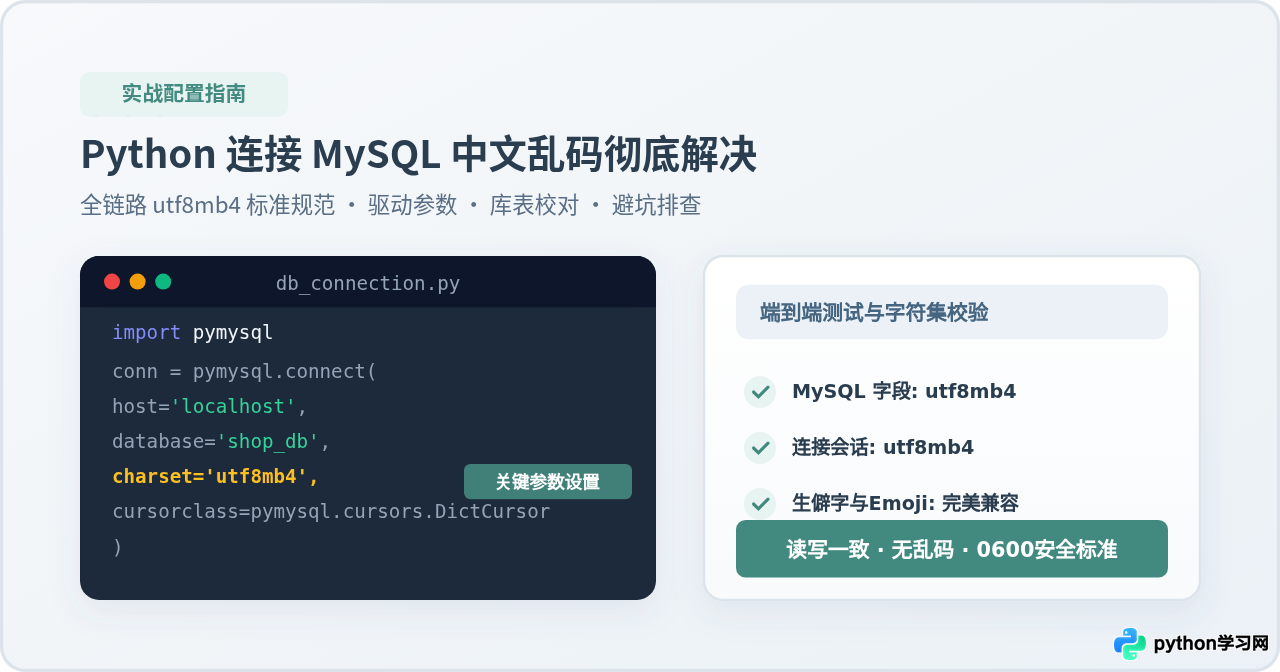
详细解析Python连接MySQL时设置charset避免中文乱码的核心方法与底层原理。涵盖PyMySQL、mysqlclient、SQLAlchemy等主流驱动的标准配置、实操步骤、连接验证与常见排错避坑清单。
charset='utf8mb4'(严禁写成带有短横线的 'utf-8',也不要使用仅支持最多 3 字节的陈旧 'utf8'),并确保 MySQL 目标数据库及数据表的字段字符集同样配置为 utf8mb4。
一、为什么会出现中文乱码与字符截断
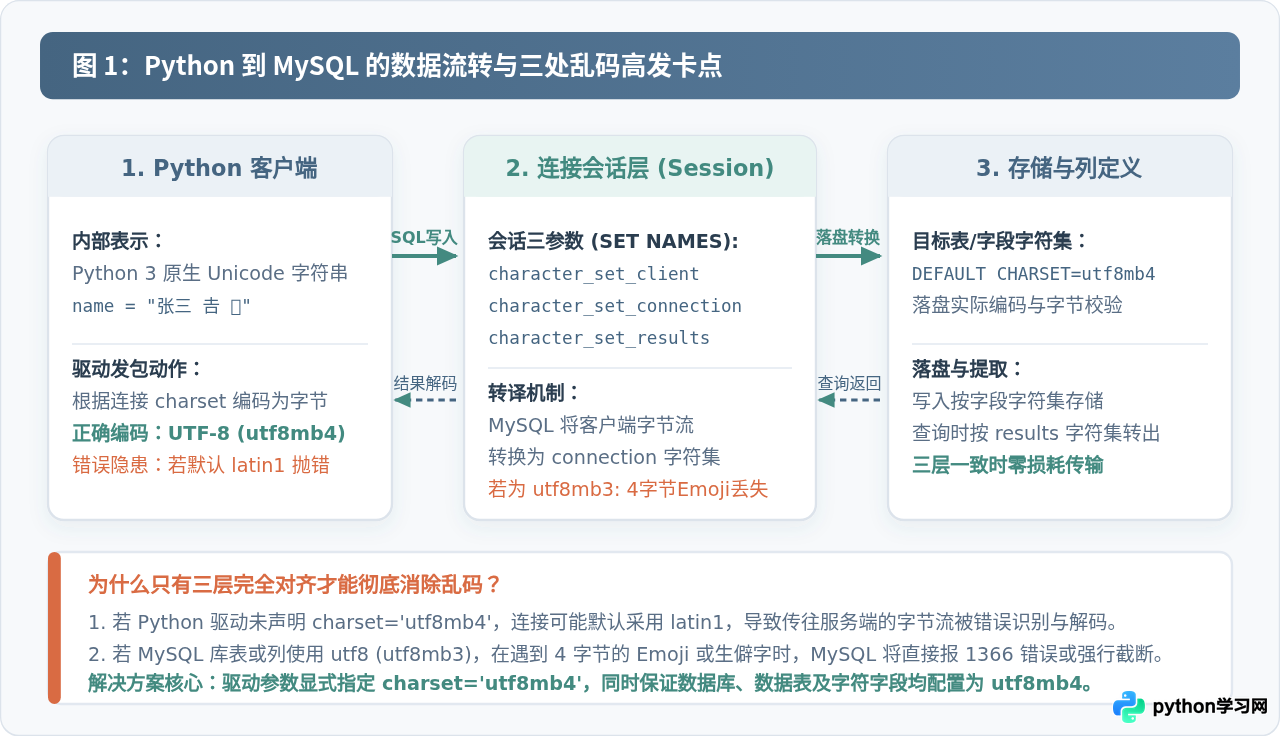
在 Python 3 中,程序内部所有字符串对象(str)都是统一的 Unicode 字符序列。然而,当 Python 通过数据库驱动(例如 PyMySQL、mysqlclient)向 MySQL 发送 SQL 查询或写入数据时,字符串必须先被编码为二进制字节流(bytes),通过网络协议传输给 MySQL 服务器;查询返回结果时,驱动再将 MySQL 返回的字节流反向解码为 Python 的 str 对象。
乱码或报错通常出现在以下三个关键衔接点:
- 客户端与连接会话字符集不一致:如果 Python 连接未显式声明字符集,驱动可能退回默认的
latin1字符集,导致汉字在发往服务端时被误当成西文字符处理,产生诸如???或ä¸æ等乱码。 - MySQL 历史字符集
utf8(即utf8mb3)的容量缺陷:官方早期在 MySQL 中定义的utf8仅支持 1 至 3 字节编码。当遇到 4 字节的汉字生僻字、特定古籍字或 Emoji 表情时,MySQL 会直接抛出OperationalError: (1366, "Incorrect string value...")异常,或在非严格模式下强行截断文本。 - 列级别字符集遗漏:即便客户端和数据库默认字符集均设为 UTF-8,但若具体数据表或列依然保留着旧有的
latin1编码,MySQL 会在内部转换时导致信息永久损坏。
二、实操配置:四步彻底解决中文乱码
解决乱码不是单一代码参数的修改,而需要保证“服务端数据表、连接会话、客户端驱动”三者规范对齐。按照以下四个标准步骤进行排查与配置即可稳定运行。
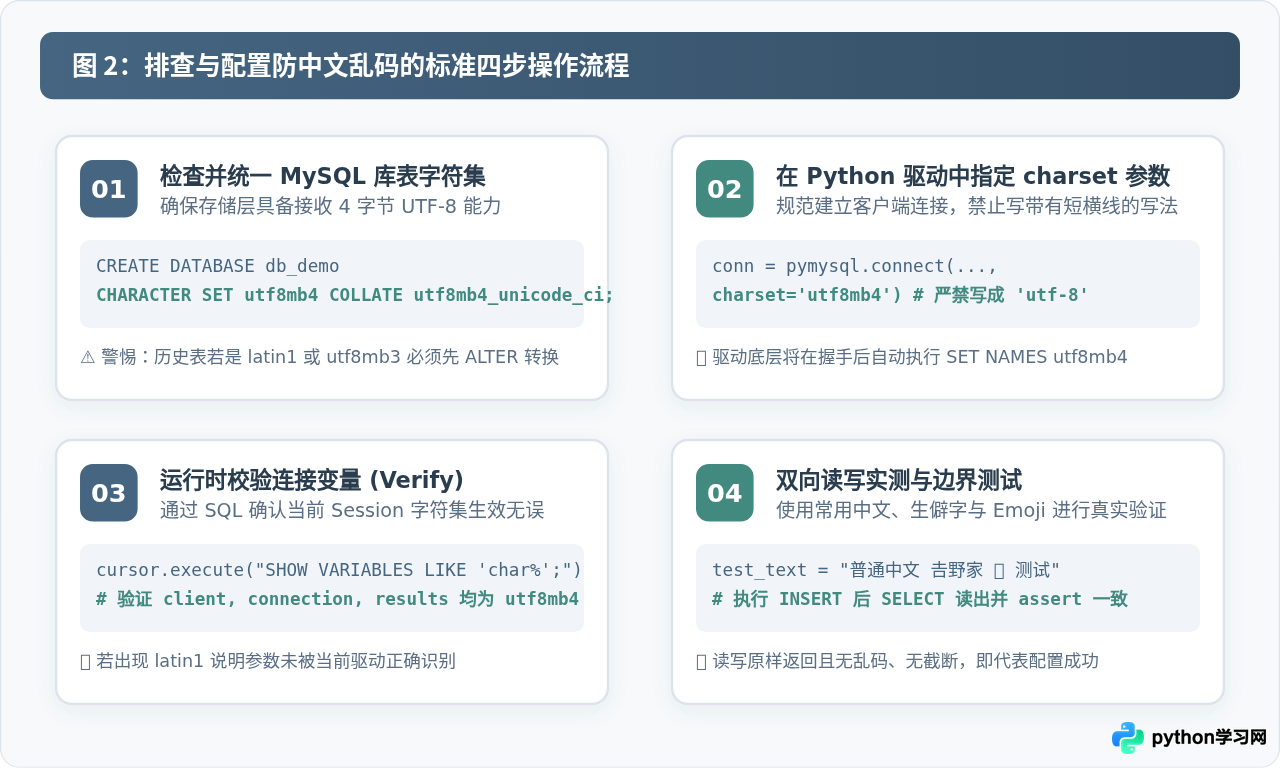
第 1 步:创建与校对 MySQL 数据库及数据表字符集
在创建数据库和数据表时,明确声明字符集为 utf8mb4,排序规则推荐采用 utf8mb4_unicode_ci(兼容性极佳)或 MySQL 8.0 默认的 utf8mb4_0900_ai_ci:
-- 1. 创建数据库时指定 utf8mb4
CREATE DATABASE db_tutorial
DEFAULT CHARACTER SET utf8mb4
DEFAULT COLLATE utf8mb4_unicode_ci;

-- 2. 创建数据表时明确声明 DEFAULT CHARSET=utf8mb4
USE db_tutorial;

CREATE TABLE article_content (
    id INT AUTO_INCREMENT PRIMARY KEY,
    title VARCHAR(200) NOT NULL,
    body TEXT NOT NULL,
    author VARCHAR(50) NOT NULL
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;latin1 或 utf8,单纯执行 ALTER DATABASE 不会修改现有表的列编码。必须使用 ALTER TABLE 表名 CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci; 命令,它会连同现有列定义和物理存储数据一并转换为标准的 utf8mb4。
第 2 步:在 Python 连接时正确配置 charset 参数
在 Python 代码中初始化数据库连接时,必须将参数 charset 赋值为字符串 'utf8mb4'。无论使用的是 PyMySQL、mysqlclient 还是 mysql-connector-python,均需遵循该命名规范。
以最常见的 PyMySQL 为例:
import pymysql

# 建立连接:显式指定 charset='utf8mb4'
connection = pymysql.connect(
    host='127.0.0.1',
    port=3306,
    user='db_user',
    password='SecurePassword_123',
    database='db_tutorial',
    charset='utf8mb4',  # 关键参数:绝不写 'utf-8',必须是 'utf8mb4'
    cursorclass=pymysql.cursors.DictCursor,
    autocommit=True
)
第 3 步:运行时查询并验证连接字符集生效情况
建立连接后,可以通过执行 MySQL 的字符集系统变量查询,确认当前连接所采用的 character_set_client、character_set_connection 和 character_set_results 是否确实为 utf8mb4:
with connection.cursor() as cursor:
    cursor.execute("SHOW VARIABLES LIKE 'character_set_%';")
    variables = {row['Variable_name']: row['Value'] for row in cursor.fetchall()}

    print("客户端字符集:", variables.get('character_set_client'))
    print("连接层字符集:", variables.get('character_set_connection'))
    print("结果集字符集:", variables.get('character_set_results'))
预期输出结果中,上述三项变量的值应当全部显示为 utf8mb4。如果其中某项出现 latin1 或其他西文字符集,说明当前驱动的参数未被生效或被其他初始化指令覆盖。
第 4 步:完整插入与读取测试(含生僻字与 Emoji)
进行端到端验证时,不能仅使用简单的一二级汉字测试,应当同时包含生僻字(如“𠮷”、“燚”)和四字节符号进行边界检验:
# 编写包含常见中文、生僻字与四字节字符的测试样本
sample_title = "Python数据库编码验证说明"
sample_body = "测试文本包含普通汉字、生僻字【𠮷野家】以及符号表情 🚀🎉。"
sample_author = "张工程师"

with connection.cursor() as cursor:
    # 执行参数化写入
    insert_sql = """
        INSERT INTO article_content (title, body, author)
        VALUES (%s, %s, %s);
    """
    cursor.execute(insert_sql, (sample_title, sample_body, sample_author))
    inserted_id = cursor.lastrowid

    # 查询刚刚写入的数据
    query_sql = "SELECT id, title, body, author FROM article_content WHERE id = %s;"
    cursor.execute(query_sql, (inserted_id,))
    result = cursor.fetchone()

    # 校验读取回来的字符串是否完全无损
    assert result['body'] == sample_body, "数据存在字符损耗或乱码!"
    print("测试成功,读出内容:", result['body'])
三、主流 Python 驱动及 ORM 的配置对照
Python 生态中有多种与 MySQL 交互的驱动程序和对象关系映射(ORM)框架。尽管其底层最终都发送相同的协议指令,但传入参数的语法略有不同:
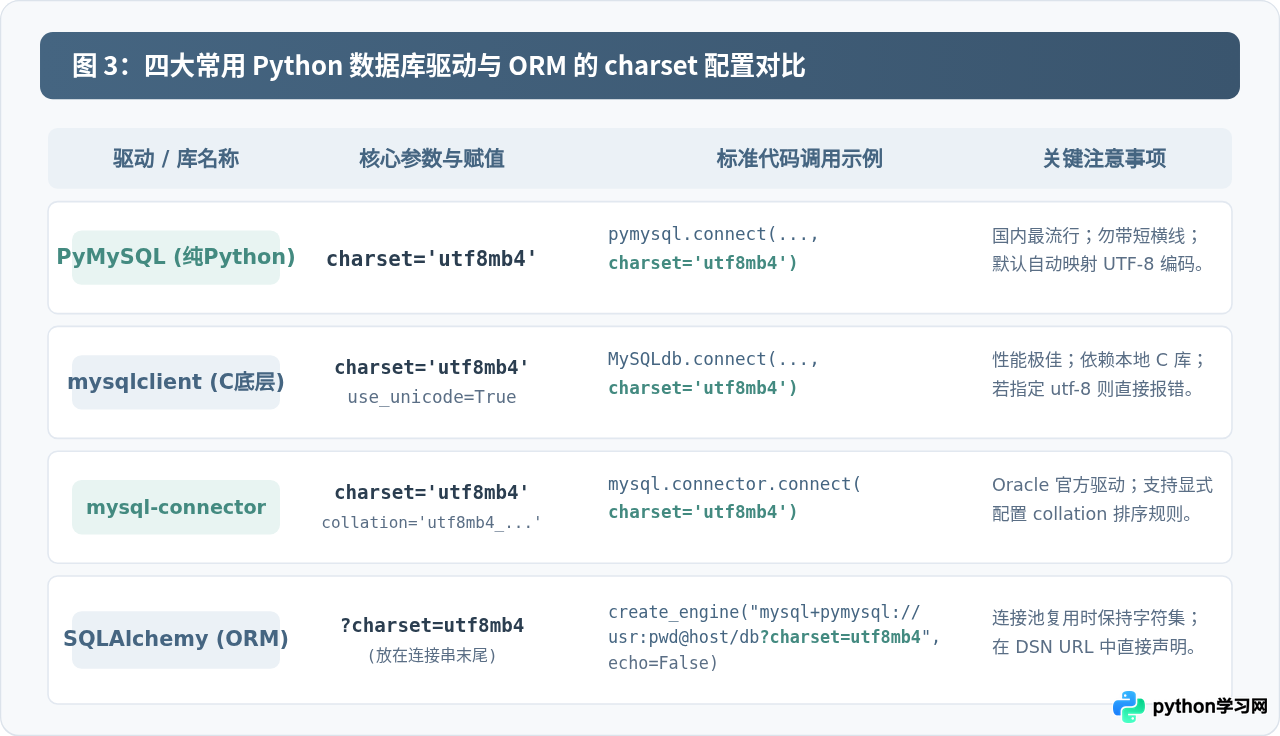
| 组件名称 | 依赖类型 | 连接参数写法 | 配置示例 |
|---|---|---|---|
| PyMySQL | 纯 Python 实现 | charset='utf8mb4' |
pymysql.connect(..., charset='utf8mb4') |
| mysqlclient | C 语言扩展 (MySQL C API) | charset='utf8mb4', use_unicode=True |
MySQLdb.connect(..., charset='utf8mb4') |
| mysql-connector-python | Oracle 官方驱动 | charset='utf8mb4', collation='...' |
mysql.connector.connect(..., charset='utf8mb4') |
| SQLAlchemy (ORM) | 统一数据库抽象层 | 在 DSN 连接串中附加查询参数 | create_engine("mysql+pymysql://user:pwd@host/db?charset=utf8mb4") |
1. mysqlclient(即底层 MySQLdb)
由于直接包装了 C 语言的 libmysqlclient,mysqlclient 在处理字符集时对命名要求极为严格。若传入 charset='utf-8',驱动会立刻抛出 Can't initialize character set utf-8 错误。必须严格传递 charset='utf8mb4':
import MySQLdb

conn = MySQLdb.connect(
    host='localhost',
    user='root',
    passwd='password',
    db='db_tutorial',
    charset='utf8mb4',
    use_unicode=True
)
2. SQLAlchemy 引擎配置
在基于 SQLAlchemy 的 Web 项目(如 Flask 或 FastAPI)中,通常使用数据库连接 URI。必须在 URI 的参数部分显式追加 ?charset=utf8mb4:
from sqlalchemy import create_engine

# 在连接串尾部添加 ?charset=utf8mb4
DATABASE_URI = "mysql+pymysql://db_user:SecurePass@127.0.0.1:3306/db_tutorial?charset=utf8mb4"

engine = create_engine(
    DATABASE_URI,
    pool_size=10,
    max_overflow=20,
    pool_pre_ping=True  # 建议开启:自动检测断开重连并恢复字符集状态
)
四、常见误区与避坑清单
在实际开发与线上维护过程中,以下四类典型误区最为常见:
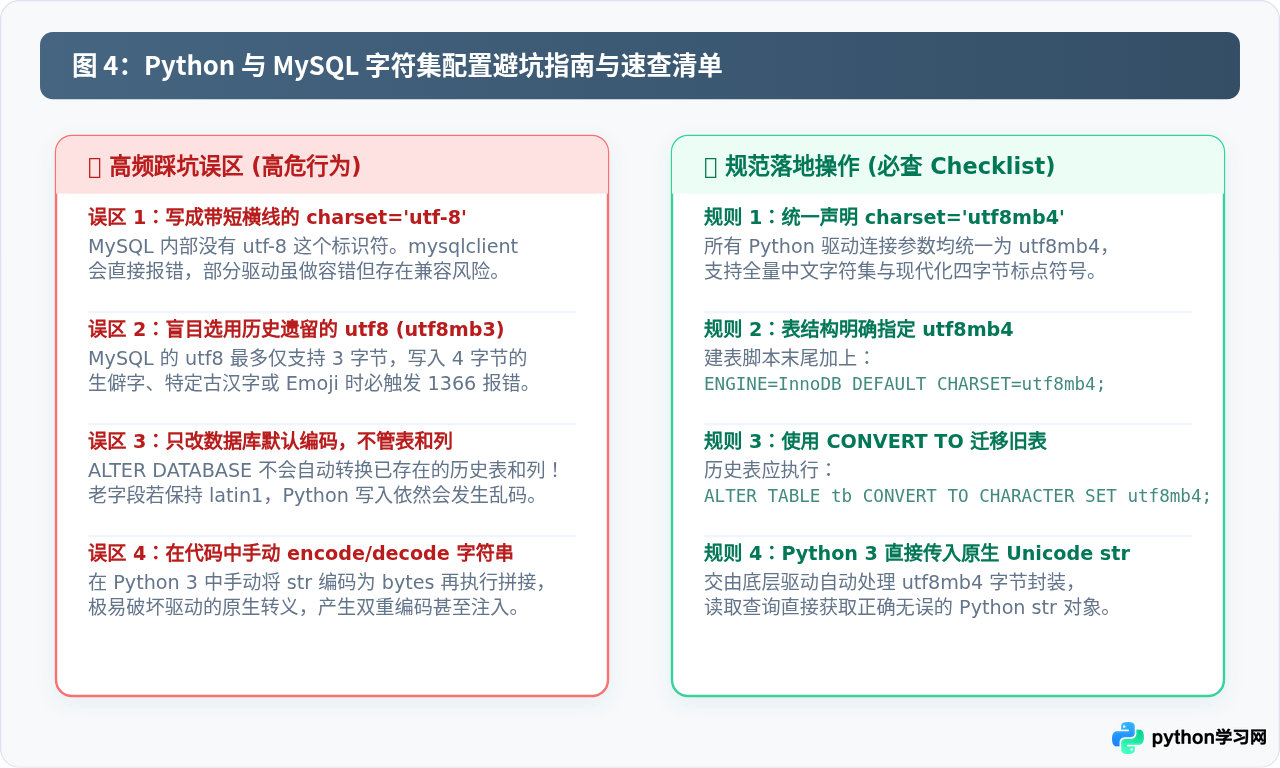
- 严禁写成
utf-8:许多初学者习惯了网页或文本编辑器中的标准 MIME 编码名称UTF-8,而在代码中写下charset='utf-8'。MySQL 内部没有该字符集名称,只有utf8或utf8mb4。部分 Python 驱动会直接报出连接失败或不识别字符集的错误。 - 抛弃历史过时的
utf8:MySQL 早期的utf8实际上等同于utf8mb3,每个字符最多使用 3 字节存储。不仅不支持 Emoji,而且像“𠮷”等扩展字也会引发存储异常。新项目应无条件统一选择utf8mb4。 - 勿在 Python 代码中手动
encode/decode:Python 3 驱动程序内部会自动将 Pythonstr转换成网络二进制并发送。开发者无需手动执行text.encode('utf-8')再去组装 SQL,手动编码不仅破坏参数化绑定的防 SQL 注入功能,还可能导致双重编码。 - 连接池重连重置会话变量:如果使用连接池,个别配置不当的重连机制可能使会话退回 MySQL 服务端的全局默认字符集。在 SQLAlchemy 中开启
pool_pre_ping=True,并在 DSN 中固定?charset=utf8mb4,可确保从池中借出的每一个连接都保持预设字符集。
五、总结
在 Python 连接 MySQL 的全流程中,彻底消除中文乱码的核心脉络可以总结为一句话:“全链路统一为 utf8mb4,连接参数显式声明无短横线的 charset='utf8mb4'”。只要保证数据库、数据表、列定义与 Python 驱动连接参数四处一致,即可实现生僻字、现代符号与日常汉字在读写交互中的零损耗与安全存储。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









