

Python操作数据库怎么防止SQL注入?安全实践与参数化查询
全面讲解在 Python 中防止 SQL 注入的核心机理与实用操作方案,深入分析字符串拼接的危害、PEP 249 占位符规范、主流驱动(sqlite3、PyMySQL、psycopg、SQLAlchemy)的标准安全写法,以及动态表名与 IN 查询等复杂场景的安全处理策略。
一、SQL 注入的根源与 Python 中的高危写法
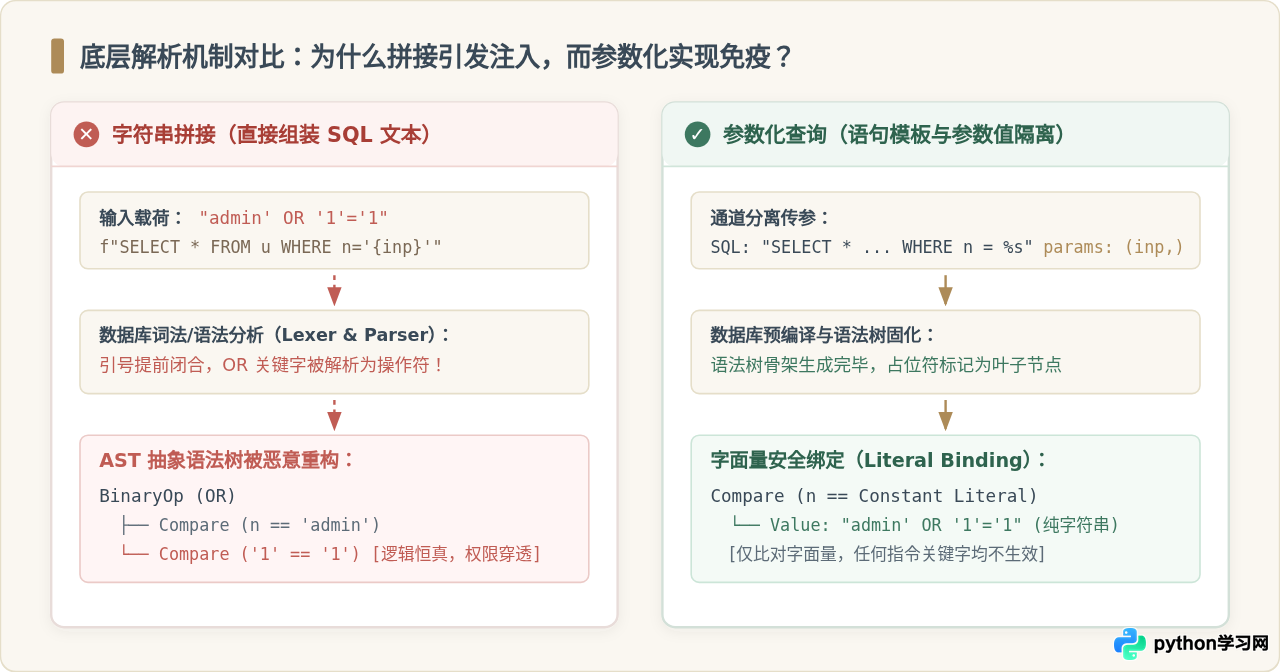
SQL 注入并非数据库本身的缺陷,而是应用程序在构造 SQL 查询文本时,将“代码指令”与“不受信任的外部输入数据”错误混杂所致。在数据库引擎执行查询之前,必须先经过词法分析器(Lexer)与语法分析器(Parser),将传入的纯文本字符串解析成一棵抽象语法树(AST)。如果用户输入中包含引号、注释符或 SQL 关键字,而程序直接用字符串拼接组装 SQL,这些输入内容就会直接参与词法分析,篡改原本预定的语法结构。
在 Python 开发中,初学者或缺乏安全意识的代码中最常见的四种高危字符串拼接写法如下:
# 【高危写法 1:f-string 拼接】
sql = f"SELECT * FROM users WHERE username = '{username}' AND password = '{password}'"
cursor.execute(sql)

# 【高危写法 2:% 格式化拼接】
sql = "SELECT * FROM users WHERE username = '%s'" % username
cursor.execute(sql)

# 【高危写法 3:str.format() 拼接】
sql = "SELECT * FROM users WHERE username = '{}'".format(username)
cursor.execute(sql)

# 【高危写法 4:+ 运算符拼接】
sql = "SELECT * FROM users WHERE username = '" + username + "'"
cursor.execute(sql)
假设用户在前端登录表单的用户名框中输入了 admin' OR '1'='1,密码任意填写。经过上述任何一种字符串拼接后,发送给数据库的 SQL 字符串将变成:
SELECT * FROM users WHERE username = 'admin' OR '1'='1' AND password = 'xxx'此时单引号提前闭合了原本的用户名字符串,OR '1'='1' 被语法分析器解析为布尔逻辑运算符,使整条 WHERE 条件恒为真,攻击者无需密码便能直接以管理员身份登录系统。若攻击者传入 '; DROP TABLE users; --,更可能导致整个数据表被物理销毁。
二、参数化查询的核心机制与 PEP 249 规范
参数化查询(Parameterized Queries,又称参数绑定或预编译语句 Prepared Statements)之所以能够彻底消除 SQL 注入,关键在于它改变了数据库与驱动之间的通信方式与解析时机。
在参数化查询模式下,Python 驱动向数据库引擎发送的是一个包含占位符的 SQL 骨架模板,同时将具体的数据变量打包放入单独的数据槽位中。数据库引擎对 SQL 模板进行词法与语法分析,锁定其抽象语法树(AST)的结构分支与算子。此时,占位符在语法树中已经被牢固标记为“叶子节点上的常量数据值”。随后传入的外部数据无论是否含有单引号、分号、注释符或 SQL 关键字,都仅会被当作纯字符串或数值填入叶子节点,绝无可能被编译器逆向提升为语法指令。
1. Python PEP 249 标准的占位符风格
Python 官方在 PEP 249(Python Database API Specification v2.0)规范中对各数据库驱动的参数传递风格进行了明确定义(通过模块属性 paramstyle 可查看)。不同数据库驱动所采用的占位符语法并不完全一致:
| 风格名称 (paramstyle) | 占位符语法 | 典型驱动库 | 示例代码片段 |
|---|---|---|---|
| qmark | ? |
内置 sqlite3 | cursor.execute("SELECT * FROM t WHERE id = ?", (uid,)) |
| format | %s |
PyMySQL, mysql-connector, psycopg2 | cursor.execute("SELECT * FROM t WHERE id = %s", (uid,)) |
| pyformat | %(name)s |
psycopg2, PyMySQL | cursor.execute("SELECT * FROM t WHERE id = %(id)s", {'id': uid}) |
| named | :name |
sqlite3, SQLAlchemy text | cursor.execute("SELECT * FROM t WHERE id = :id", {'id': uid}) |
| numeric | :1, :2 |
cx_Oracle / oracledb | cursor.execute("SELECT * FROM t WHERE id = :1", (uid,)) |
%s 绝非 Python 字符串格式化!很多初学者看到 PyMySQL 或 psycopg2 中使用
%s,便误以为它是在执行 Python 内部的 "..." % (...) 字符串格式化。必须特别强调:
- 错误写法(依然存在注入漏洞):
cursor.execute("SELECT * FROM users WHERE name = '%s'" % username)—— 这是先在 Python 内存中拼接成新字符串,再交给数据库,完全没有起到参数化作用! - 正确写法(安全参数化):
cursor.execute("SELECT * FROM users WHERE name = %s", (username,))—— 注意逗号!SQL 字符串中不要对%s加任何引号,且必须将参数作为execute()的第二个独立参数传入。
三、主流数据库驱动与 ORM 的标准安全写法
1. SQLite(标准库 sqlite3)
Python 标准库自带的 sqlite3 支持问号位置参数(qmark)和冒号命名参数(named)。
import sqlite3

conn = sqlite3.connect(":memory:")
cursor = conn.cursor()
cursor.execute("CREATE TABLE users (id INTEGER PRIMARY KEY, username TEXT, role TEXT)")

# 方式 A:位置参数(qmark),第二个参数必须是元组或列表
username_input = "alice"
cursor.execute("SELECT * FROM users WHERE username = ?", (username_input,))

# 方式 B:命名参数(named),第二个参数传入字典,可读性更佳
cursor.execute(
    "SELECT * FROM users WHERE username = :uname AND role = :urole",
    {"uname": username_input, "urole": "admin"}
)
2. MySQL(PyMySQL / mysqlclient)
在 MySQL 驱动中,PEP 249 占位符统一使用 %s。不管字段类型是整数、浮点数还是字符串,占位符一律使用 %s,驱动层会自动根据 Python 变量类型进行二进制转换和协议传输。
import pymysql

conn = pymysql.connect(host="127.0.0.1", user="app_user", password="secret", database="shop")
with conn.cursor() as cursor:
    user_id = 42
    status = "ACTIVE"
    # 正确:占位符不加引号,参数作为第二个元组传入
    cursor.execute(
        "SELECT id, username, email FROM users WHERE id = %s AND status = %s",
        (user_id, status)
    )
    row = cursor.fetchone()

    # 批量安全写入:使用 executemany 配合参数列表
    batch_data = [
        ("bob", "bob@example.com"),
        ("charlie", "charlie@example.com")
    ]
    cursor.executemany(
        "INSERT INTO users (username, email) VALUES (%s, %s)",
        batch_data
    )
conn.commit()
3. PostgreSQL(psycopg 3 / psycopg2)
最新一代的 PostgreSQL 驱动 psycopg(psycopg 3)与经典的 psycopg2 均支持安全参数化绑定,并能深度利用 PostgreSQL 的原生二进制协议。
import psycopg

# psycopg 3 标准连接
with psycopg.connect("dbname=shop user=app_user password=secret") as conn:
    with conn.cursor() as cur:
        search_kw = "python%"
        # 正确传参:支持位置参数(元组)
        cur.execute(
            "SELECT id, title, price FROM products WHERE title LIKE %s",
            (search_kw,)
        )

        # 同时也支持命名参数(pyformat 风格字典传参)
        cur.execute(
            "SELECT id, title FROM products WHERE price > %(min_price)s AND status = %(st)s",
            {"min_price": 99.0, "st": "IN_STOCK"}
        )
4. ORM 框架(SQLAlchemy)
SQLAlchemy 在使用其高层 Core 表达式或 ORM 查询构建器时,底层会自动完成参数化封装。如果遇到复杂查询必须手写原生 SQL,则必须使用 text() 构造器配合绑定参数。
from sqlalchemy import create_engine, text
from sqlalchemy.orm import Session

engine = create_engine("sqlite:///demo.db")

with Session(engine) as session:
    user_name = "dave"
    min_score = 80

    # 正确使用 text() 与绑定字典
    stmt = text("SELECT id, name, score FROM students WHERE name = :name AND score >= :score")
    result = session.execute(stmt, {"name": user_name, "score": min_score})
    for row in result:
        print(row.id, row.name)

    # 严禁写成:session.execute(text(f"SELECT ... WHERE name = '{user_name}'")) —— 同样是高危注入!
四、常见特殊与复杂场景的安全应对策略
在日常实际开发中,有两种高频业务场景经常让开发者陷入误区甚至退回字符串拼接:动态表名/字段名,以及 IN (...) 列表查询。
1. 场景一:动态表名、列名与排序字段(ORDER BY)
数据库的 SQL 语法解析规则规定:参数化占位符只能代表数据值(Value / Literal),不能作为标识符(Identifier,如表名、字段名)或 SQL 关键字(如 ASC/DESC)。如果写出 SELECT * FROM %s 并传入 ('users',),数据库在编译时会直接报语法错误。
当业务确实需要支持用户选择按哪个字段排序或查询分表时,绝不能直接将前端传参拼入 SQL。必须采用严格的白名单校验机制(Whitelist Validation):
# 允许用户排序的字段严格白名单字典
ALLOWED_SORT_FIELDS = {
    "create_time": "created_at",
    "price": "unit_price",
    "sales": "sales_count"
}
ALLOWED_DIRECTIONS = {"asc": "ASC", "desc": "DESC"}

def get_sorted_products(cursor, user_field: str, user_direction: str, min_price: float):
    # 1. 严格白名单判定,非白名单内容直接抛出异常或取默认值
    sort_column = ALLOWED_SORT_FIELDS.get(user_field)
    sort_dir = ALLOWED_DIRECTIONS.get(user_direction.lower(), "DESC")
    if not sort_column:
        raise ValueError("非法的排序字段请求")

    # 2. 字段名经白名单严格清洗后,方可放入 SQL 结构;数值部分依然采用参数化
    sql = f"SELECT id, title, unit_price FROM products WHERE unit_price >= %s ORDER BY {sort_column} {sort_dir}"
    cursor.execute(sql, (min_price,))
    return cursor.fetchall()
2. 场景二:动态变长 IN (...) 列表查询
若需要查询一批 ID 的商品信息,许多人会误写成 WHERE id IN (%s) 并传入 ([1, 2, 3],),这在大多数驱动中会导致格式化错误。正确的做法是:根据待查询集合的长度,动态生成相应数量的占位符字符串,并将参数作为扁平元组传入。
def get_users_by_ids(cursor, target_ids: list[int]):
    if not target_ids:
        return []

    # 1. 根据列表元素个数生成等量的占位符:如 "?,?,?" 或 "%s,%s,%s"
    placeholders = ",".join(["%s"] * len(target_ids))
    sql = f"SELECT id, username, email FROM users WHERE id IN ({placeholders})"

    # 2. 将列表解包/转换为元组作为实参传入
    cursor.execute(sql, tuple(target_ids))
    return cursor.fetchall()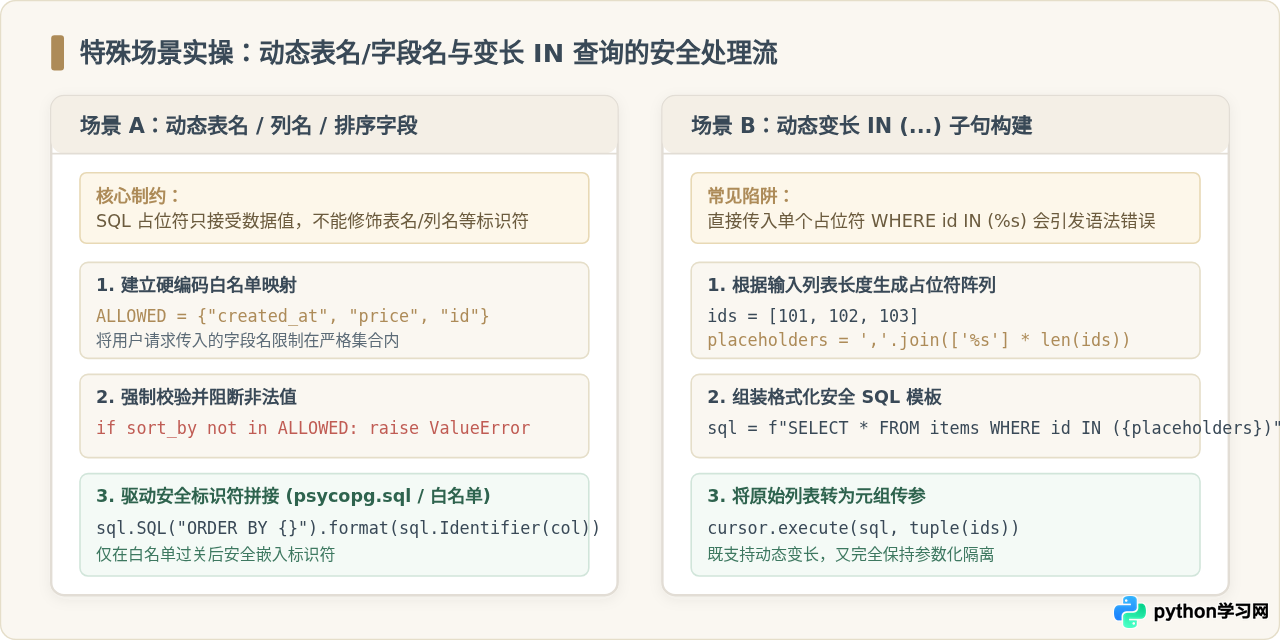
五、存量代码排查与安全重构四步操作指南
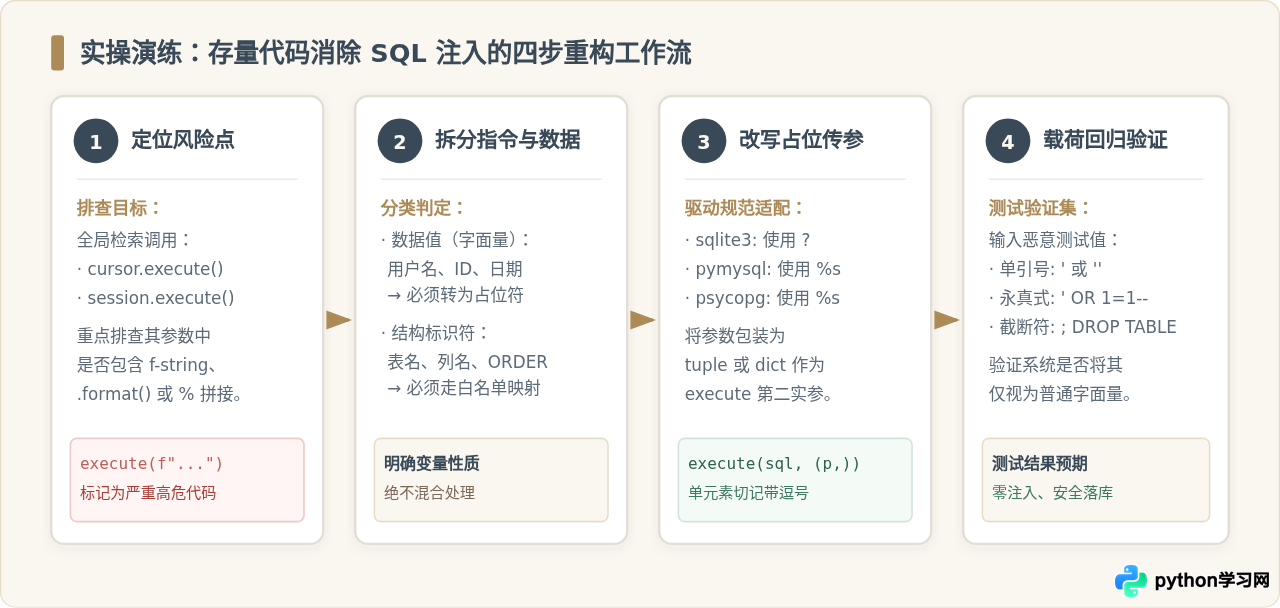
如果现有项目中存在历史遗留代码,如何系统化地排查并改造消除 SQL 注入隐患?可以遵循以下经过生产验证的标准四步重构工作流:
- 特征检索定位风险点:使用代码搜索工具(如 ripgrep 或 IDE 全局正则),搜索所有对
cursor.execute、session.execute的调用,重点排查实参中包含f"、.format(、%的行。 - 拆分指令结构与数据值:对检出的每一个调用进行审视,标出哪些部分属于业务数据(如用户名、手机号、日期),哪些部分属于结构标识符(如分表后缀、排序字段)。
- 改写为驱动适配的占位传参:将数据值替换为驱动专用的占位符(如 SQLite 用
?,MySQL 用%s),将变量整理为独立的元组或字典,作为第二个参数传入。对于单元素元组,切记书写尾随逗号(val,)。 - 输入边界载荷回归验证:使用包含单引号(
')、双破折号(--)、永真表达式(' OR 1=1 --)的载荷进行单元测试,验证系统是否能够安全执行并返回准确结果,确保不会触发数据库异常或逻辑穿越。
六、防御纵深:超越参数化查询的综合安全实践
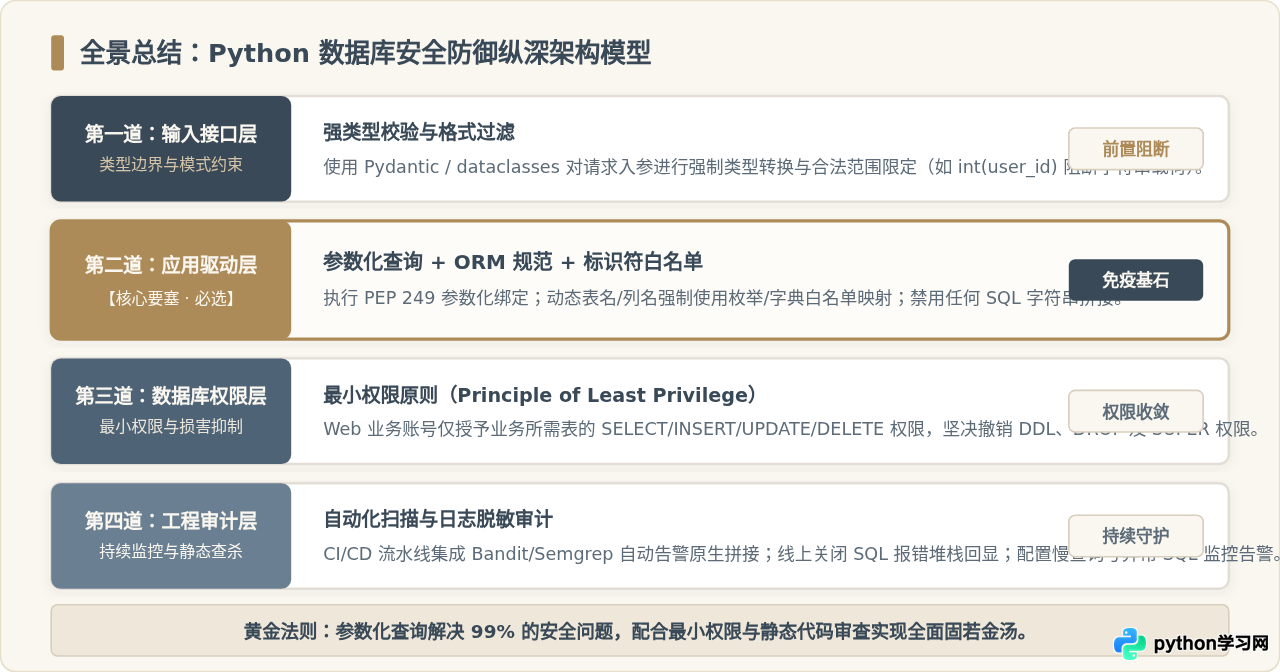
安全工程学的一个基本原理是“没有单一的银弹”。参数化查询虽然可以抵御 99% 以上的数据层注入攻击,但构建真正健壮的企业级数据库安全体系,仍需构建纵深防御(Defense-in-Depth)防线:
1. 数据库账号权限最小化(Principle of Least Privilege)
Web 业务应用在日常运行中只需对数据进行读写,绝不需要执行结构变更权限。因此必须对数据库连接账号进行权限收敛:
- 仅授予业务所需的
SELECT、INSERT、UPDATE、DELETE权限。 - 严禁向 Web 应用账号授予
DROP、ALTER、CREATE、GRANT或SUPER权限。即便应用层偶发注入,攻击者也无法删库或篡改数据库配置。
2. 静态代码安全扫描(CI/CD 流水线集成)
在持续集成(CI)流水线中集成自动化安全静态分析工具,能够在代码合入主干前自动拦截拼接风险。例如 Python 生态中广泛应用的 Bandit 工具:
# 在项目根目录执行 Bandit 扫描,重点检测 B608 (硬编码 SQL 拼接检测)
$ bandit -r ./app -t B608

# 示例输出检测报告:
>> Issue: [B608:hardcoded_sql_expressions] Possible SQL injection vector through string-based query construction.
   Severity: Medium   Confidence: Medium
   Location: ./app/services/user.py:48
   More Info: https://bandit.readthedocs.io/en/latest/plugins/b608_hardcoded_sql_expressions.html
3. 生产环境屏蔽详细 SQL 报错堆栈
严禁将数据库驱动抛出的原始异常信息(如 OperationalError、包含 SQL 语句和表字段信息的报错文本)直接序列化返回给客户端接口。攻击者常利用数据库报错信息探测表结构、字段类型并进行报错盲注。生产环境中应统一捕获数据库异常,记录到服务端加密日志中,对外仅响应通用的“服务请求异常”错误码。
七、常见疑惑与注意事项解答 (FAQ)
cursor.execute(sql, (user_id)) 会报错?必须加逗号吗?(user_id) 仅仅表示算术优先级分组,它的类型仍然是其内部变量本身(如 str 或 int)。如果 user_id = "alice",传入 ("alice") 会被当作长度为 5 的字符串序列,驱动会尝试将其解包为 5 个独立字符作为 5 个参数传入,从而导致占位符数量不匹配报错。只有加上逗号 (user_id,),Python 才会将其识别为包含单个元素的 tuple。
EXECUTE IMMEDIATE 或 sp_executesql 执行,注入风险依然存在。只有在存储过程内部同样采用参数绑定,并在 Python 调用存储过程时使用驱动标准 callproc() 传参时,才能保障安全性。
user_input.replace("'", "''") 过滤单引号,能否防止注入?WHERE id = 1 OR 1=1 完全无需引号);其次,宽字节编码、不同数据库字符集转义特性(如反斜杠 \ 或 Unicode 字符同形异义)均可能轻松绕过基于正则或字符串替换的简陋过滤。永远不要自行手写过滤规则去对抗注入,唯一可靠的防护手段是参数化查询。
八、日常开发自查清单
在提交涉及数据库读写的代码前,请快速对照以下核对表完成自检:
| 检查项 | 标准要求 | 合格状态 |
|---|---|---|
| SQL 文本构造 | 绝不包含 f"..."、%、.format() 或 + 进行变量直接拼接 |
[ ] 严格符合 |
| 占位符规范 | 根据对应驱动使用 ? 或 %s,且 SQL 中的占位符不加引号 |
[ ] 严格符合 |
| 单参数传递 | 单个参数传递时使用元组且保留尾随逗号 (param,) |
[ ] 严格符合 |
| 动态标识符 | 表名、字段名、排序关键字必须通过硬编码白名单字典进行严格合法性校验 | [ ] 严格符合 |
| 动态 IN 查询 | 根据输入数组长度动态生成等量占位符,以元组解包传入 | [ ] 严格符合 |
| CI 静态审计 | 流水线已配置 Bandit / Semgrep 等工具对硬编码 SQL 表达式进行持续扫描 | [ ] 严格符合 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









