

Python列表推导式替代简单for循环的规则与案例
系统讲解在Python中如何使用列表推导式重构简单的for循环。解析核心语法槽位映射规则,提供纯映射、条件过滤、双分支运算与嵌套展平四大典型案例,并总结四步决策法与适用边界。
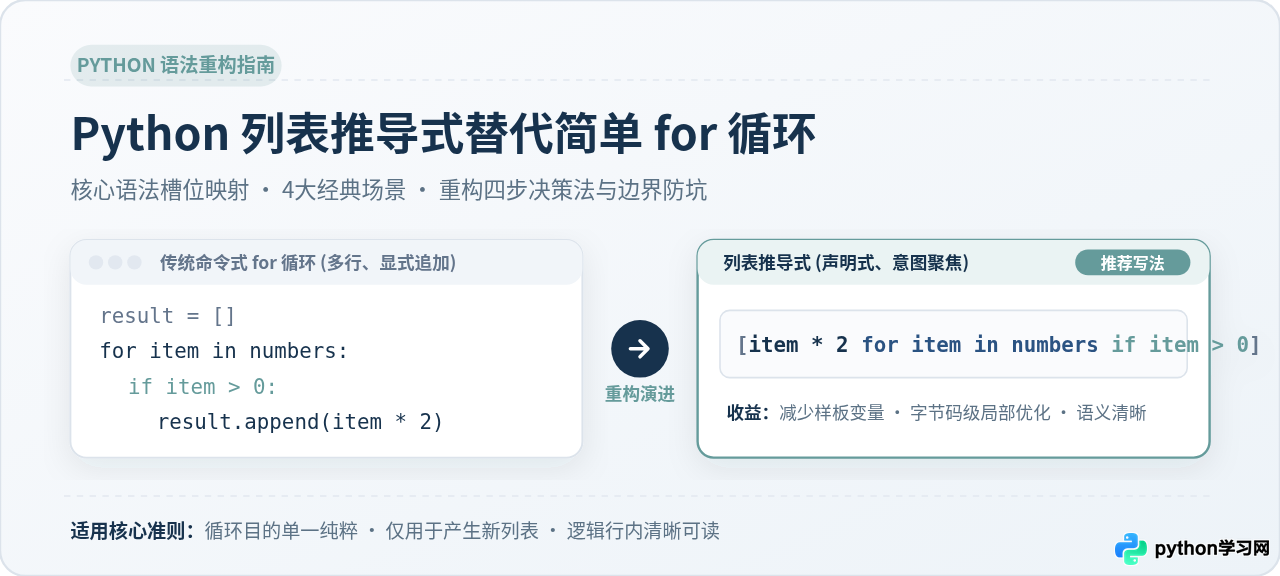
for 循环的核心意图仅仅是遍历已有序列、对每个元素做简单变换或筛选,并将结果通过 .append() 逐一追加到新列表时,将其重构为列表推导式不仅能减少 60% 以上的模板样板代码,还能利用底层 CPython 的 LIST_APPEND 优化提升运行效率。本文将梳理两者之间的语法对应规则,剖析 4 类典型转换场景,并给出清晰的重构决策流程与适用边界。
一、核心语法的对应规则与槽位解析
在传统命令式代码中,利用 for 循环构造列表通常包含三个固定步骤:在循环外部声明空列表、编写 for 遍历与可选的 if 判断、在循环体内部调用 .append() 添加元素。而在列表推导式中,这一流程被浓缩进一对中括号 [...] 内,并通过声明式的槽位排布直接交付结果。
理解两者的对应关系,关键在于认清各语法片段在推导式中的固定槽位及其重组顺序:
- 结果表达式(Expression):对应原循环中
list.append(value)的参数。在推导式中,该表达式直接摆放在中括号内的最前端。 - 遍历主体(For Clause):对应原有的
for item in iterable语句头。在推导式中,它紧跟在结果表达式的后面,保持原有的变量名与迭代对象。 - 筛选条件(If Clause):对应原循环体内的单向过滤条件
if condition。若无需过滤则省略;若存在,则直接置于遍历主体的末尾。
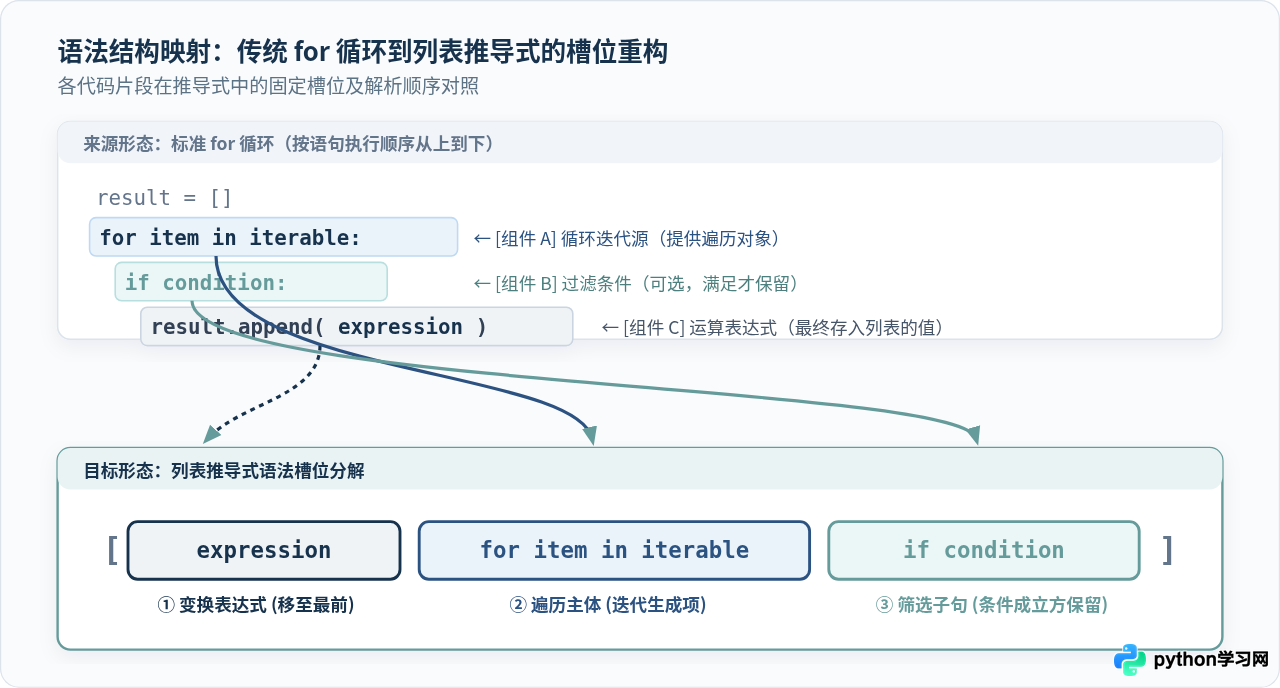
需要明确的是,虽然结果表达式书写在最前端,但 Python 解释器在实际执行列表推导式时,仍然是先评估 for 循环,再评估 if 条件,最后才计算结果表达式并将其压入列表。理解这种书写次序与评估顺序的分离,有助于我们在编写代码时既保持直观,又避免逻辑误判。
二、常见转换场景与案例精析
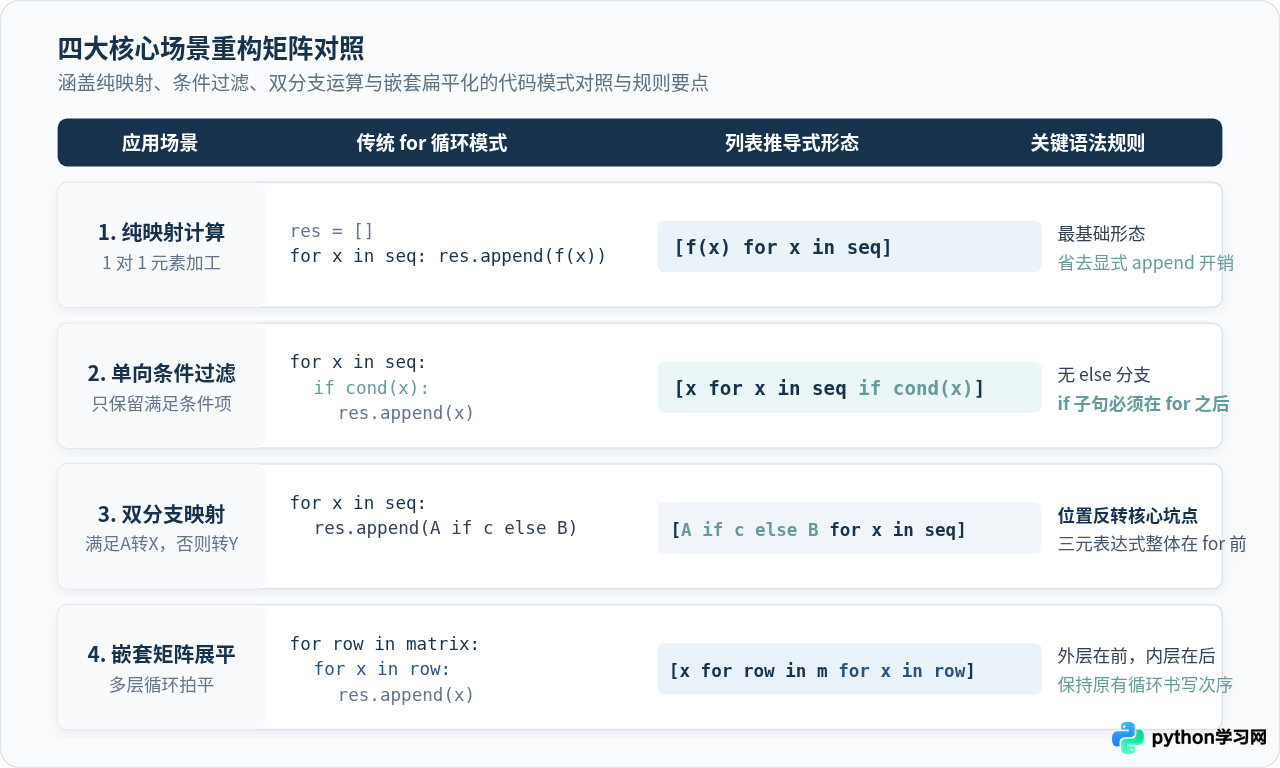
日常开发中绝大多数可被替换的简单 for 循环可以归纳为四种模式。针对每种模式,我们通过代码前后的对比来观察其具体用法。
1. 纯映射转换(Mapping):一对一计算与格式处理
这是最基础也是最常见的场景。源列表中的每一个元素都经历相同的计算、类型转换或方法调用,最终生成一个等长的新列表。
# 需求:将所有价格转换为含两位小数的字符串
prices = [12.5, 9.9, 100.0, 45.2]
formatted_prices = []

for p in prices:
    formatted_prices.append(f"¥{p:.2f}")

# 示例输出:['¥12.50', '¥9.90', '¥100.00', '¥45.20']# 一行完成遍历与格式化映射
prices = [12.5, 9.9, 100.0, 45.2]
formatted_prices = [f"¥{p:.2f}" for p in prices]
# 示例输出:['¥12.50', '¥9.90', '¥100.00', '¥45.20']
在传统写法中,阅读者必须先看到 formatted_prices = [],再看循环头,最后阅读 .append() 内部才能确定列表的最终内容。而改写为推导式后,读者的注意力立刻被吸引到 f"¥{p:.2f}" 这个核心处理逻辑上,意图直截了当。
2. 单向条件过滤(Filtering):保留满足条件的子集
当需要对源数据进行清洗或筛选,仅将满足特定布尔条件的项收录到新列表时,可在推导式末尾追加 if 子句。
# 需求:筛选出有效且长度大于3的用户名
raw_users = ["admin", "", "tom", "alice", None, "bob"]
valid_users = []

for u in raw_users:
    if u and len(u) > 3:
        valid_users.append(u.strip().lower())

# 示例输出:['admin', 'alice']# 在末尾添加 if 过滤条件
raw_users = ["admin", "", "tom", "alice", None, "bob"]
valid_users = [
u.strip().lower()
for u in raw_users
if u and len(u) > 3
]
# 示例输出:['admin', 'alice']
注意,这里的 if 位于 for 之后,只承担“开关门”的过滤职责,不附带 else 分支。不满足条件的元素会被静默跳过,不会向列表添加任何占位符。
3. 双分支值转换:利用三元运算符(If-Else)
如果需求不是“丢弃不符合条件的元素”,而是“根据条件赋予不同的取值”(例如处理默认值或标记状态),就必须结合 Python 的三元条件表达式 A if condition else B。
- 放在
for后面的if是过滤子句,决定该项“进不进列表”,绝对不能带else。 - 放在
for前面的if-else是三元运算表达式,决定该项“转换成什么值”,每个迭代项都一定会产生一个结果。
# 需求:及格显示分数,不及格标记为0
scores = [85, 42, 76, 59, 90]
normalized = []

for s in scores:
    if s >= 60:
        normalized.append(s)
    else:
        normalized.append(0)

# 示例输出:[85, 0, 76, 0, 90]# 三元表达式置于 for 前端作为生成表达式
scores = [85, 42, 76, 59, 90]
normalized = [s if s >= 60 else 0 for s in scores]
# 示例输出:[85, 0, 76, 0, 90]4. 嵌套多重循环与二维结构展平(Flattening)
当处理嵌套列表(例如矩阵、表格行)并希望将其拍平为一维列表时,列表推导式支持书写多个 for 子句。
# 需求:将二维矩阵展平为一维列表
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]
flat = []
for row in matrix:
    for num in row:
        flat.append(num)

# 示例输出:[1, 2, 3, 4, 5, 6, 7, 8, 9]# for 子句的书写次序与原循环从外到内完全一致
matrix = [
[1, 2, 3],
[4, 5, 6],
[7, 8, 9]
]
flat = [num for row in matrix for num in row]
# 示例输出:[1, 2, 3, 4, 5, 6, 7, 8, 9]
在记忆多层 for 的推导式语法时,有一条铁律:推导式中多个 for 的排列顺序,与它们在普通缩进嵌套时的上下排列顺序完全相同。先发生的外层循环写在前面,后发生的内层循环写在后面。
三、重构实施的四步决策流程
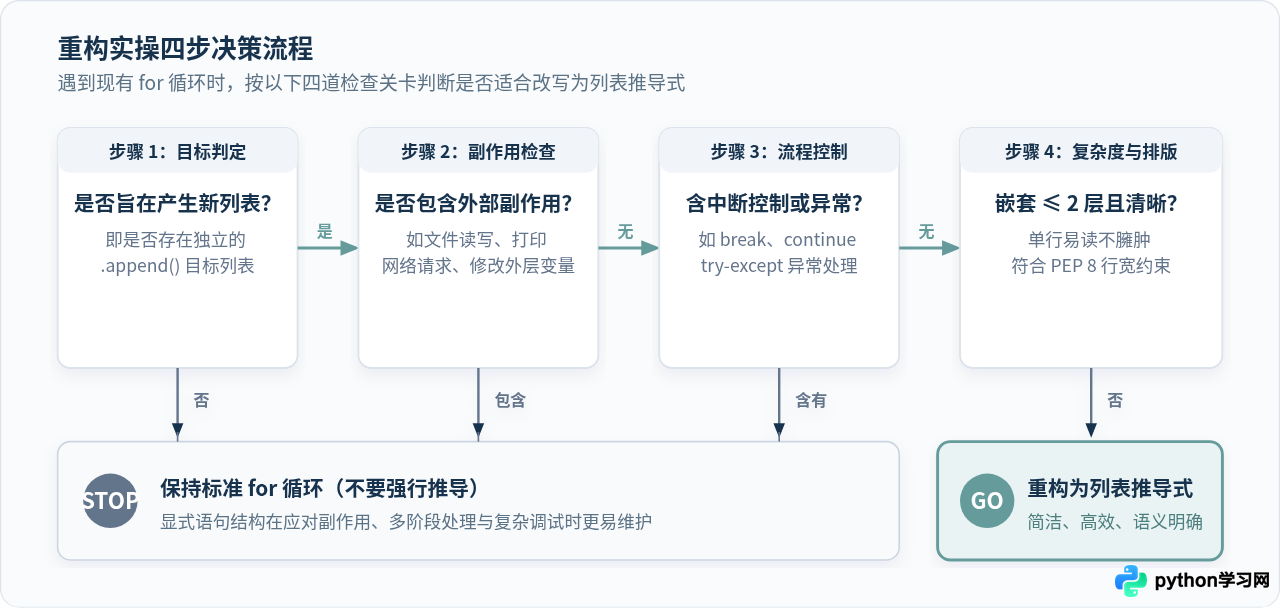
在实际工程代码中,并不是所有 for 循环都应该盲目改为推导式。优秀的代码以“可读性与维护性”为第一考量。我们可以通过以下四个步骤来系统判断是否执行重构:
- 第一步:验证目标是否为构建新列表。检查循环的最终归宿是否是向某个已有的列表中
append元素。如果是为了更新已有字典、向数据库写数据或单纯执行逻辑,则不属于重构对象。 - 第二步:检查循环体内是否包含副作用(Side Effects)。如果循环体内存在文件 I/O、网络请求、
print()打印或修改全局外部变量等行为,强行使用推导式会违背其“纯函数式构建数据”的语义设计。 - 第三步:检查是否存在流程控制中断。查看循环体内是否含有
break、continue、return或复杂的try...except异常捕获块。列表推导式不支持这些控制流语句。 - 第四步:评估嵌套层级与单行可读性。若嵌套深度超过两层,或者单行代码长度超出了 PEP 8 建议的 79~100 字符范围,即使语法上能够实现,也应拆分或保留传统循环。
四、明确的边界与反模式:何时坚决不替代
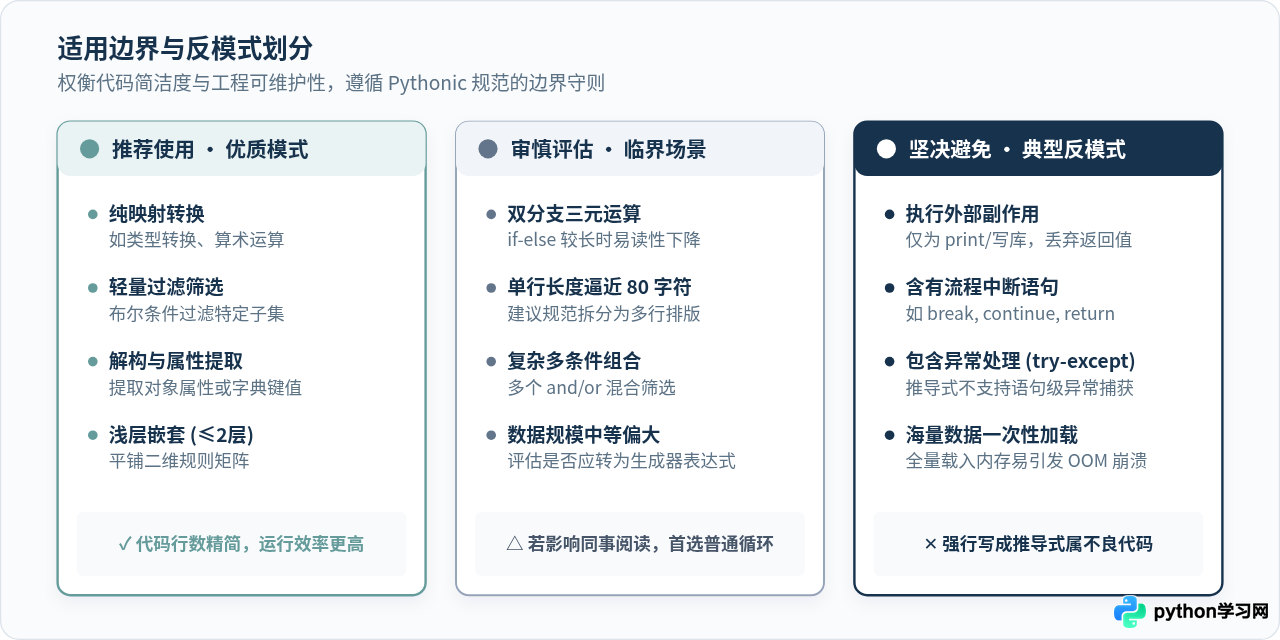
了解什么时候“不该使用”列表推导式,比掌握它的语法更为重要。以下是工程实践中必须坚决避免的三大反模式:
1. 仅为产生副作用而使用推导式(丢弃返回值)
列表推导式执行后必定会在内存中开辟一段连续空间来构建并返回一个新列表。如果不关心返回值,仅仅是为了执行某项操作,使用推导式不仅会导致不必要的内存开销,还会造成严重的语义误导。
# 错误示例:仅为了执行 print,构造了一个充满 [None, None, ...] 的临时无用列表
[print(user.name) for user in users]

# 正确做法:执行操作请使用最纯粹的普通 for 循环
for user in users:
    print(user.name)
2. 超过两层的多重循环与过于复杂的条件链
推导式虽然支持书写多个 for 和 if,但过多的嵌套会摧毁代码的自解释性。例如以下代码:
# 糟糕的可读性:三层嵌套加复杂过滤
result = [x for a in data if a.is_valid for b in a.children if b.active for x in b.values if x > 0]

# 正确做法:拆分为多步生成器或清晰缩进的常规循环
团队协作中,难以一眼看懂的推导式是隐形的技术债务。如果必须借助两行以上的换行和注释才能解释清楚一个推导式,就应果断退回到普通的结构化循环。
3. 海量数据集下的内存膨胀:优先考虑生成器表达式
列表推导式是“即时求值(Eager Evaluation)”的,它会立刻在内存中生成完整的列表。当处理百万级别的数据或读取大文件时,一次性生成列表极易触发内存溢出(OOM)。
此时应当将中括号 [...] 替换为小括号 (...),从而将其升级为生成器表达式(Generator Expression)。生成器采用“惰性求值(Lazy Evaluation)”,只在按需迭代时才产生下一个元素,内存占用恒定为极低水平。
五、总结与日常编码自查备忘
在 Python 中,列表推导式并不是为了彻底消灭 for 循环而存在的,它的使命是为“从旧序列映射与过滤新序列”这一高频场景提供一种兼具优雅与效率的表达工具。
在日常编码或代码审查(Code Review)中,你可以使用以下三条经验准则进行自查:
- 一目了然原则:如果推导式不能在 3 秒内被其他开发者看懂,就不要使用推导式。
- 纯函数原则:推导式内部只负责计算并返回值,绝不在内部修改外部状态或执行 I/O 操作。
- 行宽合规原则:遵循 PEP 8 规范,当推导式逻辑稍长时,采用垂直排版对齐每个
for与if子句,保障视觉层次清晰。
掌握这一工具的核心在于懂得克制:在适合的场景坚决使用,在复杂的边界果断放手。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









