

Python三引号是多行注释吗?本质与风险解析

''' 或 """)并不是语法层面的“多行注释”,其本质是多行字符串字面量(Multiline String Literal)。虽然未赋值、未使用的独立字符串在运行后表面上“不产生副作用”,但直接将其当作多行注释使用,会引发代码缩进错误(IndentationError)、文档字符串(Docstring)意外覆盖以及不必要的常量池内存开销。本文将通过底层原理解析其本质,阐明潜在风险,并给出符合 PEP 8 规范的高效注释操作方案。
一、核心结论:三引号在 Python 语法体系中的真实地位
很多初学者在编写 Python 代码时,习惯用三引号包裹大段代码以达到快速注释的目的。这种做法之所以看似可行,是因为 Python 允许“表达式语句(Expression Statement)”独立存在。当一个字符串字面量单独占有一行且没有赋值给任何变量、没有作为函数调用参数时,解释器在执行该语句后便会直接跳过,从而表现出类似注释的效果。
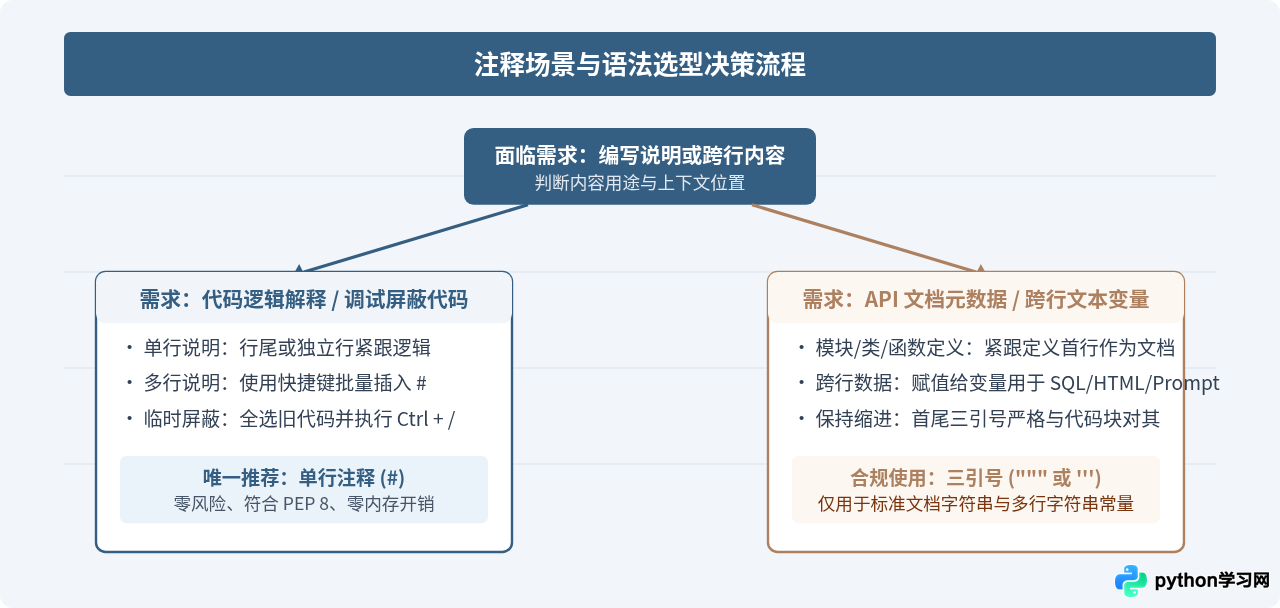
然而从语言规范与底层实现来看,Python 官方文档及 PEP 8 代码规范中明确指明:Python 唯一的官方注释语法是以井号 # 开头的单行注释。语言本身并没有专门设计成对出现的“多行注释”关键字。三引号的真正使命只有两个:
- 构建跨行的字符串字面量:保留文本内部的换行与排版格式,常用于构建长文本、SQL 模板或格式化输出;
- 定义文档字符串(Docstrings):放置在模块、类或函数的首行,供 Python 解释器提取并绑定到
__doc__属性上,为 IDE 悬浮提示与文档生成工具提供元数据。
二、底层原理解析:编译管线与字节码差异
要真正理解三引号与真实注释的本质区别,需要观察 Python 解释器在词法分析(Lexing)、语法解析(Parsing)与字节码编译(Compiling)各阶段的处理逻辑。
当 Python 源码进入词法分析器(Tokenizer)时,以 # 开头的单行注释会被打上 tokenize.COMMENT 标记。在后续生成抽象语法树(AST)时,语法分析器会直接忽略这些注释标记,不为其生成任何 AST 节点。因此,真正的注释在编译后完全消失,不会产生字节码,运行时也不占任何内存。
相反,三引号包裹的文本会被词法分析器识别为 tokenize.STRING。语法分析器会据此在抽象语法树中生成对应的 ast.Expr(表达式语句)与 ast.Constant(常量字面量)节点。即使该字符串未被赋值,它依然是一个合法的语法对象。在编译为代码对象(Code Object)时,解释器通常会将该字符串写入代码对象的常量表 co_consts 中,在特定上下文下还会生成 LOAD_CONST 字节码指令。
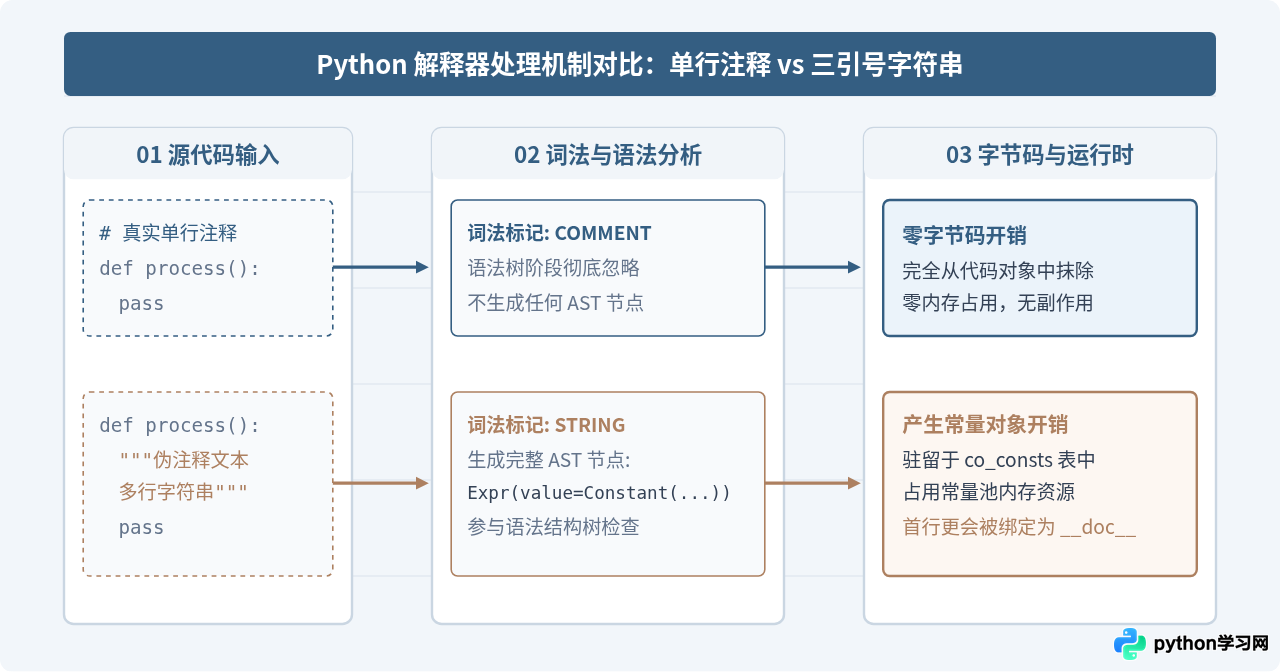
我们可以使用标准库中的 dis 模块进行验证。观察以下示例代码:
import dis

def example_function():
    # 这是单行注释
    """这是三引号字符串"""
    return 42

dis.dis(example_function)
在该函数的字节码输出中,单行注释完全不留痕迹;而三引号字符串由于紧跟函数定义首行,直接被解释器提取并放入了 example_function.__doc__ 中。若该字符串位于函数中间其他代码行,虽然 Python 优化器在多数情况下会略去其执行指令,但该字符串依然会被存入代码对象的常量元组 co_consts,这与真正被丢弃的注释有本质差别。
三、潜在风险:将三引号当作注释的四大陷阱
由于三引号在语法上是正规的语句(Expression Statement),如果盲目将其当作多行注释使用,可能会在生产环境中引发难以排查的隐患。
1. 严格的缩进规则陷阱(IndentationError)
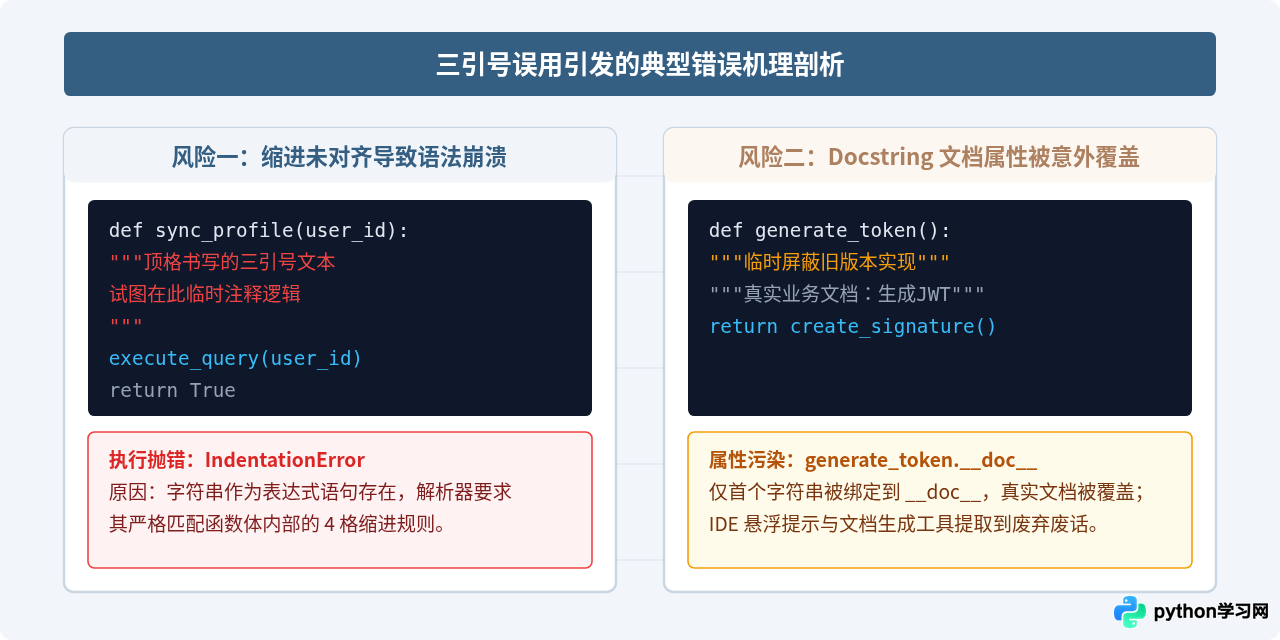
在 Python 中,井号 # 可以出现在一行的任意位置(包括最左侧顶格),完全不受上下文缩进层次的约束。但三引号字符串是代码块内的一个语句节点,必须严格遵循其所在作用域的缩进规则。如果代码块内部的三引号字符串未缩进,或者其闭合引号的缩进与上一行不一致,解释器在语法解析阶段就会直接抛出语法错误。
def calculate_discount(price):
    if price > 100:
# 这里使用真实注释,即使顶格也不会影响语法结构
# 依然保持安全
"""
这里如果直接顶格写三引号注释,
会导致语法解析器认为缩进异常中断
"""
        return price * 0.8
return price上述代码在执行时会直接抛出:IndentationError: unindent does not match any outer indentation level。这表明它并不是被忽略的注释,而是参与语法排版的正式代码构件。
2. 意外污染文档字符串(__doc__ 覆盖)
在模块、类或函数定义的内部第一行,如果使用三引号注释掉一段废弃的测试逻辑,Python 解释器会无条件将其判定为该对象的 Docstring。这不仅会导致原本写好的文档说明被无意抹去,还会引发以下级联问题:
- API 文档工具提取错误:Sphinx、pydoc 等自动化文档构建工具会将临时废弃代码渲染为官方 API 说明;
- IDE 智能提示显示混乱:其他开发者在调用该函数时,代码补全卡片中会直接浮现大段被注释的废旧逻辑;
- 单元测试与反射失效:某些依赖
__doc__属性进行校验或路由注册的框架可能发生行为异常。
3. 转义字符与无效转义警告(SyntaxWarning)
由于三引号内容是字符串字面量,Python 词法分析器会对其中的反斜杠 \ 进行转义语法检查。如果被注释的代码中包含正则表达式、Windows 路径或未经转义的特殊字符序列,解释器在执行时会抛出警告甚至语法错误:
def parse_windows_path():
    """
    C:\test\new_project\scripts
    注意:在 Python 3.8+ 中,无效的转义序列会触发:
    SyntaxWarning: invalid escape sequence '\t'
    """
    pass
而真正的以 # 开头的单行注释绝对不会对反斜杠进行任何转义解析,无论写什么内容都不会触发此类警告。
4. 常量池驻留与内存无谓开销
被三引号包裹的大段代码、废弃数据或测试文本,在编译生成 .pyc 文件时会作为完整的文本对象存放在常量池(co_consts)中。如果在一个包含数万行代码的大型项目中滥用三引号做代码屏蔽,不仅会增加磁盘上的 .pyc 文件体积,还会导致模块在导入时消耗更多内存用于初始化常量表。
四、正确实践:规范的多行注释操作与效率技巧
PEP 8 规范明确给出指引:行注释是解释代码逻辑的最佳方式;当需要连续书写多行解释时,应当使用以 # 开头的连续单行注释,且每行在 # 后保留一个空格。
很多开发者之所以使用三引号,主要是为了省去每行手动输入 # 的麻烦。实际上,现代代码编辑器均已提供极其高效的批量注释快捷操作。
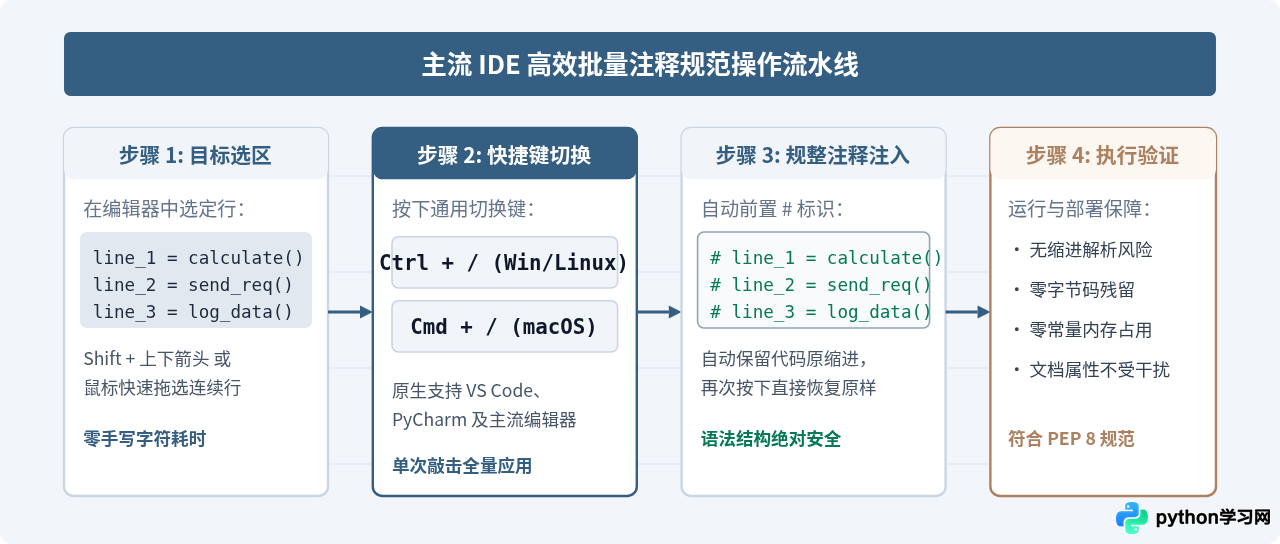
Ctrl + v 进入可视块模式,使用 j 选择多行,按下 Shift + i 进入插入模式,输入 # ,最后连按两次 Esc 即可自动补齐选中各行的注释。
五、特性对比与场景选型矩阵
为了让团队规范更明确,下表整理了单行注释与三引号多行字符串在语法、编译与运行时各维度的详细差异:
| 对比维度 | 单行注释(#) | 三引号字符串(''' 或 """) |
|---|---|---|
| 语言定位 | Python 官方唯一正式注释语法 | 多行字符串字面量(String Literal) |
| 词法分析(Lexer) | 标记为 tokenize.COMMENT |
标记为 tokenize.STRING |
| 抽象语法树(AST) | 彻底忽略,不生成任何 AST 节点 | 生成 ast.Expr 与 ast.Constant 节点 |
| 缩进敏感度 | 极其宽松,顶格书写不影响代码块 | 严格遵守所在代码块的作用域缩进规则 |
| 转义字符检查 | 不解析转义字符,绝不引发转义报错 | 解析转义序列,非法反斜杠会触发 SyntaxWarning |
| 运行时与内存 | 无指令、无运行时常量、零内存占用 | 驻留常量表(co_consts),增加编译文件体积 |
| 官方推荐用途 | 逻辑解释、代码屏蔽、业务标注 | 模块/类/函数 Docstring、多行文本模板 |
六、常见问题解答与总结
Q1:为什么 Python 不像 C 或 Java 那样提供原生类似 /* ... */ 的多行注释语法?
Python 采用“缩进定义代码块”的核心语法体系。如果引入像 C 语言一样的跨行闭合注释语法(例如 /* ... */),会导致语法解析器在判断物理行缩进与逻辑代码块边界时出现语法二义性;同时,Python 创始人 Guido van Rossum 崇尚“显式优于隐式(Explicit is better than implicit)”,连续的 # 可以使每一行都清晰明确地表明其被注释的状态,避免因漏写闭合标签而无意吞噬正常代码。
Q2:在 Jupyter Notebook 或交互式 REPL 中使用三引号有什么额外问题?
在 Jupyter Notebook 中,单元格最后一行如果是独立的表达式,该表达式的求值结果会被直接打印到单元格下方的 Out[...] 结果区中。如果把三引号作为单元格最后几行的“临时注释”,执行后会在下方直接打印出整个未赋值的文本,干扰可视化图表与计算输出结果。
# 书写连续多行注释,将三引号严格限制在标准 Docstring 与长文本常量的定义场景中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









