

Python基于pandas条件判断批量生成Excel备注列
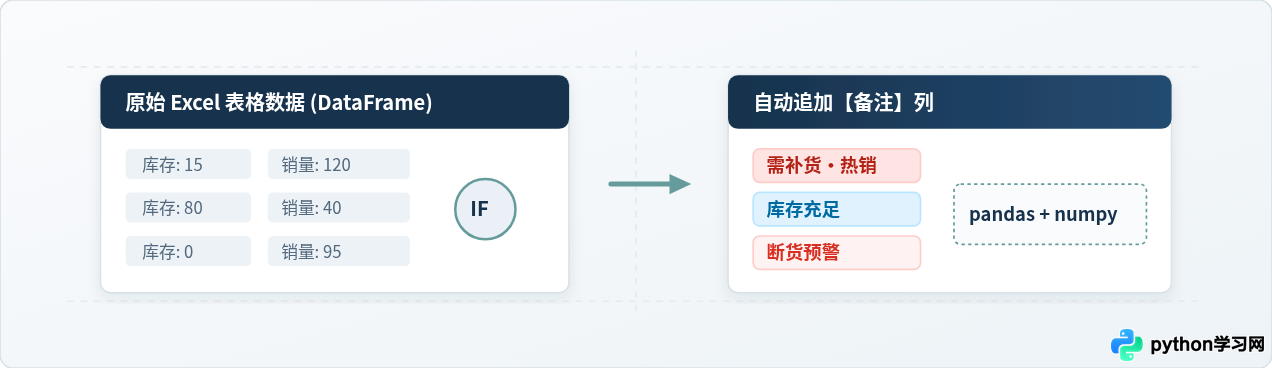
介绍如何使用Python与pandas库根据单条件或多条件逻辑批量生成Excel表格备注列。通过numpy.where、numpy.select及矢量化操作,高效完成大批量Excel数据的分类打标与导出。
一、为什么不建议使用逐行循环
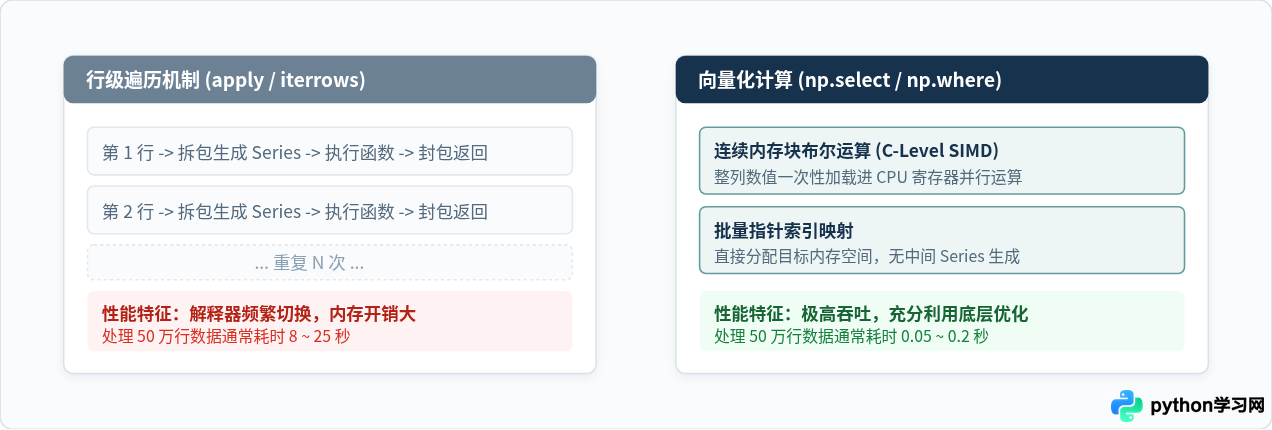
初学者面对这类需求时,直觉通常是使用 for 循环配合 iterrows() 遍历每一行,在 Python 的 if-else 语句中逐条判断并修改单元格。这种方式虽然逻辑直观,但由于打破了底层 C 语言的连续内存块加速,每处理一行都会产生对象打包与解包的额外开销。在处理几千行甚至数万行数据时,运行耗时会从几毫秒飙升至数秒甚至数分钟。
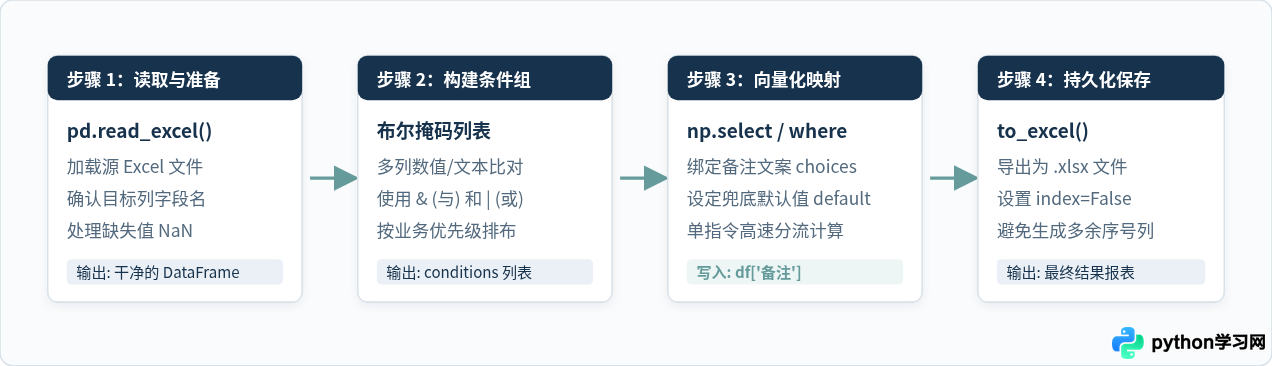
pandas 推荐的解法是向量化(Vectorization)计算:把整个列视作一个数组,直接在内存层对整列执行逻辑判断,生成布尔掩码(Boolean Mask),再通过底层优化的路由机制批量赋给新列。无论从运行效率还是代码整洁度来看,向量化都是批量生成备注列的标准解法。
二、运行环境准备
完成本文任务需要 Python 3.8+ 环境,以及两个核心数据处理库 pandas 和 openpyxl(用于读写 Excel 的 .xlsx 格式)。在终端中执行以下命令安装:
pip install pandas numpy openpyxl假设我们有一份原始业务表格 sales_data.xlsx,其包含以下字段和数据:
| 商品ID | 品名 | 当前库存 | 安全库存 | 近30天销量 |
|---|---|---|---|---|
| A101 | 无线办公鼠标 | 12 | 20 | 130 |
| A102 | 机械键盘红轴 | 45 | 30 | 85 |
| A103 | Type-C扩展坞 | 0 | 15 | 210 |
| A104 | 降噪头戴耳机 | 60 | 25 | 18 |
三、场景一:单条件二元分支(numpy.where)
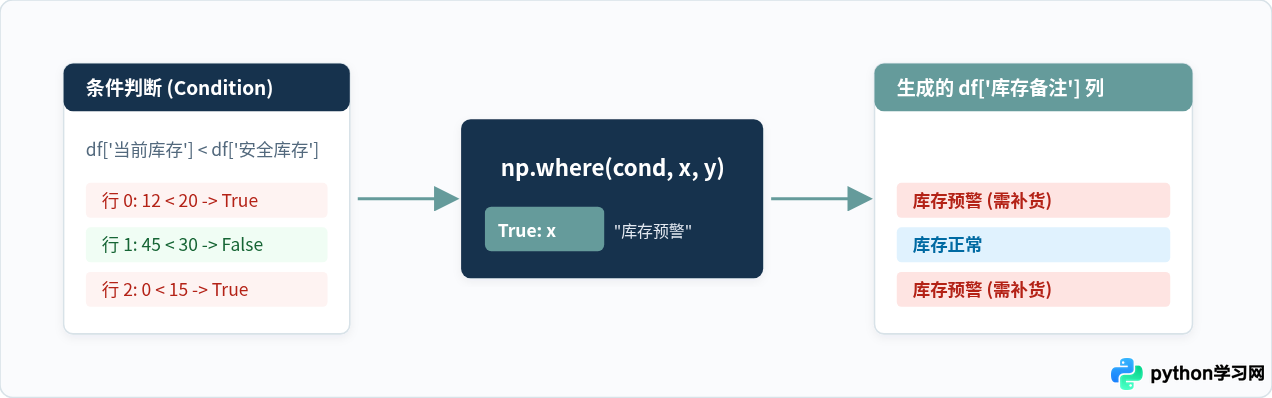
当业务规则比较单一,属于典型的“满足条件赋 A,否则赋 B”时,最轻量的做法是使用 numpy.where(condition, x, y)。它的行为类似于 Excel 中的 =IF(条件, 真值, 假值),但在内存中直接按矢量执行。
代码实现
import pandas as pd
import numpy as np

# 1. 读取 Excel 文件
df = pd.read_excel('sales_data.xlsx')

# 2. 单条件判断:当前库存是否低于安全库存
condition = df['当前库存'] < df['安全库存']

# 3. 向量化匹配生成备注列
df['库存备注'] = np.where(condition, '库存预警(需补货)', '库存正常')

# 4. 保存为新 Excel 文件
df.to_excel('sales_data_processed.xlsx', index=False)
print("单条件备注列已成功批量生成并保存!")condition = df['当前库存'] < df['安全库存'] 时,返回的是一个元素为布尔值(True/False)的 Series。np.where 会在底层根据索引位置瞬间提取对应文字,不会修改原数据。
四、场景二:多重复杂条件的层级匹配(numpy.select)
真实业务中往往存在多阶梯判定。例如:
- 紧急断货:当前库存为 0;
- 缺货预警:当前库存小于安全库存,且近30天销量大于 100;
- 滞销关注:当前库存大于等于安全库存的 2 倍,且近30天销量小于 20;
- 正常运转:其余所有情况。
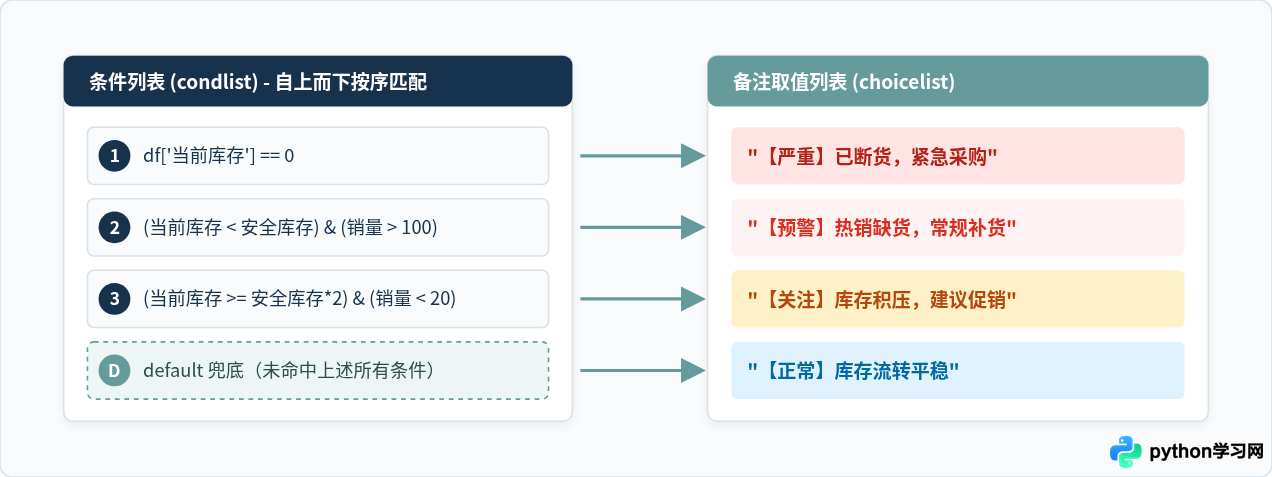
处理这种多条件匹配时,嵌套 np.where 会导致代码极其臃肿难读。最佳实践是使用 numpy.select(condlist, choicelist, default)。
代码实现
import pandas as pd
import numpy as np

df = pd.read_excel('sales_data.xlsx')

# 1. 定义多条件列表(注意每个子条件必须用小括号括起来)
conditions = [
    (df['当前库存'] == 0),
    (df['当前库存'] < df['安全库存']) & (df['近30天销量'] > 100),
    (df['当前库存'] >= df['安全库存'] * 2) & (df['近30天销量'] < 20)
]

# 2. 定义对应的备注文本列表(长度必须与 conditions 一致)
choices = [
    '【严重】已断货,紧急采购',
    '【预警】热销缺货,常规补货',
    '【关注】库存积压,建议促销'
]

# 3. 批量生成复合备注列,并指定兜底默认值
df['综合运营备注'] = np.select(conditions, choices, default='【正常】库存流转平稳')

# 4. 导出为新 Excel 文件
df.to_excel('sales_data_processed.xlsx', index=False)
print("多条件复合备注列生成完成!")np.select 会从前到后依次检测。如果某一行同时满足第 1 个和第 2 个条件,它会被优先赋值为第 1 个条件对应的文案,后续条件将被跳过。这种“先命中先结算”的机制天然支持设置优先级规则。
五、底层机制对比:向量化 vs 循环与 apply
很多开发者在面对多列运算时会考虑 df.apply(lambda row: ..., axis=1)。虽然 apply 语法上比 for 循环简短,但本质上它仍然是在 Python 解释器内部执行行级循环,并反复创建 Series 对象。
六、高频踩坑点与避坑准则
在实际编码中,虽然思路简单,但有几个细节极易导致报错或产生意料之外的空值:
1. 逻辑运算符优先级与括号问题
在 Python 中,按位运算符 &(与)和 |(或)的优先级高于比较运算符(如 >、<=、==)。如果不加小括号:
# 错误写法:会优先计算 df['安全库存'] & df['近30天销量'],引发 TypeError
df['当前库存'] < df['安全库存'] & df['近30天销量'] > 100

# 正确写法:每个判断单元必须用独立的括号包住
(df['当前库存'] < df['安全库存']) & (df['近30天销量'] > 100)
2. 空值(NaN)穿透导致所有条件失真
如果 Excel 某单元格存在空值,在进行比较(如 df['销量'] > 50)时,结果会直接返回 False。若未对缺失值做预处理,这部分数据会自动落入 default 兜底备注中,造成业务误判。
防范方法:在执行判断前,明确处理缺失值,或显式将 .isna() 作为前置条件纳入 conditions 列表:
# 方式 A:预填充安全默认值
df['近30天销量'] = df['近30天销量'].fillna(0)

# 方式 B:将空值作为独立条件置于首位
conditions = [
    df['当前库存'].isna(),
    df['当前库存'] == 0,
    ...
]
choices = [
    '【异常】数据缺失待核实',
    '【严重】已断货',
    ...
]
3. 条件列表与取值列表长度不匹配
np.select 要求 len(conditions) == len(choices)。若两者长度不等,会抛出 ValueError: list of cases, can't solve without default case 异常。务必在编码后核对列表对应关系。
七、方案选型决策与总结
针对不同的数据格式与规则复杂度,pandas 提供了多种生成新列的方法。我们可以根据以下规则进行选择:
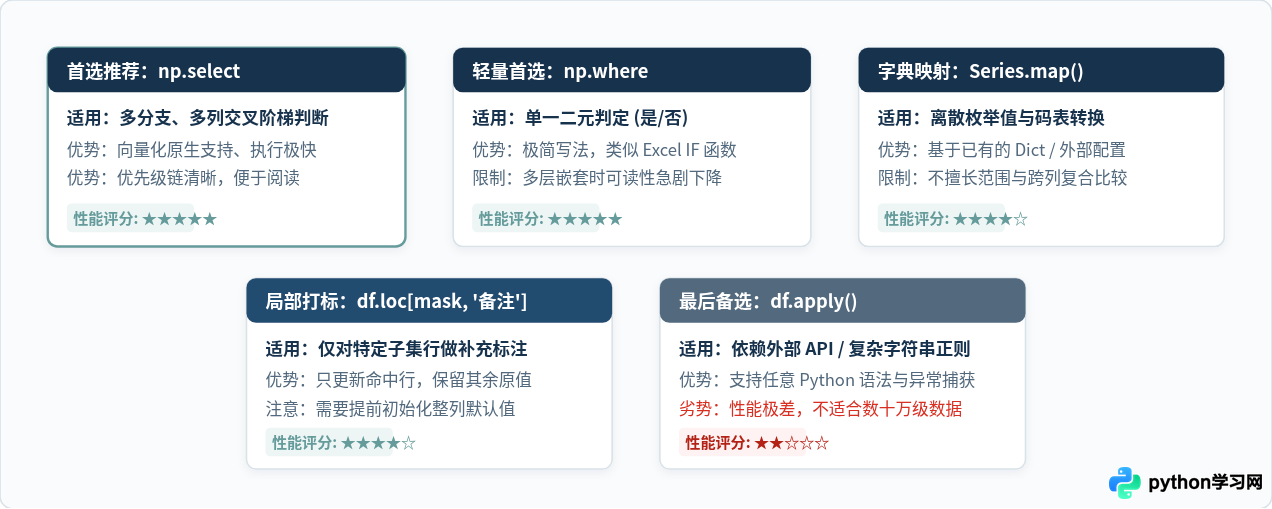
通过本文介绍的方法,在处理 Excel 批量备注生成时,可以优先评估业务规则是单条件还是多条件:简单的二元逻辑直接选用 np.where;面对复杂的阶梯规则与多指标联动时,使用 np.select 分离条件与取值,即可在保持代码清晰、易维护的同时,获得向量化运算带来的极速处理体验。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









