

Python list.append在多线程下是线程安全的吗
深入剖析在CPython解释器中list.append的线程安全性、底层字节码与GIL机制,对比单操作原子性与复合业务逻辑的竞态条件风险,并给出规范的多线程并发解决方案。
list.append() 调用具有单操作原子性,多线程并发追加不会导致列表底层内存破坏或元素丢失;但在实际业务开发中,由其组成的复合操作(如先检查长度再追加、判断去重再追加)并不是线程安全的。理解这一差异,是避免多线程程序出现诡异偶发 Bug 的关键。
一、核心结论:区分“单操作原子性”与“业务逻辑安全”
当我们在讨论“某个操作是否线程安全”时,通常存在两个完全不同维度的含义:底层数据结构完整性,以及上层业务逻辑一致性。回答 list.append 的线程安全性,必须严格区分这两个场景:
- 底层数据结构维度(线程安全):在官方 CPython 解释器中,多个线程同时对同一个列表执行
my_list.append(x),底层的指针数组分配与长度计数由单个解释器字节码完成,不会破坏底层PyListObject内存,也不会发生指针错乱或进程崩溃。 - 业务逻辑执行维度(不保证安全):多线程追加的相对顺序由操作系统的线程调度决定,顺序是不可控的;更重要的是,如果追加前伴随状态检查(例如“当长度未达上限时追加”),条件检查与追加之间并非不可分割,极易发生并发竞态导致逻辑被击穿。
二、CPython 下 append 原理剖析:字节码与 GIL
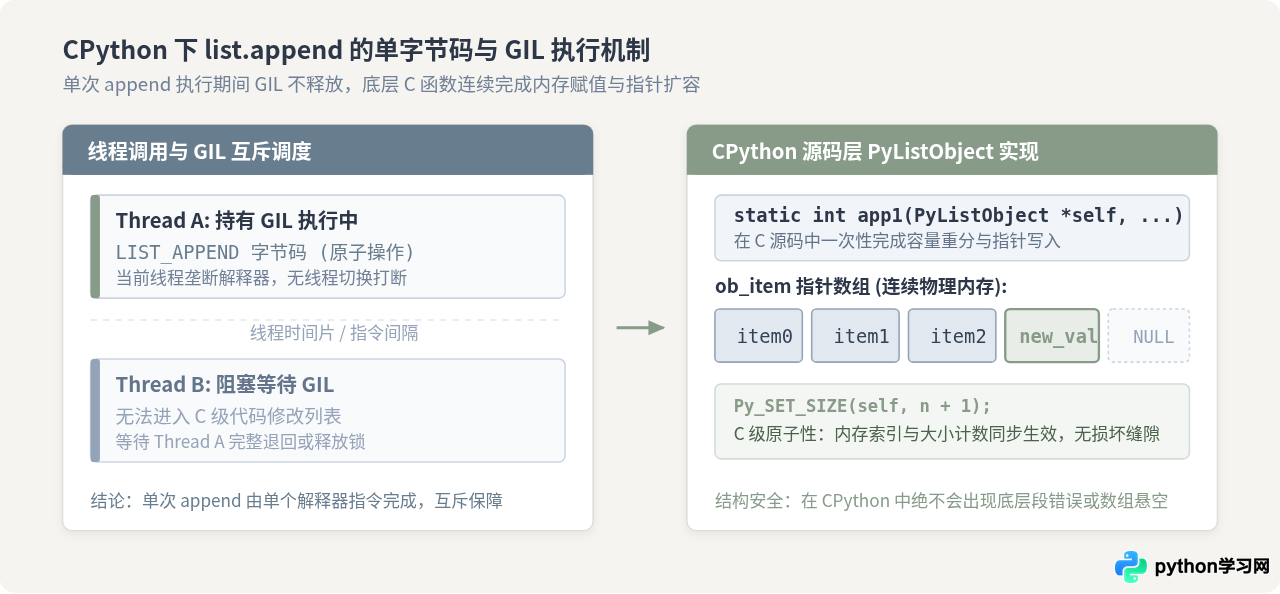
为什么在 CPython 中单次 append 不会损坏数据结构?这由全局解释器锁(GIL)和 Python 底层 C 源码的实现方式共同决定。
在 CPython 中,GIL 保证了在任何给定时刻,只有一个系统原生线程在执行 Python 字节码。当解释器执行到字节码 LIST_APPEND 时,它直接调用 C 语言函数 app1():
# 查看 append 操作对应的底层字节码
import dis

def add_element(target_list, val):
    target_list.append(val)

dis.dis(add_element)
在底层的 Objects/listobject.c 源码中,app1() 的核心逻辑是先检查连续内存容量,若容量足够则直接将对象指针写入 ob_item[n],紧接着更新列表长度 Py_SET_SIZE(self, n + 1)。在这段极短的 C 代码执行期间,线程不会主动释放 GIL,操作系统也不会在 C 函数执行到一半时切换到另一个 Python 线程执行同一列表的 app1()。因此,列表的物理连续内存永远处于合法状态。
三、关键差异:原子操作 vs 复合操作(Check-then-Act)
初学者最容易踩中的误区,是将“底层操作不会崩溃”等同于“代码在多线程下不需要加锁”。我们通过两种典型场景对比关键差异:
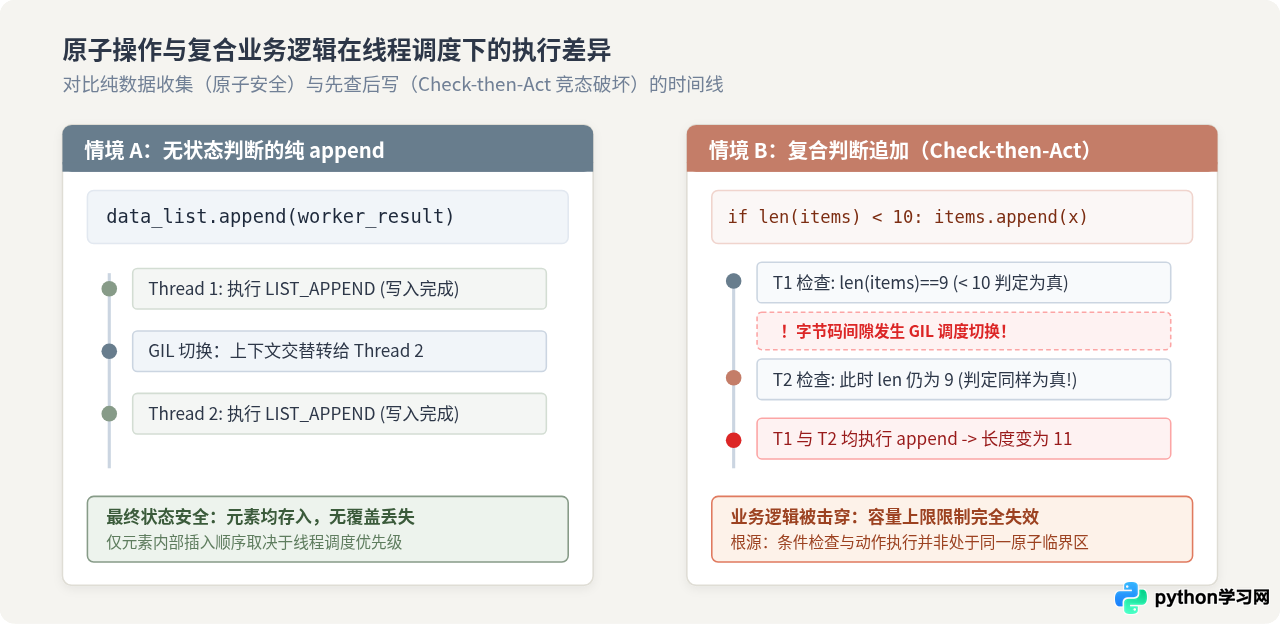
1. 场景 A:纯数据收集(安全的原子操作)
每个工作线程独立计算结果,算完后直接 append 到一个共享列表中。由于每次追加都是独立的单指令,不需要依赖列表的其他状态,在 CPython 下即便启动几十个线程,最终收集到的元素总数也完全准确:
import threading

shared_list = []
NUM_THREADS = 10
ITEMS_PER_THREAD = 10000

def worker():
    for i in range(ITEMS_PER_THREAD):
        shared_list.append(i)

threads = [threading.Thread(target=worker) for _ in range(NUM_THREADS)]
for t in threads:
    t.start()
for t in threads:
    t.join()

print(f"预期长度: {NUM_THREADS * ITEMS_PER_THREAD}, 实际长度: {len(shared_list)}")可以看到,在 CPython 环境下,10 万次并发追加没有丢失任何一个元素,列表结构保持完好。
2. 场景 B:带限制的复合追加(引发竞态条件的危险操作)
如果业务要求“当列表长度小于 1000 时才允许继续添加”,看似简单的两行代码,在多线程下就会立即失效:
import threading

shared_list = []
MAX_CAPACITY = 1000

def bounded_worker():
    for i in range(500):
        # 危险的复合操作:Check-then-Act
        if len(shared_list) < MAX_CAPACITY:
            shared_list.append(i)

threads = [threading.Thread(target=bounded_worker) for _ in range(10)]
for t in threads:
    t.start()
for t in threads:
    t.join()

print(f"限制容量: {MAX_CAPACITY}, 实际长度: {len(shared_list)}")
原因解释:len(shared_list) < MAX_CAPACITY 和 shared_list.append(i) 是两条独立的 Python 语句,包含多个字节码。当线程 A 刚判断完长度为 999 准备追加时,操作系统发生线程上下文切换,线程 B 同样读取到长度为 999 并通过判断。随后两个线程各自执行 append,最终容器突破了预设的容量上限。
append 甚至会引发物理内存破坏。此外,随着 Python 3.13 引入自由线程(Free-Threaded 构建 / PEP 703 逐步移除 GIL),依赖隐式 GIL 保障并发安全的做法正在被现代工程实践淘汰。
四、多线程列表操作的选型决策与最佳实践
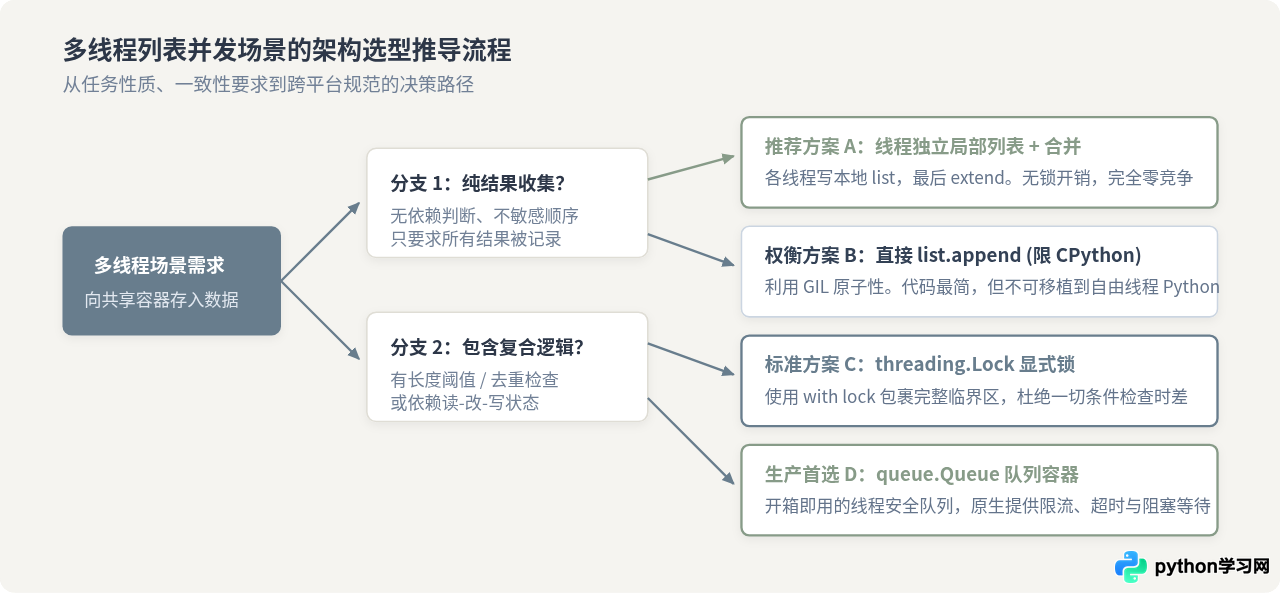
在实际编写多线程程序时,应当根据业务要求选择恰当的同步策略与容器架构:
实践一:使用 threading.Lock 保护复合操作
如果必须共享同一个列表并进行条件读写,使用互斥锁将“检查”与“追加”包裹在同一个临界区内,是最清晰可靠的做法:
import threading

shared_list = []
lock = threading.Lock()
MAX_CAPACITY = 1000

def safe_bounded_worker():
    for i in range(500):
        with lock:
            if len(shared_list) < MAX_CAPACITY:
                shared_list.append(i)
实践二:生产环境优先使用 queue.Queue
如果多线程之间涉及生产者-消费者模型,不要直接使用 list 充当共享队列。Python 标准库的 queue.Queue 内部封装了互斥锁与条件变量,天然支持线程安全、超时控制与容量阻塞:
import queue
import threading

# 原生线程安全,设置最大容量为 1000,超出时 put 会自动阻塞等待
task_queue = queue.Queue(maxsize=1000)

def producer(q, val):
    q.put(val)  # 线程安全且自带流量控制
实践三:Map-Reduce 思路(局部列表,零锁争用)
在数据批处理、网络爬虫或高并发计算场景中,最高性能的方式是避免共享可变状态。每个工作线程仅向自己私有的局部列表中追加数据,计算全部完成后由主线程通过 extend 统一合并:
from concurrent.futures import ThreadPoolExecutor

def compute_chunk(start_idx, count):
    local_results = []
    for i in range(count):
        local_results.append(start_idx + i)
    return local_results

with ThreadPoolExecutor(max_workers=4) as executor:
    futures = [executor.submit(compute_chunk, i * 1000, 1000) for i in range(4)]
    final_list = []
    for f in futures:
        final_list.extend(f.result())  # 主线程单线程合并,完全无锁争用
五、知识梳理与全景总结
综上所述,回答“Python list.append在多线程下是线程安全的吗”,应当遵循严谨的边界条件进行判断:
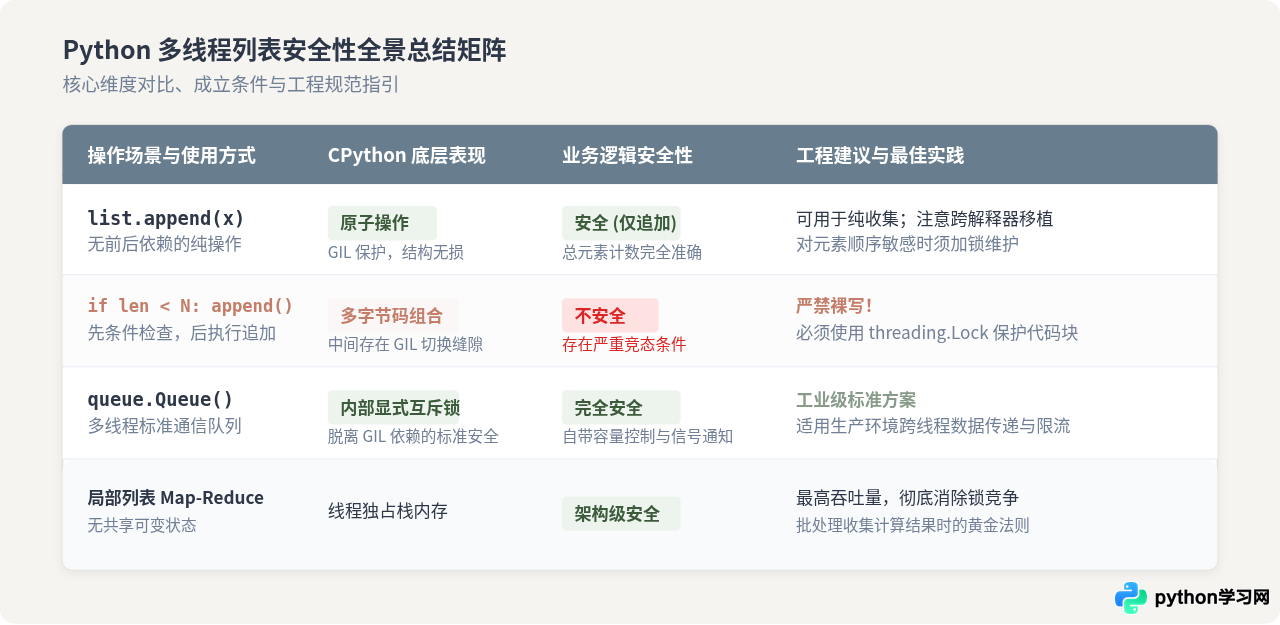
| 操作类型 | CPython 表现 | 业务安全性 | 规范处理方式 |
|---|---|---|---|
单次 list.append(x) |
单个字节码完成,底层内存不损坏 | 仅在纯收集且无序时安全 | 可直接使用,但需注意移植性 |
| 复合操作(判断后再 append) | 多字节码,中间会发生 GIL 切换 | 不安全(存在竞态条件) | 必须用 threading.Lock 保护临界区 |
| 多线程先进先出 / 管道通信 | 用 list 模拟易死锁或数据混乱 | 不推荐手写 | 直接使用标准库 queue.Queue |
| 多工作线程并发计算产出 | 高并发下存在全局解释器锁开销 | 逻辑独立但有共享成本 | 推荐线程局部独立列表,任务结束后统一合并 |
在日常开发中,建议牢记核心原则:永远不要仅凭底层操作的原子性来支撑复杂的并发业务。对状态变化保持敬畏,优先选用标准库提供的并发原语(如 threading.Lock 或 queue.Queue),才能构建出健壮且具有良好跨版本适应性的多线程程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









