

Python大文件上传form-data怎么避免内存溢出
深入讲解在Python中进行multipart/form-data大文件上传时避免内存溢出的核心机制、落地步骤、生产避坑与代码实现,将全量内存加载转换为恒定低占用的流式迭代。
requests.post(..., files=...) 并直接传入包含文件读取内容的参数,Python 经常会在发送前将文件全量载入内存,造成多倍内存暴涨并触发 OOM 崩溃。解决该问题的核心路径是使用流式迭代编码器(Streaming Multipart Encoder):保持文件句柄常驻磁盘,以固定大小(如 64KB 到 1MB)的分块进行滑动读取,并直接泵入底层 Socket,让客户端内存占用恒定在几十兆字节以内。
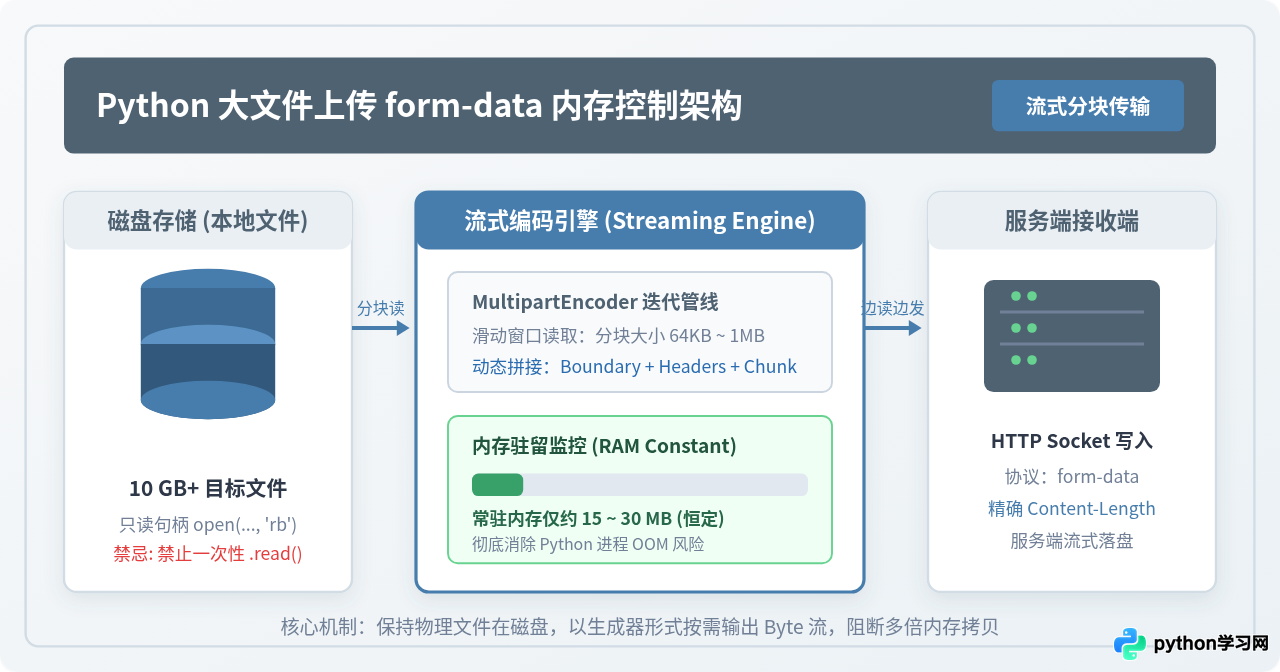
核心机制示意图:通过流式迭代管线直接连接磁盘只读句柄与网络套接字
常规上传为什么会引发内存暴涨
在日常开发中,许多人习惯直接调用 requests.post(url, files={'file': open('huge.zip', 'rb')})。对于几兆的普通图片或文档,这种写法非常方便。然而,当文件尺寸达到数吉字节时,进程内存往往会在请求发起瞬间飙升,甚至直接被操作系统的 OOM Killer(内存不足终止程序)强行杀死。
这种内存暴涨并非 Python 语言本身的问题,而是 HTTP 的 multipart/form-data 协议结构与高阶 HTTP 客户端默认缓冲行为叠加产生的结果。
按照 RFC 7578 规范,multipart/form-data 并非纯粹的二进制流,而是需要用随机边界字符串(Boundary)将各个表单字段、头部信息(如 Content-Disposition 与 Content-Type)以及实际文件内容拼接在一起的复合结构。如果客户端库在准备请求(PreparedRequest)时试图在内存中一次性组装出一个完整的 bytes 对象,整个文件就会被完整读入内存。
更糟糕的是,在这个组装与传输过程中,往往存在多重内存副本:
- 原始数据载入:文件由磁盘被读取为 Python 内存中的
bytes字符串,耗费 1 倍文件大小的物理内存。 - 协议帧拼接:将 Boundary、头部分隔符与二进制数据合并为一个新的请求体,在拼接瞬间可能开辟新的内存连续块,使得内存占用倍增。
- 底层连接缓冲与重试机制:标准库及第三方库若启用了重试或未声明只读流传输,底层传输层为了能在失败时重新发送,往往会保留一份请求体缓冲区。
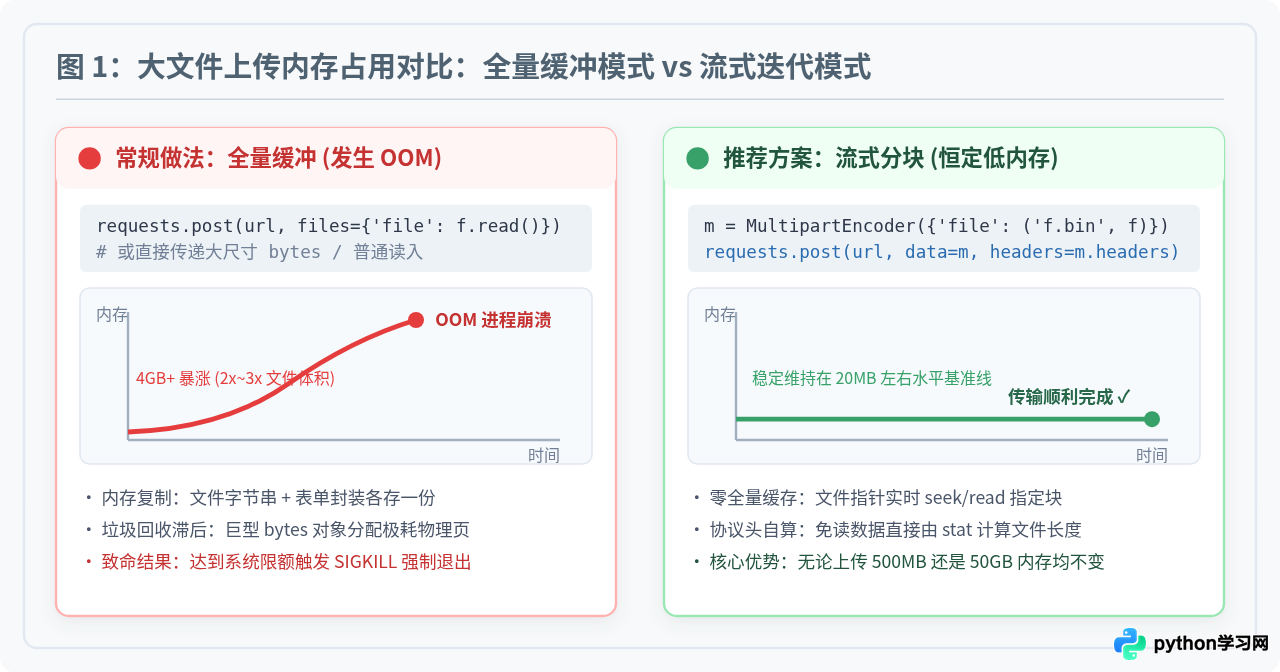
图 1:大文件上传内存占用对比:全量缓冲模式 vs 流式迭代模式
从图 1 可以清楚看到,全量缓冲模式的内存开销与文件大小呈严格的线性正比关系,任何机器的物理内存在面对超大文件时都会被迅速击穿;而流式迭代模式则将内存占用与文件体积完全解耦,使内存消耗曲线维持在平直的基准线上。
multipart/form-data 流式装配的核心原理
要做到真正的零全量内存装载,必须在协议组装与网络发送两个层面同时实现“流式化”。
HTTP 传输本质上是通过 TCP Socket 顺序推送字节流。既然服务端只需要按照协议规范依次解析出 Boundary、字段名、文件头、文件数据分片和结尾 Boundary,那么客户端就完全不需要在内存中维持一个完整的大型载荷。
流式编码器的工作机制是将整个 multipart/form-data 请求体看作一个可迭代的字节生成器(Stream Generator):
- 预生成头部:先产出包含了首个 Boundary 和表单字段名的几十字节字符。
- 按块产出载荷:当底层网络发送缓冲区空闲时,生成器向操作系统的文件句柄申请读取指定大小的块(例如 64KB),读出后立即推送给 Socket 发送。发送完成后,该块立即被回收或复用,绝不堆积。
- 收尾标记:直到文件全部读取完毕,生成器再输出最后一段带有结尾双横线的终止 Boundary(如
--boundary--)。
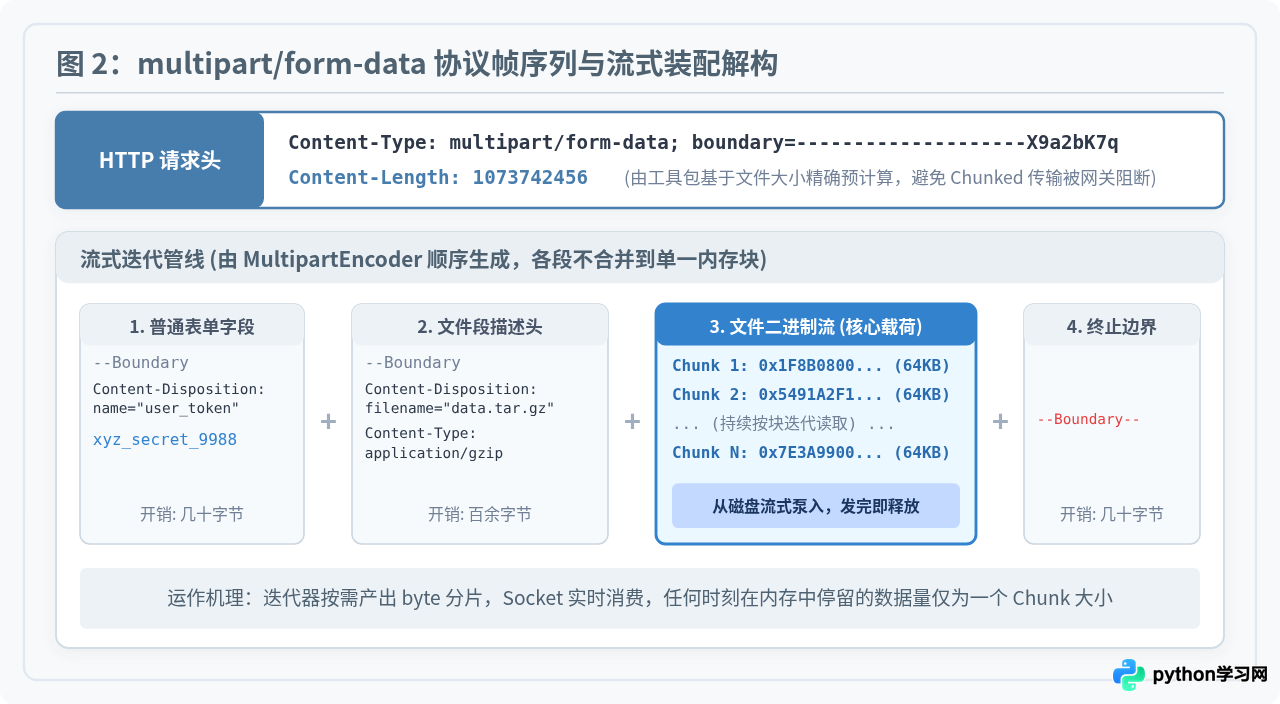
图 2:multipart/form-data 协议帧序列与流式装配解构
在 HTTP 1.1 中,向服务端流式传输通常有两种方式:一是使用分块传输编码(
Transfer-Encoding: chunked),二是在请求头中明确告知 Content-Length。然而许多生产环境中的 API 网关、对象存储或反向代理(如某些默认配置的 Nginx 与云存储签名接口)会明确拒绝没有 Content-Length 的 POST 请求。优秀的流式工具(如 requests-toolbelt)并不需要真正读取文件内容,而是通过 os.path.getsize(file_path) 获取文件物理大小,结合固定协议头字符的字节长度,在上传前毫秒级精确计算出总长度并填入请求头,彻底解决了网关兼容性问题。
标准方案落地:使用 requests-toolbelt 实现流式上传
在同步代码体系中,官方推荐的标准工具是 requests-toolbelt。它为 requests 库提供了专门的 MultipartEncoder 和带进度监听的 MultipartEncoderMonitor。
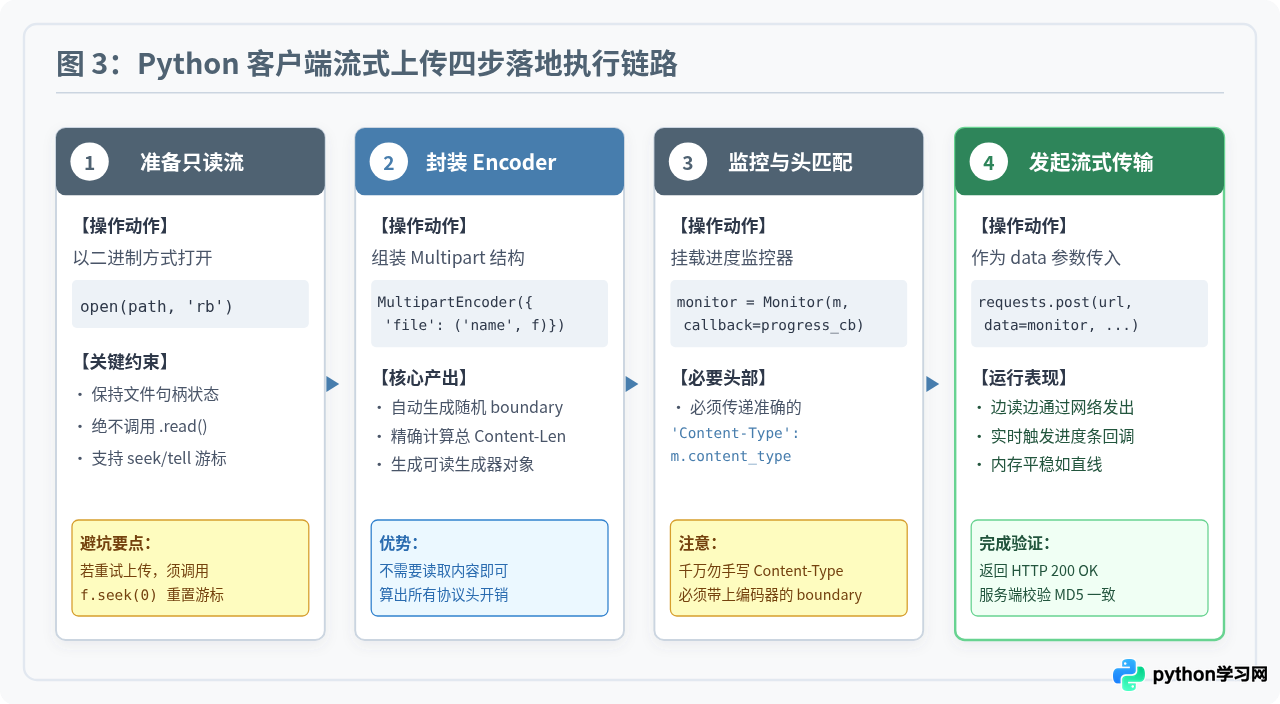
图 3:Python 客户端流式上传四步落地执行链路
环境准备与安装
执行以下命令安装依赖:
pip install requests requests-toolbelt核心代码示例与逐步解析
以下是一份可直接用于生产环境的完整上传脚本。代码中展示了如何组装普通字段、文件流,并配置带有传输速率与百分比的回调函数。
import os
import sys
import time
import requests
from requests_toolbelt.multipart.encoder import MultipartEncoder, MultipartEncoderMonitor

def create_progress_callback(encoder):
    """创建上传进度监控回调函数"""
    start_time = time.time()
    last_printed_time = 0.0

    def callback(monitor):
        nonlocal last_printed_time
        current_time = time.time()
        # 限制刷新频率,避免在终端中过度频繁输出
        if current_time - last_printed_time < 0.2 and monitor.bytes_read < monitor.len:
            return

        last_printed_time = current_time
        elapsed = current_time - start_time
        percent = (monitor.bytes_read / monitor.len) * 100
        speed_mb = (monitor.bytes_read / (1024 * 1024)) / elapsed if elapsed > 0 else 0

        sys.stdout.write(
            f"\r[上传进度] {percent:6.2f}% | "
            f"已发送: {monitor.bytes_read / (1024*1024):8.2f} MB / {monitor.len / (1024*1024):8.2f} MB | "
            f"平均速率: {speed_mb:6.2f} MB/s"
        )
        sys.stdout.flush()

    return callback

def upload_large_file_streaming(target_url: str, file_path: str, auth_token: str):
    if not os.path.isfile(file_path):
        raise FileNotFoundError(f"文件不存在: {file_path}")

    filename = os.path.basename(file_path)

    # 1. 以只读二进制模式安全打开文件句柄
    with open(file_path, "rb") as file_stream:
        # 2. 组装 MultipartEncoder,传入普通参数与文件只读流
        encoder = MultipartEncoder(
            fields={
                "token": auth_token,
                "description": "生产日志归档分卷",
                "file": (filename, file_stream, "application/octet-stream")
            }
        )

        # 3. 封装监控器,绑定实时进度回调
        progress_cb = create_progress_callback(encoder)
        monitor = MultipartEncoderMonitor(encoder, progress_cb)

        # 4. 发送请求:必须使用 encoder.content_type 覆盖请求头
        headers = {
            "Content-Type": monitor.content_type
        }

        print(f"开始流式上传: {filename} (总尺寸: {encoder.len / (1024*1024):.2f} MB)")
        try:
            # 注意:将 monitor 对象直接传给 data,而非 files 参数!
            response = requests.post(
                target_url,
                data=monitor,
                headers=headers,
                timeout=(10, 300)  # 依次为连接超时与读取超时
            )
            print()  # 打印换行,收束进度条

            if response.status_code == 200:
                print("上传成功!服务端响应:", response.text)
            else:
                print(f"上传失败,HTTP 状态码: {response.status_code}, 错误信息: {response.text}")
        except requests.exceptions.RequestException as exc:
            print(f"\n网络请求异常: {exc}")
            raise

if __name__ == "__main__":
    # 示例调用
    TARGET_API = "http://127.0.0.1:8000/api/upload"
    LARGE_FILE = "data_archive_sample.iso"
    upload_large_file_streaming(TARGET_API, LARGE_FILE, auth_token="Bearer-secure-abc1234")
- 传递参数是
data=monitor而非files=...:在requests内部,如果向files传参,会重新触发其内置的分块解析器;将MultipartEncoder传给data,requests才会将其识别为一个标准的流迭代对象。 - 使用
monitor.content_type:编码器在初始化时随机生成了boundary字符串,请求头必须带上这个具体的 Boundary 声明,否则服务端无法定位边界。 timeout=(connect, read)细分超时设置:对于大文件上传,网络耗时会很长。如果只设置一个较短的单值超时,很容易在数据正在持续发送时误判超时中断。
现代异步场景:使用 httpx 与 aiohttp 流式上传
随着 FastAPI、Sanic 等基于 ASGI 的异步框架普及,客户端也越来越多地使用 httpx 或 aiohttp 来支持协程并发。在异步场景下,同样需要避免在内存中拼接字节串。
基于 httpx 的流式上传
httpx 提供了优异的现代化 API。对于异步文件流,可以通过生成器包装或者使用官方推荐的流式生成管道:
import httpx
import os

async def upload_file_httpx_streaming(url: str, file_path: str):
    file_size = os.path.getsize(file_path)

    # 定义异步分块生成器,每次 yield 128KB
    async def file_generator(chunk_size: int = 128 * 1024):
        with open(file_path, "rb") as f:
            while chunk := f.read(chunk_size):
                yield chunk

    # 如果服务端接口接受原始二进制流(octet-stream)
    headers = {
        "Content-Type": "application/octet-stream",
        "Content-Length": str(file_size)
    }

    async with httpx.AsyncClient(timeout=300.0) as client:
        # 直接传入生成器,httpx 自动进行流式推送
        response = await client.post(url, content=file_generator(), headers=headers)
        return response.status_code
如果服务端必须要求 multipart/form-data 格式,在 httpx 中也可以传递包含异步读取能力的文件句柄对象,httpx 的 files 字典支持传入具有 .read() 接口的文件对象并自动流式发送。
生产环境避坑与全链路协同优化
流式上传不仅仅是客户端单方面的代码修改,整个链路上还涉及反向代理配置、断点游标与重试策略等多个现实因素。
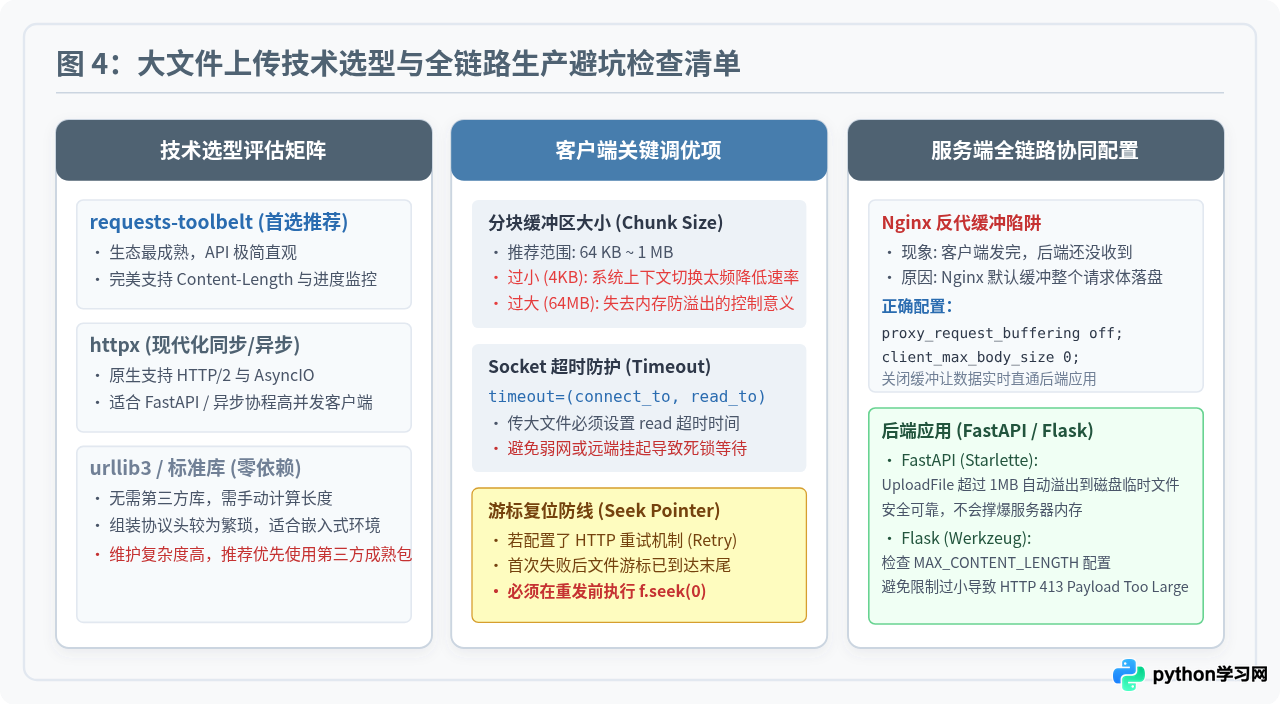
图 4:大文件上传技术选型与全链路生产避坑检查清单
1. 分块大小(Chunk Size)的合理取值
MultipartEncoder 默认使用 8192 字节(8KB)作为默认的分块大小。在内网高速网络或千兆互联网环境下,8KB 的分块可能会引发过于频繁的系统调用与 CPU 上下文切换,从而无法跑满网络带宽。
通常建议根据文件大小和网络环境调整分块粒度:
| 推荐分块大小 | 适用场景 | 优缺点评估 |
|---|---|---|
| 64 KB (65536) | 百兆级别公网上传、轻量容器环境 | 内存占用极低(几乎忽略不计),适应常规波动网络 |
| 256 KB ~ 1 MB | 千兆局域网传输、GB 级别大文件归档 | 显著降低 CPU 系统调用次数,吞吐量高,常驻内存仍小于 30MB |
| > 32 MB | 通常不建议使用 | 失去流式控制内存的意义,垃圾回收压力增加 |
2. 网络重试与文件游标陷阱
在大文件传输中,网络抖动是常态。许多开发者会为 requests.Session 挂载 HTTPAdapter(max_retries=3)。
危险隐患:当连接在中途发生异常触发重试时,底层的文件对象 f 的读取指针(Pointer)已经停留在中断处,比如第 500MB 的位置。如果直接让连接适配器发起重试,重发出来的数据将从第 500MB 开始读取,导致服务端接收到一个头部残缺、内容混乱的损坏文件!
正确对策:如果必须在代码层面做自动重试,必须显式捕获异常,并在下一次请求发起前重新执行 file_handle.seek(0) 恢复指针位置,同时重新构建 MultipartEncoder。
3. 服务端反向代理(Nginx)的缓冲陷阱
许多技术团队在客户端改用了流式上传后,发现服务端依然会在上传完成的一瞬间“假死”,或者服务端监控依然显示内存瞬间爆满。这通常是因为中间部署了 Nginx 等反向代理服务器。
Nginx 默认启用了 proxy_request_buffering on;。这意味着:
- 客户端虽然在流式发送,但 Nginx 会在自己的磁盘或内存中完整缓存整个 HTTP 请求体;
- 只有当所有几十 GB 的数据完全写到 Nginx 本地临时目录后,Nginx 才会一次性向后端的 Python 服务(如 Uvicorn / Gunicorn)发起转发;
- 这不仅让客户端的进度条彻底失去即时意义,而且可能导致 Nginx 磁盘空间耗尽报 500 错误。
在处理大文件上传的特定 location 路径下,应该在 Nginx 中关闭请求缓冲:
location /api/upload {
    proxy_pass http://backend_upstream;
    # 关闭请求体全量缓冲,让数据流实时直达后端 Python 应用
    proxy_request_buffering off;
    # 允许上传任意体积的大文件(或设定为足够大的上限,例如 20G)
    client_max_body_size 0;
    # 调高超时时限以防大文件传输中断
    proxy_read_timeout 600s;
    proxy_send_timeout 600s;
}
总结与快速自查清单
要彻底解决 Python 在大文件 form-data 上传时的内存溢出问题,请在代码上线前逐一核对以下关键自查项:
- [✓] 只读流模式:文件打开必须使用
open(path, 'rb'),全局搜索代码,严禁出现任何.read()一次性读取大文件的操作。 - [✓] 采用流式装配库:使用
requests-toolbelt的MultipartEncoder代替原始字典传参,并挂载到data=参数上。 - [✓] 绑定动态 Boundary:请求头中的
Content-Type必须取自encoder.content_type。 - [✓] 精确 Content-Length:确保没有因为强制启用 chunked 导致缺少总长度头而被生产网关拦截。
- [✓] 全链路关闭缓冲:检查客户端到服务端的中间代理(如 Nginx),确保
proxy_request_buffering off,实现端到端的纯流式管道。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









