

Python异步编程能处理CPU密集计算吗
深入解析Python异步编程(asyncio)处理CPU密集型计算的底层机理与瓶颈,讲解单线程事件循环阻塞原因,并提供基于ProcessPoolExecutor与架构解耦的完整解决方案与实战代码。
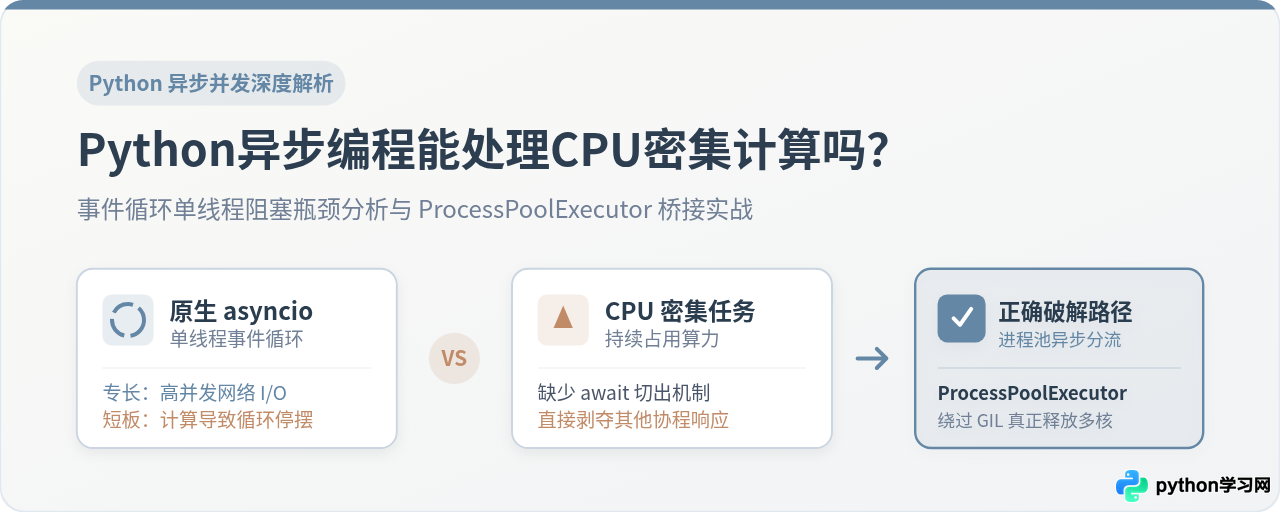
asyncio 及其 async/await 语法)无法直接处理 CPU 密集型计算。在协程中直接运行密集算力任务,会无条件霸占底层的单线程事件循环,导致网络通信、定时器及其它所有协程全线卡死。不过,asyncio 提供了官方桥接机制:通过 loop.run_in_executor() 将纯计算任务委托给独立的多进程池(ProcessPoolExecutor),不仅能够绕开 CPython 的全局解释器锁(GIL)实现多核物理并行,还能确保异步主线程继续以极低延迟响应外部请求。
一、底层机制:为什么原生协程会被 CPU 计算完全冻结
要理解为什么异步协程难以直接胜任 CPU 密集计算,必须从 asyncio 的调度本质说起。Python 的 asyncio 采用的是单线程协作式多任务(Cooperative Multitasking)模型。
在协作式模型中,操作系统的调度器并不介入协程之间的切换。整个进程只有一个主执行线程,所有的协程代码都在同一个事件循环(Event Loop)中排队轮流运行。当一个协程执行到 await socket_read() 或 await asyncio.sleep() 时,它是在主动向事件循环发出通知:“我正在等待外部 I/O 资源,请先把当前线程的执行权交还给调度器,去执行就绪队列里的其他任务”。当 I/O 事件在内核中就绪后,事件循环再将该协程重新唤醒恢复执行。这就是 Python 异步能够以单线程承受数万个高并发连接的根本原因。
然而,CPU 密集型计算(例如图像渲染、密码散列计算、高位素数分解、大规模数据重排)的执行特征是无休止的纯计算循环。在计算过程中,代码没有任何 await 出让点。由于 Python 协程是非抢占式的,一旦一个协程开始执行耗时 3 秒的纯数学计算,事件循环就会被该协程彻底独占整整 3 秒。在这 3 秒内,事件循环无法轮询任何新到达的 TCP 请求,定时器无法触发,WebSocket 心跳无法维持,系统在外部表现为完全无响应或超时崩溃。
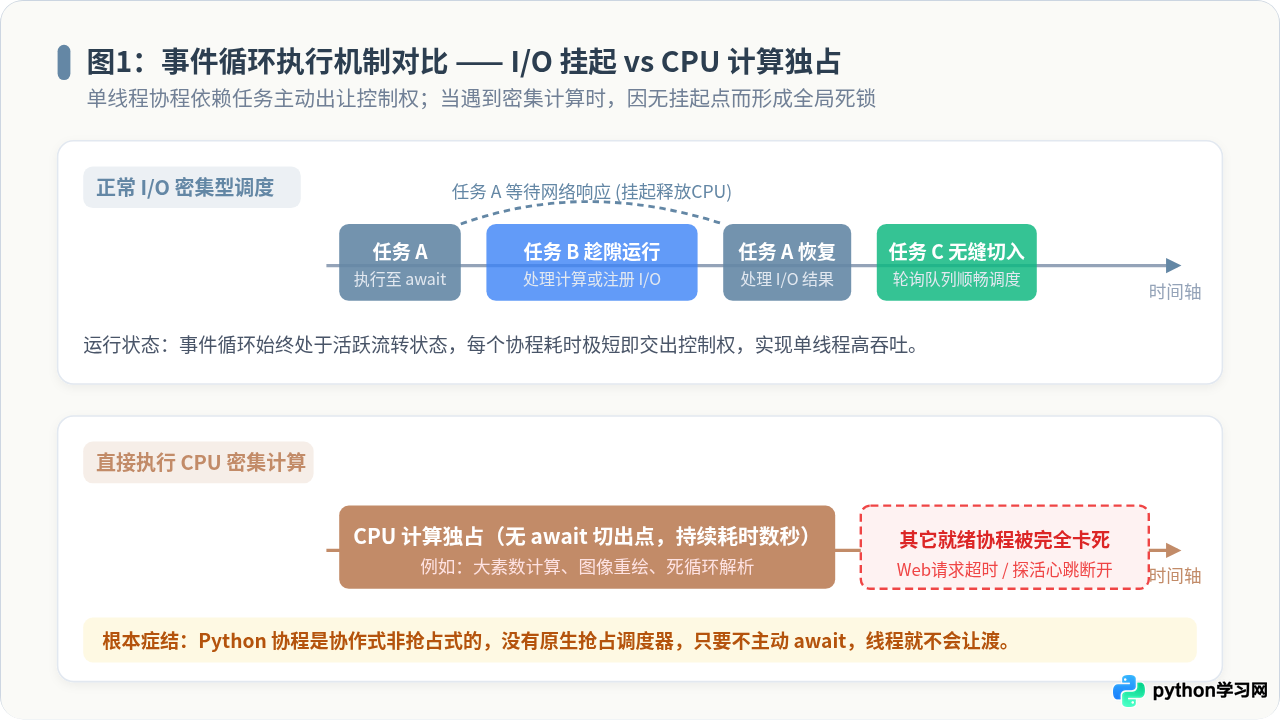
为了直观验证这种阻塞现象,我们来看一段典型的反模式示例:在协程中直接写纯计算代码。
# 文件名:bad_cpu_async.py(反模式示例:直接在协程中执行密集计算)
import asyncio
import time

async def heartbeat():
    """模拟每 500 毫秒一次的高频心跳或外部请求"""
    while True:
        print(f"[{time.strftime('%H:%M:%S')}] 心跳正常:系统响应灵敏")
        await asyncio.sleep(0.5)

async def blocking_cpu_task(n: int):
    """错误示例:在 async 函数中执行 CPU 密集型纯算力逻辑"""
    print(f"[{time.strftime('%H:%M:%S')}] 开始执行 CPU 密集任务...")
    count = 0
    for i in range(n):
        count += i * i
    print(f"[{time.strftime('%H:%M:%S')}] CPU 密集任务完成!")
    return count

async def main():
    # 同时启动心跳和计算任务
    asyncio.create_task(heartbeat())
    await asyncio.sleep(1.0)  # 先让心跳打印两次

    # 触发 CPU 密集计算(约占用 3 秒 CPU)
    await blocking_cpu_task(60_000_000)

    await asyncio.sleep(1.0)

if __name__ == "__main__":
    asyncio.run(main())
控制台运行输出(示例):
[11:00:00] 心跳正常:系统响应灵敏
[11:00:00] 心跳正常:系统响应灵敏
[11:00:01] 开始执行 CPU 密集任务...
[11:00:04] CPU 密集任务完成!
[11:00:04] 心跳正常:系统响应灵敏
[11:00:04] 心跳正常:系统响应灵敏
[11:00:05] 心跳正常:系统响应灵敏
从运行结果可以清晰看到,在 11:00:01 到 11:00:04 整整 3 秒的时间里,原本应该每 500 毫秒打印一次的 heartbeat() 彻底陷入沉寂。这就是单线程事件循环遭遇 CPU 密集任务时的真实后果。
二、认知误区:多线程(ThreadPool)为什么无法救场
许多刚接触异步编程的开发者会尝试用 asyncio.to_thread() 或 ThreadPoolExecutor 将密集计算包装成后台任务。这种做法在表面上确实让主事件循环线程不再卡死,但对于纯 Python 的 CPU 计算任务而言,多线程并不能带来任何算力提升,甚至可能导致程序变得更慢。
造成这一现象的根本原因是 CPython 解释器的全局解释器锁(Global Interpreter Lock,简称 GIL)。在 CPython 中,哪怕操作系统分配了多个物理 CPU 核心,GIL 规定在任何给定瞬间,只允许一个操作系统线程在解释器中执行 Python 字节码。
- 在 I/O 密集场景中:当线程执行系统调用(如网络阻塞读取或休眠)时,Python 会主动释放 GIL,允许其他线程获得锁并运行。因此多线程对 I/O 是有效的。
- 在纯 Python CPU 计算场景中:多个线程会不断为了争夺 GIL 而发起激烈的自旋锁竞争。解释器每执行约 5 毫秒(或一定数量的字节码指令)就会强制触发一次线程上下文切换。这种高频的线程抢占和 CPU 缓存失效(L1/L2 Cache Thrashing),反而引入了巨大的额外调度损耗。
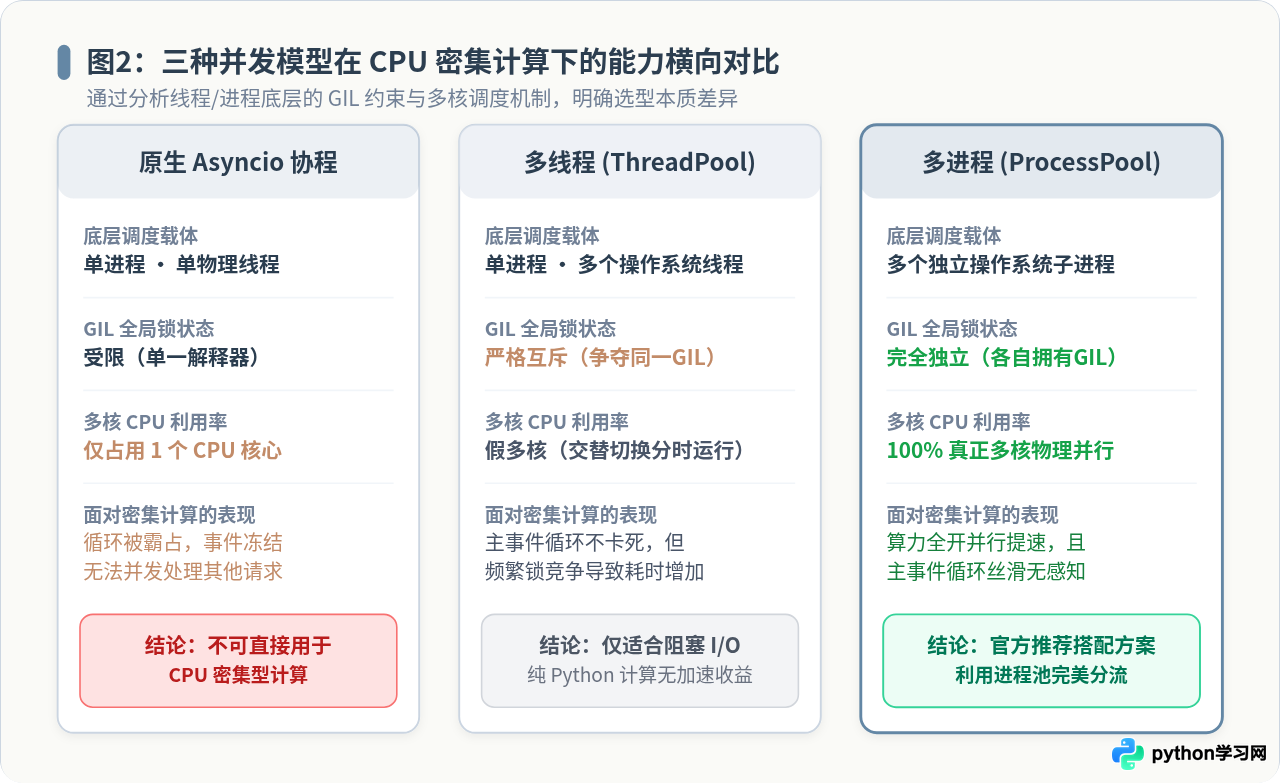
NumPy 的矩阵计算、OpenCV 的图像处理、Pillow 的图片编解码),这些库在进入 C 语言层面运算前通常会调用 Py_BEGIN_ALLOW_THREADS 显式释放 GIL。只有在满足该前提时,使用线程池(ThreadPoolExecutor)才能真正享受到多核并行加速。
三、标准解法:Asyncio 结合 ProcessPoolExecutor 安全调度
既然原生协程会阻塞事件循环,而纯 Python 多线程又受困于 GIL,那么在异步程序中处理 CPU 密集计算的唯一标准出路,就是多进程(Multiprocessing)。
每一个独立的 Python 进程都拥有自己专属的内存空间、独立的 Python 解释器以及各自完全独立的 GIL。因此,多个子进程能够在操作系统的多核 CPU 上实现真正的物理并行,互不干扰,更不会占用主服务进程的事件循环资源。
asyncio 标准库通过 loop.run_in_executor() 接口提供了优雅的无缝桥接方式。事件循环将计算任务提交给 concurrent.futures.ProcessPoolExecutor,子进程在后台独立跑满 CPU,主线程的协程则使用 await 挂起监听。一旦子进程计算完毕,跨进程通道(IPC)将结果传回,事件循环自动唤醒协程继续向下执行。
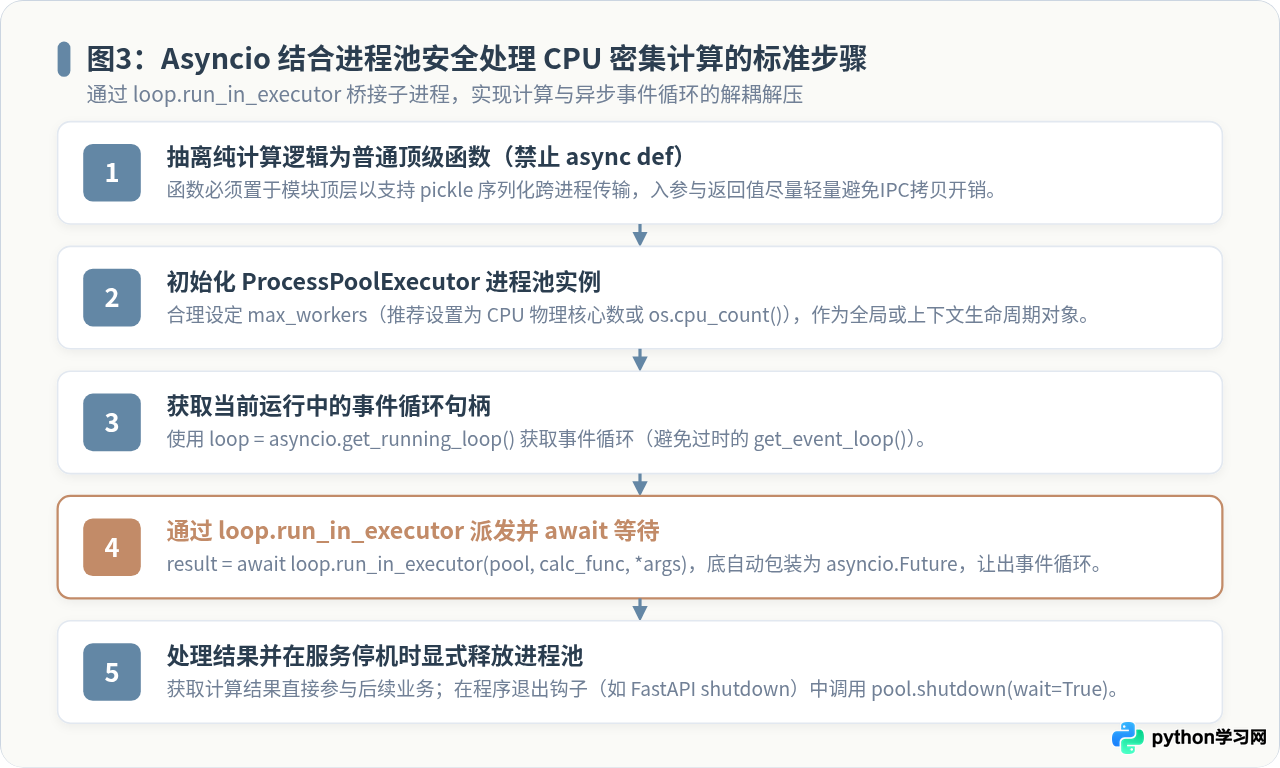
完整实战代码:多进程桥接无阻塞运算
下面给出一个可在生产中参照的规范实现。我们在主事件循环中持续维护心跳,同时将高负载的数学计算分发给后台进程池:
# 文件名:good_async_process.py(推荐范式:进程池异步分发)
import asyncio
import os
import time
from concurrent.futures import ProcessPoolExecutor

# 关键步骤 1:必须定义为模块顶级普通函数(支持 pickle 序列化跨进程传输)
def cpu_heavy_calculation(chunk_id: int, total_iterations: int) -> dict:
    """纯 CPU 密集运算逻辑(不要加 async)"""
    start_time = time.perf_counter()
    accumulated_sum = 0
    for i in range(total_iterations):
        accumulated_sum += i * i
    duration = time.perf_counter() - start_time
    return {
        "chunk_id": chunk_id,
        "process_pid": os.getpid(),
        "duration_sec": round(duration, 3),
        "result_checksum": accumulated_sum % 1_000_007
    }

async def pulse_monitor():
    """模拟服务的主业务高频事件(验证事件循环绝不卡死)"""
    for tick in range(10):
        print(f"[{time.strftime('%H:%M:%S')}] 主事件循环响应心跳 Tick-{tick}")
        await asyncio.sleep(0.5)

async def main():
    # 关键步骤 2:创建进程池实例,默认 max_workers 为机器物理核心数
    cpu_count = os.cpu_count() or 4
    print(f"[{time.strftime('%H:%M:%S')}] 初始化进程池,工作子进程数:{cpu_count}")

    with ProcessPoolExecutor(max_workers=cpu_count) as process_pool:
        # 关键步骤 3:获取当前运行中的事件循环
        loop = asyncio.get_running_loop()

        # 启动高频心跳任务
        monitor_task = asyncio.create_task(pulse_monitor())

        # 关键步骤 4:通过 run_in_executor 并发分发 3 个沉重的计算任务
        tasks = [
            loop.run_in_executor(
                process_pool,
                cpu_heavy_calculation,
                task_id,
                50_000_000
            )
            for task_id in range(1, 4)
        ]

        print(f"[{time.strftime('%H:%M:%S')}] 3 个后台计算任务已分发至子进程...")

        # 关键步骤 5:使用 asyncio.gather 异步等待所有计算结果返回
        results = await asyncio.gather(*tasks)

        for item in results:
            print(f"[{time.strftime('%H:%M:%S')}] 任务 {item['chunk_id']} 完成 | "
                  f"执行进程 PID={item['process_pid']} | 耗时 {item['duration_sec']}s")

        await monitor_task

if __name__ == "__main__":
    # Windows 及 macOS 必须在此入口守卫下运行多进程
    asyncio.run(main())
控制台运行输出(示例):
[11:05:00] 初始化进程池,工作子进程数:8
[11:05:00] 主事件循环响应心跳 Tick-0
[11:05:00] 3 个后台计算任务已分发至子进程...
[11:05:00] 主事件循环响应心跳 Tick-1
[11:05:01] 主事件循环响应心跳 Tick-2
[11:05:01] 主事件循环响应心跳 Tick-3
[11:05:02] 主事件循环响应心跳 Tick-4
[11:05:02] 任务 1 完成 | 执行进程 PID=48921 | 耗时 2.145s
[11:05:02] 任务 2 完成 | 执行进程 PID=48922 | 耗时 2.158s
[11:05:02] 任务 3 完成 | 执行进程 PID=48923 | 耗时 2.162s
[11:05:02] 主事件循环响应心跳 Tick-5
[11:05:03] 主事件循环响应心跳 Tick-6
...Tick-1 到 Tick-4 每隔 0.5 秒如期打出,丝毫不受后台计算负载的任何影响。
多进程桥接的三大注意事项
- 序列化约束(Pickleable):传递给
loop.run_in_executor的函数、入参以及最终返回的计算结果,必须能够被 Python 的pickle模块序列化。避免传递数据库连接、套接字句柄或包含局部闭包的复杂动态对象。 - IPC 通信开销控制:跨进程通信依赖管道或套接字在内存中序列化与反序列化数据。如果计算需要传递几百兆的高清原图或大型数据帧,序列化和反序列化本身的 CPU 耗时可能超过计算本身。此时应结合
multiprocessing.shared_memory共享内存机制,或通过本地临时文件仅传递文件路径。 - 进程池的生命周期管理:不要在每个 API 路由或请求函数内部频繁创建和销毁
ProcessPoolExecutor,启动新 Python 解释器的进程开销极大。应该将进程池作为服务的全局长生命周期单例(例如在 FastAPI 的lifespan事件中初始化并在退出时shutdown)。
四、生产级选型:不同算力规模下的架构决策
在构建工业级高可用服务时,不能简单地把所有计算需求都丢进本地进程池。我们需要根据任务的耗时量级、资源隔离要求和集群规模制定架构分级策略。
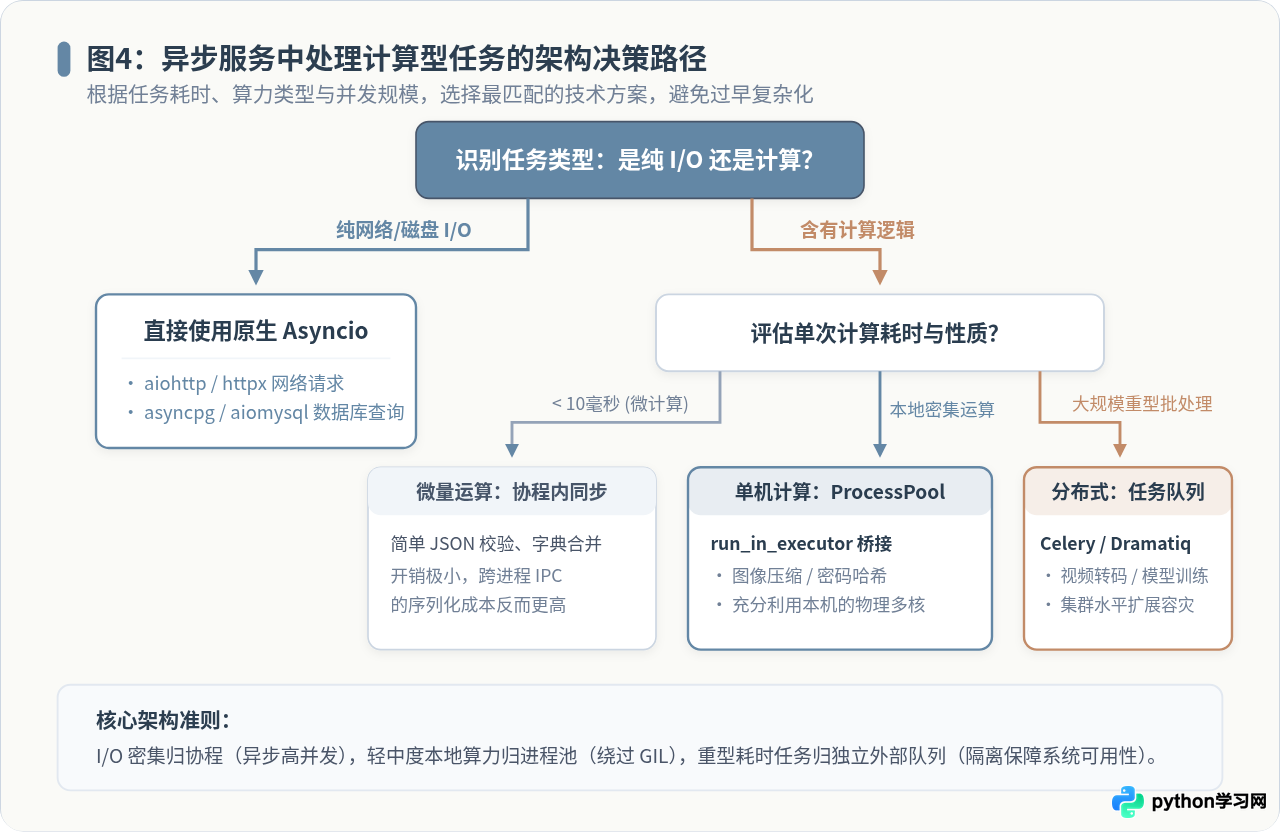
| 计算耗时量级 | 典型业务场景 | 推荐技术方案 | 核心选型理由 |
|---|---|---|---|
| 微量计算 (< 10ms) | 请求参数校验、简单 JWT 签名解密、小字典过滤 | 协程内直接同步计算 | 耗时极短,IPC 跨进程序列化的调度开销反而远大于任务本身。 |
| 本地中度计算 (10ms ~ 2s) | 头像缩放裁剪、密码哈希加盐校验、中型报表数据清洗 | asyncio + ProcessPoolExecutor |
单机多核并行利用率最高,开箱即用,无需维护额外分布式基础设施。 |
| 重型耗时任务 (> 2s) | 视频切片转码、大模型离线推理、大规模 PDF 文档解析 | 外部独立任务队列 (Celery / Dramatiq + Redis/RabbitMQ) | 严格隔离算力集群与 Web API 服务,防止单机 CPU 占满导致整机雪崩或 OOM。 |
| 高频极速运算 | 海量特征向量距离检索、超大矩阵运算 | C 扩展 / Rust (PyO3) + 线程池 | 在底层原生代码中释放 GIL,直接压榨物理核心极限性能。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









