

Python处理大文件时切片与itertools.islice的区别
深入对比Python处理大文件时常规切片与itertools.islice的底层机制差异,解析内存占用、惰性求值、指针推进与提前终止原理,提供大文件流式切片与分批处理工程实战。
一、底层协议与机制:为什么文件对象不能直接切片?
在 Python 的对象体系中,序列切片语法 sequence[start:stop:step] 依赖的是序列随机访问协议(即类内部实现了 __getitem__ 方法,并且支持通过整型索引直接定位)。列表(list)、字符串(str)和元组(tuple)都原生支持该协议。
然而,通过 open() 打开的文件对象是一个流式迭代器(Iterator),其底层核心方法是 __next__(),并没有实现 __getitem__。文件对象只支持单向向前拉取下一行,无法直接根据行号进行跳转。
# 错误示范 1:直接尝试切片文件对象
with open("huge_access.log", "r", encoding="utf-8") as f:
    try:
        lines = f[1000:1050]
    except TypeError as e:
        print(e)  # 报错: TypeError: '_io.TextIOWrapper' object is not subscriptable
为了解决无法切片的问题,很多初学者常常采用如下的折中方案:
# 错误示范 2:将文件全量转为列表后再切片(大文件极度危险)
with open("huge_access.log", "r", encoding="utf-8") as f:
    all_lines = f.readlines()  # 若文件为 20GB,此行将直接将 20GB 数据读入物理内存
    target_lines = all_lines[1000:1050]  # 极易引发 MemoryError 或导致系统卡死
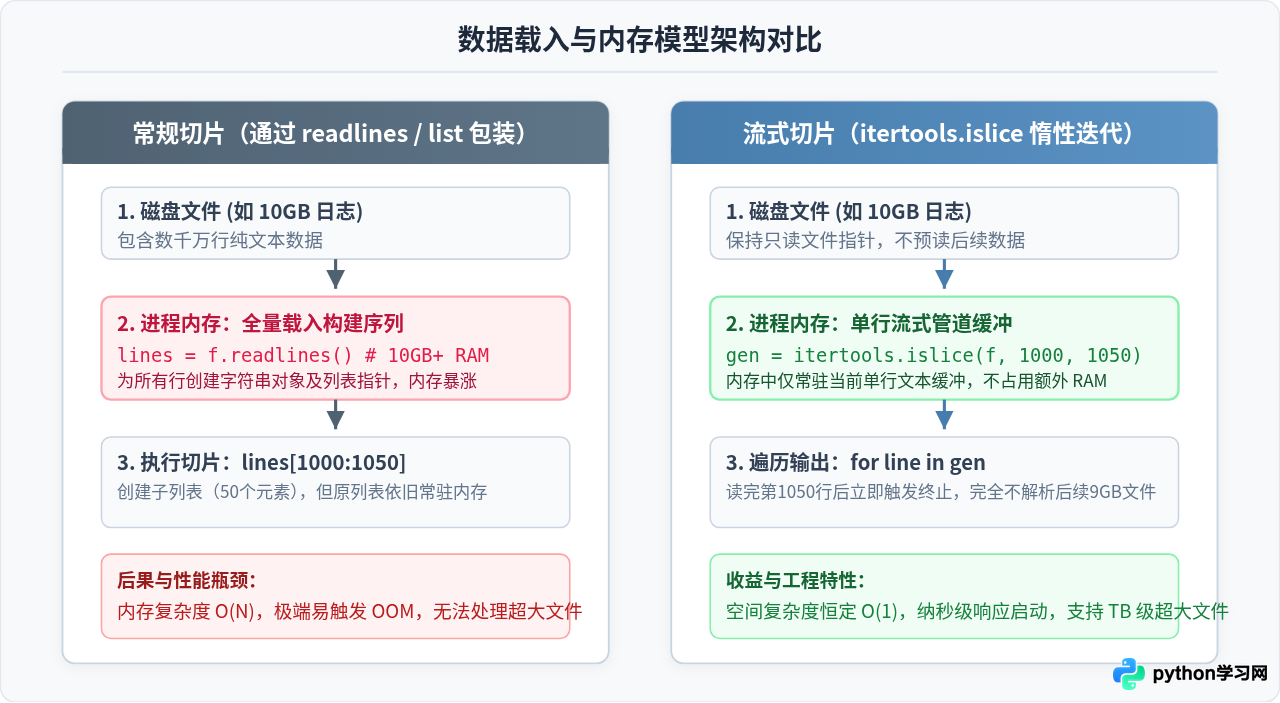
f.readlines() 或 list(f) 会迫使 Python 遍历文件直到文件末尾(EOF),为每一行分配一个字符串对象,并将它们的指针保存在一个巨大列表中。对于数吉字节到数十吉字节的文件,这种做法会瞬间耗尽机器可用 RAM,触发操作系统的 Swap 换页甚至被 OOM Killer 强制终结。
二、itertools.islice 的运行原理与指针推进机制
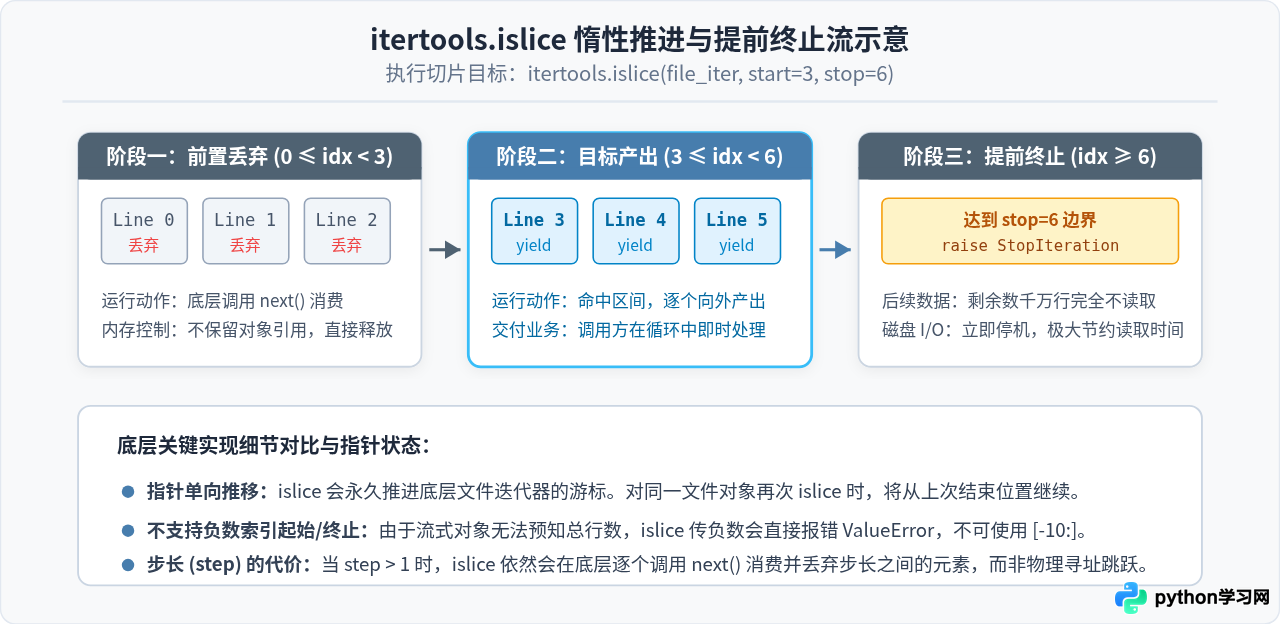
itertools.islice(iterable, [start,] stop [, step]) 是 Python 标准库中为迭代器量身打造的切片生成器。它接收任意可迭代对象,并返回一个新的惰性迭代器。在读取文件时,它的工作流包含三个明确阶段:
- 前置丢弃阶段(Skip Phase):从第 0 行开始,在未达到
start边界之前,islice底层通过不断调用next(iterable)获取数据并立即释放丢弃,不会在内存中创建列表存储。 - 目标产出阶段(Yield Phase):当计数器到达
start后,islice开始将每次从底层迭代器读取到的元素通过yield交付给上层调用者。 - 提前终止阶段(Early Termination):一旦计数器递增到
stop,islice内部会立刻触发StopIteration终止迭代。此时后续的所有磁盘内容完全不会被读取或解析,避免了无谓的磁盘 I/O 开销。
正因为这种逐行流转的机制,无论待处理日志文件是 100MB 还是 100GB,使用 islice 时 Python 进程占用的内存都仅仅是当前单行文本的微量缓冲区大小(通常不足几 KB),空间复杂度严格保持在 O(1)。
三、实操指南:大文件切片与分批处理标准步骤
在实际工程开发中,提取大文件特定行段或对文件按块(Batch)批处理是最常见的需求。以下展示规范的操作步骤与标准示例代码。
步骤 1:截取指定区间(例如第 1,000 到 1,050 行)
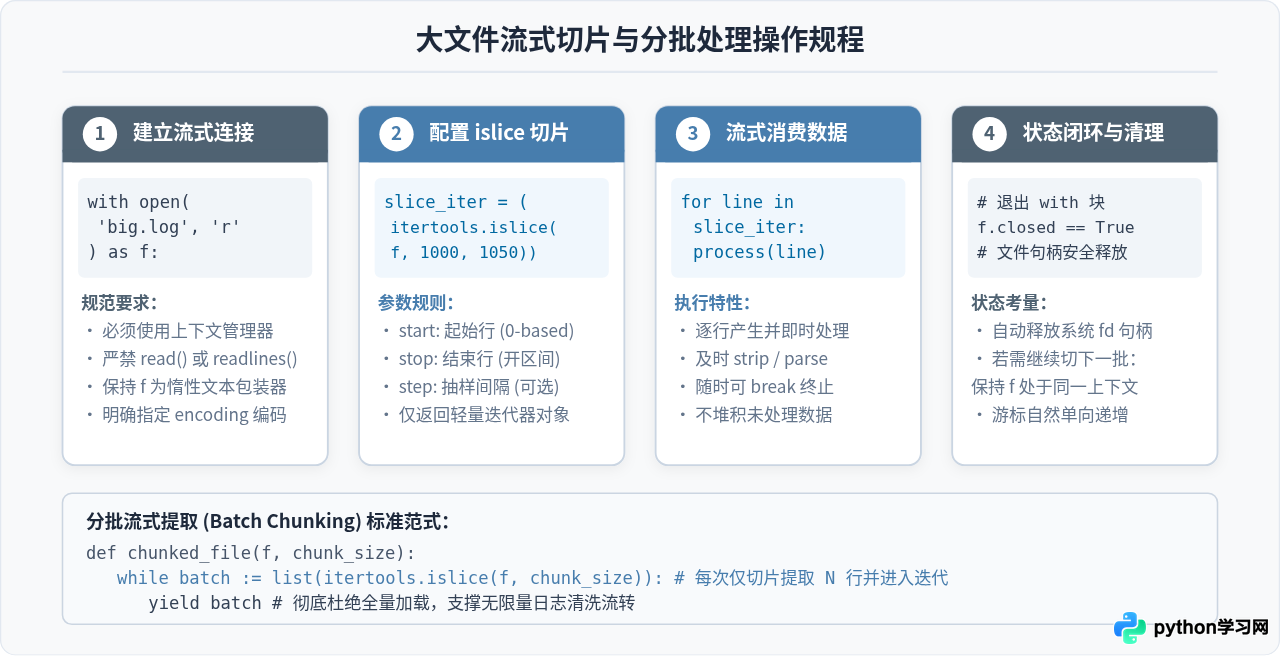
若需要快速查看或解析大型日志文件中第 1,000 行至 1,050 行的内容,直接将打开的文件句柄传入 itertools.islice:
import itertools

def extract_log_slice(file_path, start_line, stop_line):
    # 使用 with 确保无论处理是否异常,底层文件描述符均能安全关闭
    with open(file_path, "r", encoding="utf-8") as f:
        # islice 索引与 Python 切片一致:从 0 开始计数,左闭右开
        target_stream = itertools.islice(f, start_line, stop_line)

        for idx, line in enumerate(target_stream, start=start_line):
            print(f"[{idx}] {line.strip()}")

# 示例调用:提取 50GB 日志文件的第 1000 到 1050 行
# extract_log_slice("huge_production.log", 1000, 1050)
步骤 2:对大文件进行分批分块(Chunking)流式消费
在数据清洗、批量插入数据库或并行任务调度中,通常需要将几千万行的大文件按每批 5,000 行切片处理。利用 islice 的单向推进特性,可以写出极为优雅的批处理生成器:
import itertools

def read_file_in_chunks(file_obj, chunk_size=5000):
    """
    将大文件按固定 batch_size 切割为批次生成器。
    由于 islice 会不断推移 file_obj 的当前游标,连续调用可自然获取后续批次。
    """
    while True:
        # 每次切片取出最多 chunk_size 行
        chunk = list(itertools.islice(file_obj, chunk_size))
        if not chunk:
            break
        yield chunk

# 实战使用示例
with open("large_dataset.csv", "r", encoding="utf-8") as f:
    for batch_no, batch_data in enumerate(read_file_in_chunks(f, chunk_size=5000), start=1):
        print(f"正在处理批次 #{batch_no},本批数据条数: {len(batch_data)}")
        # 在此执行批量 SQL 写入或特征提取操作...
四、关键差异与容易踩坑的边界限制
虽然 itertools.islice 在性能和内存控制上远胜常规切片,但因为它是面向抽象迭代器的,在使用时存在几个必须注意的技术边界与常见陷阱:
常规列表切片支持 seq[-10:] 语法,因为列表知道自身的 len()。但迭代器是单向流,在读完全部数据之前,它不可能预知总行数。如果在 islice 中传入负数:
# 错误写法:
itertools.islice(f, -10, None)
# 立即抛出: ValueError: Indices for islice() must be None or an integer >= 0正确解决方案:如果要在不全量装入内存的前提下获取大文件的末尾 N 行,应使用标准库中的定长双端队列 collections.deque,它只会保留最近 N 个元素:
from collections import deque

with open("huge_access.log", "r", encoding="utf-8") as f:
    # maxlen=10 的定长队列,流式读完文件,内存开销仅为 10 行文本
    last_10_lines = deque(f, maxlen=10)
    for line in last_10_lines:
print(line.strip())普通列表切片 lst[0:10] 执行完后,列表本身没有任何状态变化,再次调用 lst[0:10] 得到的结果完全一样。
但 itertools.islice(f, 0, 10) 会真实推移底层文件对象的内部游标。如果你接着对同一个 f 再次执行 islice(f, 0, 10),读取到的将是第 10 到 20 行,而不是前 10 行。若需重新从头切片,必须显式调用 f.seek(0) 重置文件指针,或者重新打开文件。
在普通切片 lst[::2] 中,Python 可以根据底层 C 数组的步长公式直接通过指针加法跳过元素。但在 islice(f, 0, 100, 2) 中,因为底层是文本行流,Python 无法预知换行符在磁盘上的字节跨度,所以必须在底层逐个调用 next() 读出中间被跳过的行并丢弃。因此,步长虽然减少了输出数量,但并不会显著降低前置行的磁盘扫描耗时。
五、全维度对比与技术选型决策
通过下表与选型决策图,可以清晰建立在不同数据规模和访问模式下的切片选型依据:
| 对比指标 | 常规序列切片(List Slicing) | itertools.islice |
|---|---|---|
| 底层协议要求 | 实现 __getitem__ 协议的随机访问序列 |
实现 __iter__ / __next__ 的任意可迭代对象 |
| 内存复杂度 | O(N) 需保留全量或切片容器内存 | O(1) 恒定单行缓冲,内存无堆积 |
| 是否提前终止 I/O | 否(使用 readlines 需先全部读完) | 是 到达 stop 行立即停止读取 |
| 负数索引支持 | 支持(例如 [-10:] 获取末尾) |
不支持(传负数抛出 ValueError) |
| 对原对象副作用 | 纯函数式读取,原序列保持无损 | 具有单向消耗性,会持久推进流游标 |
| 适用文件规模 | 小文件(< 50MB 内存无压力场景) | 中型、大型及超大型文件(GB 至 TB 级) |
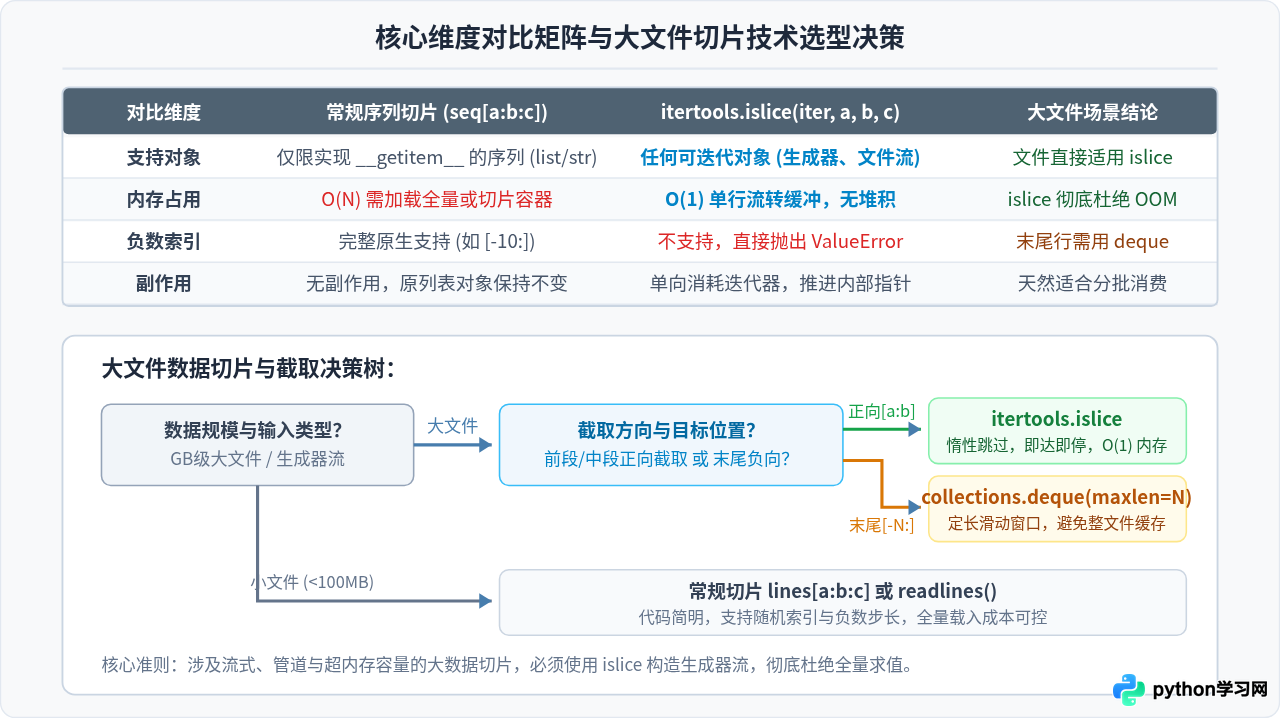
总结与选型原则
在 Python 大文件处理任务中,牢记以下两条核心准则:
- 正向抽取与批处理:凡是面对大于可用内存的文件、日志流或网络生成器,只要涉及按行区间截取、样本抽样或分批处理,统一使用
itertools.islice构建轻量管道,杜绝全量加载。 - 末尾截取与逆向查询:若需要截取大文件的最后 N 行,应搭配
collections.deque(f, maxlen=N)或底层的os.lseek反向字节寻址,而非强行对islice传入负数索引。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









