

Python中Sync与Async执行速度对比:场景决定性能

本文深入解析Python中Sync与Async的执行效率差异。通过纯CPU计算与高并发IO两种场景的对比实验,揭示async语法在纯计算中因事件循环开销略慢于sync,但在高并发IO场景下凭借协程非抢占式调度优势,显著优于多线程/进程方案。
前记
Python新版本引入了async/await语法,许多文章声称使用这种语法编写的代码运行速度会显著提升,但这种性能提升是有特定场景限制的。本文将尝试简要解释为何在特定情况下,Async代码的执行速度可能快于Sync代码。
1.一个简单的例子
首先通过一个示例来了解两种调用方式的区别。为了清晰展示运行时间的差异,我们让两种方法分别重复执行10000次,具体代码如下:
import asyncio
import time


n_call = 10000


# sync的调用时长
def demo(n: int) -> int:
    return n ** n

s_time = time.time()
for i in range(n_call):
    demo(i)
print(time.time() - s_time)

# async的调用时长
async def sub_demo(n: int) -> int:
    return n ** n

async def async_main() -> None:
    for i in range(n_call):
        await sub_demo(i)

loop = asyncio.get_event_loop()
s_time = time.time()
loop.run_until_complete(async_main())
print(time.time() - s_time)

# 输出
# 5.310615682601929
# 5.614157438278198
可以看出,sync语法是大家非常熟悉的,而async语法则有所不同:函数定义需要使用async def关键字开头,同时调用async def函数时必须使用await语法。运行时,需要先获取线程的事件循环,然后通过事件循环来运行async_main函数,从而达到相同的效果。从运行结果的输出来看,在这个场景中,sync语法的执行速度比async语法稍快一些(由于Python的GIL限制,这里无法利用多核性能,只能以单核运行)。
造成这种差异的原因是,在由同一个线程执行(CPU单核心)的情况下,async的调用还需要经过事件循环的一些额外处理,这会产生少量开销,从而导致运行时间比sync稍慢。同时,这是一个纯CPU运算的示例,而async的优势主要体现在网络IO运算上,在此场景中无法发挥其优势,但在高并发场景下则会表现出色。造成这一现象的原因在于,async是基于协程运行的,而sync是基于线程运行的。
NOTE: 目前提到的async语法主要支持网络IO,而文件系统的异步IO尚不完善,因此文件系统的异步读写是通过封装交给多线程处理,而非协程。具体可见: https://github.com/python/asyncio/wiki/ThirdParty#filesystem
2.一个io的例子
为了了解async在IO场景下的运行优势,我们先假设一个IO场景——Web后台服务通常需要处理大量请求,所有请求均来自不同的客户端,示例如图:
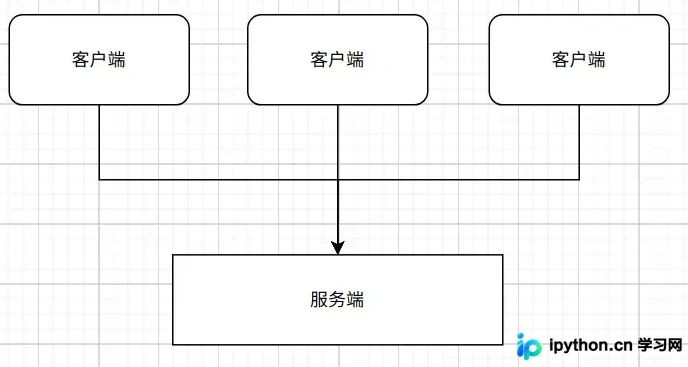
在这种场景下,客户端请求通常在短时间内发出。而服务端为了能在短时间内处理大量请求并防止处理延迟,通常会以某种方式支持并发或并行处理。
NOTE: 并发,在操作系统中,是指一个时间段中有几个程序都处于已启动运行到运行完毕之间,且这几个程序都是在同一个处理机上运行,但任一个时刻点上只有一个程序在处理机上运行。并行是计算机系统中能同时执行两个或多个处理的一种计算方法。
对于sync语法而言,这个Web后台可以通过进程、线程或两者结合来实现,它们提供的并发/并行能力受限于worker的数量。例如,当有5个客户端同时请求而服务端只有4个worker时,有一个请求会进入阻塞等待阶段,直到运行的4个worker中有一个处理完毕。为了让服务器提供更好的服务,我们通常会提供足够多的worker。同时,由于进程具有良好的隔离性且每启动一个进程都会占用一份独立资源,因此通常采用几个进程加大量线程的形式来提供服务。
NOTE:进程是最小的资源分配单位,过多的进程会占用大量系统资源,一般的后台服务启用的进程数量不会很多。同时线程是最小的调度单位,因此以下的调度描述均以线程为例。
但是这种方式非常消耗系统资源(相对于协程而言),因为线程的运行依赖于CPU执行,而CPU是有限的,同一时刻只能支持固定数量的worker运行,其他线程则需等待被调度。这意味着每个线程只能工作一个时间分片,之后就会被调度系统控制进入阻塞或就绪状态,让位给其他线程,直到下次获取时间分片时才能继续运行。为了模拟同一时刻内多个线程同时运行,且防止其他线程饿死,线程每次获得的运行时间很短,线程间的调度切换非常频繁。当启用更多的进程和线程时,调度会变得更加频繁。
不过调度线程的开销尚不算大,更大的开销是调度线程所产生的上下文切换和竞争条件(具体可参考《计算机导论》中进程调度相关的资料,此处仅作简单说明)。CPU在执行代码时,需要将数据加载到CPU缓存中再运行。当CPU运行的线程在这个时间分片内执行完成时,该线程的最新运行数据会被保存起来,然后CPU会去加载准备被调度的线程的数据并运行。虽然这部分暂存数据保存在比内存更快、更靠近CPU的寄存器上,但寄存器的访问速度也没有CPU缓存的访问速度快。因此,CPU在切换运行的线程时,都会花费一部分时间用于装载数据以及处理装载缓存时的竞争问题。
对比线程调度产生的上下文切换与抢占式机制,async语法实现的协程是非抢占式的。协程的调度依赖于一个循环来控制,这个循环是一个非常高效的任务管理器和调度器。由于调度的是一段代码的实现逻辑,CPU执行代码时无需切换上下文,因此没有上下文切换的开销,同时也无需考虑装载缓存的竞争问题。还是以上面那个图为例子,在服务启动时,会先启动一个事件循环。当收到请求时,它会创建一个任务来处理客户端发送过来的请求。这个任务从事件循环获取执行权,独占整个线程资源并一直执行,直到遇到需要等待外部事件(如等待数据库返回数据)的情况。这时任务会告诉事件循环自己在等待这个事件,然后交出执行权,事件循环就会把执行权传递给最需要运行的任务。当刚才交出执行权的任务在后续收到数据库事件响应时,事件循环会把它安排到就绪列表的第一个(不同的事件循环实现可能不一样),并在下一次切换执行权时,把执行权返回给他,让他继续执行,直到遇到下一个等待事件。
这种切换协程的方式称为协作式多任务处理。由于只在单个进程或单个线程中运行,切换协程时上下文无需改变,CPU无需重新读写缓存,因此节省了一些开销。从上面可以看出,协作式切换执行权是基于协程自己主动让出的,而线程是抢占式的。线程在没遇到IO事件时,也可能从运行状态转为就绪状态,直到再次被调用,这样会多出很多调度带来的开销。而协程会一直运行,直到遇到让步事件才切换,因此协程调度的次数会比线程少很多。同时可以看出,协程的何时调度由开发者指定(比如上面所说的等待数据库返回事件),而且是非抢占式的。这意味着某个协程在运行时,其他协程是无法运行的,只能等到运行的协程交出执行权。因此,开发者要确保不能让任务在CPU上停留太长时间,否则剩余的任务就会饿死。
3.总结
在IO场景下,IO的开销比CPU执行代码逻辑外的开销大得多。从这里也可以换个角度思考:在遇到IO开销时,代码逻辑需要进行等待,而CPU是空闲的,于是通过协程/线程的方式对CPU进行多路复用,以压榨CPU性能。假设sync语法和async语法执行的代码逻辑是一样的,那么它们执行速度快慢的对比可以转换为协程与多进程/线程的开销对比,也就是协程事件循环调度开销与多进程/线程的调度开销逻辑对比。而事件循环调度的开销基本不变(或变化不大),多进程/线程的开销除了比事件循环调度的开销大外,还会随着worker量的增多而变大。当并发量高到一定程度时,多进程/多线程的开销会大于协程切换的开销,这时async语法的执行速度就会快于sync语法。所以在普通场景下,sync语法的执行速度会快于async语法的执行速度,但在IO计算大于CPU计算且高并发场景下时,async语法的执行速度会比sync语法速度还快。
到此这篇关于详解Python中Sync与Async执行速度快慢对比的文章就介绍到这了,更多相关Python Sync Async内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









