

Python模型保存与加载指南:Pickle、Joblib与ONNX格式详解
深入详解Python机器学习与深度学习模型保存与加载的三种主流格式:内置Pickle、科学计算优化的Joblib以及跨语言跨平台的ONNX格式。分析其核心原理、代码实现、安全性考量与生产选型决策。
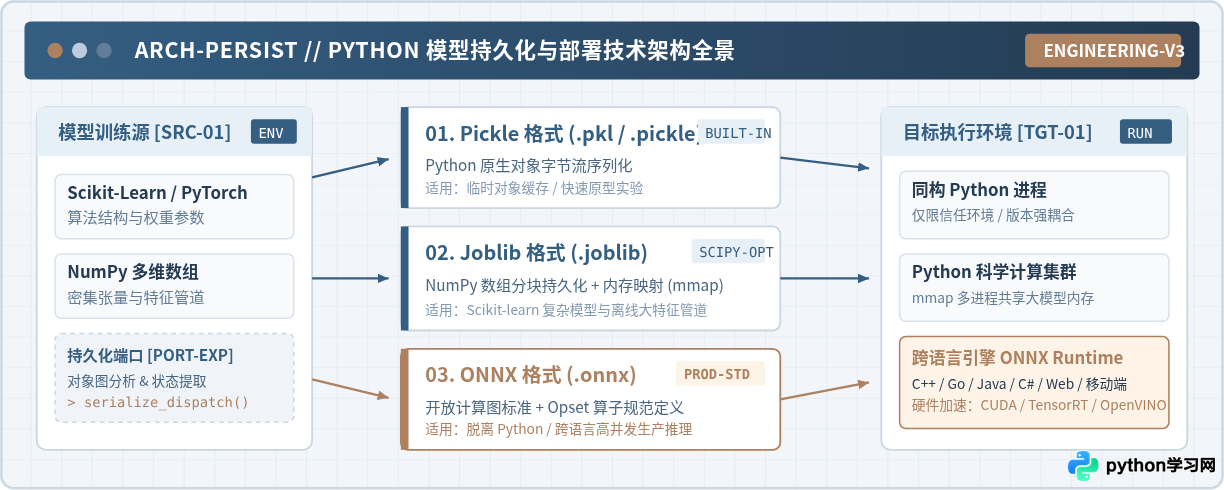
在 Python 机器学习与深度学习开发中,模型训练通常需要消耗大量的计算资源与时间。将拟合完成的估计器或网络权重持久化存储到磁盘,并在后续离线推断或在线预测服务中无损恢复,是算法由原型走向生产的关键一环。不同持久化格式在底层工作原理、序列化粒度、内存消耗与运行安全上存在本质区别:标准库内置的 Pickle 适用于快速原型与通用 Python 对象缓存;经 Scipy 优化的 Joblib 针对大型 NumPy 矩阵实现了分块存储与内存映射(mmap);而作为跨平台开放工业标准的 ONNX 则通过定义严格的计算图彻底脱离对 Python 解释器的依赖,成为高性能服务部署的首选。本文将详细讲解这三种格式的核心机制、可直接执行的代码范式与选型边界。
一、Pickle 格式:Python 原生对象序列化原理与安全边界
Pickle 是 Python 标准库自带的二进制对象序列化协议。它的核心任务是将内存中任意复杂的 Python 对象层次图(包括自定义类的实例、函数闭包、字典与循环引用关系)转换为一系列虚拟机指令字节流,保存到文件或在进程间传输,加载时再逐条回放这些指令以在内存中重新构建对象。
1. 标准保存与加载操作
使用 Pickle 保存与加载 Scikit-learn 模型非常直接。需要特别注意:在打开文件时必须使用二进制读写模式("wb" 与 "rb"),且推荐显式指定较高版本的序列化协议(例如 protocol=pickle.HIGHEST_PROTOCOL 或 protocol=5)。
import pickle
import numpy as np
from sklearn.linear_model import LogisticRegression

# 1. 准备训练数据并训练逻辑回归模型
X_train = np.array([[1.0, 2.0], [2.0, 3.0], [3.0, 4.0], [5.0, 6.0]], dtype=np.float32)
y_train = np.array([0, 0, 1, 1], dtype=np.int32)

clf = LogisticRegression()
clf.fit(X_train, y_train)

# 2. 将模型持久化到本地文件
model_path = "logistic_model.pkl"
with open(model_path, "wb") as f:
    pickle.dump(clf, f, protocol=pickle.HIGHEST_PROTOCOL)

# 3. 从磁盘重新加载模型并执行验证推断
with open(model_path, "rb") as f:
    loaded_clf = pickle.load(f)

# 4. 验证预测结果一致性
X_test = np.array([[2.5, 3.5]], dtype=np.float32)
original_pred = clf.predict_proba(X_test)
loaded_pred = loaded_clf.predict_proba(X_test)
assert np.allclose(original_pred, loaded_pred), "模型预测结果不一致!"
print("[示例输出] Pickle 加载成功,预测概率:", loaded_pred)Pickle 在反序列化时允许通过 __reduce__ 方法执行构造函数及系统调用。如果攻击者向服务接口提交精心伪造的 .pkl 恶意字节流,pickle.load() 将在服务器后台执行任意系统命令(远程代码执行 RCE)。因此,绝不能使用 Pickle 加载任何未经验证或来源不可信的外部模型文件。
2. Pickle 在生产环境中的主要瓶颈
- 代码与环境强耦合:Pickle 文件中并不存储类定义的实际源码,仅记录了模块名与类标识。如果模型反序列化时运行环境中的 Python 主版本、Scikit-learn 版本或项目代码目录结构发生变动,极易抛出
AttributeError或ModuleNotFoundError。 - 大型数组性能劣化:Pickle 没有对多维连续内存数组做特殊优化。在保存包含上千万参数的大型集成树或权重矩阵时,它会将数组逐项转换为通用对象流,导致磁盘文件膨胀且反序列化时内存开销翻倍。
二、Joblib 格式:科学计算与大阵列的高效持久化
Joblib 是一套专为 Python 科学计算设计的高效持久化工具包,也是 Scikit-learn 官方长期推荐的默认序列化方式。它在内部继承并扩展了 Pickle 机制,但重构了对大型 NumPy 连续多维数组(np.ndarray)的处理管道。
1. 为什么 Joblib 适合 Scikit-learn 模型
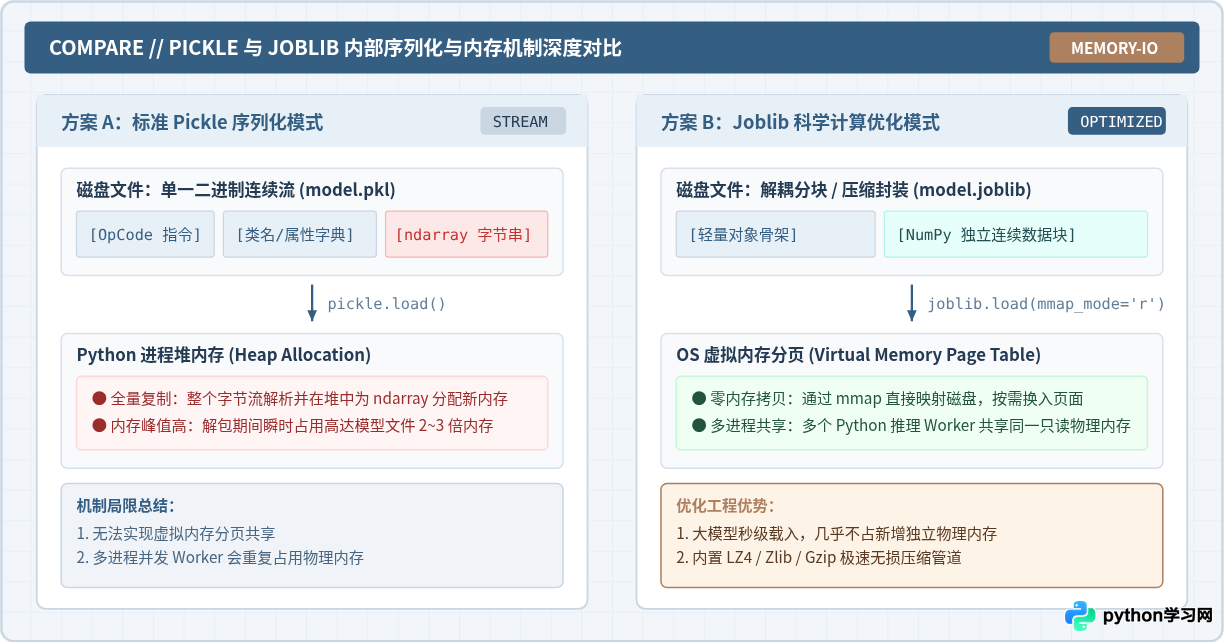
Scikit-learn 的估计器(如随机森林、梯度提升树、支持向量机和 PCA)核心属性几乎全部是 NumPy 数组。Joblib 会将 Python 对象的状态骨架与数组物理内存数据分离处理:对于大数组,Joblib 直接以原始字节块的形式高效刷盘,并支持多种高效压缩算法(如 zlib、lz4、gzip)。
更为关键的是,Joblib 提供了 mmap_mode(内存映射)参数。在多进程并发提供预测服务时(例如使用 Gunicorn 或 Celery 启动多个 Worker 进程),多个子进程可以通过操作系统的虚拟内存分页机制只读共享同一份位于磁盘上的模型权重,避免了每个 Worker 重复分配独立物理内存的严重浪费。
2. 典型 Pipeline 训练、压缩与内存映射加载实战
以下示例演示了构建一个包含数据标准化与随机森林分类器的完整流水线,使用 LZ4 压缩级别将其保存,并通过只读内存映射安全载入:
import joblib
import numpy as np
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier

# 1. 构建标准化与随机森林分类流水线 (Pipeline)
X = np.random.randn(1000, 10).astype(np.float32)
y = (X[:, 0] + X[:, 1] > 0).astype(np.int32)

pipeline = Pipeline([
    ("scaler", StandardScaler()),
    ("rf", RandomForestClassifier(n_estimators=50, random_state=42))
])
pipeline.fit(X, y)

# 2. 持久化存储,启用 3 级 zlib 压缩以平衡保存速度与体积
joblib_path = "model_pipeline.joblib"
joblib.dump(pipeline, joblib_path, compress=("zlib", 3))

# 3. 高并发场景下使用只读内存映射快速载入模型
# mmap_mode='r' 使得大数组直接由 OS 页表映射,无需拷贝至进程私有堆
loaded_pipeline = joblib.load(joblib_path, mmap_mode="r")

# 4. 验证推断与一致性测试
sample_input = np.random.randn(5, 10).astype(np.float32)
pred_prob = loaded_pipeline.predict_proba(sample_input)
print("[示例输出] Joblib 加载成功,五条样本推断类别:", np.argmax(pred_prob, axis=1))虽然 Joblib 在数据存储与内存利用率上远优于 Pickle,但它依然依赖 Python 运行环境与反序列化逻辑。在线下离线流水线中使用 Joblib 时,务必通过 requirements.txt 或容器镜像严格锁定 scikit-learn、joblib 以及 numpy 的小版本号,避免库版本迭代导致参数不兼容。
三、ONNX 格式:跨语言、跨平台的工业级推理标准
ONNX(Open Neural Network Exchange,开放神经网络交换格式)是由微软、Meta 等科技巨头联合推动的开放开源生态标准。不同于将代码对象结构转存为字节码,ONNX 将机器学习与深度学习模型抽象为一张声明式、强类型的静态数据流计算图(Dataflow Graph)。
在 ONNX 计算图中,节点表示具有数学定义的标准化算子(如矩阵乘法 MatMul、激活函数 Relu、归一化 BatchNormalization),边则代表有向流动的张量(Tensor)。整个模型被序列化为标准的 Protocol Buffers(.proto)二进制文件,彻底切断了与 Python 解释器或特定训练框架的纽带。
1. 为什么 ONNX 是生产部署的终极选择
- 零 Python 依赖与容器瘦身:在线推理服务仅需要链接超轻量级的
onnxruntime动态库,无需在生产服务器上安装几十个 GB 的 Python 科学计算依赖(如 PyTorch、CUDA Toolkit、Scikit-learn、SciPy),容器镜像体积可由数个 G 缩减至百兆以内。 - 多语言原生支持:生成的
.onnx文件可以直接在 C++、Go、Java、Rust、C# 甚至前端浏览器(WebAssembly / WebGPU)中原生加载运行。 - 极高执行效率与硬件加速:ONNX Runtime 内置了图融合(Operator Fusion)、常量折叠(Constant Folding)与内存复用等高级优化,并无缝适配 CUDA、TensorRT、DirectML、OpenVINO 等底层加速硬件。
- 极高的运行时安全性:ONNX 是纯粹的数据结构和算子连接关系,不包含任何可执行代码逻辑,从根本上杜绝了 Pickle 类的代码注入与反序列化漏洞。
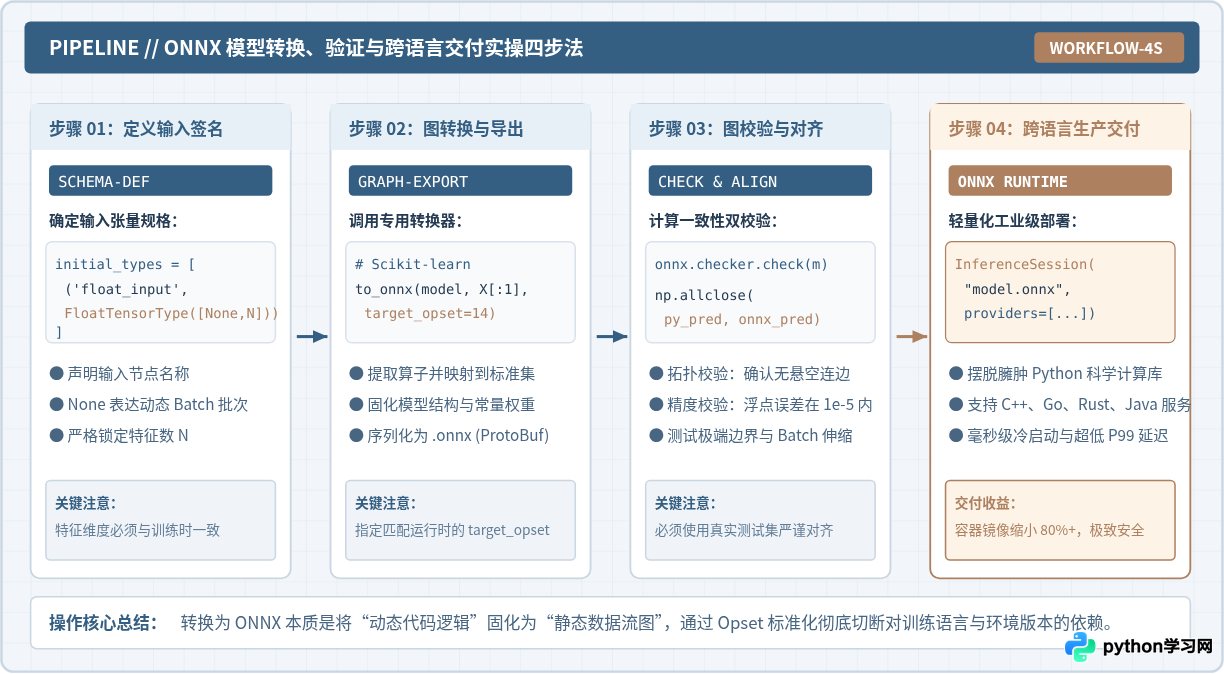
2. Scikit-learn 模型转 ONNX 与 ONNX Runtime 推理全流程
在 Python 中将 Scikit-learn 模型转换为 ONNX,需要使用官方推荐的 skl2onnx 工具包。关键前置步骤是声明模型输入的类型和张量维度(initial_types)。以下是完整的端到端转换与推断比对代码:
import numpy as np
import onnx
import onnxruntime as rt
from skl2onnx import to_onnx
from skl2onnx.common.data_types import FloatTensorType
from sklearn.datasets import load_iris
from sklearn.ensemble import GradientBoostingClassifier

# 1. 准备数据并训练一个梯度提升分类器
iris = load_iris()
X = iris.data.astype(np.float32)
y = iris.target.astype(np.int32)

model = GradientBoostingClassifier(n_estimators=30, random_state=42)
model.fit(X, y)

# 2. 导出为 ONNX 格式
# initial_types 指定输入节点格式:None 代表动态 batch 大小,4 代表特征列数
initial_type = [('float_input', FloatTensorType([None, 4]))]
onnx_model = to_onnx(model, initial_types=initial_type, target_opset=14)

onnx_path = "gbdt_iris.onnx"
with open(onnx_path, "wb") as f:
    f.write(onnx_model.SerializeToString())

# 3. 校验 ONNX 模型的计算图拓扑结构
onnx.checker.check_model(onnx_model)
print("[状态] ONNX 拓扑检查通过,计算图已成功固化!")

# 4. 使用 ONNX Runtime 执行跨语言高性能推理 (可在无 sklearn 的环境中独立运行)
sess = rt.InferenceSession(onnx_path, providers=["CPUExecutionProvider"])
input_name = sess.get_inputs()[0].name
label_name = sess.get_outputs()[0].name
prob_name = sess.get_outputs()[1].name

# 准备测试样本 (batch_size=2)
test_samples = np.array([
    [5.1, 3.5, 1.4, 0.2],
    [6.7, 3.0, 5.2, 2.3]
], dtype=np.float32)

# 执行推理
onnx_outputs = sess.run([label_name, prob_name], {input_name: test_samples})
onnx_labels, onnx_probs = onnx_outputs[0], onnx_outputs[1]

# 5. 数值一致性对齐验证
py_labels = model.predict(test_samples)
assert np.array_equal(onnx_labels, py_labels), "类别输出不匹配!"
print("[示例输出] ONNX 推断分类结果:", onnx_labels)
print("[示例输出] ONNX 类别概率字典序列:", onnx_probs)
3. 深度学习(PyTorch)转 ONNX 导出简述
如果是 PyTorch 深度学习模型,PyTorch 原生内置了 torch.onnx.export 函数。通过传入一个虚拟样例张量(dummy input),跟踪(Tracing)或脚本化(Scripting)网络的前向计算流程即可输出 ONNX 文件:
import torch
import torch.nn as nn

class SimpleMLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(16, 64),
            nn.ReLU(),
            nn.Linear(64, 2)
        )
    def forward(self, x):
        return self.net(x)

mlp = SimpleMLP().eval()
dummy_input = torch.randn(1, 16, requires_grad=False)

torch.onnx.export(
    mlp,
    dummy_input,
    "simple_mlp.onnx",
    export_params=True,
    opset_version=14,
    do_constant_folding=True,
    input_names=["input"],
    output_names=["output"],
    dynamic_axes={"input": {0: "batch_size"}, "output": {0: "batch_size"}}
)
print("[状态] PyTorch 模型成功导出为 ONNX 格式。")
四、技术选型决策与全景维度对比
面对具体的工程落地需求,如何权衡这三种格式?下面的选型推导图清晰梳理了从训练完成到持久化格式选择的核心判断路径:
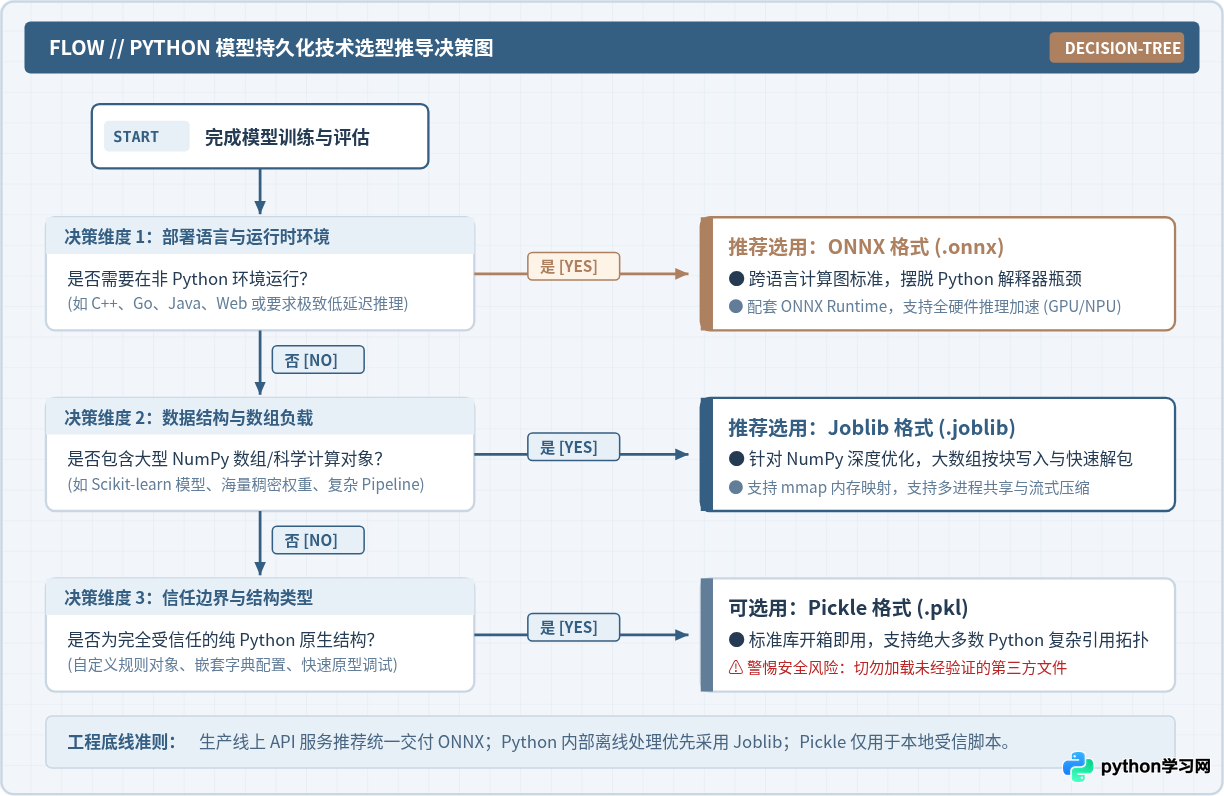
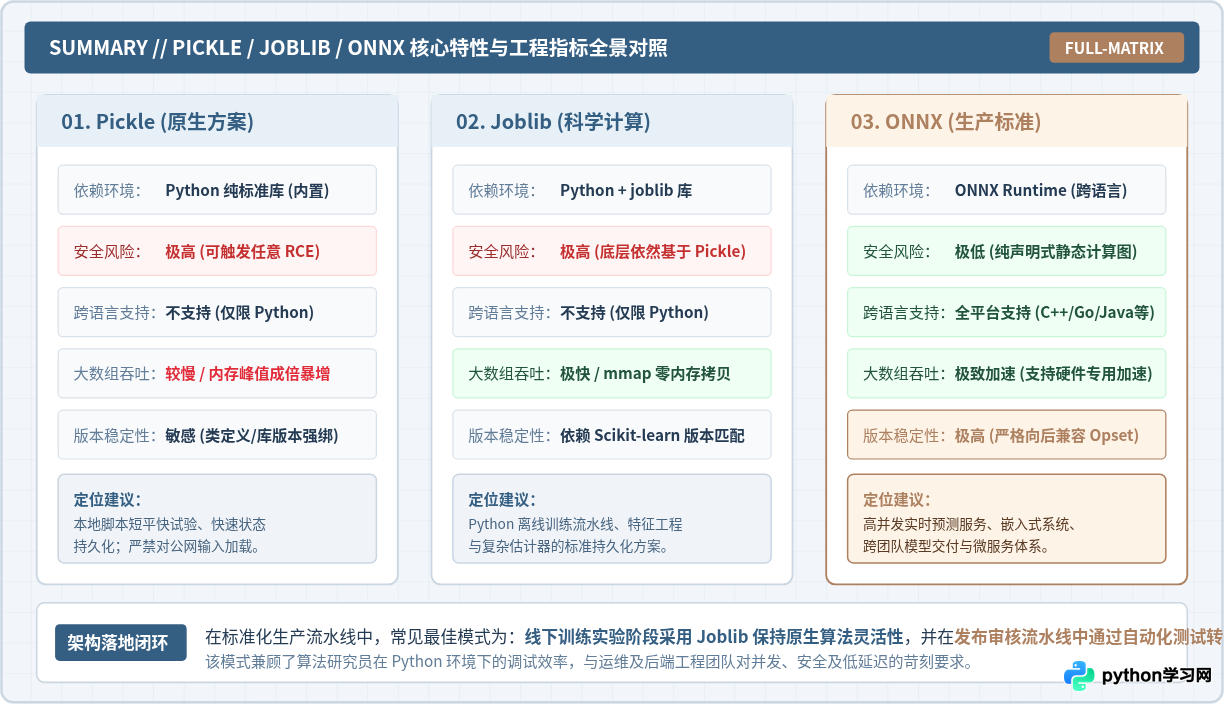
为了进一步明确工程指标差异,以下表格对三种格式的关键特性进行了系统横向对比:
| 核心维度 | Pickle (.pkl) | Joblib (.joblib) | ONNX (.onnx) |
|---|---|---|---|
| 标准归属与依赖 | Python 核心标准库内置,零第三方依赖 | 第三方库 (pip install joblib) |
Linux 基金会开放标准,依赖 onnxruntime |
| 数据存储模式 | 单一连续二进制字节码指令流 | 对象结构与 NumPy 数组分块存储,可压缩 | Protocol Buffers 强类型静态计算图与常量参数 |
| 反序列化安全性 | 高危(存在任意代码执行漏洞) | 高危(底层依然为 Pickle 封装) | 极高(纯图结构描述,无代码注入风险) |
| 大数组加载性能 | 较差,全量深拷贝,内存峰值翻倍 | 极高,支持 mmap 零拷贝内存映射 |
极致,支持显存复用与算子级并行计算优化 |
| 跨语言跨平台能力 | 无(完全锁定在 Python 解释器内) | 无(完全锁定在 Python 解释器内) | 全支持(C++、Go、Java、C#、Web、iOS/Android) |
| 版本兼容性 | 脆弱,强绑定 Python 及算法库小版本 | 较脆弱,依赖 Scikit-learn 版本对齐 | 极强,严格遵循 Opset 规范向后兼容 |
| 最佳应用阶段 | 本地快速脚本验证、临时配置状态快照 | Python 离线训练流水线、特征工程与中间模型 | 高并发在线预测、微服务集群、嵌入式端侧推理 |
五、生产落地的最佳实践建议
结合企业级算法工程的落地实践,模型生命周期的最佳持久化流转路径可以归纳为两句话:
- 研发实验在 Python,持久化用 Joblib:在探索性数据分析、特征预处理流水线构建以及超参数网格搜索过程中,统一使用
joblib.dump()保存中间模型。这样既能保留全部 Python 对象的灵活调试接口,又能借助分块压缩与mmap特性避免大数组内存溢出。 - 生产交付脱离 Python,统一上线用 ONNX:在模型定型准备交付给线上实时 API 或微服务网关时,通过自动化 CI 脚本执行
to_onnx()转换与np.allclose数值对齐测试。线上推断服务统一基于 C++ 或 Go 编写的onnxruntime引擎封装,不仅能够杜绝任意代码执行的安全隐患,更将推理延迟与资源消耗降至最低。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









