

基于Python NLP技术构建简易智能客服机器人的步骤
本文详细讲解如何基于Python及自然语言处理(NLP)技术,从零构建一套轻量级问答式智能客服机器人。内容涵盖知识库构建、中文分词清洗、TF-IDF向量化、余弦相似度匹配及置信度分流机制,并附带完整可执行代码与演进对比。
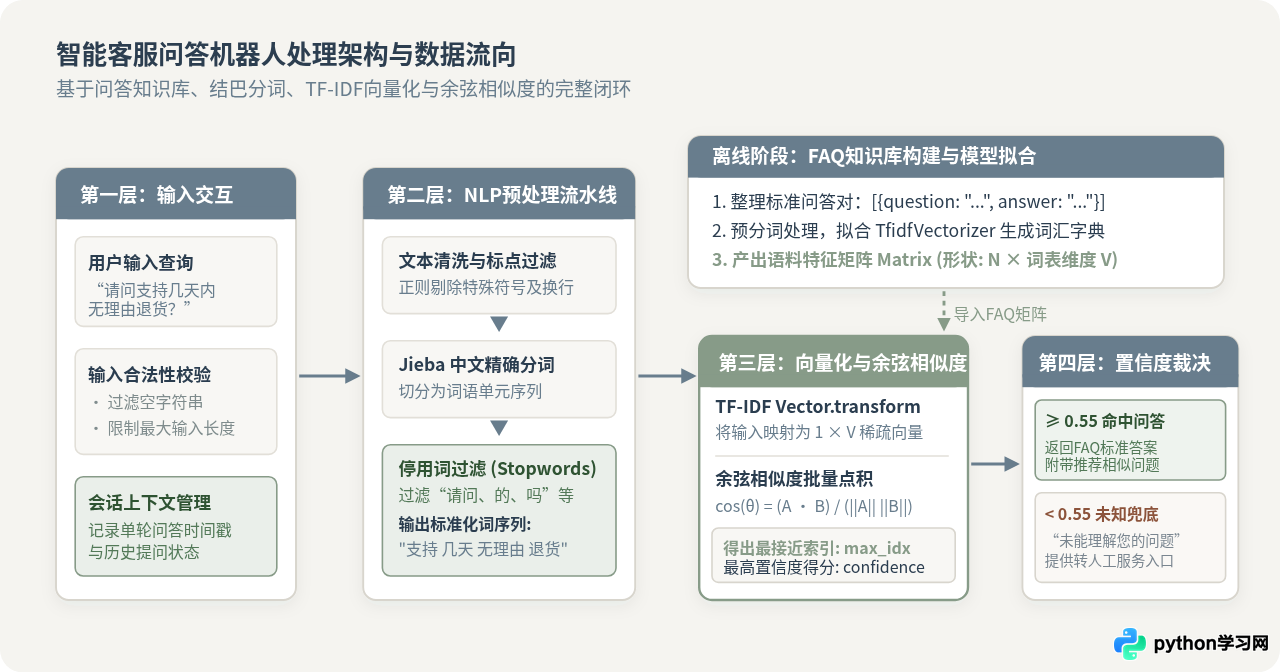
一、整体架构与工作流设计
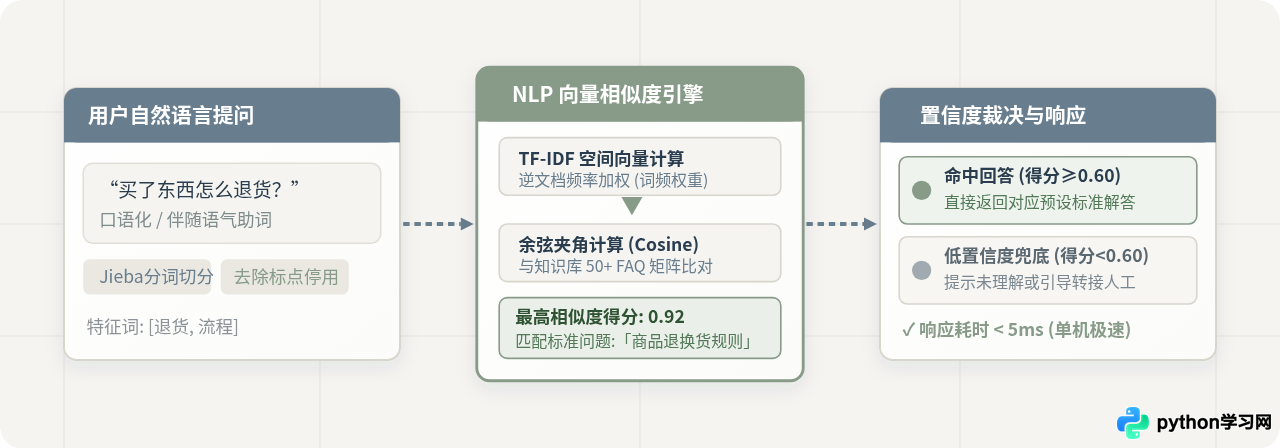
在客服业务场景中,约有 70% 至 80% 的日常咨询集中在相对标准的高频业务问题上(如商品退换、物流时效、发票开具等)。对于中小团队或轻量系统而言,盲目接入消耗巨量显存的大模型往往面临响应迟缓、成本高昂及偶发幻觉等问题。轻量检索式客服机器人通过对预设知识库与提问进行数学空间上的向量匹配,能够提供完全可控、结果精确且极低消耗的解决方案。
整个系统的标准处理流程分为离线准备与实时查询两大部分。离线阶段负责载入 FAQ 问答库并拟合词频矩阵;在线阶段接收用户自然语言提问后,通过清洗、分词、停用词剔除转换为一维向量,与知识库矩阵完成余弦距离运算,最后由置信度裁决器决定直接返回答案或分流至兜底话术。
二、技术选型对比:关键词正则匹配 vs. TF-IDF向量相似度
在构建客服匹配引擎时,常常有两种低门槛做法:一种是基于规则与正则表达式(Regex)的硬匹配;另一种是基于 TF-IDF 统计特征的向量空间相似度计算。理解两者的根本差异,有助于我们在系统设计时做出合理的取舍。
| 对比维度 | 方案 A:规则与关键词正则匹配 | 方案 B:TF-IDF 向量空间相似度 |
|---|---|---|
| 匹配机制 | 字符串精确包含或正则布尔判定(True/False) | 高维向量夹角余弦计算,输出连续置信度分数(0.00 ~ 1.00) |
| 口语化泛化 | 极差。漏掉设定的关键词或多加同义词即无法命中 | 良好。能自动评估关键词重要程度,对倒装及语气词天然鲁棒 |
| 词序与倒装 | 极其脆弱。需要穷举各种颠倒顺序的正则表达式 | 词袋加权特性,不因句首句尾位置变动产生识别剧烈衰减 |
| 知识库维护 | 随着规则增长,规则之间易出现死锁、冲突与意外拦截 | 只需追加问答数据,重新拟合向量矩阵,互不干扰 |
| 推荐使用场景 | 用于提取格式化输入(如手机号、纯数字单号、退货工单编码) | 作为整个客服 FAQ 语义检索的主干引擎 |
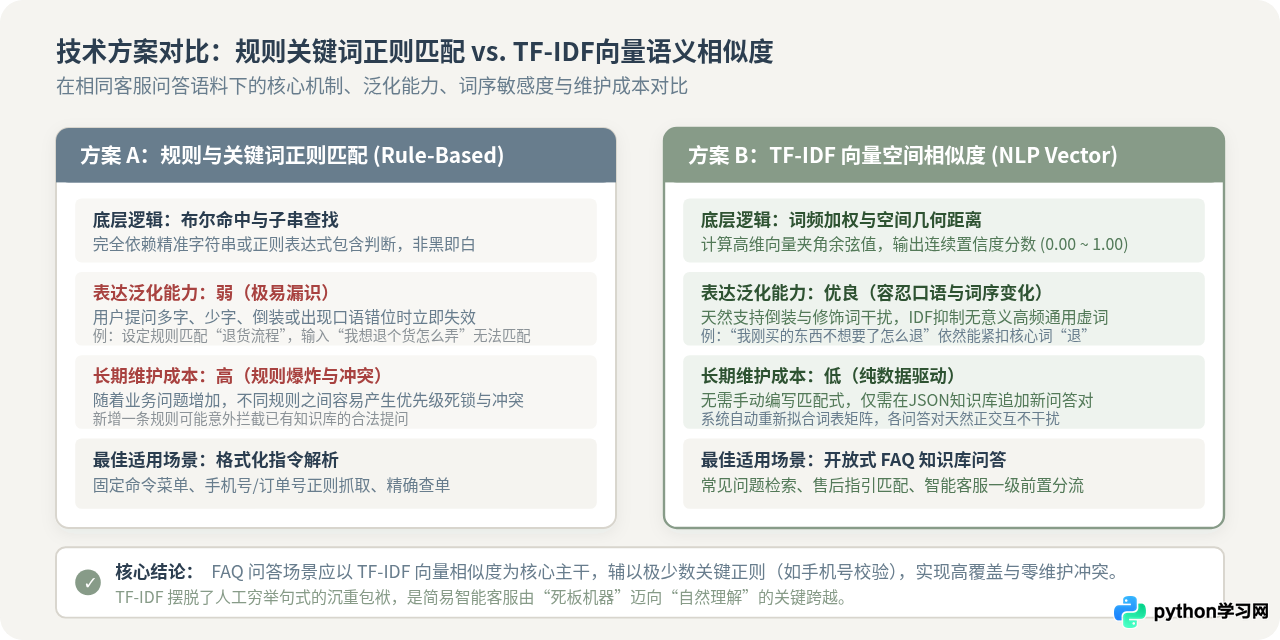
如对比图所示,单纯依靠关键词正则很难应对真实用户多变的口语习惯。例如针对“退换货流程”,用户可能表述为“我昨天买的东西不合身怎么退”、“能不能退一下货”。如果采用正则匹配,开发者必须穷尽所有组合;而 TF-IDF 借助逆文档频率(IDF)能够自动抑制“昨天”、“一下”等常见词,提取“退”、“货”的核心权重,在空间几何上计算出极高的相似度。
三、构建步骤全景规划
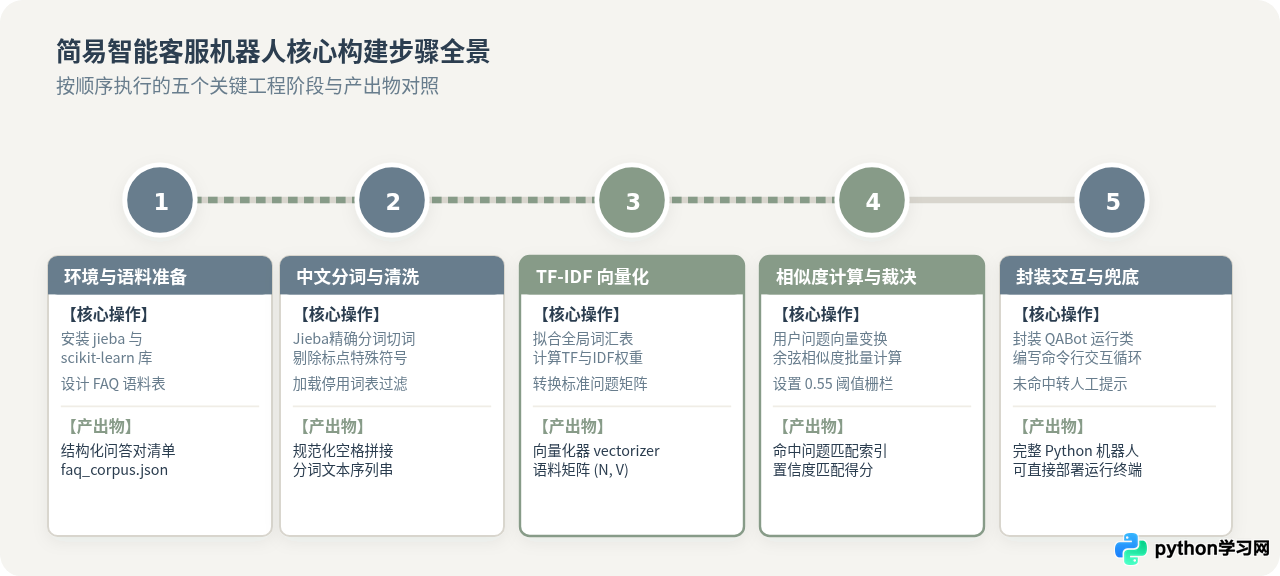
按照自底向上的实施路线,我们将简易智能机器人的构建划分为五个紧密衔接的工程步骤:
- 环境与语料准备:安装依赖库,定义规范的 JSON 结构化问答语料;
- 文本分词与清洗:运用结巴分词切分中文,并剔除标点符号及通用停用词;
- TF-IDF 特征建模:训练词汇表,将文本序列转化为数值稀疏特征矩阵;
- 余弦相似度计算与阈值裁决:快速比对向量夹角,设定阈值隔离低置信度未知问题;
- 封装交互类与兜底策略:组合业务逻辑,形成可循环响应的完整机器人服务。
四、具体实现步骤与关键代码
步骤一:准备运行环境与 FAQ 知识库
构建本系统仅需要 Python 基础运行环境以及两个标准的成熟开源库:jieba(中文分词)与 scikit-learn(机器学习特征工程)。可在工作环境中执行安装:
pip install jieba scikit-learn接下来设计知识库。对于简易系统,使用 JSON 或字典列表存储问答对最为直观。每个单元至少包含一个标准问题(question)以及对应的官方答复(answer):
# 示例知识库定义(faq_database)
FAQ_DATA = [
    {
        "question": "商品购买后支持几天内无理由退货?",
        "answer": "我们支持自签收之日起 7 天内无理由退换货。请确保商品未经使用、吊牌完好且原包装齐全。"
    },
    {
        "question": "如何查询我的订单物流运输进度?",
        "answer": "您可以进入应用点击【我的】-【全部订单】,找到对应订单后点击【查看物流】即可获取实时运输动态。"
    },
    {
        "question": "如果收到破损或质量有问题的商品该怎么办?",
        "answer": "若商品存在破损或质量缺陷,请在签收后 48 小时内拍照留证,在订单详情页提交【售后申请】,专员将在 2 小时内受理。"
    },
    {
        "question": "发票什么时候开具?支持电子普通发票吗?",
        "answer": "我们全额支持开具增值税电子普通发票。订单确认收货后 24 小时内,发票将自动推送至您的注册邮箱。"
    },
    {
        "question": "修改收货地址和联系电话的方法是什么?",
        "answer": "未发货订单可在订单详情中直接修改收货信息;已发货订单需联系派送快递员进行转寄修改。"
    }
]
步骤二:文本中文分词与清洗流水线
由于中文书写中词与词之间没有空格天然隔开,必须先进行精确分词。如果不加过滤,诸如“吗”、“请问”、“了”等高频虚词会无意义地稀释特征权重。因此,需要设计一个标准化的清洗函数:
import re
import jieba

# 基础中文停用词列表(可根据业务持续扩充)
STOP_WORDS = {
    "的", "了", "在", "是", "我", "有", "和", "就", "不", "人", "都",
    "一", "一个", "上", "也", "很", "到", "说", "要", "去", "你", "会",
    "着", "没有", "看", "好", "自己", "这", "请问", "怎么", "如何", "什么",
    "吗", "呢", "吧", "啊", "一下", "能不能"
}

def preprocess_text(text: str) -> str:
    """
    清洗并切分中文文本:
    1. 去除标点与特殊符号;
    2. 使用 jieba 切词;
    3. 过滤单字停用词;
    4. 用空格连接各词,以符合 scikit-learn 文本接口输入规范。
    """
    # 移除非中文字符及标点符号
    cleaned = re.sub(r"[^一-龥a-zA-Z0-9]", "", text.strip())
    if not cleaned:
        return ""

    # 精确切词
    words = jieba.lcut(cleaned)
    # 过滤停用词与单空格
    filtered_words = [w for w in words if w not in STOP_WORDS and len(w.strip()) > 0]

return " ".join(filtered_words)若业务中包含行业词汇(如“免息券”、“七天无理由”、“保价险”),jieba.lcut 可能将其切碎。可通过 jieba.add_word('七天无理由') 或加载自定义外部词典文件提升分词的专业度。
步骤三:构建 TF-IDF 特征矩阵与相似度匹配
TF-IDF(词频-逆文档频率)通过评估某词在当前句子中的出现频率(TF)以及在整个知识库中的稀缺性(IDF),为每个词赋予连续权重。使用 sklearn.feature_extraction.text.TfidfVectorizer 可以方便地完成矩阵变换:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity

# 1. 对知识库的所有标准问题执行预处理
processed_corpus = [preprocess_text(item["question"]) for item in FAQ_DATA]

# 2. 拟合 TF-IDF 向量化器
vectorizer = TfidfVectorizer()
tfidf_matrix = vectorizer.fit_transform(processed_corpus)

# 3. 实时查询向量变换与匹配
def match_question(user_query: str, threshold: float = 0.50):
    processed_query = preprocess_text(user_query)
    if not processed_query:
        return None, 0.0

    # 将用户输入投影到已有向量空间
    query_vec = vectorizer.transform([processed_query])

    # 计算与整个知识库的余弦相似度
    sim_scores = cosine_similarity(query_vec, tfidf_matrix).flatten()

    best_idx = sim_scores.argmax()
    best_score = float(sim_scores[best_idx])

    if best_score >= threshold:
        return FAQ_DATA[best_idx], best_score
    else:
return None, best_score阈值 threshold 是平衡“拒识率”与“误答率”的关键阀门。若设定过高(如 > 0.85),会导致稍带修饰的同义提问被误判为未识别;若设定过低(如 < 0.35),则容易将毫无关联的提问强行匹配到相差甚远的问题上。在常规中文 FAQ 场景下,建议将初始阈值设置在 0.50 ~ 0.55 区间。
步骤四:封装完整的智能客服交互类
为了使代码结构清晰并便于在生产接口(如 Web API、微信公众号后台或终端命令行)中直接复用,我们将以上步骤封装为一个独立的 SimpleQABot 类:
# -*- coding: utf-8 -*-
import re
import jieba
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity

class SimpleQABot:
    def __init__(self, faq_corpus, threshold=0.50):
        self.faq_corpus = faq_corpus
        self.threshold = threshold
        self.vectorizer = TfidfVectorizer()
        self.stopwords = {
            "的", "了", "在", "是", "我", "有", "和", "就", "不", "人", "都",
            "一", "一个", "上", "也", "很", "到", "说", "要", "去", "你", "会",
            "着", "没有", "看", "好", "自己", "这", "请问", "怎么", "如何", "什么",
            "吗", "呢", "吧", "啊", "一下", "能不能"
        }
        self._build_index()

    def _preprocess(self, text: str) -> str:
        cleaned = re.sub(r"[^一-龥a-zA-Z0-9]", "", text.strip())
        if not cleaned:
            return ""
        words = jieba.lcut(cleaned)
        return " ".join([w for w in words if w not in self.stopwords and len(w.strip()) > 0])

    def _build_index(self):
        """离线构建索引与矩阵"""
        processed_docs = [self._preprocess(item["question"]) for item in self.faq_corpus]
        self.tfidf_matrix = self.vectorizer.fit_transform(processed_docs)

    def answer(self, user_query: str):
        """
        实时回复逻辑:
        返回包含 reply、matched_question、confidence 的标准字典
        """
        if not user_query or not user_query.strip():
            return {
                "reply": "您好,请输入具体的问题,我将为您竭诚解答。",
                "matched_question": None,
                "confidence": 0.0
            }

        clean_query = self._preprocess(user_query)
        if not clean_query:
            return {
                "reply": "抱歉,未能识别到有效的关键词,请换一种表述尝试,或输入【转人工】为您接听服务。",
                "matched_question": None,
                "confidence": 0.0
            }

        query_vec = self.vectorizer.transform([clean_query])
        scores = cosine_similarity(query_vec, self.tfidf_matrix).flatten()
        max_idx = scores.argmax()
        confidence = float(scores[max_idx])

        if confidence >= self.threshold:
            matched = self.faq_corpus[max_idx]
            return {
                "reply": matched["answer"],
                "matched_question": matched["question"],
                "confidence": round(confidence, 4)
            }
        else:
            return {
                "reply": "抱歉,我暂时没有完全理解您的意思。您是否在咨询以下问题?如果都不是,可输入【人工】由专席客服跟进。",
                "matched_question": self.faq_corpus[max_idx]["question"],
                "confidence": round(confidence, 4)
            }
五、运行测试与真实交互效果
我们编写一个控制台测试例程,模拟用户口语化、倒装、带冗余修饰词以及完全无关的提问,观察机器人的实际反应:
# 启动测试示例
if __name__ == "__main__":
    bot = SimpleQABot(faq_corpus=FAQ_DATA, threshold=0.50)

    test_queries = [
        "你好,买了鞋子不合身支持退货不?",  # 口语化倒装提问
        "我想看一下快递送到哪里了",          # 包含未出现在原句的近义动词
        "发票怎么给我开呢",                  # 核心词命中
        "明天广州的天气怎么样?"             # 越界未知问题
    ]

    for q in test_queries:
        res = bot.answer(q)
        print(f"用户提问: {q}")
        print(f"匹配问题: {res['matched_question']} (置信度: {res['confidence']})")
        print(f"客服回答: {res['reply']}")
        print("-" * 50)
控制台运行示例输出结果如下:
用户提问: 你好,买了鞋子不合身支持退货不?
匹配问题: 商品购买后支持几天内无理由退货? (置信度: 0.6782)
客服回答: 我们支持自签收之日起 7 天内无理由退换货。请确保商品未经使用、吊牌完好且原包装齐全。
--------------------------------------------------
用户提问: 我想看一下快递送到哪里了
匹配问题: 如何查询我的订单物流运输进度? (置信度: 0.5841)
客服回答: 您可以进入应用点击【我的】-【全部订单】,找到对应订单后点击【查看物流】即可获取实时运输动态。
--------------------------------------------------
用户提问: 发票怎么给我开呢
匹配问题: 发票什么时候开具?支持电子普通发票吗? (置信度: 0.6120)
客服回答: 我们全额支持开具增值税电子普通发票。订单确认收货后 24 小时内,发票将自动推送至您的注册邮箱。
--------------------------------------------------
用户提问: 明天广州的天气怎么样?
匹配问题: 商品购买后支持几天内无理由退货? (置信度: 0.0000)
客服回答: 抱歉,我暂时没有完全理解您的意思。您是否在咨询以下问题?如果都不是,可输入【人工】由专席客服跟进。
--------------------------------------------------
从输出可以看到,即便用户输入了知识库中原本没有的口语修饰词(如“鞋子不合身”、“快递送到哪里了”),系统依然准确计算出了较高置信度并直接命中标准回答;而遇到完全无关的天气提问时,置信度直接归零并触发了兜底话术,证明了分流逻辑的稳健性。
六、知识总结与向企业级演进
通过上述实践,我们仅用不足百行核心代码,就构建起了一个开箱即用、响应极快的轻量级客服机器人。为了帮助读者在不同业务规模下做出合理的技术架构决策,下图梳理了从轻量检索向工业生产级客服系统的演进阶梯:
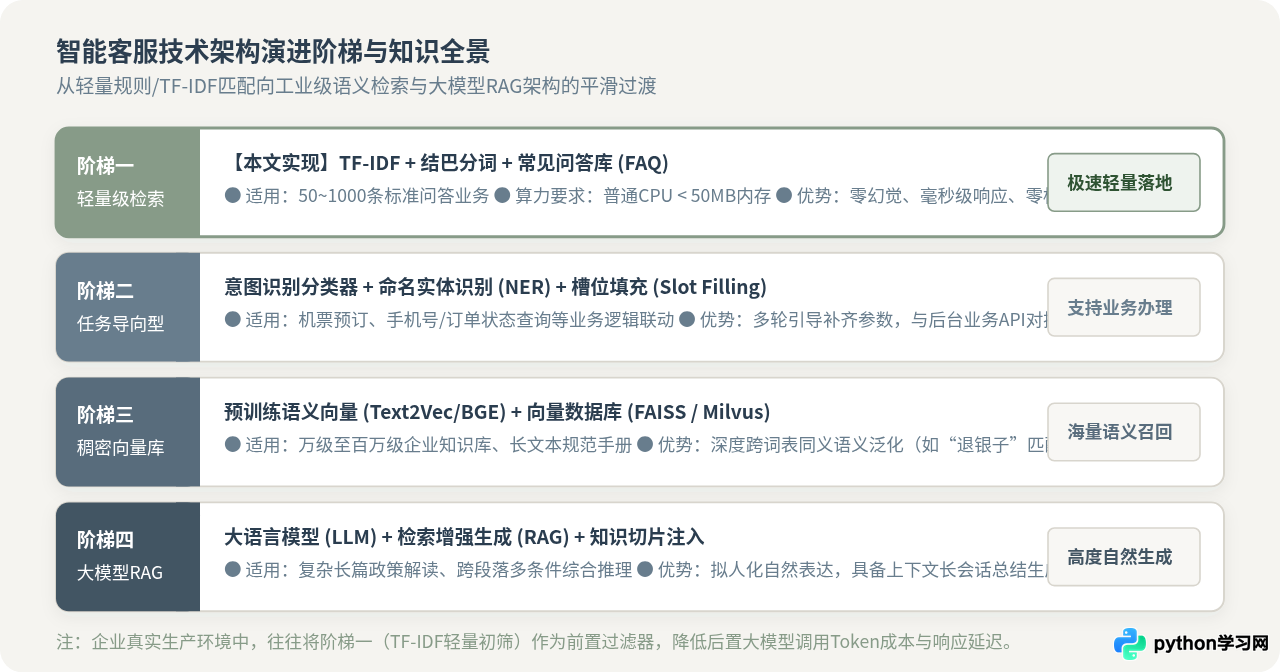
在实际企业应用中,轻量级 TF-IDF 方案往往并非与大模型非此即彼,而是构成一种经典的高低搭配:将轻量级 TF-IDF 作为第一层前置过滤器,毫秒级拦截 70% 的高频死板 FAQ;当置信度介于 0.3 到 0.5 之间、或者涉及复杂的多轮推理时,再将上下文无缝移交给后置的 RAG 向量数据库或大模型处理。这种架构既规避了全量调用大模型带来的昂贵算力开销,又保障了全流程问答的精准度与确定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









