

Python3中将普通列表转换为NumPy矩阵的方法
在Python3中将原生列表转换为NumPy矩阵的方法详解。涵盖一维与二维列表的转换、np.array与np.mat的区别、维度重塑、内存拷贝机制与常见报错避坑指南。
list)。当需要进行矩阵相乘、求逆、奇异值分解或批处理运算时,必须将这些嵌套列表转换为具备矩阵特性的 NumPy 数组结构。在 Python 3 中,标准做法是通过 numpy.array() 或 numpy.asarray() 将齐次列表转为二维 ndarray,必要时也可通过 numpy.asmatrix() 转换为专用矩阵类型。本文将逐一演示完整的转换步骤、维度控制与避坑要点。
一、为什么需要将列表转为 NumPy 矩阵
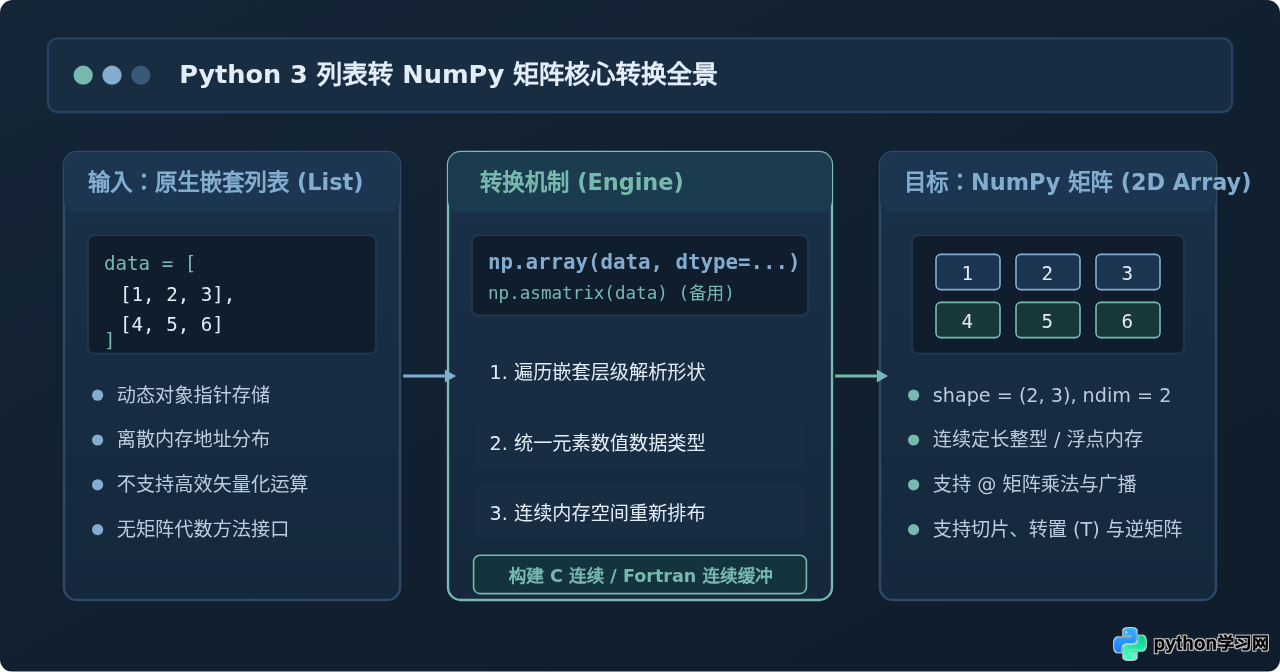
Python 内置的 list 是一种异构且动态伸缩的容器,其底层存放的是指向各个独立 Python 对象的指针。这种特性在普通编程中提供了极大的灵活性,但在数值计算场景下却存在明显的性能与功能瓶颈:
- 内存分散:列表元素的真实数值在堆内存中离散分布,无法充分利用现代 CPU 缓存行(Cache Line)预取能力。
- 缺乏代数运算支持:对原生列表执行加法操作(如
[1, 2] + [3, 4])只会拼接列表产生[1, 2, 3, 4],无法直接进行矩阵点乘、转置、行列变换等线性代数操作。 - 无严格维度约束:列表对行与列的概念没有硬性规范,嵌套层级容易混乱。
将列表转换为 NumPy 矩阵之后,数据将在连续的内存块中以固定类型(如 64 位浮点数或 32 位整型)紧密排列,不仅内存体积缩减数倍,还可以直接调用高度优化的 BLAS/LAPACK 底层数学库执行高速矢量运算。
二、标准操作步骤与核心转换流程
完成一次标准的列表到矩阵转换,通常包含四个严谨的步骤:引入依赖库、准备齐次列表、调用转换函数、以及验证矩阵的维度和数据类型。
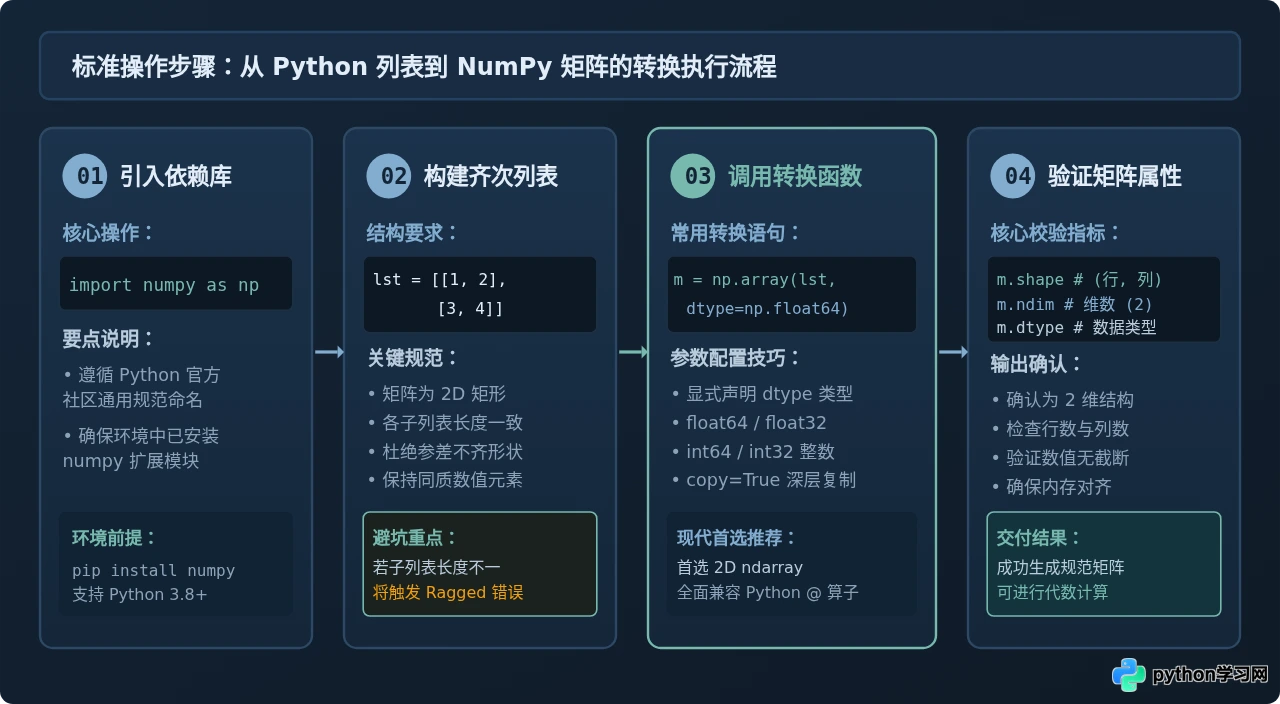
第 1 步:引入 NumPy 库
首先确保运行环境中已安装 NumPy。在 Python 脚本或交互式解释器顶部引入模块,推荐使用社区通用的别名 np:
import numpy as np第 2 步:构建齐次嵌套列表
一个合法的二维矩阵由行和列构成。在原生 Python 中,通常使用二维嵌套列表表示,其中外层列表代表行,内层列表代表各行内的列元素。为了成功构建二维矩阵,每个内层子列表包含的元素数量必须完全一致:
# 准备一个 2 行 3 列的齐次二维嵌套列表
raw_data = [
    [1.5, 2.0, 3.5],
    [4.0, 5.5, 6.0]
]
第 3 步:使用 np.array() 执行转换
调用 np.array() 是最为通用和推荐的做法。我们可以通过 dtype 参数显式指定生成矩阵的精度类型(如 np.float64、np.float32 或 np.int32):
# 将普通列表转换为标准的 2 维 NumPy 矩阵(ndarray)
matrix_a = np.array(raw_data, dtype=np.float64)
第 4 步:检查矩阵的关键属性
转换完成后,建议立即检查对象的属性,确保矩阵的形态与预期一致:
print("矩阵内容:\n", matrix_a)
print("形状 (shape):", matrix_a.shape)
print("维度数量 (ndim):", matrix_a.ndim)
print("元素类型 (dtype):", matrix_a.dtype)矩阵内容:
[[1.5 2. 3.5]
[4. 5.5 6. ]]
形状 (shape): (2, 3)
维度数量 (ndim): 2
元素类型 (dtype): float64三、深入理解:二维 ndarray 与 np.matrix 的选型区别
初学者在查阅教程或旧代码时,经常会看到 np.mat()、np.matrix() 或 np.asmatrix()。理解它们与标准 np.array() 生成的二维数组之间的区别至关重要。
1. np.matrix 子类的历史与现状
np.matrix 是 NumPy 早期为了模仿 MATLAB 语法而推出的专门针对二维矩阵的子类。使用 np.mat() 或 np.asmatrix() 能够直接将列表转为该类的实例:
# 使用 np.asmatrix 将列表转为 np.matrix 实例
mat_legacy = np.asmatrix(raw_data)
print(type(mat_legacy))
# 输出: <class 'numpy.matrix'>
2. 为什么现代 Python 3 推荐使用 2D ndarray
NumPy 官方文档已经在明确提示:不建议在新的代码中使用 np.matrix 类,未来可能会将其移除。原因如下:
- 运算符歧义的解决:在早期的 Python 中没有专用的矩阵乘法符号,
np.matrix将星号*重载为矩阵点乘,而ndarray的*则是逐元素相乘。自 Python 3.5 起,Python 引入了专用的矩阵乘法运算符@。无论操作标准二维数组还是矩阵,使用A @ B即可直观进行矩阵乘法,不再依赖np.matrix。 - 维度的统一性:
np.matrix强制限制为固定的 2 维,甚至进行单行切片时也会返回(1, N)的矩阵。这在与现代深度学习库(如 PyTorch、TensorFlow、Scikit-learn)处理三维张量或多维批次数据时极易引发类型不匹配问题。
| 特性对比项 | 标准 2D ndarray (np.array / asarray) | 专用 matrix 子类 (np.mat / asmatrix) |
|---|---|---|
| 官方推荐等级 | 现代标准推荐(长期维护) | 遗留兼容(Pending Deprecation) |
| 矩阵乘法语法 | A @ B 或 np.dot(A, B) |
A * B 或 A @ B |
| 元素级相乘 | A * B |
np.multiply(A, B) |
| 切片降维行为 | 单行切片返回 1D 数组 (N,) |
单行切片仍强制保持 2D 矩阵 (1, N) |
| 高维张量兼容 | 原生支持任意多维扩展 | 严格限制最大为 2 维 |
四、内存管理:深拷贝 (Copy) 与视图引用 (View)
在批量转换大型列表时,程序的内存占用与执行速度息息相关。了解 np.array() 与 np.asarray() 的内存行为是写出高质量代码的关键。
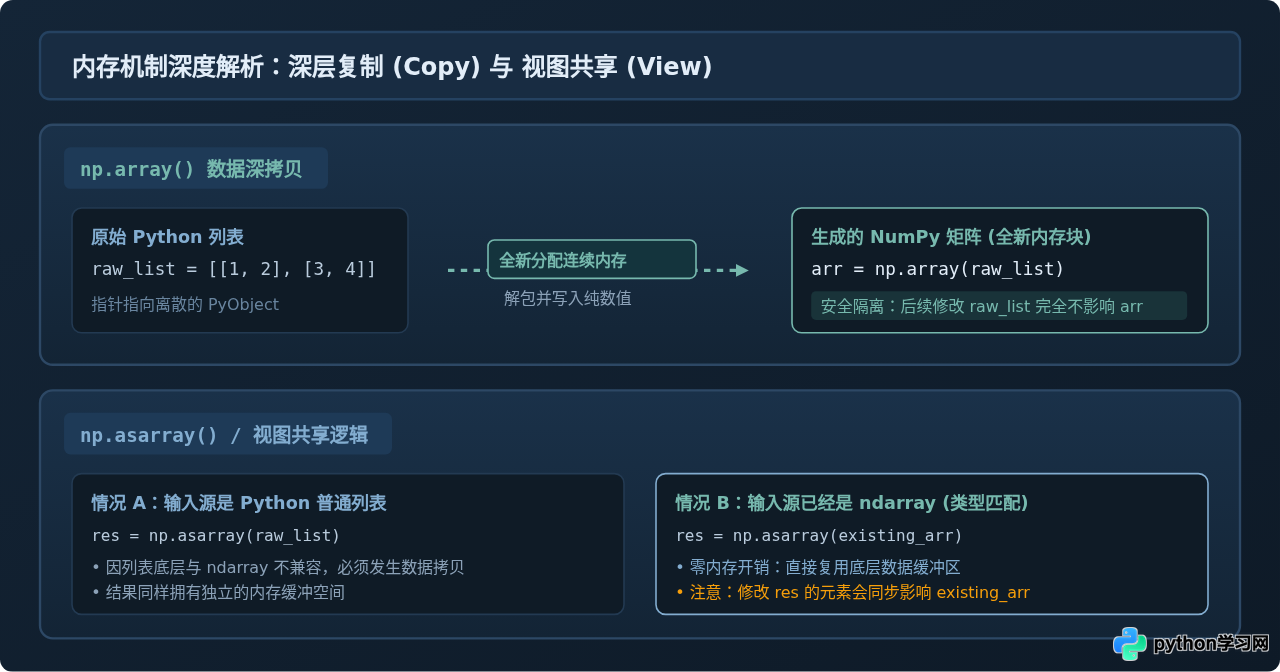
当输入的源数据是原生 Python 列表时,无论是 np.array() 还是 np.asarray(),都必须在内存中开辟一段全新的连续缓冲区,并将列表中的每个元素转换为 C 基础类型复制进去。因此,针对原生列表进行转换后,修改原始列表不会改变已生成的矩阵。
二者的核心差别体现在输入数据本身已经是数组时:
np.array(x, copy=True)始终强制重新分配一份完全相同的内存,进行物理复制。np.asarray(x)会首先探测x的类型。如果x已经是相匹配的ndarray,它将直接复用原内存指针返回视图,避免无谓的内存分配与数据搬运。
# 代码示例:验证独立内存隔离性
source_list = [10, 20, 30]
arr_copy = np.array(source_list)

# 修改原列表
source_list[0] = 999

print("原列表内容:", source_list)
print("NumPy矩阵内容:", arr_copy)原列表内容: [999, 20, 30]
NumPy矩阵内容: [10 20 30]五、一维列表转换为二维行矩阵与列矩阵
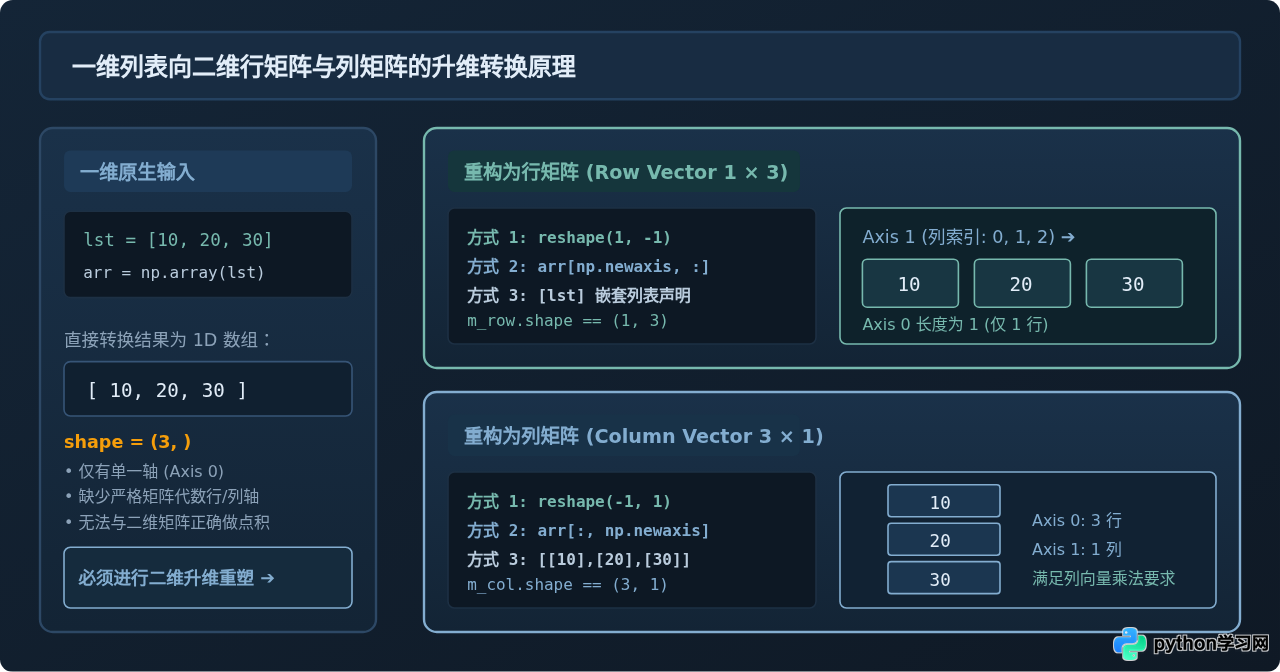
在日常场景中,我们经常遇到仅有一维的普通列表(如 [1, 2, 3])。直接对其调用 np.array([1, 2, 3]) 得到的仅仅是一个一维数组,其 shape 为 (3,)。
在线性代数理论中,参与矩阵乘法的必须是具有明确行和列的二维实体,即行向量(1 × N 矩阵)或列向量(N × 1 矩阵)。一维数组与二维矩阵在广播机制和矩阵乘法中的行为存在根本差异。
1. 构建 1 × N 的行矩阵 (Row Vector)
若需要将一维列表转换为 1 行 N 列的二维行矩阵,可使用以下三种等效方法:
vec = [10, 20, 30]

# 方法 A:在创建时直接外包一层列表括号(最直接)
row_mat_a = np.array([vec])

# 方法 B:使用 reshape(1, -1) 重塑维度(-1 表示自动推导该轴长度)
row_mat_b = np.array(vec).reshape(1, -1)

# 方法 C:使用 np.newaxis 插入新轴
row_mat_c = np.array(vec)[np.newaxis, :]

print("行矩阵形状:", row_mat_b.shape)  # 输出: (1, 3)
2. 构建 N × 1 的列矩阵 (Column Vector)
在许多线性方程组计算与特征工程中,样本特征常以列向量呈现。转换为 N 行 1 列的列矩阵同样可以通过重塑维度实现:
# 方法 A:使用 reshape(-1, 1)
col_mat_a = np.array(vec).reshape(-1, 1)

# 方法 B:使用切片与 np.newaxis
col_mat_b = np.array(vec)[:, np.newaxis]

print("列矩阵内容:\n", col_mat_a)
print("列矩阵形状:", col_mat_a.shape)列矩阵内容:
[[10]
[20]
[30]]
列矩阵形状: (3, 1)六、常见错误排查与避坑指南
在实际工程开发中,输入列表往往来源于文件解析或外部接口,可能包含不规则或混杂数据。以下梳理两个最容易引发崩溃的典型陷阱及对应解决方案。
如果二维列表各行的列数不一致,例如 [[1, 2, 3], [4, 5]],NumPy 将无法分配规整的二维矩形内存。
在现代 NumPy 版本中,尝试直接对其调用 np.array() 会抛出致命异常:
ValueError: setting an array element with a sequence.
The requested array has an inhomogeneous shape after 1 dimensions.解决办法:在转换前对列表进行对齐校验或填充(Padding),确保每行子列表具有相同的长度。
Python 列表允许同时包含整数、浮点数甚至字符串(如 [[1, 2.5], [3, "text"]])。
NumPy 必须保证底层内存数组中所有元素的数据类型完全一致。如果列表中混入了字符串,NumPy 会将整个矩阵的所有元素强制转换为 Unicode 字符串类型(如 <U32),导致所有数学运算失效。
规范写法:在调用转换时始终显式指明期望的数值类型,如 np.array(lst, dtype=np.float64)。若遇到非法字符,程序会立即在转换时显式抛出 ValueError,便于排查数据源错误,而不是将错误隐蔽传递。
七、转换方法选型决策与最佳实践总结
为了在不同业务场景中做出准确的技术选型,以下给出决策树与完整指南:
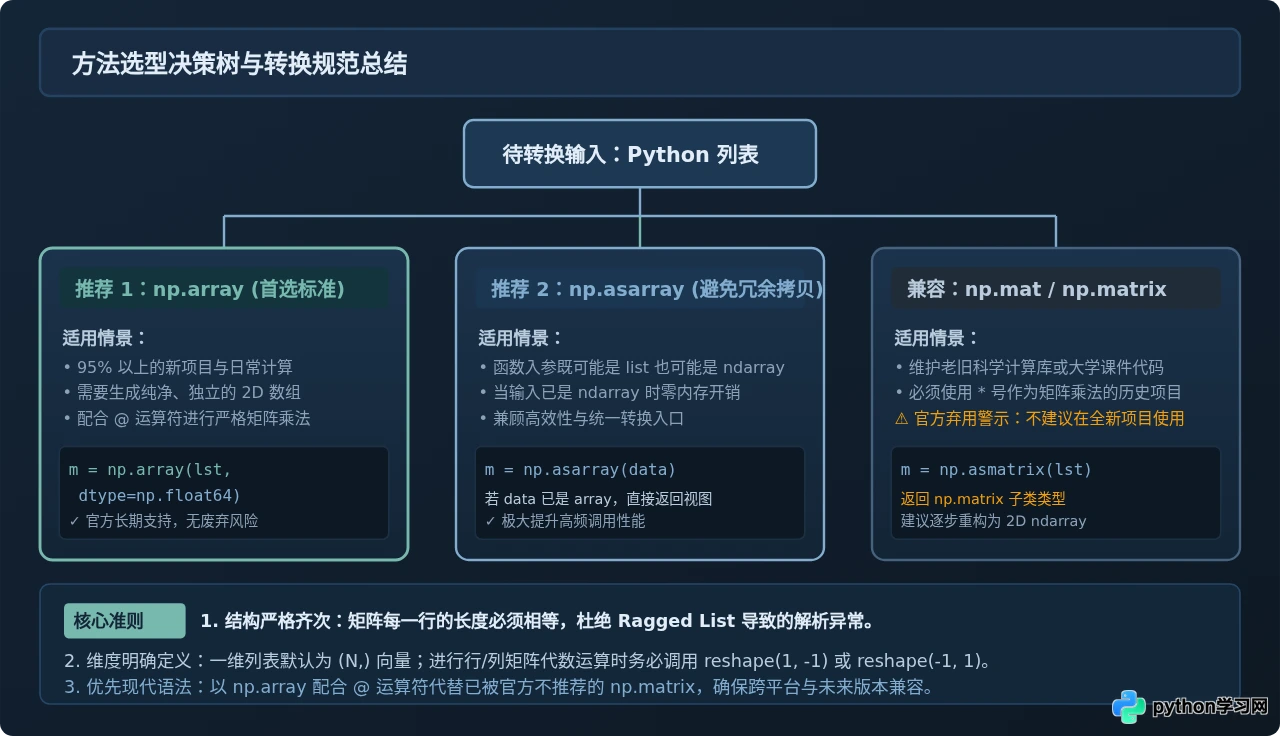
总结建议:
- 默认推荐方案:在 Python 3 中,直接使用
np.array(data, dtype=...)生成标准的二维ndarray,并通过 Python 3.5+ 提供的@运算符执行矩阵乘法。这是最符合现代规范且兼容性最好的方案。 - 防御性编程:对于一维列表输入,根据代数运算要求显式使用
.reshape(1, -1)或.reshape(-1, 1)确定行/列矩阵形态,避免隐藏的广播运算风险。 - 老旧项目兼容:仅在维护重度依赖
*乘号的遗留系统时使用np.asmatrix(),新项目应全面摒弃该类。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









