

GitHub上值得下载的Python爬虫实战源码项目
深入梳理GitHub上真正具备高实战与工程学习价值的Python爬虫开源项目,解析分布式架构、反反爬对抗机制、多平台登录逆向及数据管道部署落地的具体实操。
优秀爬虫开源项目的三项评估标准
在GitHub搜索“Python 爬虫”,可以找到成千上万个代码仓库。很多初学者习惯按照Star数量排序,但Star数往往存在“滞后性”。一些收获了上万Star的项目可能创建于六七年前,其爬取的接口早已随着目标网站全面改版而失效。盲目下载这类项目并尝试运行,只会耗费大量时间在无意义的调试报错上。
一个真正值得下载研读的爬虫源码,应当满足以下三个核心工程指标:
- 清晰的模块解耦分层:成熟的项目绝不会把网络请求、数据解析、反爬逻辑和持久化写在单个几百行的Python文件中。通常具有清晰的架构边界:Downloader负责网络调度与Session维系,Spider负责DOM/JSON解析,Pipeline负责入库校验与清洗,Middleware负责拦截请求注入代理与防封头部。
- 具备代表性的对抗机制实现:目标网站反爬越严,爬虫项目的技术含金量越高。值得下载的项目通常针对特定反爬策略给出了优雅的解决代码,例如多账号Cookie池管理、JS混淆签名动态逆向、TLS客户端指纹伪装或验证码自动化打码接入。
- 完善的异常容错与断点续爬:工业级爬虫面对的是不可预测的公共网络。优质项目会集成任务超时重试、指数退避重试、死信队列记录以及基于Redis/布隆过滤器的亿级URL去重,确保单点失败不扩散,任务重启能无缝续爬。
工程级爬虫框架与分布式标杆项目
如果目标是学习如何构建吞吐量大、稳定性高的分布式爬虫系统,应优先研究成熟的框架源码与分布式调度插件。
1. rmax/scrapy-redis:分布式爬虫队列调度标杆
Scrapy本身是基于Twisted异步事件驱动的强大爬虫框架,但原生仅支持单机运行,内存队列无法跨进程共享。scrapy-redis通过重写Scrapy的核心调度器(Scheduler)与管道(Item Pipeline),将待爬请求队列与去重指纹集合无缝迁移到了Redis中,成为了Python分布式爬虫的行业事实标准。
下载该项目源码后,重点应精读以下两个核心模块:
scheduler.py:深入理解enqueue_request与next_request方法如何基于Redis的有序集合(ZSET)实现优先级任务存取。dupefilter.py:学习如何对Request的Method、URL和Body生成SHA1指纹,并利用Redis集合或Bitmap进行高并发低内存的指纹去重。
# scrapy-redis 典型分布式配置示例 (settings.py)
SCHEDULER = "scrapy_redis.scheduler.Scheduler"
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"
SCHEDULER_PERSIST = True  # 队列任务在爬虫关闭后持久化保留

# 配置集中式 Redis 服务连接
REDIS_URL = 'redis://user:password@10.0.0.1:6379/0'
REDIS_START_URLS_AS_SET = True  # 起始URL通过Redis集合管理
2. Boris-code/feapder:现代化生产级全功能爬虫框架
与重型且基于异步Twisted底层回调的Scrapy不同,feapder是一款基于Python多线程、协程并内置分布式调度、浏览器动态渲染(Playwright集成)和企业级报警监控的国产开源框架。对于希望快速搭建生产可用爬虫集群的开发者而言,feapder的设计非常贴近现代国内互联网开发习惯。
项目源码结构清晰地分为不同层级:用于轻量抓取的AirSpider、适用于大规模分批抓取的BatchSpider以及应对海量分布式采集的TaskSpider。其内置了断点续爬、错误重试、动态Cookie维护和一键接入MySQL/Mongo存储管道,是现代爬虫工程组织架构的绝佳范例。
# feapder AirSpider 编写示例 (main.py)
import feapder

class RealWorldSpider(feapder.AirSpider):
    def start_requests(self):
        yield feapder.Request("https://api.example.com/v1/items?page=1")

    def parse(self, request, response):
        data_list = response.json.get("items", [])
        for item in data_list:
            yield feapder.Item(title=item["title"], price=item["price"])

if __name__ == "__main__":
    RealWorldSpider(thread_count=10).start()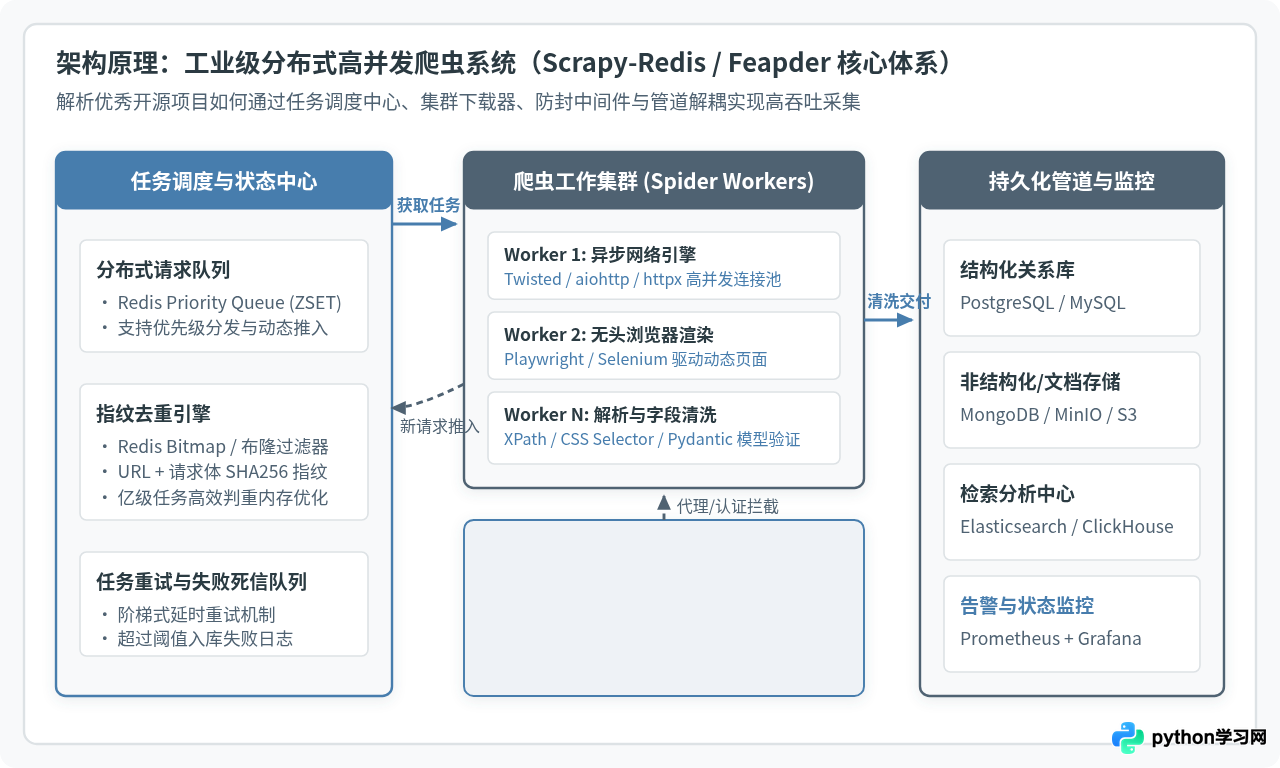
针对复杂场景的特定业务与逆向实战项目
除了通用框架,针对复杂业务网站(如社交平台、内容资讯大厂)的实战项目,能让开发者学习到具体的防风控技巧与数据清洗经验。
3. dataabc/weibo-crawler:社交平台深层遍历与Cookie维系
新浪微博历来是爬虫学习中的高频目标,其反爬规则涵盖动态Token、IP频次拦截以及复杂的时间线分页。dataabc/weibo-crawler是一个维护周期长、活跃度高的经典开源爬虫。该项目没有引入重型框架,而是使用清晰的requests结合JSON API请求构建。
通过阅读该源码,可以掌握以下关键技能:
- 手机端接口分析:Web端通常充斥着复杂的HTML混淆与广告脚本,而项目巧妙转向m.weibo.cn等移动端公开接口,直接抓取高信噪比的JSON响应,极大地提高了采集性能与稳定性。
- 健壮的异常与降速机制:源码中详细演示了当检测到频率限制或重定向时,如何通过配置休眠间隔、动态轮换请求头保证连续采集数万条博文不被封号。
4. jhao104/proxy_pool:爬虫高频访问的生命线支撑设施
商业爬虫面临的最大瓶颈通常是目标站点的单IP速率限制。没有稳定可用的代理IP池,任何大规模爬虫都会陷入瘫痪。jhao104/proxy_pool是GitHub上标杆级的开源免费代理池系统。
该项目由三个核心组件协同运作:
- ProxyGetter:定时从数十个免费代理发布渠道爬取候选IP与端口。
- ProxyValidator:利用异步协程对所有候选代理发起真实目标站点连通性测试,对超时或返回403的代理自动剔除或扣减健康分。
- Flask RESTful API:向外部爬虫提供统一的HTTP请求接口,例如通过
/get/获取当前可用权重最高的优质代理IP。
HttpError或ConnectionRefused异常时再实时调用API换IP,避免在每个解析函数中硬编码代理逻辑。
5. CharlesPikachu/DecryptLogin:多平台复杂登录与加密逆向合集
很多高质量数据必须在登录状态下才能访问。现代互联网平台在登录请求中普遍采用了RSA非对称加密、AES动态密钥混淆以及滑块拼图验证码。CharlesPikachu/DecryptLogin是一个覆盖数十个主流国内主流平台(知乎、Bilibili、网易云等)的模拟登录逆向方案库。
阅读该项目源码可以系统了解Python通过cryptography或PyExecJS执行JS解密脚本提取密码密文的完整推导过程,以及如何保存和序列化Session Cookie供后续采集任务调用。
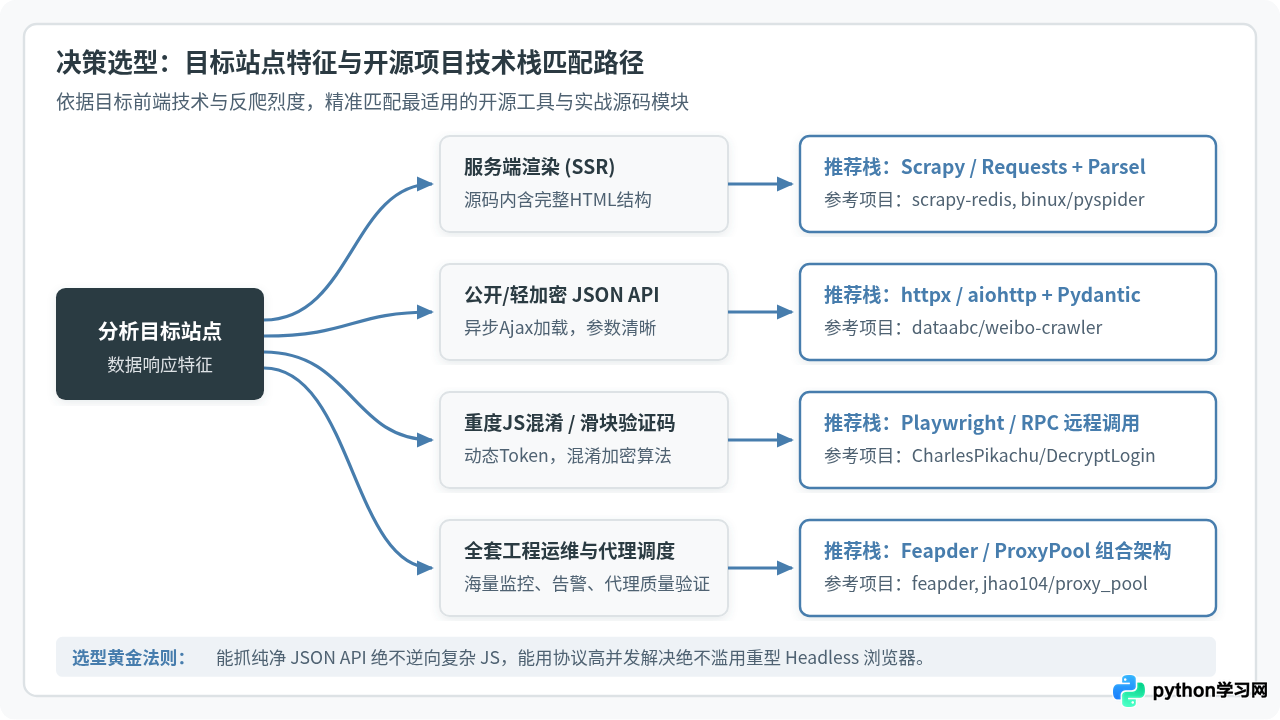
本地部署与源码调试的关键实操
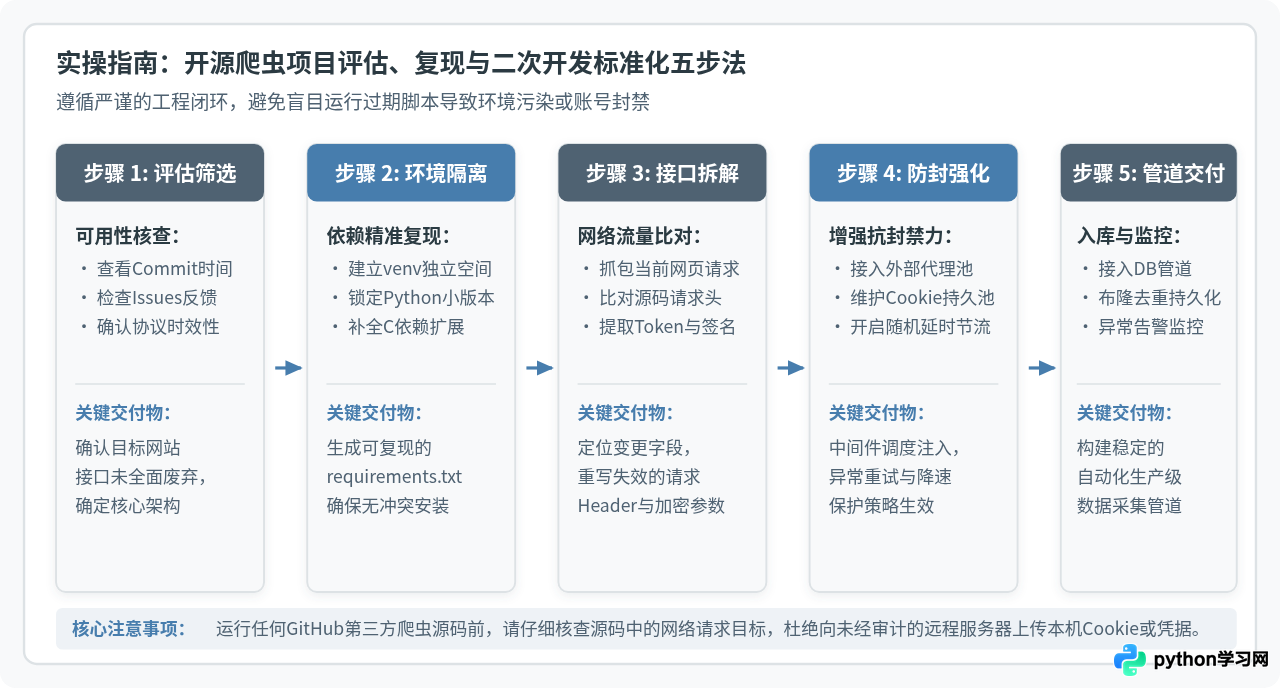
在克隆GitHub爬虫源码并尝试在本地启动时,建议严格遵循以下标准化流程,防止因本地环境不兼容或接口变动而产生排查障碍:
步骤 1:创建隔离的虚拟环境并锁定Python版本
爬虫依赖项如lxml、Scrapy和Twisted往往深度依赖底层C语言编译库。在全局Python环境中安装极易引发版本污染。必须针对每个项目创建独立的venv:
# 创建并激活专用隔离环境
python3 -m venv spider_env
source spider_env/bin/activate

# 升级基础打包工具
pip install --upgrade pip setuptools wheel

# 安装对应项目的依赖项
pip install -r requirements.txt
步骤 2:抓包校准请求头与动态签名字段
开源项目发布的请求头参数可能已经过时。在启动爬虫前,使用Chrome开发者工具(F12)打开网络面板(Network),勾选Preserve log,实际触发一次目标网页请求:
- 比对最新的
User-Agent与浏览器版本是否一致; - 检查请求头中是否新增了防爬校验字段(如
Sec-Ch-Ua、Referer防盗链或动态生成的X-Signature); - 将抓包获取的最新有效Cookie填入项目的配置文件或环境变量中,切勿将个人真实账号密码明文提交到公共Git仓库。
步骤 3:注入限速中间件与异常捕获
本地调试时,务必在配置中开启请求延时(例如Scrapy的DOWNLOAD_DELAY = 2.0),并开启随机延时(RANDOMIZE_DOWNLOAD_DELAY = True)。初次运行推荐只爬取1到2页,观察输出的Item是否完整,字段是否存在大量None或脏数据。
- 返回403 Forbidden:重点检查TLS指纹是否被识别,可尝试使用
curl_cffi或无头浏览器模拟真实浏览器握手; - 解析返回空列表:目标页面已从服务端HTML渲染改为前端客户端JS异步加载,需切换抓包定位真实的Ajax数据接口;
- 频繁连接重置(Connection Reset):单IP并发过高被目标服务器防火墙丢包,需要降低并发线程数并挂载高匿代理IP。
核心开源项目全维度评估与总结
为了更直观地协助开发者针对自身学习目标与业务场景进行技术选型,下表对本文推荐的核心GitHub开源爬虫项目进行了全维度矩阵评估:
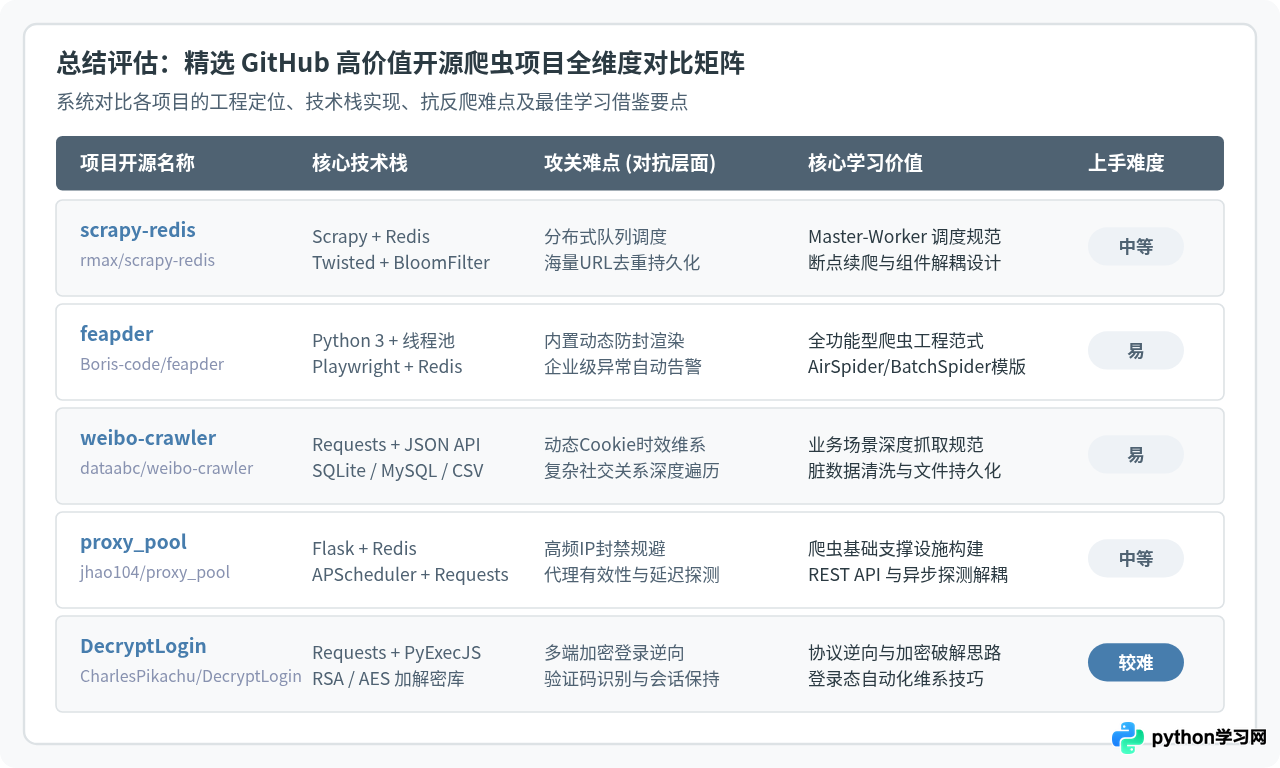
工程实践中的法律与合规防线
技术研究的边界是法律与道德底线。在下载、复现和二次开发GitHub上的爬虫实战项目时,必须时刻保持敬畏心:
- 尊重Robots协议与版权声明:不抓取明确声明禁止采集的路径,不对目标平台的商业版权内容进行非法批量转储或商业售卖;
- 严格限制并发频次:合理设置采集间隔与并发线程,爬虫请求压力不应对目标网站的正常生产服务造成性能冲击或宕机故障;
- 杜绝侵犯个人隐私:严禁利用逆向爬虫手段非法获取用户身份证号、通讯录、手机号等受法律保护的个人隐私数据。
将GitHub优秀开源项目的架构精髓、反爬策略和容错逻辑转化为自身的工程内功,才是探索爬虫技术的正确途径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









