

Python多行注释规范:PEP 8推荐的连续#号写法
深入解析 Python 官方 PEP 8 推荐的多行块注释(Block Comments)规范,系统阐明连续 # 号写法的规则细节、与三引号文档字符串的底层机制差异、现代 IDE 快捷键高效操作流程,以及工程实践中的避坑指南。
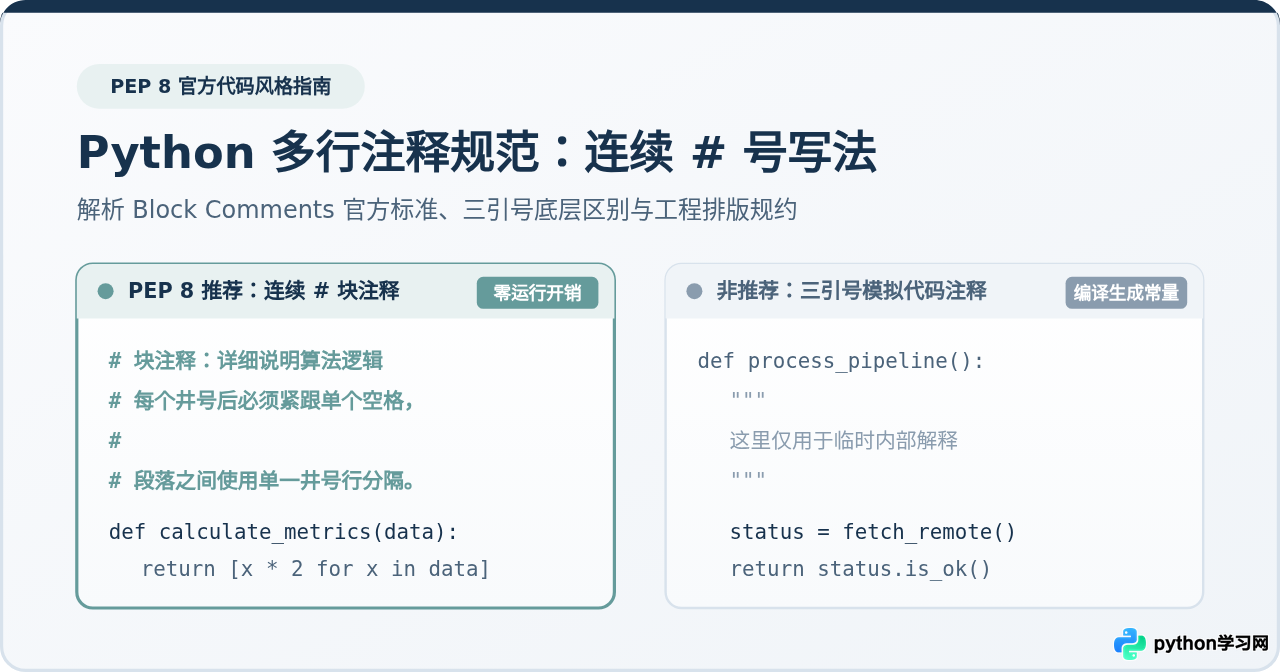
/* ... */ 专用块注释语法。官方推荐且唯一标准的“多行块注释(Block Comments)”书写方式,是在每一行文字前使用单独的 # 符号加单个空格进行连续书写。许多初学者常习惯用三引号(''' 或 """)临时充当多行注释,但在 Python 规范与底层实现中,三引号是真正的字符串常量,其唯一合规的文档用途是 PEP 257 规定的文档字符串(Docstrings)。本文将深入梳理连续 # 号写法的核心排版规则、与三引号的底层编译差异、现代 IDE 快捷键工作流,以及规避团队代码审查常见陷阱的最佳实践。
一、PEP 8 官方推荐的多行注释规范:连续 # 块注释
根据 PEP 8 规范的“Comments(注释)”一节定义,应用于紧随其后的代码段、由多行解释文本构成的注释被称为块注释(Block Comments)。PEP 8 对块注释的书写给出了明确、严谨的格式约定:
- 同级别缩进(Indentation):块注释必须缩进到与其解释的代码完全相同的层级。如果一段函数体内部有 4 个空格缩进,那么针对其内部逻辑的块注释每行开头也必须是 4 个空格。
- 井号与空格配对(# 后单空格):块注释的每一行都必须以
#字符和一个半角空格(#)开头,严禁出现#代码说明这种紧贴符号的书写方式。 - 段落隔离专用单井号(Single # separator):当一段多行注释内容较长、需要划分成两个或多个逻辑段落时,段落之间不能使用完全空白的空行,而必须使用一行仅包含单个
#的占位注释行(没有后续文字)。 - 72 字符行宽软限制(Line Length):PEP 8 推荐 Python 代码行的最大长度为 79 字符,而对于包含大量自然语言的注释和文档字符串,建议严格控制在 72 个字符以内,以确保代码并排对比或在终端中查阅时拥有极佳的可读性。
- 规范标点与大小写:注释应构成完整的句子。首字母大写(除非首词是变量或标识符本身),并在陈述句末尾使用正确的句号。
我们来看一段严格符合 PEP 8 标准的块注释范例:
def process_transaction_batch(transactions, timeout=30):
    # 核心校验逻辑:批量过滤已撤销与重复提交的流水记录。
    # 每个流水对象必须具备唯一的 tx_id 与合法的数字签名,
    # 超时未确认的流水将被归档至重试队列中等待二次轮询。
    #
    # 注意:如果遇到跨账期的对账单,系统会跳过直接扣款流程,
    # 改为记录审计日志并向运维通道发送高优先级通知告警。
    valid_records = []
    for tx in transactions:
        if tx.is_valid() and not tx.is_expired(timeout):
            valid_records.append(tx)
    return valid_records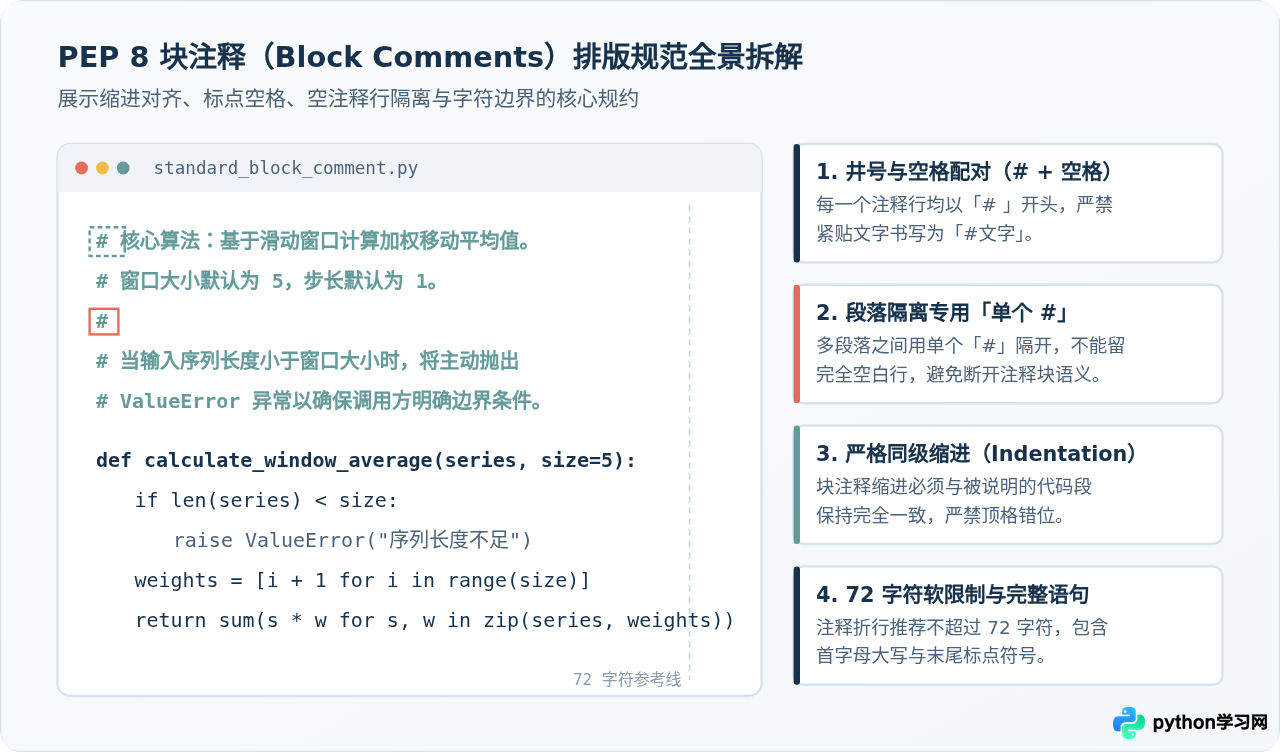
在上方图 1 中,可以清晰看到各规则的布局:缩进基准线、# 加空格标记、多段落之间的单 # 隔离行,以及 72 字符右侧辅助边界线。这种严密的结构让阅读者在浏览代码时,能一眼分辨出哪些行属于同一个逻辑说明块,而不会产生视觉断层。
二、底层机制深度剖析:为什么连续 # 号优于三引号?
许多开发者在刚接触 Python 时,常听人说“Python 可以用三个单引号或三个双引号写多行注释”。这种做法在语法上虽然能够“蒙混过关”(解释器在运行时不会报错),但在 Python 底层机制和规范语义上,它与真正的代码注释有着本质的区别。
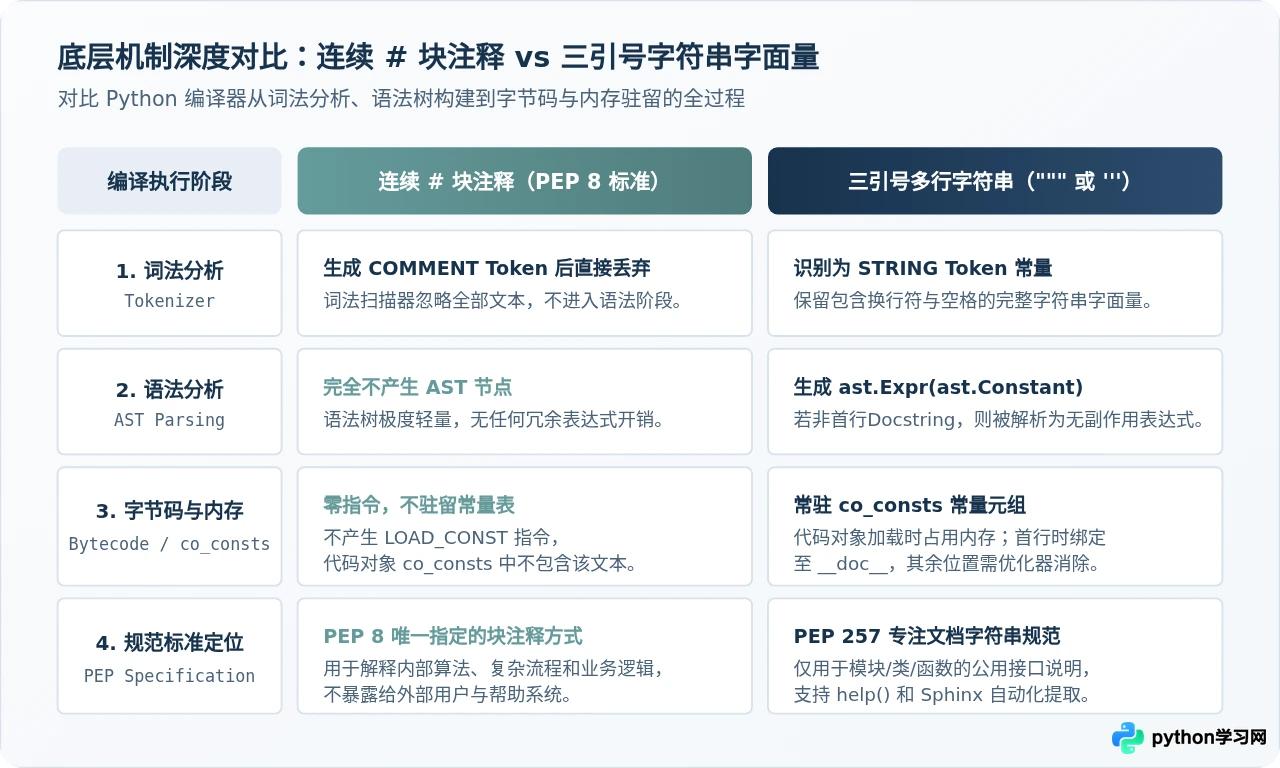
1. 词法分析与 AST 语法树层面的差异
Python 解释器在编译代码时,首先经过词法分析器(Tokenizer)。
- 对于以
#开头的文本,词法分析器将其识别为COMMENTtoken,在生成语法分析单元时会直接被丢弃。抽象语法树(AST)中完全不会出现任何代表注释的节点,更不会生成任何字节码。 - 而三引号括起来的文本,词法分析器会将其准确解析为
STRINGtoken。在构建抽象语法树时,如果它位于函数、类或模块的第一行,它会被赋予特殊的docstring属性;如果它出现在代码逻辑中间,它会被解析为一个独立的表达式语句(ast.Expr(value=ast.Constant(...)))。
2. 字节码指令与内存驻留(co_consts)
因为三引号在本质上是一个字符串字面量(String Literal),在未开启极致字节码优化的环境中,编译器会将这段长字符串载入当前代码对象的常量元组 co_consts 中。虽然运行时由于它没有副作用会被丢弃执行,但该文本在模块加载阶段已实实在在地分配了字符串对象的内存空间。
相比之下,连续 # 号是纯粹的编译期前置注释,在生成的 .pyc 文件和运行时内存中占用为严格的零字节,没有任何副作用与性能消耗。
3. 规范定位分工:PEP 8 与 PEP 257 的界限
Python 官方通过两个不同的增强提案划分了职责:
- PEP 8 统管代码风格:指定连续
#号作为唯一的行内与代码块注释方式,其定位是面向代码维护者,解释“为什么这么写”、“算法背景是什么”。 - PEP 257 专注文档规范:规定三引号专门用于文档字符串(Docstrings),其定位是面向接口调用者,通过
help()函数、__doc__属性以及 Sphinx / pydoc 等自动化文档工具对外输出 API 说明。
由于多行三引号字符串会忠实保留内部的所有换行符和前导空格,如果不小心在缩进代码块(例如嵌套循环或 if-else 分支)中随意粘贴未对齐的三引号文本,不仅会导致生成的字符串包含多余空白,有时甚至可能因缩进不匹配抛出 IndentationError。而连续 # 号无论内部写什么文本,均不会受到字符串换行空白的干扰。
三、现代 IDE 高效编写连续 # 注释的 4 步标准化工作流
之所以有人倾向于使用三引号,很大程度上是因为觉得“连续打很多个 # 符号和空格太繁琐”。事实上,现代主流开发工具(如 Visual Studio Code、PyCharm、Cursor、Sublime Text 等)早已内置了强大的批量注释支持,开发者完全无需手动逐行敲击 #。
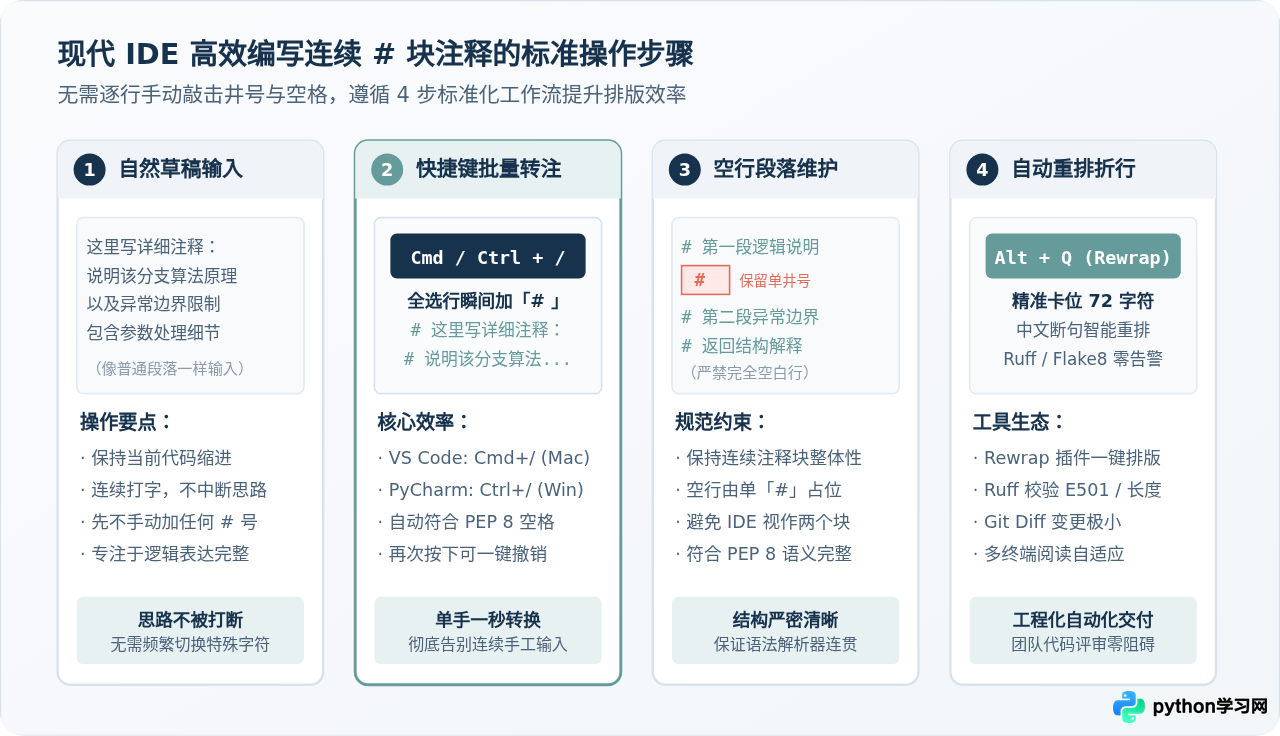
按照图 3 所示的 4 步工作流,编写规范的多行注释通常只需数秒时间:
第 1 步:自然编写多行草稿文本
在需要书写注释的代码上方,像普通段落一样直接输入你的构思和逻辑解释。无需在每行前添加任何特殊字符,保持正常的代码层级缩进即可。这能让你的思维完全聚焦于技术方案表达,不被符号输入打断。
第 2 步:全选段落并触发一键行注释快捷键
使用鼠标或键盘快捷键(Shift + 方向键)选中刚刚书写的多行草稿,然后按下系统对应的切换行注释快捷键:
| 开发工具 | macOS 快捷键 | Windows / Linux 快捷键 | 执行效果 |
|---|---|---|---|
| VS Code / Cursor | Cmd + / | Ctrl + / | 在所选每行行首自动填充 # ,完美保持代码缩进 |
| PyCharm / IDEA | Cmd + / | Ctrl + / | 智能遵循 PEP 8,在缩进处准确插入 # |
| Vim / Neovim | Visual 模式 + gc (Comment.nvim) |
Visual 模式 + gc |
极速将可视选择区转换为标准的井号注释块 |
第 3 步:段落隔离处维护单个 # 占位行
如果注释包含多个自然段,选中批量加注释后,中间的空行通常也会被编辑器自动加上 #(变成只有单个 # 的空行)。如果中间出现了完全空白的行,只需顺手输入一个 #,确保注释块上下闭合连贯,避免被工具或语法高亮识别为两个孤立的碎片。
第 4 步:借助格式化工具自动完成 72 字符折行
为了满足 PEP 8 的 72 字符可读性推荐,现代编辑器提供了自动重排插件:
- VS Code 推荐插件:安装
Rewrap插件,光标置于注释块内按下 Alt + Q(macOS 为 Option + Q),即可自动按预设字符宽度(72 或 79)重新折行并自动补全每行的#。 - 代码检查工具:在项目中配置
Ruff或Flake8(配合flake8-docstrings),当注释行超出设定长度时会有清晰的静态提示,一键修复即可。
四、注释类型选择决策树与团队避坑清单
在实际项目研发中,何时使用连续 # 块注释,何时使用三引号文档字符串,何时使用单行行内注释?我们可以通过下方的决策模型进行清晰判定。
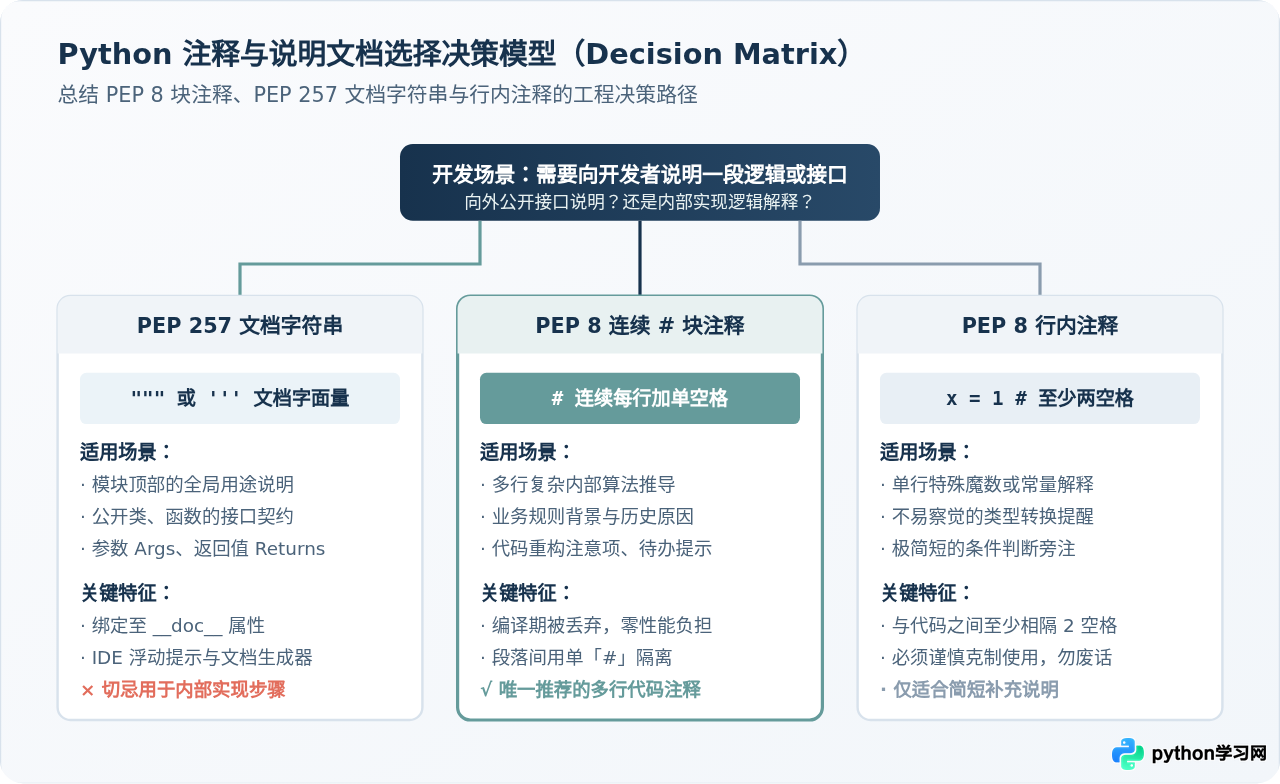
常见反模式与避坑指引
在团队代码评审(Code Review)中,以下 5 种不规范的注释写法出现频率极高,应予以规避:
-
反模式 1:用孤立的三引号替代实现逻辑注释
表现:在函数体内部随意使用"""说明文字"""。
风险:破坏了 PEP 257 的权威语义,增加不必要的字符串对象分配,且容易与真正的函数 Docstring 混淆。正确做法是在函数体内部一律使用连续#块注释。 -
反模式 2:多段落注释之间留纯白空行
表现:第一段# ...,然后是一行完全没有字符的空行,紧接着又是# ...。
风险:这在 PEP 8 中被视为中断了注释块的连贯性。规范要求段落之间必须使用由单个#构成的行。 -
反模式 3:紧贴井号不加空格(
#TODO或#注释)
表现:#之后直接跟文字,没有半角空格。
风险:PEP 8 明确规定每个#后必须跟一个空格,除非是特殊场景下的内嵌缩进。不加空格会触发 Flake8 的E265告警。 -
反模式 4:注释与代码行混杂且缺少安全间隔
表现:行尾注释仅空 1 格即写#(如a = 1 # 赋值)。
风险:PEP 8 规定行内注释与代码语句之间至少间隔两个空格(例如a = 1 # 赋值),否则会触发E261告警。 -
反模式 5:保留大段注释掉的无用历史代码
表现:在源文件中用连续#注释掉上百行废弃代码并长期提交。
风险:代码版本管理应交由 Git 处理,废弃代码注释会极大分散维护者精力。除临时调试外,应及时删除无用代码。
五、总结
Python 社区崇尚“显式优于隐式”与“只有一种显而易见的方法”。在多行注释这一基础却关键的语法规范上,PEP 8 给出的答案清晰且明确:
- 唯一的块注释标准:连续的
#号加单空格,同级缩进,段落间用单#隔开,行宽软限制为 72 字符。 - 清晰的语义边界:三引号字符串保留给 PEP 257 规定的公共文档接口(Docstrings),绝不随意侵入内部逻辑注释。
- 高效的现代工具:借助 IDE 的 Cmd/Ctrl + / 与 Rewrap 插件,连续
#注释的输入与维护效率远胜于手写三引号。
规范书写块注释不仅能够保证代码库在各类 linter 与 CI/CD 流程中保持零告警,更能为团队伙伴呈现一份排版严谨、层次分明、易于理解的高质量 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









