

Python为什么没有块注释?使用三引号模拟多行注释的风险
深入解析 Python 为什么只提供单行井号注释而未引入块注释语法,剖析使用三引号模拟多行注释在词法解析与字节码生成上的底层机理,详述缩进破坏、无效转义、文档污染等五大工程风险与规范化解法。
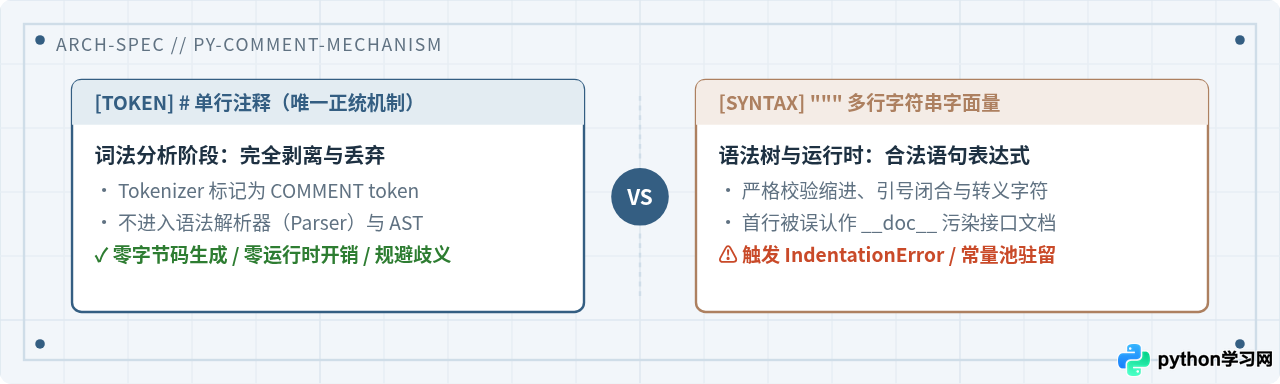
# 开头的单行注释机制。词法分析器(Tokenizer)在解析源码时会将 # 之后的内容直接标记为 COMMENT 并予以剥离丢弃,因而不会生成任何抽象语法树(AST)节点或字节码;之所以拒绝引入类 C 风格的 /* ... */ 块注释,是为了规避嵌套注释歧义,并契合 Python 依靠缩进组织代码的语法体系。很多开发者习惯使用的三引号(""" 或 ''')本质上是多行字符串字面量或文档字符串(Docstring),属于完整的表达式语句。用它模拟多行注释不仅违背语法语义,更会引发严格缩进崩溃、无效转义序列告警、意外篡改对象 Docstring、常量池内存占用以及CI 流水线 Linter 拦截等五大工程风险。
一、Python 注释的设计哲学与底层解析机制
在 C、C++、Java 等编程语言中,开发者通常能同时使用单行注释(//)与跨行块注释(/* ... */)。但自 Python 诞生以来,其语法规范中就明确仅提供单行前缀注释符号 #(Octothorpe / Hash)。想要注释多行内容,官方唯一的推荐规范就是在每一行的起始位置均添加 #。
这种设计的底层原因可从解释器编译管线和语言哲学两个维度来解释:
- 词法分析阶段的彻底清除:Python 解释器在读取
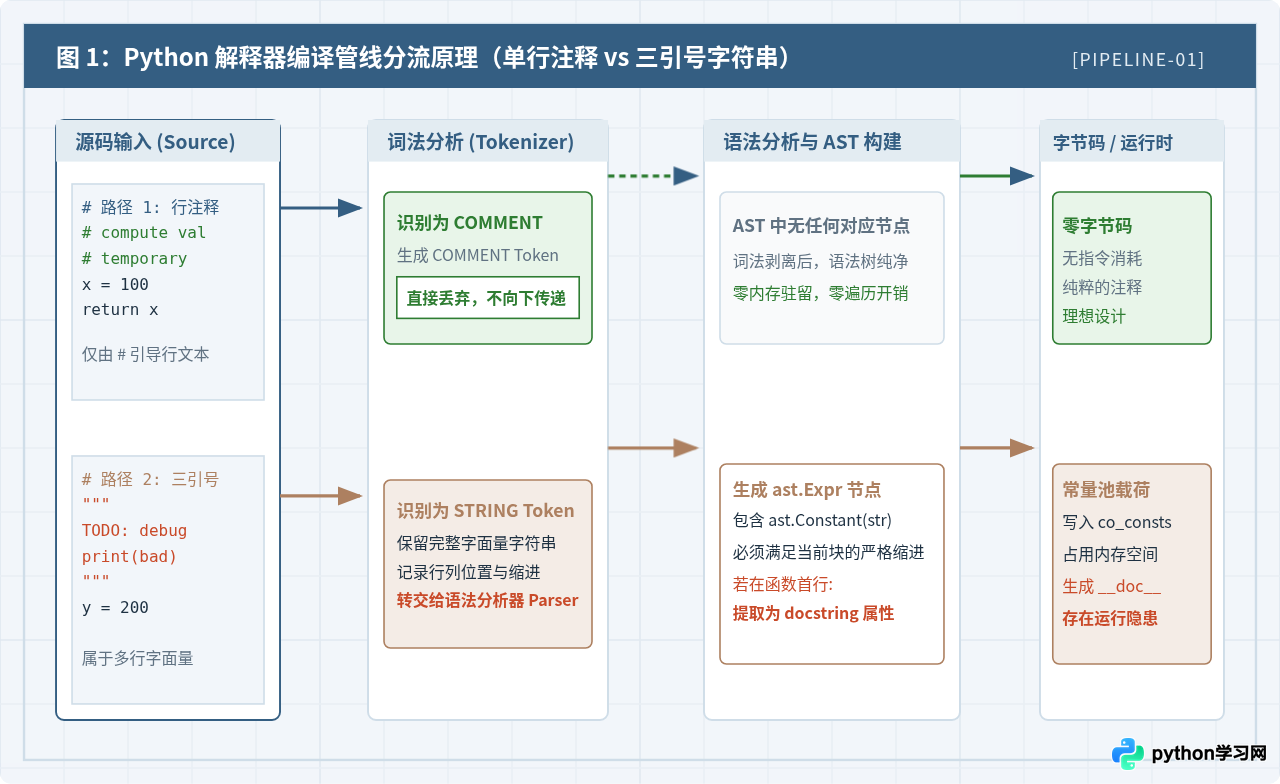
.py源码文件时,第一步由词法分析器(Tokenizer)扫描文本流。当遇到#符号时,分析器会提取整行注释文本标记为COMMENT类型的 Token,随后在向语法分析器(Parser)投递 Token 流之前直接将其丢弃。这意味着注释内容根本不会进入 AST 语法树,在后续的字节码生成与运行时完全透明,开销严格为零。 - 消除语法嵌套歧义:在支持
/* ... */块注释的语言中,如果注释内部的代码片段本身也包含/* ... */,解释器往往会提前闭合外层注释,引发语法错乱(Nested Comments Issue)。而在 Python 这样对缩进敏感(Whitespace-sensitive)的语言中,跨行自由闭合的符号还会打乱代码块的缩进视觉边界。 - Python 之禅的简洁唯一性:Guido van Rossum 曾多次强调“应当只有一种——而且最好只有一种显而易见的方式来完成”(There should be one-- and preferably only one --obvious way to do it)。单行井号注释语义纯粹、实现极简,配合现代代码编辑器的快捷键,开发者并不需要一套冗余且伴随语法隐患的块注释语法。
二、三引号的本质:多行字符串与 Docstring,绝非注释
部分初学者或从其他语言转来的开发者常常误认为三引号(""" 或 ''')是 Python 的“块注释”。产生这一误解的原因在于:当一个三引号多行字符串未被赋值给任何变量,且未参与函数调用时,Python 解释器在执行该代码块时似乎没有产生直接可见的副作用。
但从语言规范(PEP 257)与编译器实现来看,三引号在不同上下文中有完全不同的法定身份:
- 文档字符串(Docstring):当三引号字符串出现在模块、函数定义(
def)或类定义(class)的第一条可执行语句位置时,Python 会在编译时将其识别为对象的元数据,并自动将其赋值给该对象的__doc__特殊属性。 - 独立表达式语句(Expression Statement):当三引号字符串出现在普通代码逻辑段中间时,它并不是被解释器忽略的“空白”,而是一个合法的字符串常量表达式。编译器会对其进行词法切词、语法校验,并在编译期的抽象语法树中生成
ast.Expr和ast.Constant节点。
我们可以通过 Python 内置的 dis 模块反编译字节码,直观验证解释器对两者的底层处理差异:
import dis

def func_with_comment():
    # 这是标准的单行注释
    # 这是第二行注释
    return 100

def func_with_triple_middle():
    x = 10
    """这是夹在代码中间的三引号伪注释"""
    return x

print("=== func_with_comment 的常量表与字节码 ===")
print("co_consts:", func_with_comment.__code__.co_consts)
dis.dis(func_with_comment)

print("\n=== func_with_triple_middle 的常量表与字节码 ===")
print("co_consts:", func_with_triple_middle.__code__.co_consts)
dis.dis(func_with_triple_middle)
执行上述代码后的输出对比如下:
=== func_with_comment 的常量表与字节码 ===
co_consts: (None, 100)
  7           0 LOAD_CONST               1 (100)
              2 RETURN_VALUE

=== func_with_triple_middle 的常量表与字节码 ===
co_consts: (None, 10, '这是夹在代码中间的三引号伪注释')
 12           0 LOAD_CONST               1 (10)
              2 STORE_FAST               0 (x)
 14           4 LOAD_FAST                0 (x)
              6 RETURN_VALUE
可以看到,使用 # 注释的代码在常量表 co_consts 中没有留下任何痕迹;而使用三引号模拟注释的代码,字符串内容被完整记录在代码对象的常量元组中,永久驻留在程序内存中。
三、使用三引号模拟多行注释的五大工程风险
如果仅仅是轻微的内存占用,或许在日常小脚本中尚可容忍;但在多人协作的正式工程项目中,使用三引号模拟多行注释会引发多个难以察觉且影响恶劣的隐患。
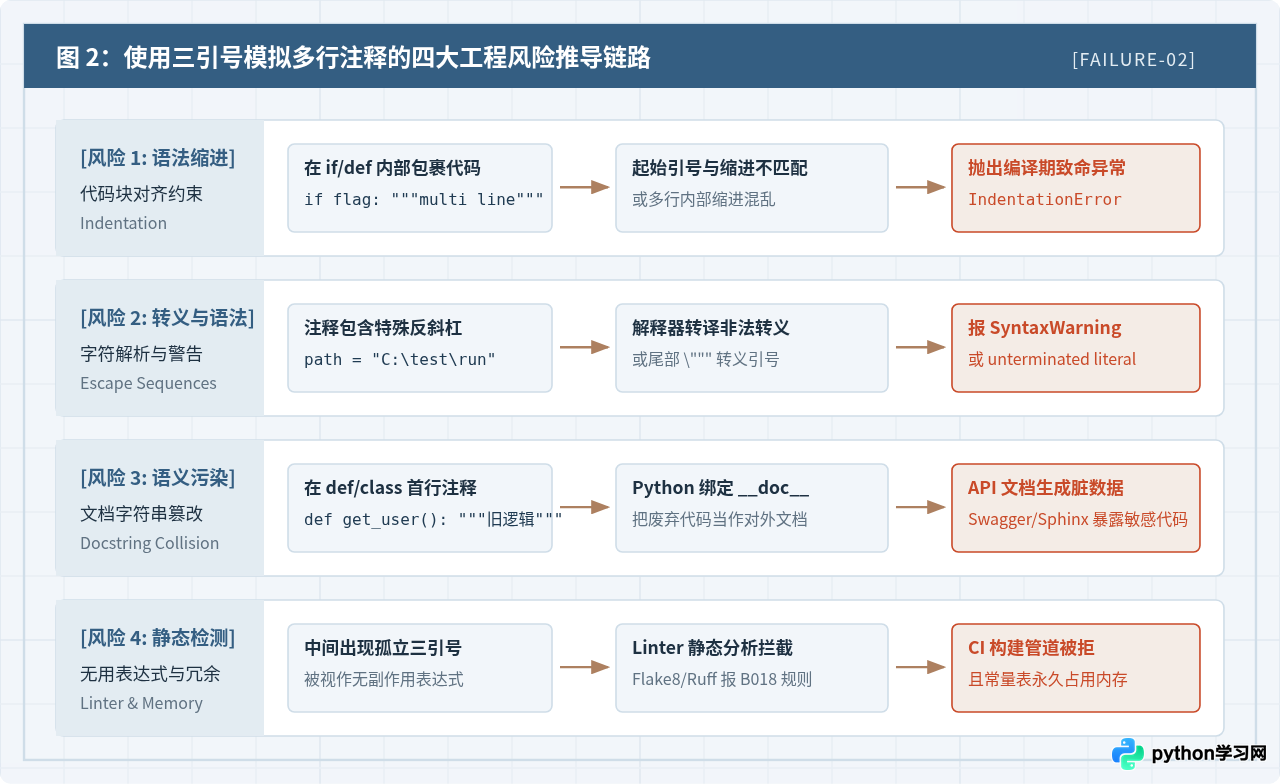
风险 1:严格的代码块缩进约束(IndentationError)
这是最频繁发生的语法报错。单行注释 # 可以写在行的任意列,甚至不需要对齐缩进,解释器均能正常解析;但三引号作为表达式语句,必须完全遵守当前代码块的缩进级别。
看以下典型错误示例:
def process_records(records):
    for item in records:
        if item.is_valid:
"""
临时注释掉这几行旧处理逻辑:
item.archive()
notify_admin(item)
"""
item.mark_active()运行上述代码会直接抛出:IndentationError: unindent does not match any outer indentation level。因为三引号起始处直接顶格书写,破坏了 if 和 for 的层级,导致 Python 语法解析直接终止。
风险 2:转义字符解析与致命语法警告(SyntaxWarning / SyntaxError)
既然三引号是字符串,Python 解释器在编译期就会对其中的反斜杠 \ 进行转义语法检查。如果被注释的代码片段中包含 Windows 文件路径、正则表达式或格式化符号,非原始字符串(Raw String)会触发异常:
def export_backup():
    """
    临时备份旧脚本指令:
    powershell.exe -Path C:\users\deploy\scripts\new_task.ps1
    """
    pass
在 Python 3.8+ 中,运行上述代码会触发警告:SyntaxWarning: invalid escape sequence '\u'、invalid escape sequence '\s'。在 Python 3.12 及更高版本中,未加处理的非法转义序列更会被严格对待。
更危险的是,如果被注释代码的最后一行恰好是以行延续符反斜杠 \ 结尾,例如:
"""
query = select(User).\
"""
末尾的反斜杠会直接将紧随其后的第一个双引号转义(转义为 \"),导致三引号未能按预期闭合,直接引发致命错误:SyntaxError: unterminated triple-quoted string literal。
风险 3:静默篡改与污染对象的 Docstring
在日常排查问题时,开发者经常需要临时注释掉函数体开头的几行校验代码。如果不假思索地在函数第一行加上三引号,就会产生严重的文档污染问题:
def calculate_tax(salary: float) -> float:
    """
    TODO: 临时注释旧版扣除公积金的逻辑
    if salary > 5000:
        salary -= 1000
    """
    return salary * 0.2

print(calculate_tax.__doc__)calculate_tax.__doc__ 打印出来的不是接口说明,而是这几行调试废弃代码!现代微服务架构广泛采用基于 Docstring 自动生成文档的工具(如 FastAPI / Swagger OpenAPI 文档生成器、Sphinx、MkDocs 等)。这种写法会将内部废弃逻辑甚至敏感业务代码直接暴露在对外发布的 API 文档和 IDE 的悬浮提示中。
风险 4:AST 构建负担与内存常量池永久驻留
大段被三引号包裹的代码(例如几十行到上百行的复杂 SQL 语句、测试数据字典或废弃逻辑)依然会完整经历 Python 语法树的节点构建。编译器会为其分配字符串对象,并将其持久化序列化到 .pyc 字节码文件的常量表 co_consts 中。不仅增加了模块加载解析耗时,还在进程常驻运行期间无意义地占据了 Python 虚拟机的堆内存空间。
风险 5:自动化代码审查工具(Linter & Formatter)冲突
在符合规范的工程项目中,代码必须通过 CI/CD 流水线上的自动化工具校验。孤立的三引号会被静态检测工具识别为无意义的死代码:
- Flake8 / Ruff:会直接抛出
B018: Found useless expression. Either assign it to a variable or remove it.规则告警,导致代码无法合入主干分支。 - Black / YAPF:代码格式化工具在遇到长字符串表达式时,会依据每行最大字符限制(如 88 字符)尝试对其进行换行或缩进调整,使得原本排版规整的代码片段被格式化打乱,造成无意义的代码差异(Diff Noise)。
四、现代工程中的正确多行注释规范与操作
认识到三引号的风险后,开发者应当如何在日常开发中优雅、高效地处理多行注释?以下是符合 PEP 8 与工程化标准的落地指南:
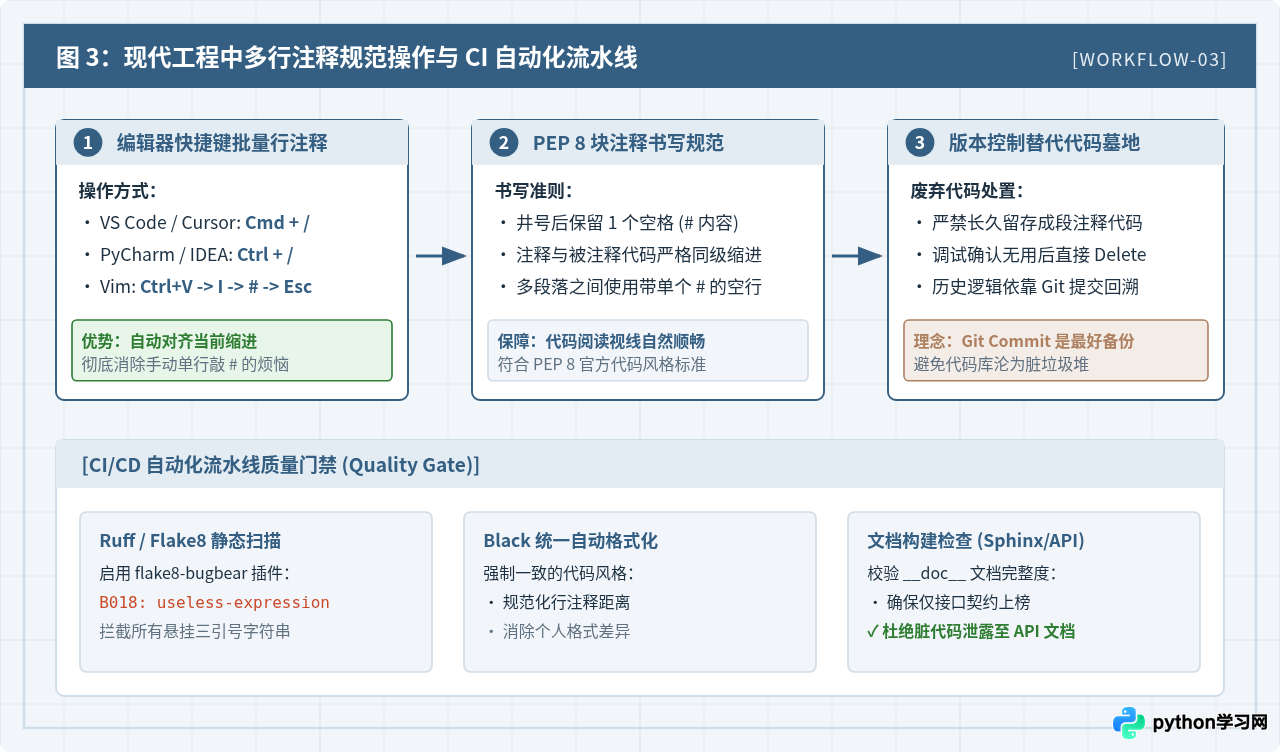
1. 编辑器快捷键批量行注释
许多人之所以冒险使用三引号,仅仅是为了图省事。但现代主流编辑器早已有极其成熟的多行批量行注释快捷键,操作成本与效率远高于手动输入三引号:
| 开发工具 / 编辑器 | 操作系统 | 批量多行注释 / 解除注释快捷键 |
|---|---|---|
| VS Code / Cursor | macOS Windows / Linux |
Cmd + /Ctrl + / |
| PyCharm / IntelliJ IDEA | macOS Windows / Linux |
Cmd + /Ctrl + / |
| Vim / Neovim | 通用 | 列块模式:Ctrl + V 选中行首 → I → 输入 # → 按 Esc |
| Sublime Text | macOS Windows / Linux |
Cmd + /Ctrl + / |
快捷键的优势在于:编辑器会自动识别当前光标所处的缩进层级,统一在正确的列位置插入 # ,完全杜绝了缩进错误与语法警告。
2. 严格遵循 PEP 8 块注释书写规范
当需要为一段复杂的业务逻辑书写多行说明文字时,遵循 Python 官方 PEP 8 风格指南:
- 块注释通常适用于跟随其后的某些(或全部)代码,并且与这些代码具有相同的缩进级别;
- 块注释的每一行以
#和一个空格开头(除非是块内缩进的代码); - 块注释内的段落通过仅包含单个
#的空行进行分隔;
# 计算加权移动平均值(WMA)。
#
# 权重随着时间推移呈线性递减,最新的数据点拥有最高的权重值。
# 算法要求输入序列长度不得小于滑动窗口大小 window_size。
def compute_weighted_moving_average(series, window_size):
    pass
3. 用版本控制(Git)替代“代码墓地”
在实际代码库中,绝大多数多行模拟注释的产生,都是因为开发者在修改逻辑时“舍不得删除旧代码”,寄希望于以后万一出错还能找回。这种做法会让源文件充斥着大量无人维护的废弃代码(Dead Code),严重降低代码的可读性。
在现代软件工程中,Git 提交历史就是最完美的备份工具。确认旧逻辑不再适用时,直接删除对应代码,并在 Git Commit 信息中清晰记录重构动机。任何时候需要找回历史逻辑,只需通过 git log -S 或 git blame 即可一键检出,无需在生产代码中留存任何多行废弃注释。
五、场景决策矩阵与最佳实践总结
为了在实际编码中快速选择正确的方式,可参考以下注释与文档使用决策矩阵:
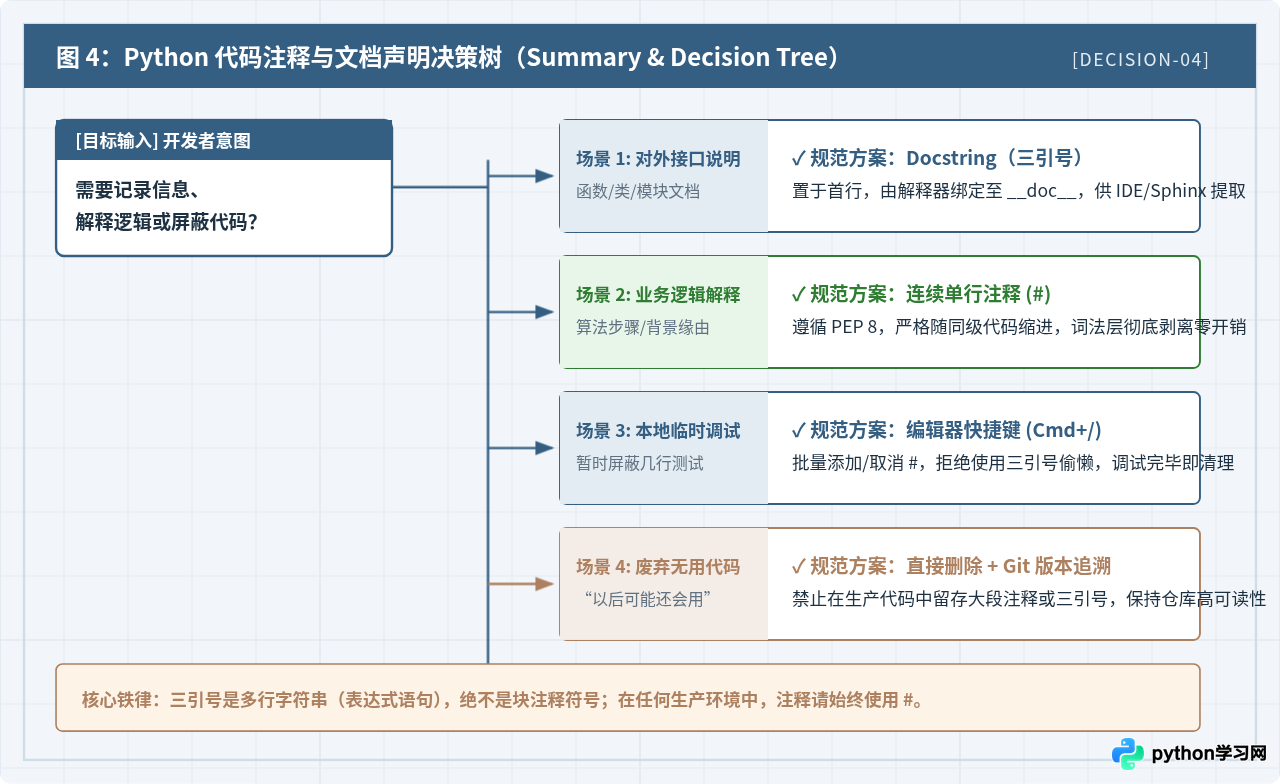
| 场景需求 | 正确做法 | 底层表现 | 严禁行为 |
|---|---|---|---|
| 模块/类/函数接口契约说明 | Docstring(三引号 """) |
绑定至 __doc__ 属性,供外部工具读取 |
严禁使用单行 # 替代对外公开文档 |
| 函数内部业务逻辑/算法解释 | 连续单行注释(# 开头) |
词法分析阶段剥离,AST 零节点,运行零开销 | 严禁在逻辑中间使用未赋值的三引号字符串 |
| 本地临时排查/屏蔽数行代码 | 编辑器快捷键批量 # |
安全保留同级缩进,排查完成后一键还原 | 严禁随手敲三引号跨行包裹,避免误报缩进异常 |
| 重构废弃代码的历史存档 | 直接从源码删除,由 Git 跟踪记录 | 源码保持整洁,降低团队长期认知负荷 | 严禁保留成段大面积注释代码(代码墓地) |
总结而言,Python 并非“遗漏”了块注释,而是从语法纯粹度、解析确定性与工程可维护性的角度出发,作出了只保留 # 注释的设计取舍。理解三引号作为字符串字面量的本质,告别用三引号模拟多行注释的坏习惯,是每一位 Python 开发者写出健壮、规范、专业代码的基础素养。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









