

Python单行注释与多行注释的正确写法

# 开头,而多行注释既可以通过连续书写多个单行 # 实现,也可以借助未赋值的三引号字符串进行逻辑段落注释。本文将具体阐明这两种注释的标准书写方式、PEP 8 格式规范、多行字符串与 Docstring(文档字符串)的核心区别,以及在实际编码中应避免的书写误区。
假设你接手了一个没有任何注释的计算折扣率脚本。代码里充斥着诸如 rate = 0.85 和 val = p * rate - 15 的数值计算。你很难一眼看清 0.85 代表节假日优惠还是老客户优惠,也不清楚减去 15 是物流立减还是优惠券抵扣。当逻辑变得更复杂时,缺少或者混乱的注释会显著增加阅读和维护成本。清晰、符合规范的注释正是为了消除这些理解歧义。
一、单行注释的写法与规范
单行注释是 Python 中最基础的注释形式。Python 解释器在语法解析阶段遇到 # 时,会忽略从该符号开始直到行末的全部字符。根据所在位置的不同,单行注释通常分为独立单行注释与行尾行内注释两种形态。
1. 独立单行注释
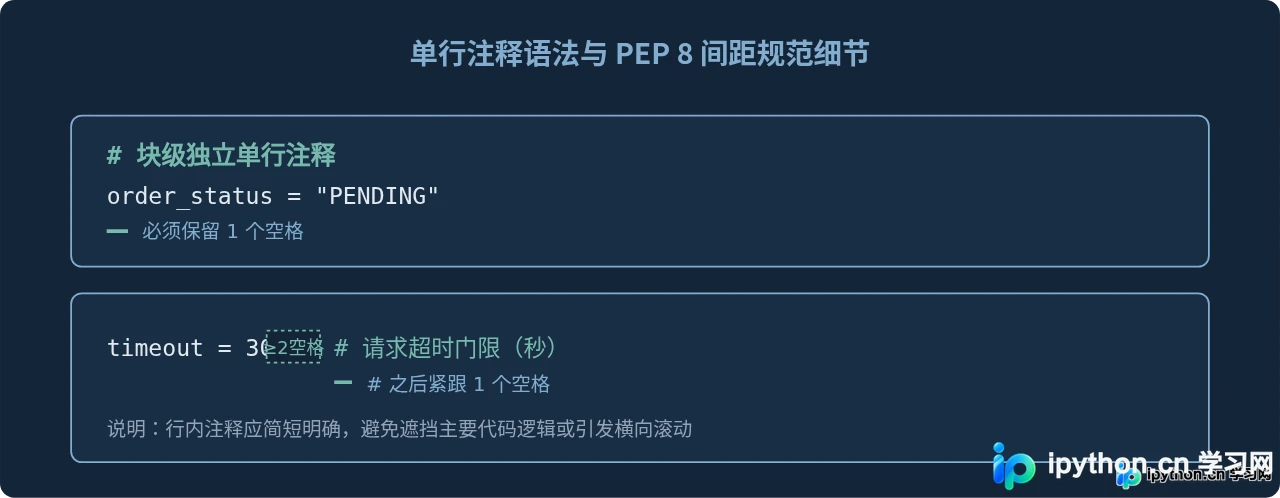
独立单行注释单独占据一行,通常位于被解释代码块的正上方。根据官方代码风格指南 PEP 8 的建议,# 后面应当紧跟一个半角空格,随后书写解释说明文本。如果注释紧随在一段代码之后,应在上方保留一个空行以便视觉切分。
# 计算订单折后实付金额(包含基础折扣与运费减免)
total_amount = original_price * discount_ratio - shipping_waiver
2. 行尾行内注释
行尾行内注释与有效代码位于同一行,紧跟在表达式的末尾。PEP 8 明确规定:代码末尾与 # 之间必须保留至少两个半角空格,且 # 之后依然需要一个空格。
retry_limit = 3 # 接口请求失败时的最大重试次数行尾注释适合用于说明边界值、特殊常量或异常处理逻辑。如果解释语句较长,应将其移至代码上方写成独立单行注释,避免造成横向代码过宽。
二、多行注释的两种书写方式
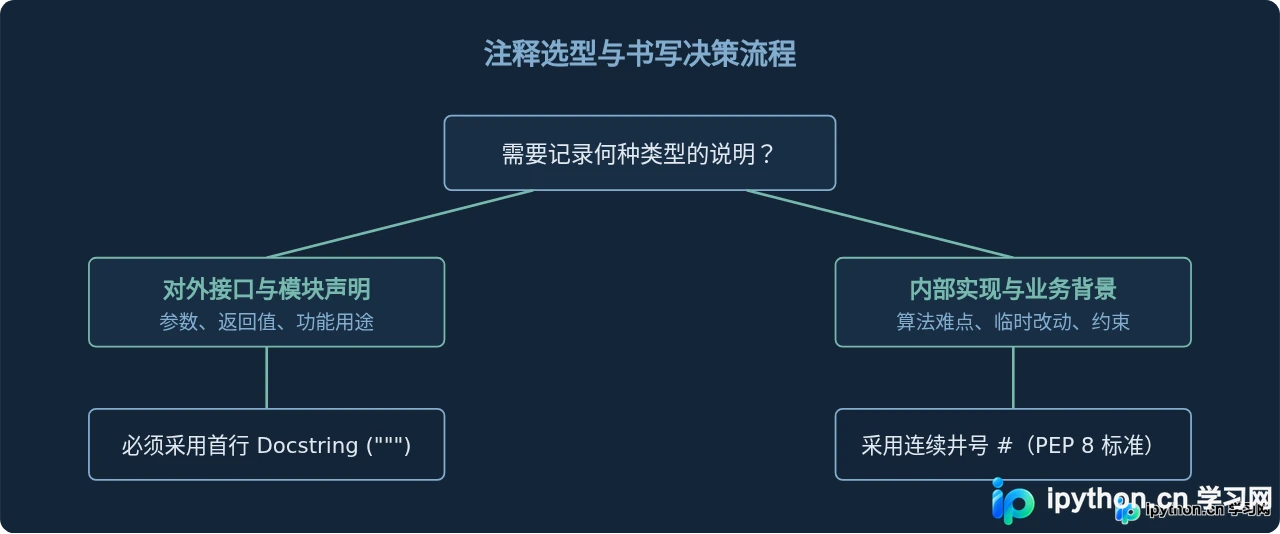
当解释一段复杂的算法实现、业务背景或多项约束条件时,单行注释往往显得篇幅不足。Python 官方语法并没有像 C 语言中 /* ... */ 那样的独立多行注释标记,在实际开发中存在两种主流写法。
方法一:连续井号(PEP 8 推荐方案)
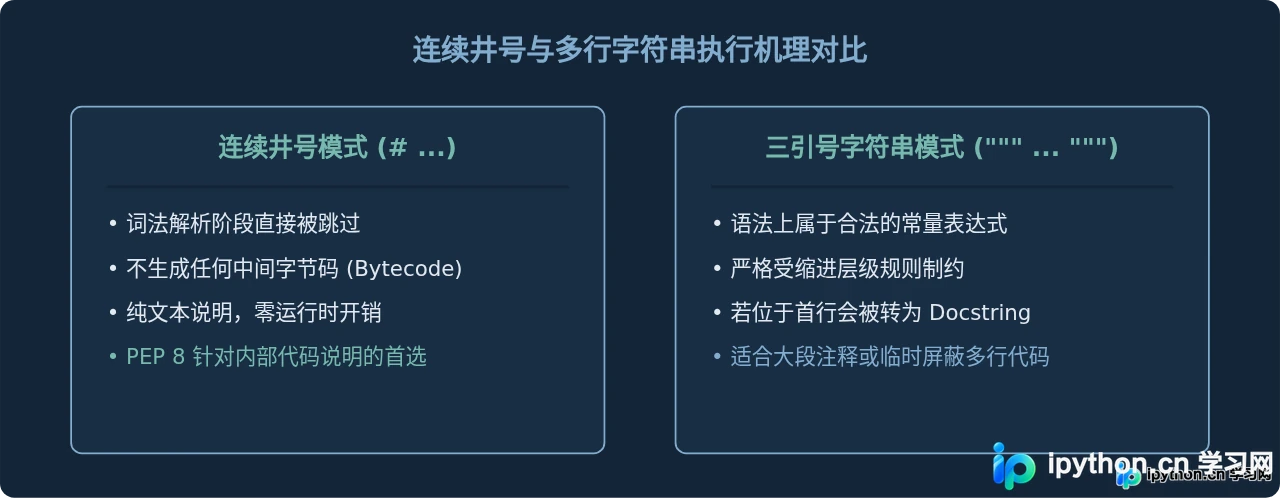
PEP 8 官方推荐的常规多行注释写法,是在每一行的行首均使用 # 符号。这种形式从语法层面上完全由纯注释构成,不会占用额外的内存对象空间,逻辑段落清晰统一。
# 数据同步校验机制说明:
# 1. 首先检查远程服务器连接状态与 API 认证 Token
# 2. 拉取变更列表并比对本地增量日志的时间戳
# 3. 若发现冲突则触发告警并保留原始快照
def sync_database():
    pass
方法二:未赋值的多行字符串(三引号)
Python 允许使用三对双引号 """ 或三对单引号 ''' 声明跨行字符串。如果该多行字符串没有赋值给任何变量,也没有作为表达式传递给任何函数,解释器在执行字节码优化时会直接忽略它。许多开发者利用这一特性作为临时的多行注释。
"""
临时调试代码块:
在修复线上同步故障期间,屏蔽底层重试以直接捕获真实调用栈。
修复完成后需恢复以下代码。
"""
# run_retry_pipeline()注意缩进匹配:使用三引号进行跨行注释时,三引号必须与当前代码层级保持一致的缩进量。若在函数或循环体内部缩进不当,会直接触发 IndentationError 语法错误。
三、关键辨析:多行字符串与 Docstring(文档字符串)
虽然三引号语法看起来一模一样,但它放在不同位置时,Python 对待它的方式有本质不同。读者最容易混淆的概念是:并不是所有的三引号字符串都是普通多行注释。
当三引号字符串紧跟在模块(文件开头)、类定义或函数定义的第一行时,它会被 Python 解释器识别为该对象的 Docstring(文档字符串)。Docstring 并不是普通注释,它会被编译进字节码,绑定到目标对象的 __doc__ 属性上,并供 help() 函数以及 Sphinx 等文档生成器读取。
def calculate_tax(income: float) -> float:
    """计算个人所得税应纳税额。

    参数:
        income: 税前月收入金额(元)

    返回:
        实际应缴纳税额
    """
    # 以下为扣除五险一金后的实际速算逻辑
    threshold = 5000.0
    taxable = max(0.0, income - threshold)
return taxable * 0.1| 对比维度 | 连续井号注释 (#) |
未赋值三引号字符串 | 文档字符串 (Docstring) |
|---|---|---|---|
| 核心作用 | 解释实现细节与逻辑缘由 | 临时屏蔽代码或大段文本说明 | 声明模块、类、函数的接口契约 |
| 生命周期 | 编译前丢弃,不进字节码 | 通常由编译器优化忽略 | 常驻内存,绑定到 __doc__ |
| 工具支持 | IDE 内部阅读 | IDE 内部阅读 | help()、Sphinx、自动补全 |
| 书写位置 | 任意代码行或独立行 | 代码内部任意缩进合法处 | 模块、类、函数体的第一条有效语句 |
四、工程实战中的常见错误与避坑指南
在实际编写注释时,如果不熟悉解释器的工作机制,往往容易犯下以下几类典型错误:
1. 字符串内部的 # 不会被当作注释
当 # 出现在成对的单引号或双引号之内时,它只代表一个普通的字符,不会触发注释截断。请看下例:
url = "https://example.com/api/v1#section"  # 这里的 # 不是注释
token = "#secret_auth_key"                  # 字符串内的 # 依然是字面值
2. 三引号临时注释引起的缩进错误
许多初学者在临时注释循环体或条件判断内的代码时,将三引号写在了行首(最左侧未缩进)。这会导致解释器报告语法错误:
for item in items:
"""
错误示范:顶格书写的三引号会导致后续代码或当前代码块出现 IndentationError
"""
process(item)修复方法:保持三引号与当前逻辑块同等缩进,或者直接利用现代代码编辑器的快捷键(如 Windows/Linux 下的 Ctrl + /,Mac 下的 Cmd + /)直接批量添加或移除单行 #。
3. 无效的“废话注释”与未同步的“过期注释”
注释的目的是解释为什么这样做(Why),而不是简单重复代码做了什么(What)。例如 i = i + 1 # 让 i 增加 1 属于无意义的冗余注释;更糟糕的是重构了代码逻辑后遗忘了旧注释,给维护者造成误导。
五、规范总结与最佳实践
编写高质量的 Python 注释可以总结为以下几条操作原则:
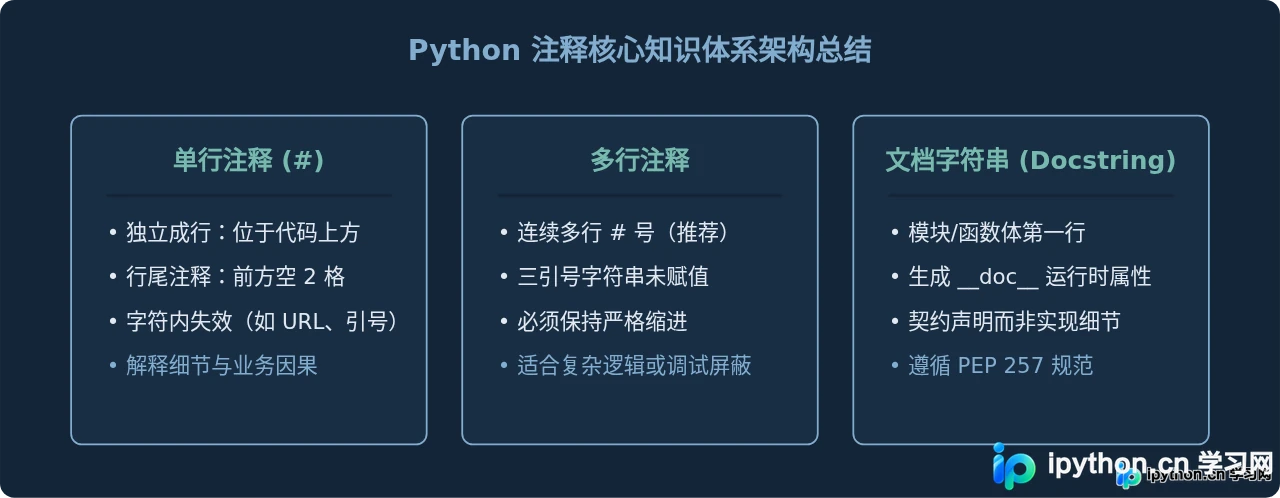
- 单行注释首选井号:使用
# 说明文字,并在#后保留一个空格。写在代码尾部时,代码与#之间留出至少两个空格。 - 多行注释优先采用连续井号:PEP 8 推荐在每行行首使用
#。如果使用三引号作为临时多行注释,务必保持相同的代码缩进。 - 严格区分 Docstring 与注释:模块、类和函数体首行的多行字符串属于文档字符串,其作用是定义公开接口规则,不应将其与常规过程注释混用。
- 保持注释与代码同步:在修改逻辑时,第一优先更新对应注释。不准确的陈旧注释比没有注释更具破坏性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









