

Python里用三引号做注释还是#号?解析块注释与Docstring的区别
深度解析Python中井号(#)块注释与三引号('''/""")文档字符串(Docstring)的本质区别,从语法机制、AST解析、内存开销到工程规范,助你写出地道、规范的Python代码。
核心结论:在 Python 中,规范的多行注释(块注释)应严格使用井号(#)逐行注释;三引号(""" 或 ''')在语法本质上是多行字符串字面量,仅当放置在模块、类或函数的首行时才会被识别为文档字符串(Docstring)。将三引号直接当作块注释使用属于非标准写法,存在缩进错误风险、内存浪费及静态检查告警隐患。
一、语法本质:纯注释与字符串表达式的区别
很多开发者从 C、C++ 或 Java 转入 Python 时,经常会产生一个疑问:C 语言中有 /* ... */ 语法支持跨多行注释,而 Python 看起来只有单行注释符号 #。由于三引号 """ 或 ''' 允许跨行书写文字,许多初学者便顺理成章地使用三引号包裹大段说明,认为这就是 Python 的“多行注释”。
这种认知在语法机制上并不准确。Python 解释器在词法分析(Lexing)阶段与抽象语法树(AST)构建阶段,对 # 与三引号有着截然不同的处理链路:
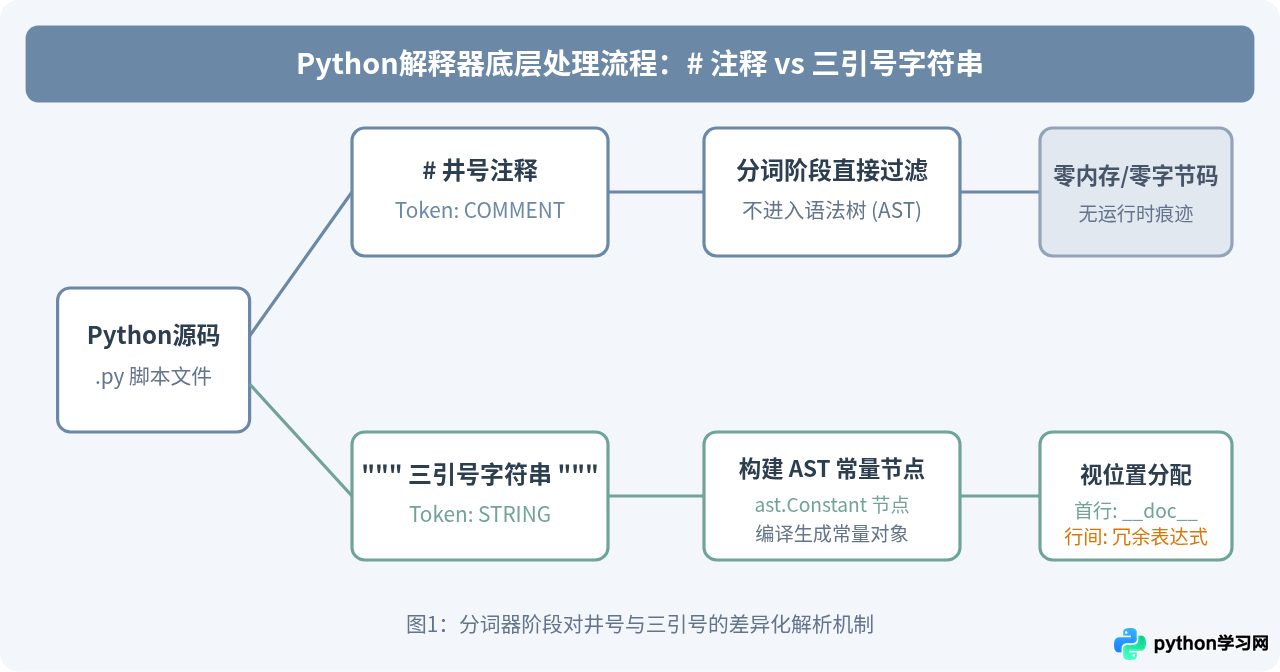
通过底层分析可以明确:
- 井号(#):是 Python 真正意义上的注释标记。分词器读取源码遇到
#时,会将其直到行末的内容识别为COMMENT标记,并在构建 AST 语法树之前直接剔除。编译后的字节码(.pyc)和内存中不会留下任何痕迹。 - 三引号(""" 或 '''):是多行字符串字面量(Multiline String Literal)。它首先是一个合法的 Python 表达式。如果单独出现在代码块中且未被赋值给变量,它就是一个没有副作用的常量表达式语句(Expression Statement)。
二、底层代码验证:字节码与 AST 的差异
我们可以通过 Python 内置的 dis 模块来查看函数的字节码,直观验证两者的差异:
import dis

def func_with_hash():
    # 这是井号注释1
    # 这是井号注释2
    x = 10
    return x

def func_with_triple_quotes():
    """这是函数中间的三引号块"""
    x = 10
    return x

print("--- 井号注释字节码 ---")
dis.dis(func_with_hash)

print("\n--- 三引号字节码 ---")
dis.dis(func_with_triple_quotes)
运行结果分析:
func_with_hash的常量表(func_with_hash.__code__.co_consts)中只有(None, 10),注释在编译阶段已被完全剥离;func_with_triple_quotes由于三引号位于函数体第一行,Python 编译器将其捕获为文档字符串,常量表中包含了('这是函数中间的三引号块', 10),并通过func_with_triple_quotes.__doc__暴露给外部。
注意:如果把三引号写在函数体中间(例如 x = 10 之后),虽然 Python 优化器可能在生成字节码时不产生额外的操作指令,但该字符串依然会被打包进模块的常量池 co_consts 中,造成不必要的内存占用。
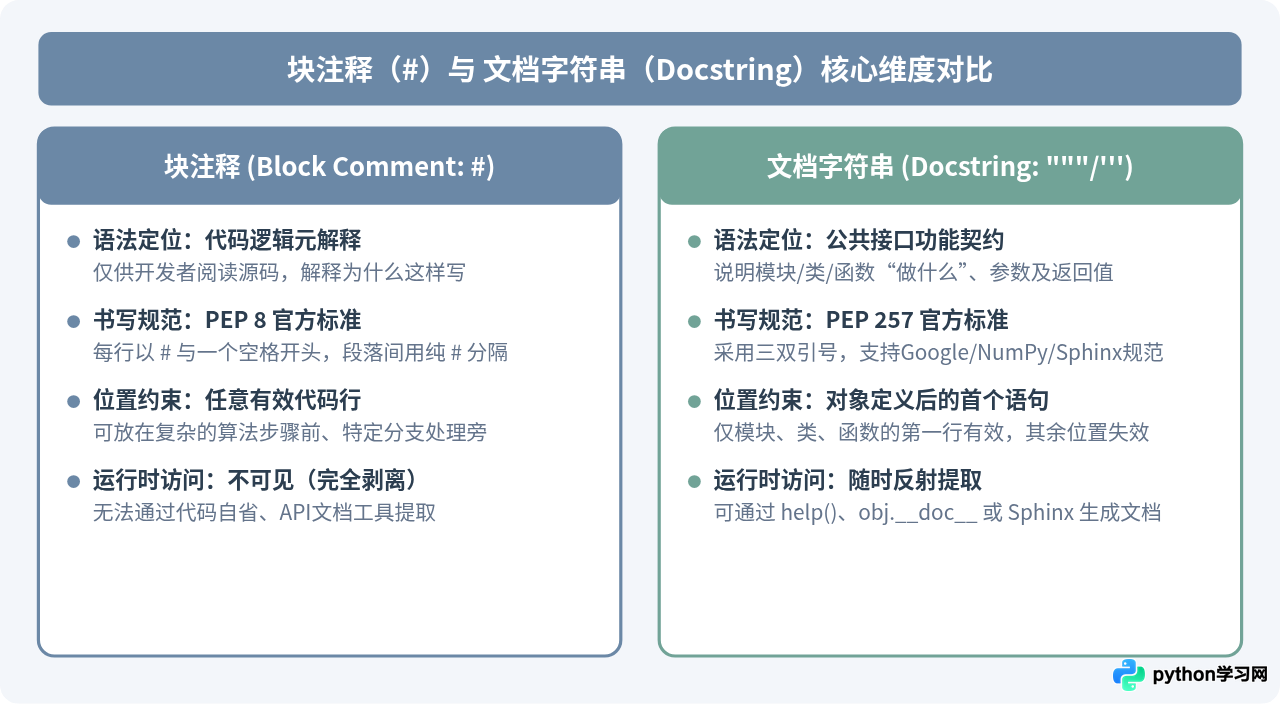
三、核心维度横向对比:块注释与 Docstring
为了让技术选型更加清晰,我们从语法规范、存放位置、工具支持等多个核心维度对两者进行系统化对比:
四、使用三引号充当注释的三大潜在隐患
在日常开发中,直接使用三引号跨多行作为临时“注释”,往往会引入以下三类不易察觉的问题:
1. 意外的缩进错误(IndentationError)
因为三引号是一个表达式语句,它必须严格服从当前代码块的缩进级别。如果在一组循环或条件分支内部随意粘贴顶格的三引号多行文本,解释器会直接抛出语法报错:
def calculate_tax(income):
    if income > 5000:
# 如果这里用三引号且没有对齐4个空格缩进,将直接报错:
"""
这里临时写一段说明
注意必须保持4格缩进!
"""
        rate = 0.2
return income * rate相比之下,# 号开头的注释即便在特定编辑器下缩进不严谨,也不会阻断解释器的语法解析。
2. 静态代码分析与 Linter 报错
成熟的团队通常会在 CI/CD 流水线中集成 flake8、pylint 或 ruff。当把三引号写在非首部位置时,静态检查工具会立即报告警告:
# 触发 Pylint 检查规则:
W0105: String statement has no effect (pointless-string-statement)
这说明工具将此类三引号识别为“无实际效果的冗余字符串语句”,破坏了代码规范整洁度。
3. 常量池膨胀与不必要的性能开销
当一段被注释掉的历史代码包含成百上千行,如果直接用三引号包裹,整个大字符串都会被编译器打包进 .pyc 的常量表,增加了二进制体积和模块导入时的内存开销。而使用 # 则在词法阶段被完全清除。
五、标准工作流程与规范操作实践
在现代集成开发环境(IDE)的辅助下,完全不需要手动逐行敲入 #。通过正确的操作流程,可以既保证效率,又符合 PEP 8 与 PEP 257 规范:
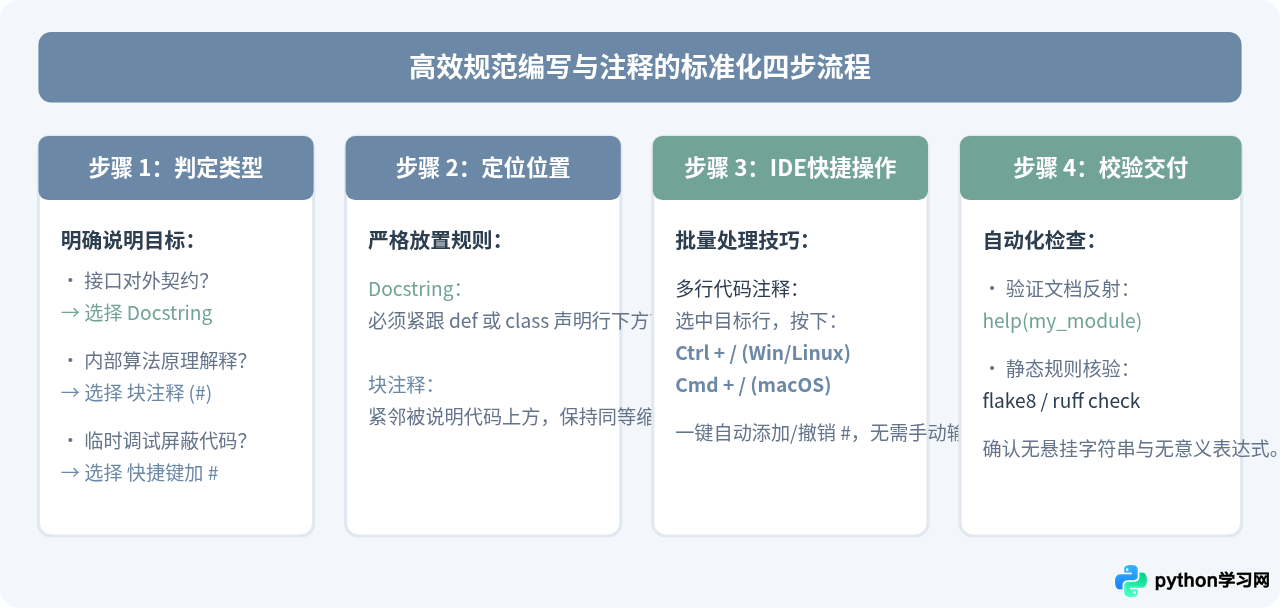
PEP 8 推荐的块注释写法
PEP 8 规定:块注释通常适用于跟随其后的一定数量的代码,并应缩进到与该代码相同的级别。块注释的每一行都以 # 开头,并紧跟一个空格;注释内的段落应通过单个仅含 # 的行进行分隔。
# 计算用户的加权活跃度分数。
# 该算法根据用户近30天内的登录频率、互动行为
# 以及消费转化情况进行动态计算。
#
# 注意:当活跃度超过99分时需触发反作弊风控复核。
score = calculate_activity(user_id)
PEP 257 推荐的 Docstring 写法
PEP 257 规定:所有公共模块、函数、类和方法都应具有文档字符串。多行文档字符串建议由总结行、空行及详细描述组成:
def fetch_user_profile(user_id: int) -> dict:
    """根据用户ID检索用户基础信息与配置。

    向主数据库集群发起只读查询。当主库网络超时时,
    将自动回退到从库缓存中检索过期数据。

    Args:
        user_id (int): 目标用户的全局唯一ID。

    Returns:
        dict: 包含用户名称、角色与状态的键值字典。

    Raises:
        UserNotFoundError: 当指定ID在数据库中不存在时抛出。
    """
    # 内部实现细节用井号注释
    return db.query(user_id)
六、决策导图:面对具体场景如何做出正确选择
在编写 Python 代码时,可以按照以下决策流程图进行判断与选择:
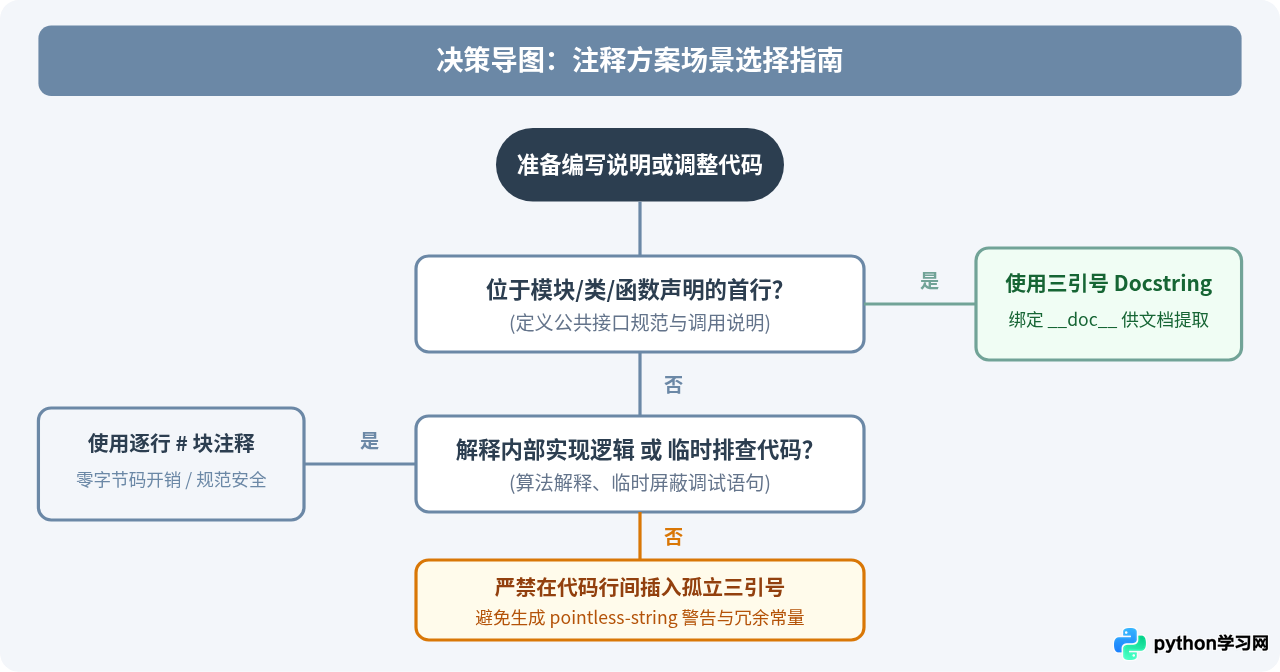
七、总结
在 Python 中,井号 # 和三引号 """ 并不是同一种语法的“单行版”与“多行版”,而是两套服务于完全不同目标的语言机制:
- 块注释(#):服务于源码阅读者,解释代码“为什么这么写”,在分词阶段即被完全丢弃,不产生任何运行时负担;
- 文档字符串(Docstring):服务于 API 调用者与自动化工具,声明接口“做什么、怎么用”,是 Python 对象的一等公民属性。
牢记规范:多行注释始终使用 #,三引号只在模块、类和函数顶部编写 Docstring 时使用。借助现代编辑器的 Ctrl + / 快捷键,不仅能彻底告别三引号假注释带来的潜在陷阱,还能让你的 Python 代码完全契合 PEP 8 工业级代码规范。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









