

解决Python在线运行超时与内存限制问题的实用技巧
深入解析Python在在线评测(OJ)、云端Notebook及沙箱环境中遇到超时(TLE)与内存超限(MLE)的底层机理,提供Fast I/O、哈希降阶、惰性生成器、__slots__紧凑结构等务实技巧与排查工作流。
一、在线沙箱的资源制约与触发机理
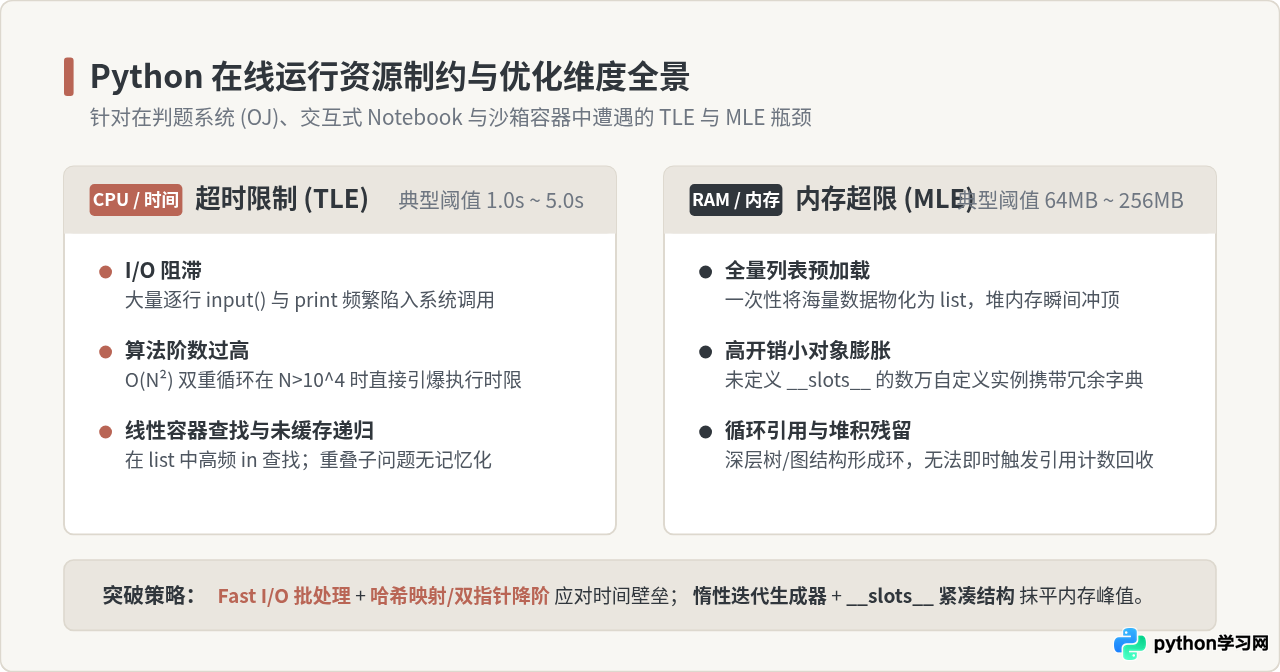
多数读者在本地开发环境运行 Python 脚本时,通常拥有数吉字节(GB)的物理内存以及数十秒甚至更长的等待容忍度。但在在线判题环境或云端多租户沙箱中,系统为了保障高并发判题的安全与公平,通常对单个进程设置了极为严苛的资源上限:通常 CPU 执行时限被约束在 1.0 秒至 5.0 秒之间,而物理内存上限则往往卡在 64MB、128MB 或 256MB。
很多初学者常把“运行耗时”简单等同于电脑时钟走过的时间,把“内存用量”等同于代码中声明变量的大小。这种理解上的偏差往往直接导致代码屡改屡超时:
-
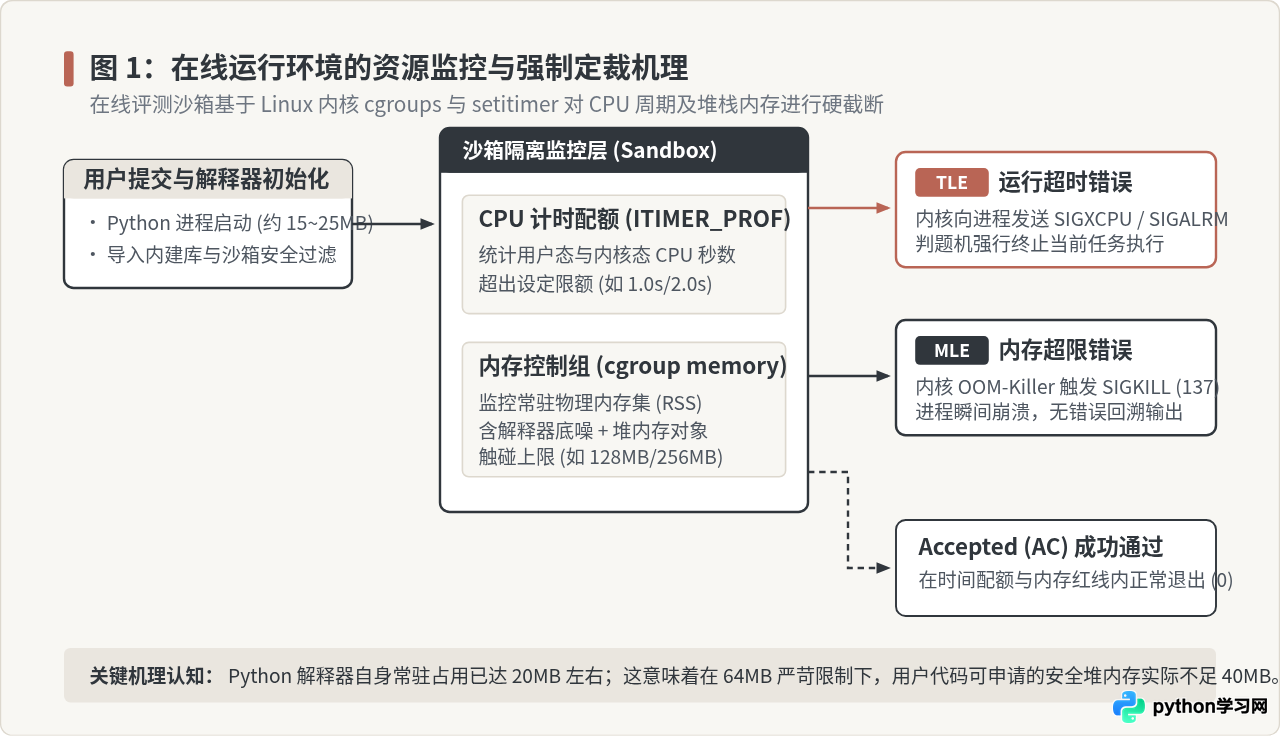
CPU 时间配额与挂钟时间(Wall-clock time): 沙箱监测的通常是进程实际消耗的 CPU 用户态时间与内核态时间总和(通过 Linux 的
ITIMER_PROF或 cgroups 计量)。如果在单次循环中高频触发阻塞式 I/O,或者产生大量的系统调用切换,哪怕实际有效运算很少,累计的系统态 CPU 消耗与调度等待也会迅速耗尽时限配额,从而触发内核的SIGXCPU或警报信号,被沙箱直接判为 TLE。 -
解释器底噪与 Linux cgroups 内存控制: CPython 解释器在没有任何用户变量加载的情况下,启动空进程本身就需占据 15MB 至 25MB 的常驻物理内存(RSS)。当沙箱设定的上限为 64MB 时,用户代码实际可调配的安全堆内存余量可能仅有 40MB 左右。一旦总物理常驻内存触碰 cgroup 的
memory.limit_in_bytes警戒线,宿主机内核的 OOM-Killer(内存耗尽杀手)将即刻向该进程发送不可捕获的SIGKILL (137)信号。此时程序甚至来不及输出异常回溯信息,直接被系统裁定为 MLE。
del obj,Python 也只是将其归还给解释器内部的可用内存池,并不会立即把物理页退还给操作系统内核。因此,靠在循环末尾频繁手写 del 往往无法从根本上避免 MLE。
二、运行超时(TLE)的定位与针对性优化
面对 TLE 时,首要任务是判断时间主要耗散在“输入输出链路”还是“核心计算环节”。在线测试用例的数据规模通常极大(例如单测试点输入数万至数十万行数据)。排查时应当依据规模由外向内做针对性改造。
2.1 输入输出(I/O)瓶颈的突破:Fast I/O
Python 原生内置的 input() 函数在每次调用时都会进行交互式缓冲处理并剥离换行符,且反复陷入操作系统底层读调用;而标准的 print() 默认会在每次调用后执行行刷新。当处理十万行规模的数据时,仅输入输出本身的系统调用开销就足以吞噬 1 秒以上的宝贵配额。
对于海量输入题型,务必优先采用基于标准输入流的成块读取方案:
import sys

def solve():
    # 做法一:一次性读入整个输入流并按空白字符切分(适用于内存充裕且数据量巨大的场景)
    input_data = sys.stdin.read().split()
    if not input_data:
        return

    # 顺序提取指针
    it = iter(input_data)
    n = int(next(it))
    m = int(next(it))

    # 批量输出:将结果汇总后一次性写出,避免在循环体内重复调用 print
    results = []
    for _ in range(n):
        val = int(next(it))
        results.append(str(val * 2))

    sys.stdout.write("\n".join(results) + "\n")

if __name__ == "__main__":
    solve()
在必须逐行处理或输入体积极大容易挤占内存时,则应改用 sys.stdin.readline 代替 input()。实验表明,读取 20 万行整型数据,sys.stdin.read().split() 通常比逐行 input() 耗时降低 70% 至 85% 左右。
2.2 查找与统计操作的复杂度降阶:消除 O(N) 线性扫描
导致 TLE 最频繁的算法病因,是在循环体内对列表(list)执行成员存在性检查(如 if x in my_list)或删除操作(my_list.remove(x) 或 my_list.pop(0))。在列表中查找元素的时间复杂度是 O(N),若外层循环执行 N 次,总时间复杂度即退化为致命的 O(N²)。
改造准则:
- 检索转哈希: 将查找容器替换为集合(
set)或字典(dict),使检索操作在哈希均匀分布下达到 O(1) 的平均时间。 - 队列首端弹出: 涉及广度优先搜索(BFS)或滑动窗口时,切忌使用
list.pop(0)(每次弹出需要整体前移剩余元素,耗时 O(N)),必须引入collections.deque,其popleft()是纯粹的 O(1) 指针操作。 - 双指针与滑动窗口: 针对数组连续子区间或有序对查找问题,用前后双指针的协同推移替代嵌套循环,将 O(N²) 暴力遍历转化为 O(N) 线性扫描。
2.3 递归深度与冗余计算治理:记忆化剪枝
动态规划或深度优先遍历代码中,若存在大量重叠子状态,朴素递归的时间复杂度往往随搜索深度呈指数级(O(2^N))暴涨。利用标准库中的 functools.lru_cache,只需一行装饰器即可将纯函数调用的历史结果缓存在哈希表中,避免重复递归:
import sys
from functools import lru_cache

# 提升沙箱允许的最大递归深度(默认通常为 1000)
sys.setrecursionlimit(200000)

@lru_cache(maxsize=None)
def count_ways(n: int, remaining_budget: int) -> int:
    if remaining_budget < 0:
        return 0
    if n == 0:
        return 1 if remaining_budget == 0 else 0

    # 状态转移:重叠子状态将直接命中缓存,不再深度展开
return count_ways(n - 1, remaining_budget) + count_ways(n - 1, remaining_budget - 5)RecursionError,但在内存极度受限(如 64MB)的沙箱中,每次函数调用都会在 C 栈上压入栈帧。过深的递归会急剧侵蚀栈空间导致直接崩溃。此时必须将递归重写为“显式栈 + while 循环”的迭代版本。
三、内存超限(MLE)的缩减与释放策略
面对 MLE,核心矛盾通常是“程序在短时间内申请并持有了过多的高级包装对象”。在 Python 中,哪怕是一个最基础的整数,也是一个包装完备的结构体(在 64 位机器上通常占用 28 字节);如果再加上包含指针的列表或字典,内存消耗将呈数倍膨胀。
3.1 使用生成器(yield)实施流式管道化
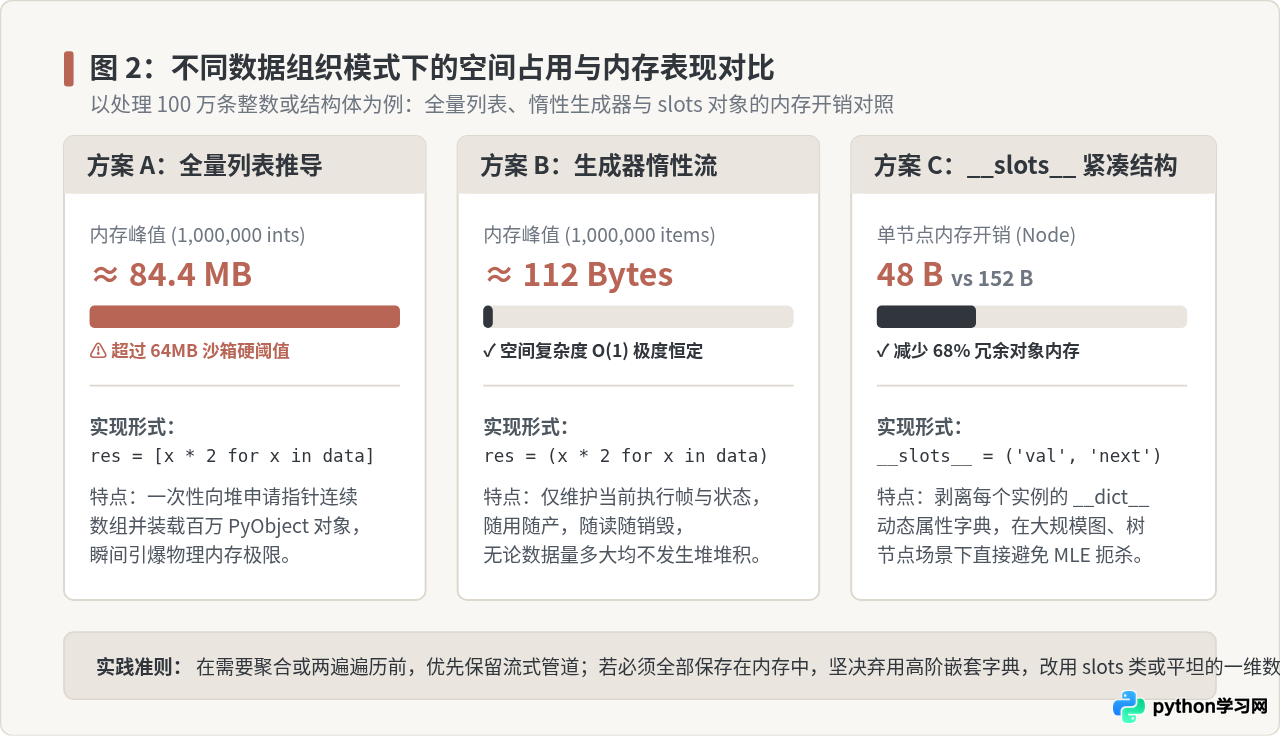
许多代码习惯使用列表推导式 [expr for x in iterable],这会立刻在堆中为整个序列物化开辟空间。当数据量达到上百万条时,瞬时堆占用会直接刺穿沙箱上限。
如果数据只需按顺序消费一遍(如求和、过滤、规约计算),应无条件使用生成器表达式 (expr for x in iterable) 或定义含 yield 的生成器函数:
import sys

def parse_records_stream():
    # 逐行读取,即读即产,内存开销始终为单行大小
    for raw_line in sys.stdin:
        line = raw_line.strip()
        if not line:
            continue
        id_str, val_str = line.split(',')
        # 产生中间状态,不预先物化全部列表
        yield int(id_str), float(val_str)

def compute_total_metric():
    total_val = 0.0
    valid_count = 0
    # 惰性迭代消费,空间复杂度保持为 O(1)
    for rec_id, val in parse_records_stream():
        if val > 0:
            total_val += val
            valid_count += 1

    return total_val / valid_count if valid_count else 0.0
3.2 使用 __slots__ 紧缩自定义节点对象
在需要构建复杂树、图或链表结构的问题中(如字典树 Trie、后缀自动机、线段树),程序往往需要创建数十万个自定义类实例。默认情况下,Python 为每个类实例都配备了一个名为 __dict__ 的动态属性字典,单实例内存占用可达 150 字节以上。
通过显式声明 __slots__,可以彻底切除动态字典,让属性以连续的定长数组形式固化,大幅节约内存:
# 传统对象:每个实例约 152 字节,十万节点需 15MB 额外字典开销
class StandardTreeNode:
    def __init__(self, val, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right

# 优化后的紧凑对象:每个实例压缩至约 48 字节,内存降低 68%
class CompactTreeNode:
    __slots__ = ('val', 'left', 'right')
    def __init__(self, val, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right
3.3 破除循环引用与垃圾收集(gc)陷阱
Python 主要依赖引用计数回收对象。当对象间形成双向关联(例如链表的 prev 和 next,或图节点中的双向边)时,引用计数无法归零,必须等待分代垃圾回收器扫描。
一些开发者为了防止 MLE,会在主循环内插入 gc.collect()。这种做法极其危险:
- 引发超时(TLE):
gc.collect()会强行触发全局分代扫描与内存指针遍历,在高频循环中反复调用会带来不可承受的 CPU 耗时。 - 正确解法: 在结构解构时主动切断引用关系(如遍历将子节点的父指针置为
None),或者在评测程序运行期间显式关闭分代回收并在关键节点一次性清理:
import gc

def batch_process_graphs(graph_batches):
    # 临时禁用自动分代回收,防止频繁触发垃圾扫描拖慢运算
    gc.disable()

    for batch in graph_batches:
        process_single_batch(batch)
        # 主动断开全局大引用
        batch.clear()

    # 全部核心计算完毕后,按需单次执行全量回收
    gc.collect()
    gc.enable()
四、在线超限问题的排查与优化工作流
在分秒必争的在线比赛或受限环境调试中,切忌无目的地随意改动代码。建立自顶向下的四步排查流程,能够以最高效率收敛问题。
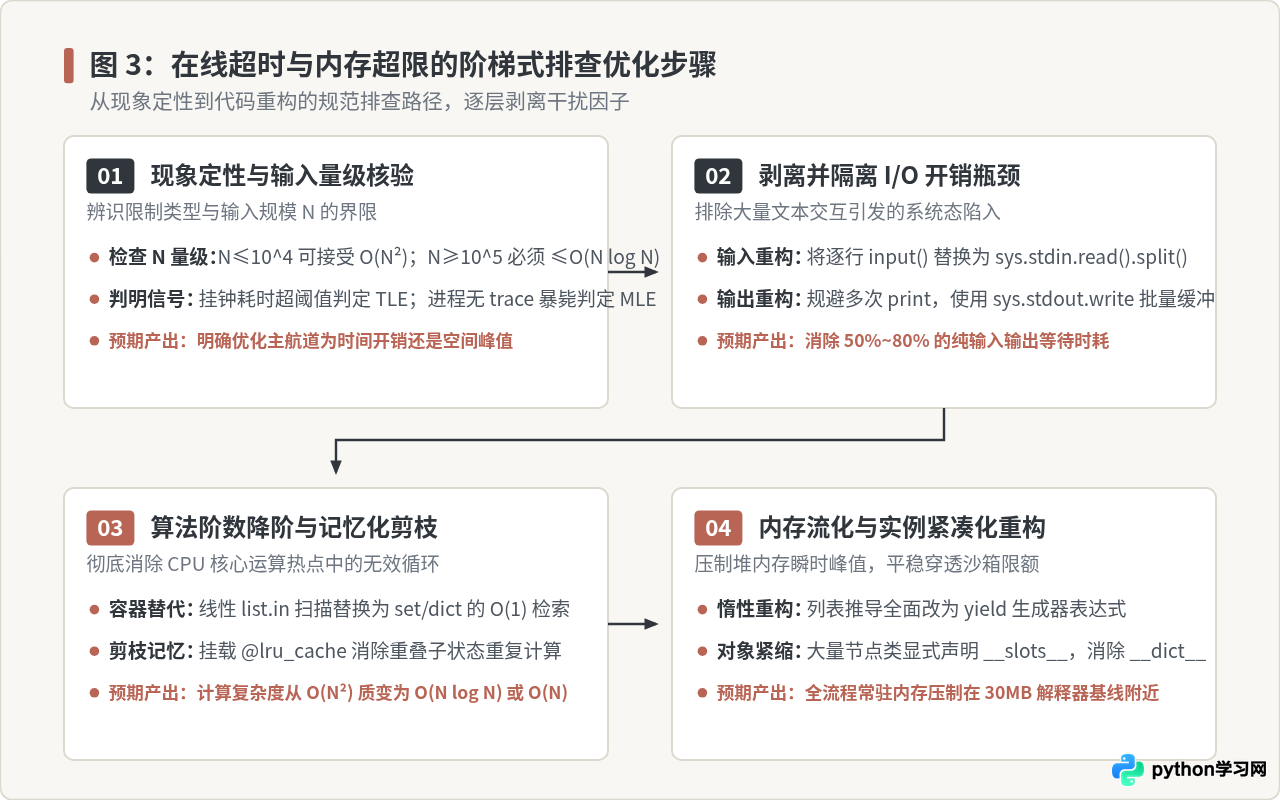
- Step 01 - 现象定性与输入量级核验: 审视题设中的数据规模上限 $N$。通常情况下,在线沙箱在 1.0 秒内大约可执行 $10^7$ 次基础指令。如果 $N = 10^5$,任何包含双重循环 $O(N^2)$ 的算法在数学上必然超时;解法必须严格控制在 $O(N \log N)$ 或 $O(N)$ 范围内。
-
Step 02 - 剥离并隔离 I/O 开销: 先将输入读取全部替换为
sys.stdin.read().split()或sys.stdin.readline,消除系统调用噪声。如果替换后直接从 TLE 变为 Accepted,说明问题纯粹是 I/O 阻塞;如果仍然超时,则聚焦于计算逻辑。 -
Step 03 - 算法阶数降阶与记忆化剪枝: 重点巡查高频执行区是否有线性列表检索。将多重检索提取为哈希映射或双指针;将具有重叠子结构的搜索挂载
@lru_cache拦截。 -
Step 04 - 内存流化与实例紧凑化重构: 如果出现 MLE,定位所有产生大列表的推导式,全部改造为
yield生成器;对于必须常驻内存的图/树对象,全量追加__slots__,并在中间计算完成后显式切断长生命周期的大对象引用。
五、常见认知误区与规避边界
在优化 Python 代码应对受限环境时,有若干流传甚广但往往产生负面作用的误区,读者必须认真甄别:
-
误区一:误以为多线程可以突破 TLE。 在受限的在线沙箱中,通常只分配了单核 CPU 配额;更重要的是,CPython 的全局解释器锁(GIL)使得多线程在 CPU 密集型任务下不但无法加速,反而会因极其频繁的线程上下文切换与 GIL 锁竞争导致耗时激增。此外,沙箱的 seccomp 安全白名单往往严密拦截或限制
multiprocessing的进程派生,盲目使用多进程往往直接触发系统安全违规报错。 - 误区二:误以为单行奇巧写法(Code Golf)能提升性能。 将复杂的逻辑强行压缩在一行列表推导或使用复杂的内联三元表达式,并不能改变底层的时间复杂度;过度嵌套的推导式还会因为临时对象的大量生成,加剧瞬时内存的分配抖动。
- 误区三:过度滥用全局变量暂存数据。 全局变量的生命周期与整个进程绑定,直到程序退出才会释放其指向的内存。在单判题进程运行多测试用例(如包含测试点组评测)的在线环境中,上一用例留下的全局变量会持续蚕食堆内存,导致后续测试用例在启动瞬间便引爆 MLE。
六、策略矩阵速查与技术总结
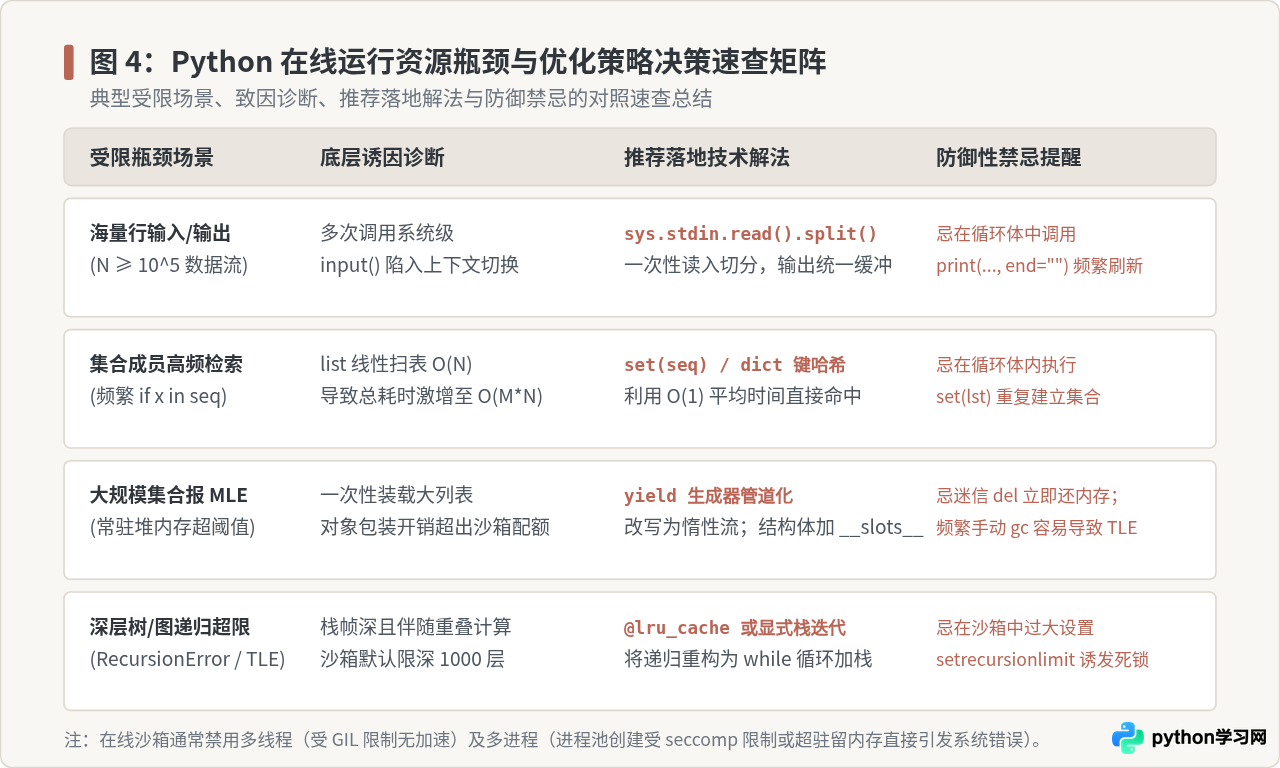
针对日常开发与在线竞赛中常见的超限场景,下表给出了快速对应的优化手段与诊断依据:
| 瓶颈现象 | 底层诱因 | 实用落地技巧 | 验证与防御提示 |
|---|---|---|---|
| 海量行输入卡顿 (TLE) | 系统级 input() 频繁陷入内核态与字符串剥离 | 改用 sys.stdin.read().split() 批量提取 |
需确认单测试点内存在读取全部文本后仍有富余 |
| 集合查找超时 (TLE) | 对 list 进行 O(N) 线性 in 扫描或 pop(0) | 改用 set / dict 或 collections.deque |
严禁在循环体内重复执行 set(seq) 造成二次建表 |
| 大规模数据载入超限 (MLE) | 全量列表推导式一次性挤占堆内存空间 | 转换为生成器表达式或 yield 惰性管道 |
流式生成器只能被顺序消费一次,不可多次切片 |
| 复杂树/图节点超限 (MLE) | 海量实例携带默认 __dict__ 属性字典 |
在自定义节点类显式声明 __slots__ |
声明后实例无法动态绑定其他非 slots 属性 |
| 深层树遍历栈溢出 (TLE/MLE) | 递归层数超千层且包含重叠状态 | 添加 @lru_cache 或改写为显式栈迭代 |
深度超万层时必须用 while 循环迭代消除 C 栈占用 |
归纳而言,在资源严苛的在线运行环境中写出高效健壮的 Python 代码,本质上是一场在“解释器动态特性”与“沙箱硬性物理界限”之间的平衡艺术。只要在输入输出环节建立批量缓冲、在算法核心中坚持对数级或线性复杂度的容器选择,并在数据组织上贯彻“能流式不全量、能紧凑不冗余”的严谨准则,即可从容穿透沙箱的资源封锁,稳定达成各项指标的合规通过。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









