

Python新手练手项目推荐:从控制台工具到简单爬虫
专为Python初学者整理的实战练手项目路径,从命令行待办工具、本地日志与数据批处理,一路进阶到网络数据抓取,通过具体代码、执行流程与避坑要点,建立扎实的编程与工程思维。
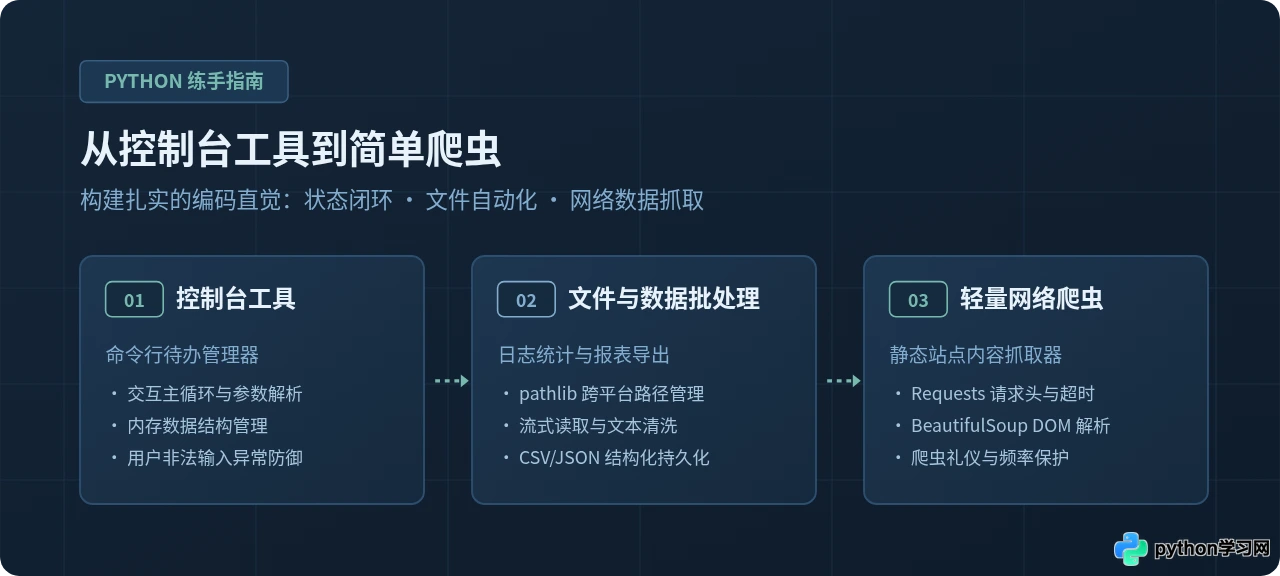
图 0:从控制台交互到网络数据爬取的实践演进全景
一、新手进阶路径:降低反馈延迟与抽象成本
在编程学习初期,最关键的不是写了多少行代码,而是能否在脑海中建立对“输入、状态转移、输出”的稳定预期。如果选择的项目依赖庞大的外部环境(如数据库迁移、跨域网关、前端构建工具),一旦报错,初学者往往难以判断是自己的核心逻辑有误,还是周边环境配置失当。
由轻到重的梯度演进遵循了认知与工程规律:
- 第一阶段(控制台工具):输入来自终端键盘,状态驻留在内存中,代码以秒级快速反馈。这一阶段专注于巩固分支、循环、集合操作以及异常防御。
- 第二阶段(文件与数据批处理):程序脱离实时人工输入,转而面对真实的磁盘文件。这一阶段的重点是掌握
with open上下文、pathlib跨平台路径管理,以及标准化格式(CSV、JSON)的解析与导出。 - 第三阶段(轻量网络爬虫):程序走出单机环境,面对不确定的网络连接与远程服务器。这一阶段重点学习 HTTP 请求协议、状态码校验、HTML 节点提取(DOM 解析)以及爬虫礼仪。
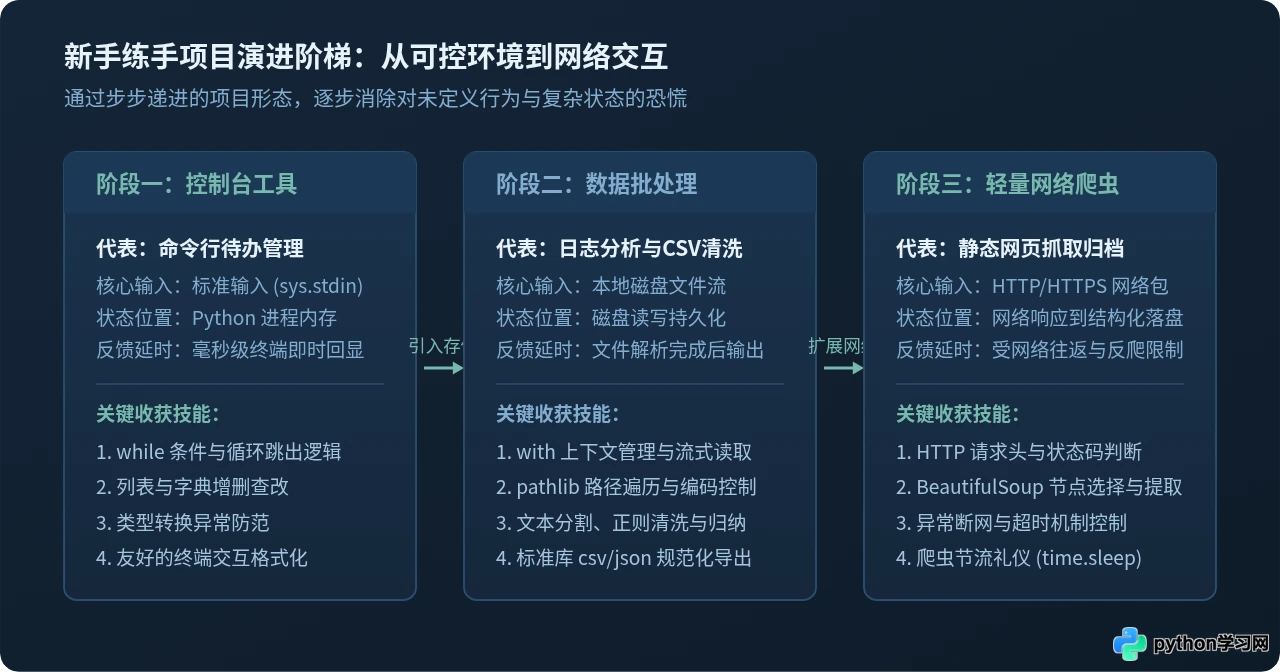
图 1:Python 新手练习项目的演进阶梯与核心能力对照
二、阶段一:控制台交互工具——建立主循环与状态管理直觉
控制台交互工具的核心,是构建一个由 while 循环驱动的“交互主循环”(REPL 模式)。程序打印菜单提示用户输入,根据输入解析指令并修改内部数据,最后向终端输出执行结果并重新等待下一次输入。
1. 推荐项目:命令行待办事项管理器(CLI Todo Manager)
这个项目能够训练将现实需求抽象为数据结构的能力。我们用一个列表保存任务,每个任务使用一个字典表示,记录任务的唯一编号、描述内容以及是否已完成的状态。
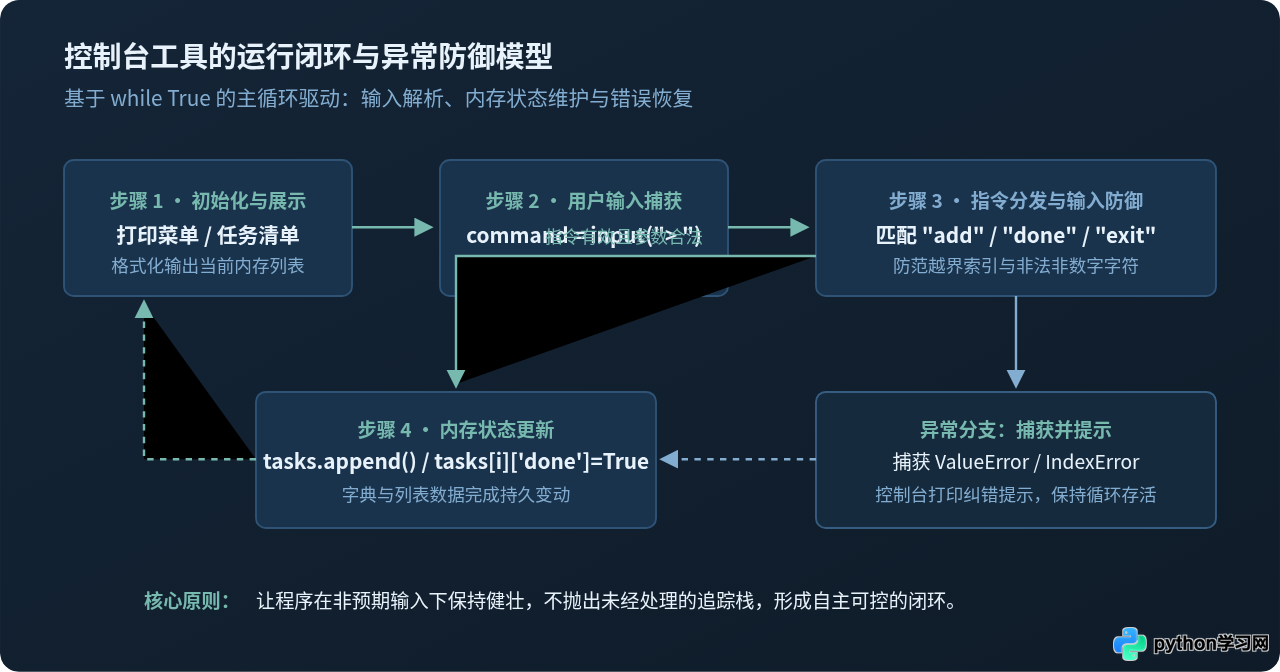
图 2:控制台程序的运行闭环与输入异常防御机制
2. 核心代码实现
以下代码不需要安装任何第三方库,直接使用 Python 3 标准环境运行即可:
todo_cli.py# -*- coding: utf-8 -*-
"""
命令行简易待办事项管理器
运行环境:Python 3.6+
"""
def print_help():
print("\n=== 简易待办事项管理器 ===")
print("1. list - 查看当前待办清单")
print("2. add <内容> - 新增一条待办任务")
print("3. done <序号> - 将指定任务标记为已完成")
print("4. delete <序号> - 删除指定任务")
print("5. exit - 退出程序")
print("==========================")
def run_todo_app():
# 内存中的状态存储:每个任务包含 id, text, done
tasks = []
task_counter = 1
print_help()
while True:
try:
user_input = input("\n请输入指令 > ").strip()
except (KeyboardInterrupt, EOFError):
print("\n程序被外部中断,退出运行。")
break
if not user_input:
continue
parts = user_input.split(maxsplit=1)
command = parts[0].lower()
argument = parts[1].strip() if len(parts) > 1 else ""
if command == "exit":
print("再见!任务已结束。")
break
elif command == "list":
if not tasks:
print("【提示】当前清单为空,请使用 add 指令添加任务。")
else:
print("【任务清单】")
for item in tasks:
status = "[✓] 已完成" if item["done"] else "[ ] 待处理"
print(f" {item['id']}. {status} - {item['text']}")
elif command == "add":
if not argument:
print("【错误】添加任务时必须提供内容,例如:add 整理学习笔记")
continue
new_task = {"id": task_counter, "text": argument, "done": False}
tasks.append(new_task)
print(f"【成功】已添加任务 #{task_counter}:{argument}")
task_counter += 1
elif command in ("done", "delete"):
if not argument:
print(f"【错误】请指定任务序号,例如:{command} 1")
continue
try:
target_id = int(argument)
except ValueError:
print("【错误】任务序号必须是正整数。")
continue
# 在列表中寻找对应 ID 的任务
target_task = next((t for t in tasks if t["id"] == target_id), None)
if not target_task:
print(f"【错误】未找到序号为 {target_id} 的任务。")
continue
if command == "done":
if target_task["done"]:
print(f"【提示】任务 #{target_id} 此前已处于完成状态。")
else:
target_task["done"] = True
print(f"【成功】任务 #{target_id} 已标记为完成!")
else:
tasks.remove(target_task)
print(f"【成功】任务 #{target_id} 已被删除。")
else:
print(f"【未知指令】'{command}'。输入 exit 退出,或输入 list 查看列表。")
if __name__ == "__main__":
run_todo_app()
3. 示例运行输出
int(input()) 直接转换,当用户输入字母或直接回车时,程序会直接抛出 ValueError 崩溃。务必使用 try...except ValueError 保护类型转换环节。
三、阶段二:本地文件与数据批处理——掌握标准库与数据持久化
控制台工具虽然逻辑闭环,但每次关闭终端后,内存里的所有数据都会丢失。第二个练手阶段的核心目标,是让程序学会读写磁盘,并能对成百上千行的文本或日志进行批量归类统计。
1. 推荐项目:日志清洗与统计报表导出工具(Log Analyzer)
在实际工作中,排查系统故障往往需要分析包含大量杂乱行的日志文件。该工具能够遍历目标目录中的所有 .log 文件,提取每一条记录的日志等级(如 INFO、WARNING、ERROR)与错误信息,统计发生频次,并将结构化结果写入 CSV 文件中供表格软件打开分析。
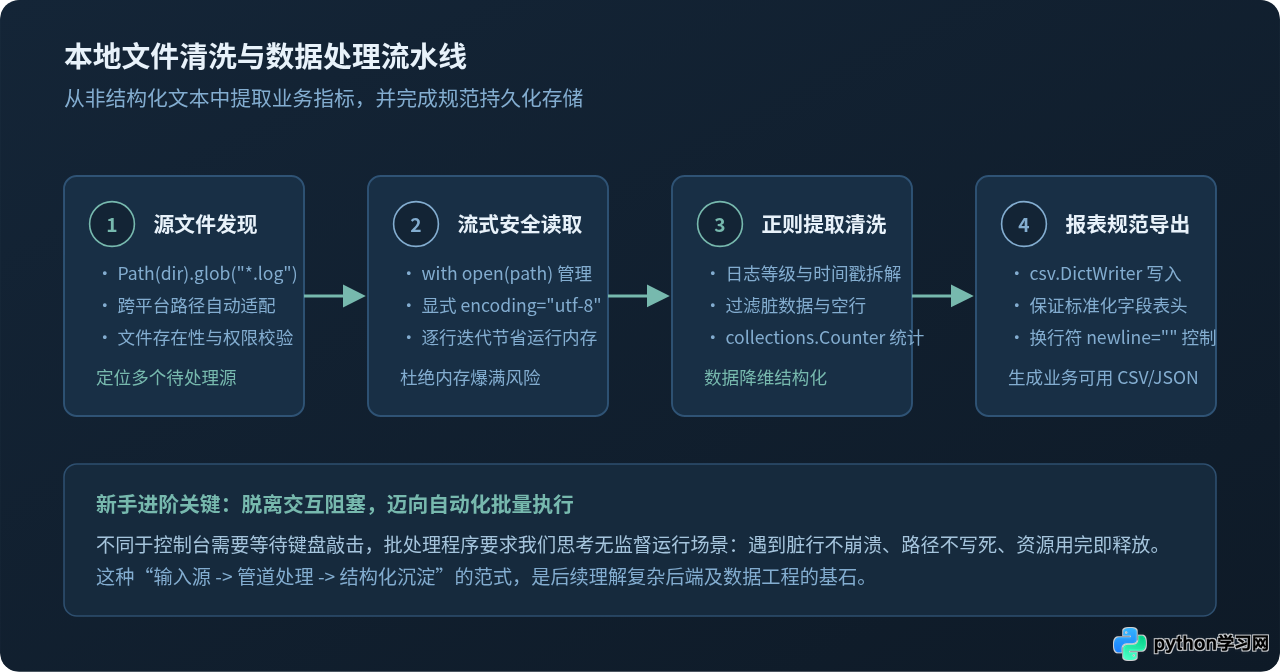
图 3:本地文件批处理与结构化数据落盘流水线
2. 核心代码实现
本示例使用标准库 pathlib.Path 处理路径,使用 csv.DictWriter 生成标准报表:
# -*- coding: utf-8 -*-
"""
本地日志批处理与 CSV 报表汇总工具
依赖环境:Python 3.6+ 内置标准库
"""

import csv
import re
from pathlib import Path
from collections import Counter

# 模拟日志行格式:2026-10-31 10:15:20 [ERROR] Database timeout on query: users
LOG_PATTERN = re.compile(r"^(\d{4}-\d{2}-\d{2}\s+\d{2}:\d{2}:\d{2})\s+\[(INFO|WARNING|ERROR)\]\s+(.*)$")

def analyze_logs(source_dir: Path, report_path: Path):
    if not source_dir.exists():
        print(f"【错误】源目录不存在:{source_dir}")
        return

    level_counter = Counter()
    error_reasons = Counter()
    total_lines = 0

    log_files = list(source_dir.glob("*.log"))
    if not log_files:
        print(f"【提示】在 {source_dir} 中未找到 .log 文件。")
        return

    print(f"正在扫描目录:{source_dir},共发现 {len(log_files)} 个日志文件...")

    for file_path in log_files:
        # 始终明确指定 encoding='utf-8',避免不同操作系统编码冲突
        with file_path.open("r", encoding="utf-8", errors="replace") as f:
            for line in f:
                total_lines += 1
                line = line.strip()
                if not line:
                    continue
                match = LOG_PATTERN.match(line)
                if match:
                    timestamp, level, message = match.groups()
                    level_counter[level] += 1
                    if level == "ERROR":
                        # 截取主要原因作为聚合统计字段
                        reason = message.split(":")[0].strip()
                        error_reasons[reason] += 1

    # 输出统计至终端
    print(f"处理完成!累计分析 {total_lines} 行文本。")
    print("级别分布:", dict(level_counter))

    # 将主要错误写入 CSV 报表
    report_path.parent.mkdir(parents=True, exist_ok=True)
    with report_path.open("w", encoding="utf-8", newline="") as csvfile:
        fieldnames = ["error_type", "occurrences", "ratio"]
        writer = csv.DictWriter(csvfile, fieldnames=fieldnames)
        writer.writeheader()

        total_errors = level_counter["ERROR"]
        for error_type, count in error_reasons.most_common():
            ratio = f"{(count / total_errors * 100):.2f}%" if total_errors > 0 else "0%"
            writer.writerow({
                "error_type": error_type,
                "occurrences": count,
                "ratio": ratio
            })

    print(f"【成功】已将汇总报表导出至:{report_path}")

if __name__ == "__main__":
    # 本地演示:创建临时测试日志并分析
    demo_dir = Path("./sample_logs")
    demo_dir.mkdir(exist_ok=True)
    sample_file = demo_dir / "service_20261031.log"
    sample_file.write_text(
        "2026-10-31 08:00:01 [INFO] Service initialized successfully\n"
        "2026-10-31 08:01:10 [ERROR] ConnectionRefused: Redis port 6379 unreachable\n"
        "2026-10-31 08:02:15 [WARNING] Memory usage exceeds 80%\n"
        "2026-10-31 08:05:40 [ERROR] ConnectionRefused: Master db unreachable\n"
        "2026-10-31 08:06:00 [ERROR] TimeoutError: Socket read timeout\n",
        encoding="utf-8"
    )
    analyze_logs(demo_dir, Path("./output/error_report.csv"))
3. 示例运行输出
- 必须声明
encoding="utf-8":如果在 Windows 环境下使用open(filename)不指定编码,系统默认会采用 ANSI/GBK 编码打开文件,一旦遇到 UTF-8 特殊符号就会抛出UnicodeDecodeError。 - 写 CSV 必须加
newline="":在 Windows 系统中,如果省略该参数,csv.writer默认每行都会多产生一个空行(\r\r\n)。
四、阶段三:轻量网络爬虫——从本地逻辑迈向外部网络协议
完成前两个阶段后,读者已经具备了数据处理与异常防范的扎实基础。接下来,我们可以将“输入源”从本地磁盘拓展至互联网络。网络爬虫本质上也是批处理程序,不同的是,它的输入是通过网络协议获取的 HTML 网页文本。
1. 推荐项目:静态图书/名言内容抓取与结构化沉淀
新手入门爬虫,切忌一开始就去尝试带有滑块验证码、字体加密或复杂 JavaScript 动态渲染的网站。推荐选用专门用于爬虫学习的公开站点(例如 quotes.toscrape.com 或公开的静态文档站点),掌握网络请求与 DOM 解析的标准模式。
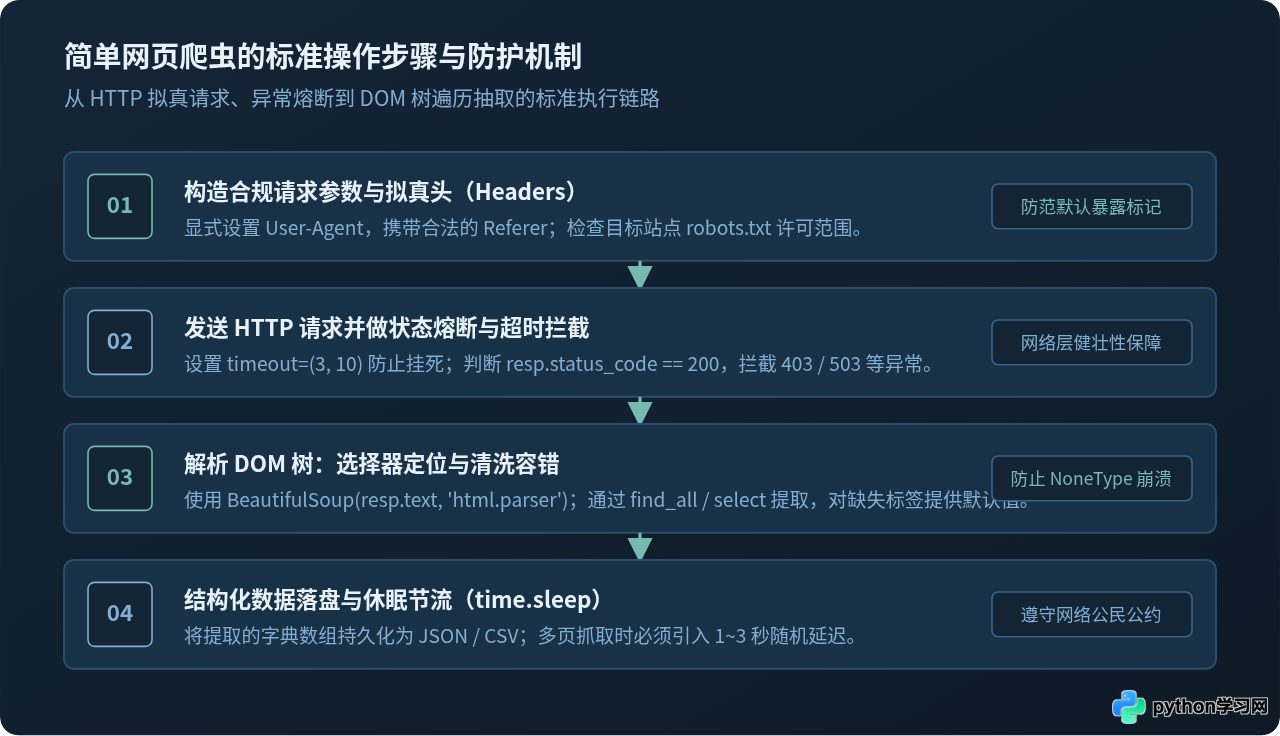
图 4:网络爬虫的标准执行链路与关键防御节点
2. 核心技术栈选择
requests:负责发送标准 HTTP 请求,设置超时、请求头与会话参数。BeautifulSoup(来自bs4):负责将凌乱的 HTML 字符串解析为树状对象,支持通过 CSS 类名或标签属性进行精准查询。
3. 核心代码实现
安装必要依赖:pip install requests beautifulsoup4
# -*- coding: utf-8 -*-
"""
静态网页数据提取与结构化沉淀示例
依赖库:pip install requests beautifulsoup4
目标练习站点:公开练习平台 http://quotes.toscrape.com
"""

import json
import time
from pathlib import Path
import requests
from bs4 import BeautifulSoup

def fetch_quotes(page: int = 1):
    url = f"http://quotes.toscrape.com/page/{page}/"

    # 爬虫规范 1:拟真请求头,表明客户端特征,杜绝暴露默认 requests 标识
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/120.0.0.0 Safari/537.36"
        ),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    print(f"正在抓取第 {page} 页: {url} ...")

    try:
        # 爬虫规范 2:必须配置 timeout,避免因网络无响应导致线程永久阻塞
        response = requests.get(url, headers=headers, timeout=(5, 10))

        # 爬虫规范 3:严谨检查状态码
        if response.status_code != 200:
            print(f"【警告】请求未成功,状态码: {response.status_code}")
            return []

        # 显式使用 UTF-8 解码 HTML 文本
        response.encoding = "utf-8"
        soup = BeautifulSoup(response.text, "html.parser")

        quote_elements = soup.select("div.quote")
        extracted_data = []

        for item in quote_elements:
            # 安全提取文本内容,防范 NoneType 异常
            text_el = item.select_one("span.text")
            author_el = item.select_one("small.author")
            tag_elements = item.select("div.tags a.tag")

            quote_text = text_el.get_text(strip=True) if text_el else "无文本"
            author = author_el.get_text(strip=True) if author_el else "匿名"
            tags = [t.get_text(strip=True) for t in tag_elements]

            extracted_data.append({
                "author": author,
                "text": quote_text,
                "tags": tags
            })

        return extracted_data

    except requests.exceptions.Timeout:
        print("【错误】网络请求超时,已跳过当前页面。")
        return []
    except requests.exceptions.RequestException as e:
        print(f"【网络异常】{e}")
        return []

def run_crawler_pipeline(total_pages: int = 2, output_file: Path = Path("./quotes.json")):
    all_results = []

    for p in range(1, total_pages + 1):
        page_results = fetch_quotes(p)
        if not page_results:
            print(f"第 {p} 页未抓取到有效数据,中断流程。")
            break
        all_results.extend(page_results)

        # 爬虫规范 4:多页抓取必须加入休眠节流,严禁高频并发轰炸目标站点
        if p < total_pages:
            print("遵守爬虫礼仪,等待 1.5 秒后请求下一页...")
            time.sleep(1.5)

    if all_results:
        output_file.parent.mkdir(parents=True, exist_ok=True)
        with output_file.open("w", encoding="utf-8") as f:
            json.dump(all_results, f, ensure_ascii=False, indent=2)
        print(f"【完成】累计抽取 {len(all_results)} 条记录,已保存至 {output_file}")
    else:
        print("【提示】未收集到任何数据,未生成持久化文件。")

if __name__ == "__main__":
    run_crawler_pipeline(total_pages=2, output_file=Path("./output/quotes.json"))
4. 示例运行输出
- 尊重
robots.txt:访问网站前,可在浏览器输入https://example.com/robots.txt查看哪些路径允许程序抓取。禁止爬取包含隐私信息或声明不允许爬取的目录。 - 绝不省略
timeout:默认情况下requests.get(url)是没有超时的,如果远程服务器挂起或丢包,程序会陷入死等。 - 善用
time.sleep节流:新手常常在for循环中无延迟高频请求,这极易导致本机 IP 被封禁,甚至对目标服务器造成不必要的负载。
五、综合复盘与能力矩阵
完成这三个阶段的项目后,读者实际上已经经历了现代后端开发与数据工程的核心场景。它们在技术栈、挑战点和编码习惯上的演进关系可汇总如下:
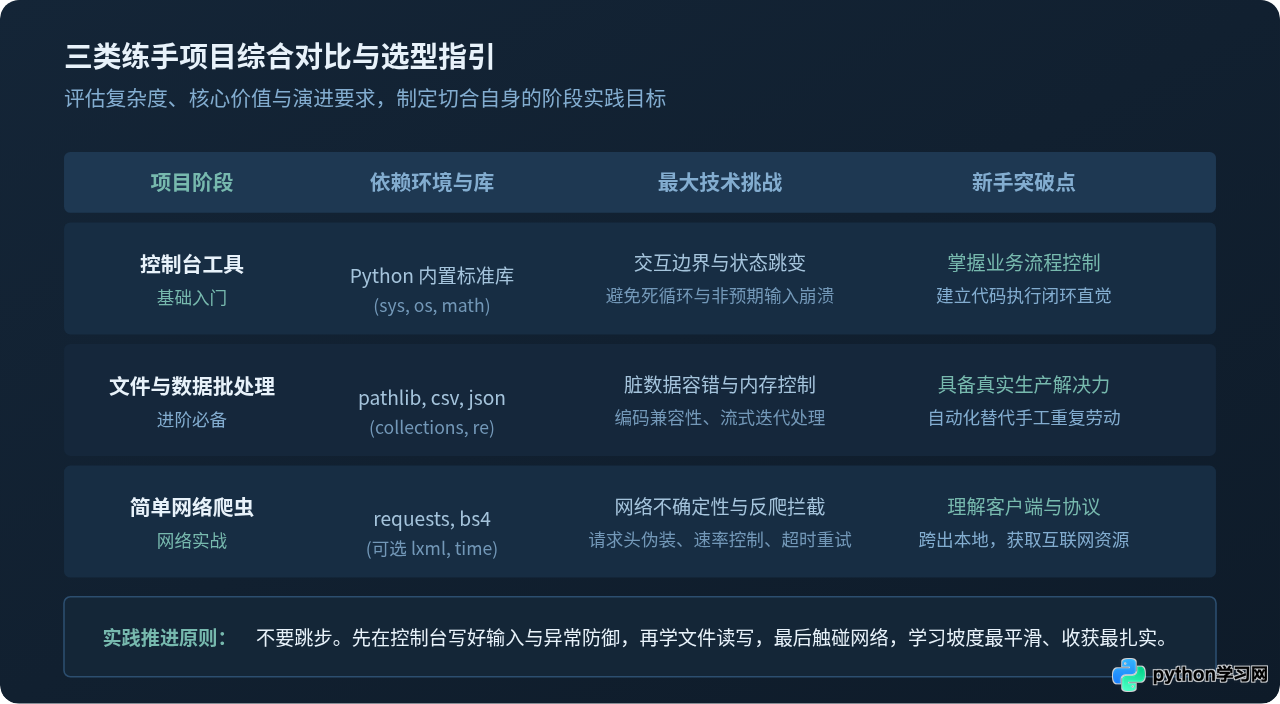
图 5:控制台工具、文件处理与网络爬虫的综合技能对比
建议新手在实践这三个项目时,按照如下节奏逐步扩展:
- 第一步(跑通基础功能):不要一开始就追求华丽的界面或多线程并发,先保证核心功能(如待办增删、日志行统计、单页网页文本抓取)能够在自己的终端里完整运行。
- 第二步(故意输入错误数据):给控制台输入特殊字符或越界数字,在日志文件中插入空行与乱码,给爬虫提供一个错误的 404 网址,观察代码是否会直接抛出未捕获的追踪栈。针对每一个异常点编写防御逻辑。
- 第三步(模块化重构):将写在同一个大函数里的代码,拆分成独立的输入模块、核心业务逻辑函数与持久化存储模块。
通过这种自底向上的练习方式,不仅能彻底巩固 Python 核心语法,更能为日后深入学习 Web 框架(如 FastAPI、Django)、自动化测试或分布式爬虫打下最坚实的基石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









